昨年秋のSprint 2.0で、NGINX Modern Apps Reference Architecture(MARA)プロジェクトを発表した際、一部のアーキテクチャのような「おもちゃ」ではなく、「堅牢で、テスト済みであり、Kubernetes環境で稼働する本番アプリケーションにすぐに導入できる」ソリューションを目指すことを強調しました。このようなプロジェクトには、オブザーバビリティツールが不可欠です。MARAチームのメンバー全員が、状態やパフォーマンスを把握できないと、アプリケーションの開発と配信がいかにストレスの多い作業になるかを身をもって経験しています。本番環境でのデバッグとトレースに必要な計装をMARAに組み込むべきだという点で、すぐに意見が一致しました。
MARAのもう1つの指針は、オープンソースのソリューションを優先することです。本記事では、多機能なオープンソースのオブザーバビリティツールを探す中で、OpenTelemetryにたどり着いた経緯を説明します。続いて、Python、Java、NGINXで構築したマイクロサービスアプリケーションにOpenTelemetryを統合する際のトレードオフ、設計上の判断、使用した手法と技術について詳しく解説します。
私たちの経験が、潜在的な落とし穴を避け、OpenTelemetryの導入を加速する一助となれば幸いです。なお、本記事は執筆時点の状況に基づく進捗報告であり、ここで取り上げる技術は1年以内に成熟すると予想しています。また、一部のプロジェクトの現時点での課題を指摘していますが、オープンソースに関するあらゆる取り組みに深く感謝しており、その進展を楽しみにしています。
私たちのアプリケーション
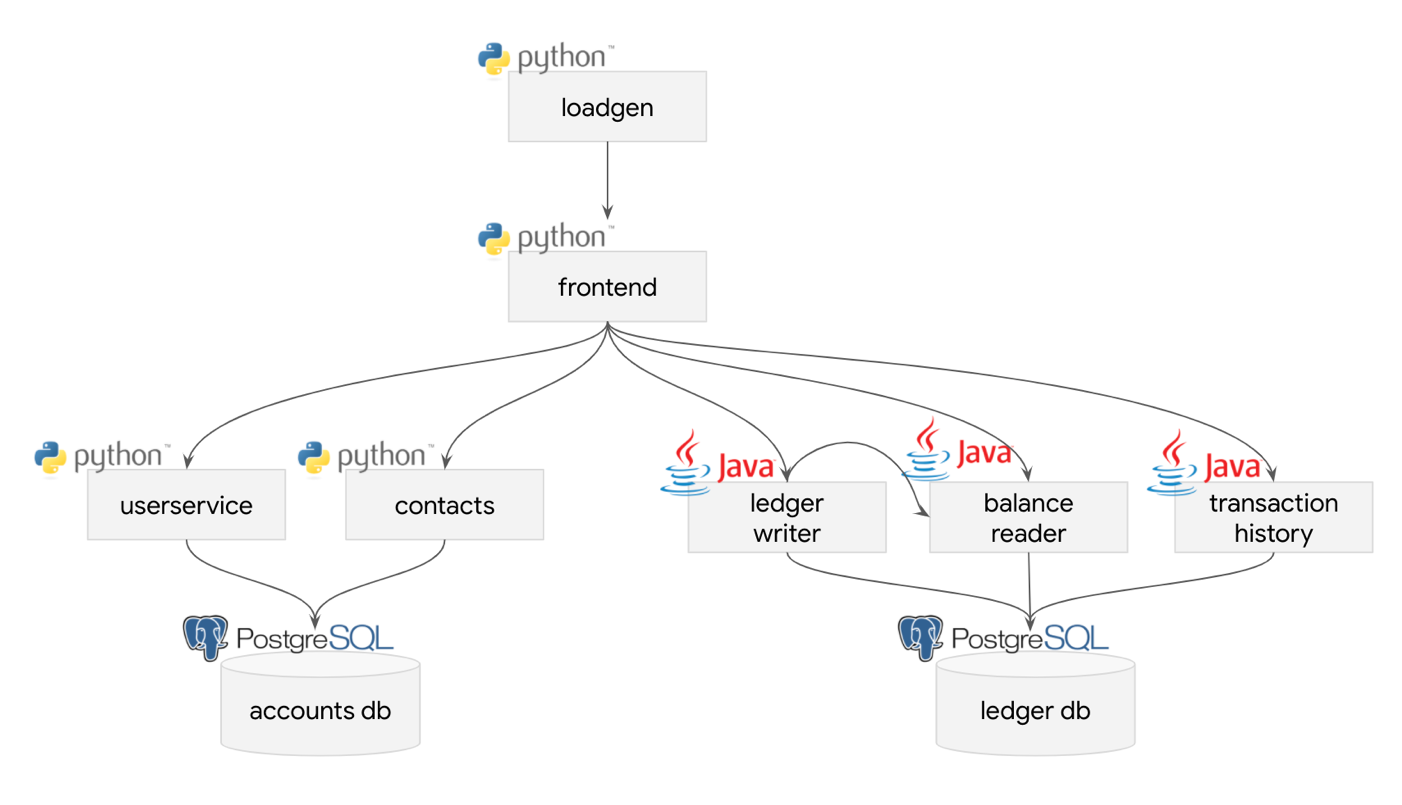
オブザーバビリティソリューションと統合するアプリケーションとして選んだのは、Bank of Siriusです。これは、GoogleのサンプルアプリケーションであるBank of Anthosをフォークしたものです。マイクロサービスアーキテクチャを採用したWebアプリケーションで、Infrastructure as Codeを利用してデプロイできます。パフォーマンスと信頼性の面では改善の余地が多くあるものの、ブラウンフィールドのアプリケーションと見なせるほどには成熟しています。そのため、OpenTelemetryをアプリケーションに統合する方法を示すのに適した例だと考えています。理論上は、分散トレーシングによって、アプリケーションアーキテクチャの問題点に関する貴重な知見が得られるためです。
図に示すように、アプリケーションを支えるサービスは比較的シンプルです。
OpenTelemetryを選んだ経緯
OpenTelemetryの選定に至るまでには、かなりの紆余曲折があり、いくつかの段階を経ました。
必要な機能のリストを作成
利用可能なオープンソースのオブザーバビリティツールそのものを評価する前に、オブザーバビリティのどの側面を重視するかを明確にしました。これまでの経験を踏まえ、以下のリストにまとめました。
- ロギング:ここでは、アプリケーションが従来の改行区切りのメッセージ群を生成することを指します。Bank of Siriusアプリでは、ログを次の形式で構造化しています:Bunyan形式
- 分散トレーシング – アプリケーション全体を構成する各コンポーネントの処理時間とメタデータ。アプリケーションパフォーマンス管理(APM)ベンダーが提供するものがその例です
- メトリクス – 一定期間にわたって収集され、時系列データとしてグラフ化された測定値
- 例外とエラーの集約および通知 — 頻繁に発生する例外とエラーを集約したものです。どのアプリケーションエラーが最も多く発生しているかを特定できるよう、検索可能である必要があります。
- ヘルスチェック – サービスがアプリケーション内で正常に機能しているかどうかを確認するために、サービスに定期的に送信するプローブ
- ランタイム状態のイントロスペクション – アプリケーションのランタイム状態に関する情報を返す、管理者にのみ表示される一連のAPI
- ヒープダンプとコアダンプ – サービスの実行時状態の包括的なスナップショットです。ここで重要なのは、必要に応じて、またはサービスがクラッシュしたときに、これらのダンプをどれだけ容易に取得できるかです。
ツールの機能と要望リストの比較
もちろん、単一のオープンソースツールやアプローチでこれらの機能をすべて網羅できるとは考えていませんでしたが、少なくとも利用可能なツールを比較するための理想的な基準にはなりました。各ツールのドキュメントを参照し、希望する7つの機能のうち、どれをサポートしているかを確認しました。その結果を表にまとめています。
技術 ログ記録 分散トレーシング メトリクス エラー集約 ヘルスチェック ランタイムイントロスペクション ヒープダンプ/コアダンプELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry ベータ版 ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
* 拡張機能として
この表を作成して、厳しい現実に気づかされました。各ツールは機能も想定用途も大きく異なり、すべてを同じカテゴリーに分類することはできませんでした。まるでリンゴとトースターを比較するようなものだったのです。
たとえば、ELK(Elasticsearch-Logstash-KibanaにFilebeatを加えたもの)とZipkinは、根本的に異なる役割を担っているため、比較しようとするとかえって混乱を招きます。残念ながら、「本来の目的を超えた機能の拡張」が、状況をさらに複雑にしています。ユーザーの要望に応えた結果であることは間違いないでしょうが、ツールの主目的からすると副次的な機能が追加され、ほかのツールと機能が重複するようになっています。一見すると、ELKはログの保存と可視化を、Zipkinは分散トレーシングを行うツールです。しかし、Elasticの製品ポートフォリオを少し詳しく調べると、すぐにElastic APMが見つかります。これは分散トレーシングをサポートし、さらにJaegerとの互換性も備えています。
本来の目的を超えた機能拡張の問題に加え、多くのツールは相互に連携できるため、コレクター、アグリゲーター、ダッシュボードなどの組み合わせもさまざまです。これらの技術には、相互に互換性があるものと、ないものがあります。
定性調査の実施
このように、この比較表だけでは、選択の判断材料となる十分に正確な全体像を把握できませんでした。そこで、各プロジェクトの目標、基本理念、今後進む可能性のある方向性について、定性的な調査を行う必要がありました。プロジェクトの価値観が私たちの価値観に近いほど、長期的にも相性のよい関係を維持できる可能性が高いと考えたためです。各プロジェクトのページを訪れたところ、OpenCensusのページですぐに次の記述が目に留まりました。
OpenCensusとOpenTracingは統合され、両プロジェクトの次期メジャーバージョンとなるOpenTelemetryが誕生しました。OpenTelemetryは既存のOpenCensus統合との後方互換性を提供する予定です。また、既存のOpenCensusライブラリに対するセキュリティパッチの提供は、今後2年間継続します。
これは私たちにとって重要な判断材料でした。選択した技術が将来にわたって通用する保証はないと理解していましたが、少なくとも今後もコミュニティから確かな支持を得られることは確認しておきたいと考えていました。この情報から、OpenCensusを候補から外すことができました。Jaegerの採用も、おそらく得策ではありませんでした。Jaegerは、現在は正式に非推奨となったOpenTracingプロジェクトのリファレンス実装であり、新たな貢献の大半はOpenTelemetryに集まる見込みだったためです。
その後、OpenTelemetry Collectorについて詳しく調べました。
OpenTelemetry Collectorは、テレメトリデータの受信、処理、エクスポートを行う、ベンダーに依存しない実装を提供します。また、オープンソースのテレメトリデータ形式(Jaeger、Prometheusなど)に対応し、複数のオープンソースまたは商用バックエンドにデータを送信するために、複数のエージェントやコレクターを実行、運用、保守する必要がなくなります。
OpenTelemetry Collectorはアグリゲーターとして機能し、オブザーバビリティデータのさまざまな収集方法や計装方法を、各種バックエンドと組み合わせることができます。基本的には、アプリケーションでトレースをZipkinで収集し、メトリクスをPrometheusから収集して、設定可能なバックエンドに送信し、Grafanaで可視化できます。この設計にはほかにもさまざまな組み合わせがあるため、異なるアプローチを試し、ユースケースに適した技術を見極めることができます。
今後に向けたOpenTelemetryの統合
私たちがOpenTelemetry Collectorに魅力を感じたのは、理論上、オブザーバビリティ技術を切り替えられるからです。プロジェクトはまだ比較的未成熟でしたが、思い切って踏み出し、オープンソースのインテグレーションのみでOpenTelemetryを使うことにしました。技術の全体像を理解するには、実際に使ってみるしかないと考えたためです。
ただし、OpenTelemetry Collectorには不足している機能もあるため、それらについては他の技術に頼る必要があります。以降のセクションでは、選択した技術とその理由をまとめます。
ログ記録の実装
ログ収集はオブザーバビリティの一部として一見単純に思えますが、すぐに複雑な判断が必要になります。コンテナが出力するログを収集するだけという点では単純です。しかし、データの保存先、保存先への転送方法、有効に活用するためのインデックス作成方法、保持期間を決める必要があるため、複雑になります。ログファイルを役立てるには、検索するさまざまなユーザーのニーズを満たせるよう、十分に多様な条件で簡単に検索できる必要があります。
OpenTelemetry Collectorのロギングサポートを検討しましたが、執筆時点ではまだベータ版の初期段階にあります。他の選択肢の調査を続けながら、当面のロギングにはELKを使用することにしました。
採用を見送る強い理由がなかったため、標準的な選択肢としてElasticsearchのツールを使用し、デプロイメントをインジェストノード、調整ノード、マスターノード、データノードに分割できるようにしました。デプロイを容易にするために、Bitnami chartを使用しました。データ転送には、FilebeatをKubernetes DaemonSetの一部としてデプロイしました。検索機能は、Kibanaをデプロイし、あらかじめ組み込まれているインデックス、検索、可視化、ダッシュボードを活用して追加しました。
このソリューションは動作したものの、デフォルト構成ではリソース消費量がかなり多く、K3SやMicrok8sのようなリソース使用量の少ない環境では実行が難しいことが、比較的早い段階で明らかになりました。各コンポーネントのレプリカ数を調整できるようにすることで、この問題は解決しましたが、リソースの枯渇や過剰なデータ量が原因と考えられる障害がいくつか発生しました。
この結果に落胆するどころか、構成を変えてログシステムのベンチマークを実施し、さらに別の選択肢としてGrafana LokiやGraylogなどを調査する機会と捉えています。軽量なログソリューションでは、一部のユーザーが必要とし、より多くのリソースを消費するツールで利用できる機能をすべては提供できないと判明する可能性も十分にあります。MARAはモジュール構造を採用しているため、ユーザーの選択肢を広げるべく、これらの選択肢に対応する追加モジュールを開発することになるでしょう。
分散トレーシングの実装
必要なトレーシング機能を備えたツールを選定するだけでなく、ソリューションの実装方法や、連携が必要な技術についても検討する必要がありました。
まず、計装によってアプリケーション自体のサービス品質に悪影響が出ないようにしたいと考えました。私たちは全員、ログのエクスポートに伴って1時間ごとに決まってパフォーマンスが低下するシステムを扱った経験があり、同じ経験を繰り返したくありませんでした。この点で、OpenTelemetry Collectorのアーキテクチャは魅力的でした。ホストごとに1つのインスタンスを実行できるためです。各コレクターは、コンテナー化の有無にかかわらず、ホスト上で稼働するさまざまなアプリケーションのクライアントやエージェントからデータを受信します。コレクターはデータを集約し、場合によっては圧縮してからストレージバックエンドに送信するため、理想的な仕組みに思えました。
次に、アプリケーションで使用している各プログラミング言語とフレームワークのOpenTelemetry対応状況を評価しました。ここで、状況は少し複雑になりました。使用しているのは表に示した2つのプログラミング言語と関連フレームワークだけでしたが、複雑さは予想以上でした。
言語 フレームワーク サービス数Java Spring Boot 3Python Flask 3
言語レベルのトレーシングを追加するため、まずOpenTelemetryの自動計装エージェントを試しましたが、その出力は雑然としていて分かりにくいものでした。自動計装ライブラリの成熟に伴い、この点は改善されると確信していますが、当面はOpenTelemetryのエージェントの採用を見送り、コードにトレーシングを組み込むことにしました。
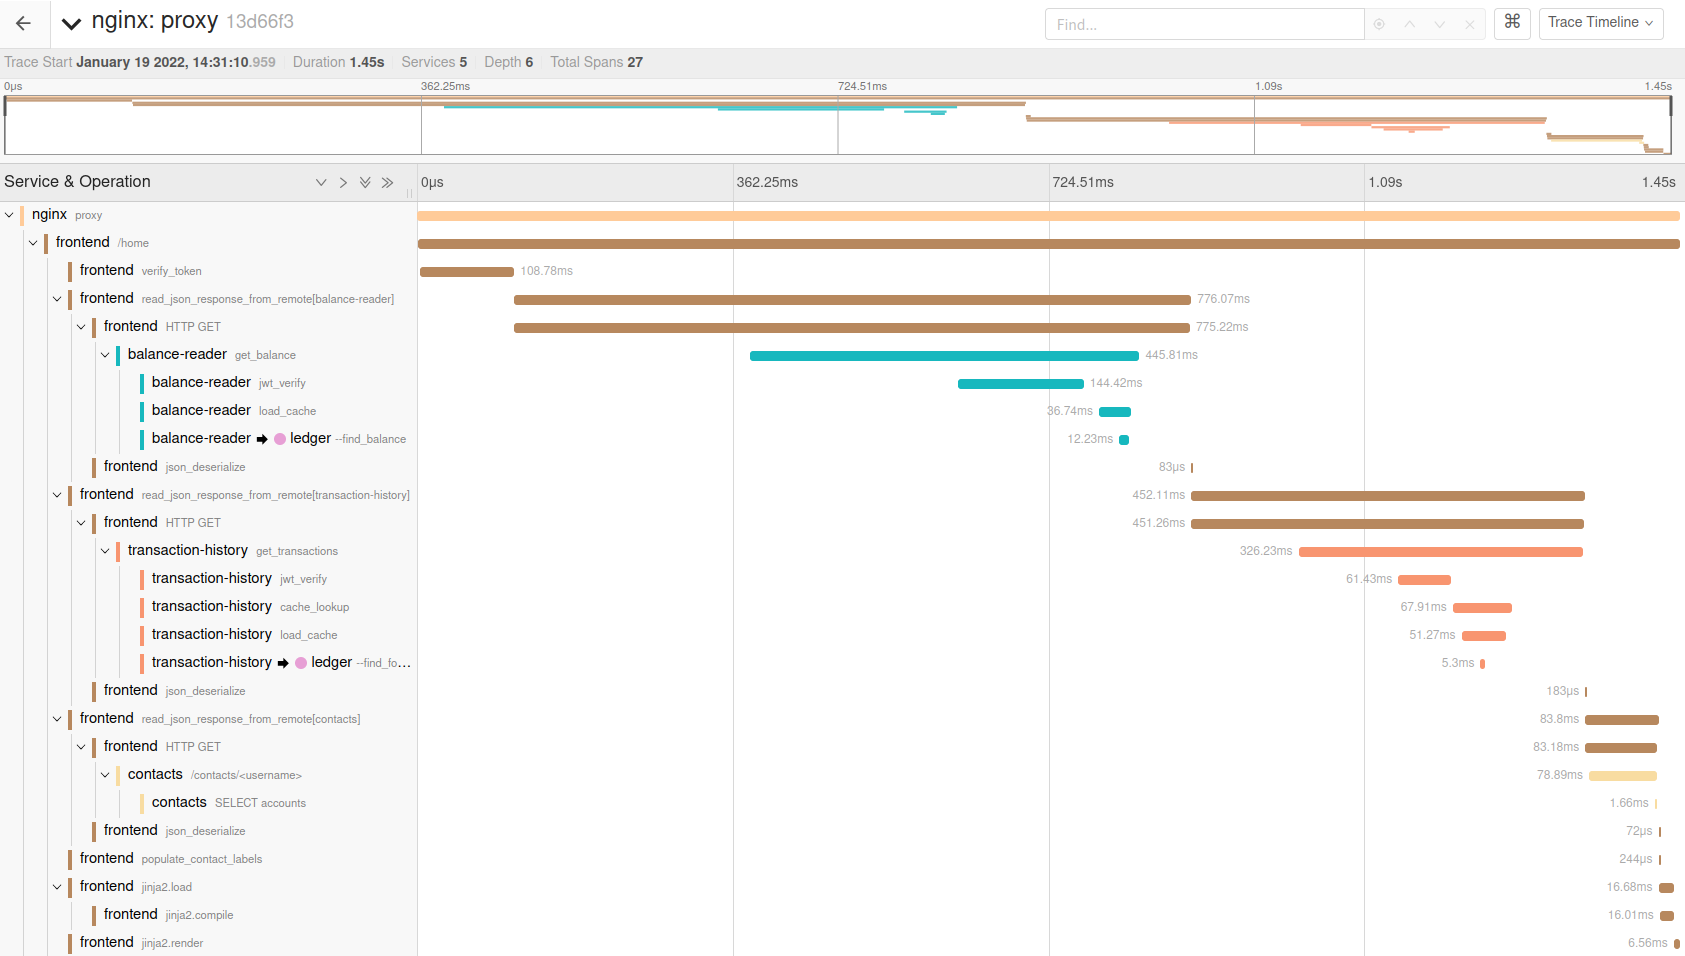
コードにトレーシングを直接実装する前に、まずOpenTelemetry Collectorを設定し、すべてのトレースデータをローカルで稼働するJaegerインスタンスに出力して、結果を確認しやすくしました。これにより、OpenTelemetryを全面的に統合する方法を検討しながら、トレースデータの表示方法を試すことができ、非常に役立ちました。たとえば、HTTPクライアントライブラリが依存先のサービスを呼び出す際にトレースデータを含めていないことがわかれば、すぐに修正リストに追加しました。Jaegerでは、1つのトレースに含まれるさまざまなスパンを、次のように見やすく表示できます。
Pythonの分散トレーシング
Pythonコードへのトレースの追加は比較的簡単でした。すべてのサービスから参照する2つのPythonソースファイルを追加し、各サービスのrequirements.txtファイルを更新して、関連するopentelemetry-instrumentation-*の依存関係を含めました。これにより、すべてのPythonサービスで同じトレーシング設定を使用できるようになったほか、各リクエストのトレースIDをログメッセージに含めたり、依存先サービスへのリクエストに埋め込んだりできるようになりました。
Javaの分散トレーシング
次に、Javaサービスに目を向けました。新規プロジェクトでOpenTelemetry Javaライブラリを直接使用するのは比較的簡単です。必要なライブラリをインポートし、トレーシングAPIを直接使用するだけです。ただし、私たちと同じようにSpringを使用している場合は、さらに検討すべき事項があります。
Springには、分散トレーシングAPIとしてSpring Cloud Sleuthがすでに用意されています。これは、基盤となる分散トレーシング実装に対するファサードを提供し、ドキュメントに記載されているとおり、以下の処理を行います。
- トレースIDとスパンIDをSlf4J MDCに追加し、ログアグリゲーターで特定のトレースまたはスパンに属するすべてのログを抽出できるようにします。
- Springアプリケーションの一般的な入出力ポイント(サーブレットフィルター、rest template、スケジュールされたアクション、メッセージチャネル、feign client)を計装します。
- If
spring-cloud-sleuth-zipkinが利用可能な場合、……HTTP経由でZipkin互換のトレースを[生成してレポートします]。デフォルトでは、localhost(ポート9411)上のZipkinコレクターサービスにトレースを送信します。サービスの場所を設定するには、spring.zipkin.baseUrlを使用します。
このAPIを使用すると、@Scheduledアノテーションが付いたタスクにもトレースを追加できます。
つまり、Spring Cloud Sleuthだけで、特別な設定をせずにHTTPサービスのエンドポイントレベルのトレースを取得できるのは、うれしいメリットです。このプロジェクトではすでにSpringを使用しているため、すべてをそのフレームワーク内に収め、提供されている機能を活用することにしました。しかし、すべてを連携させるために使用したMavenで、いくつかの問題が見つかりました。
- The Spring Cloud Sleuth Autoconfigure moduleは、まだマイルストーンリリースの段階です。
- Spring Cloud Sleuth Autoconfigureモジュールは、古いアルファ版の
opentelemetry-instrumentation-apiに依存しています。現在、このライブラリには、アルファ版ではない最近の1.xリリースはありません。 - このプロジェクトでは、親プロジェクトオブジェクトモデル(POM)である
spring-cloud-buildをSpring Snapshotリポジトリから取得する必要があります。これは、Spring Cloud Sleuthでのマイルストーンリリース向けの依存関係参照の記述方法によるものです。
このため、Maven Centralに加えてSpringリポジトリからもMavenで取得する必要があり、Mavenプロジェクトの定義が少し複雑になりました。これは、Spring CloudでのOpenTelemetryサポートがいかに初期段階にあったかを明確に示しています。それでも作業を進め、Spring Cloud SleuthとOpenTelemetryを使用して分散トレーシングを構成するための共通テレメトリモジュールを作成しました。このモジュールには、テレメトリ関連のさまざまなヘルパー関数や拡張機能も備えました。
共通テレメトリモジュールでは、以下を提供することで、Spring Cloud SleuthとOpenTelemetryのライブラリが提供するトレーシング機能を拡張しています。
- Spring対応の
Autoconfigurationクラスが、プロジェクトのトレーシングと拡張機能を設定し、追加のトレースリソース属性を読み込みます。 - NoOpインターフェイスの実装により、すべてのSpring Cloud SleuthインターフェイスにNoOpインスタンスを注入することで、起動時にトレーシングを無効にできます。
- A トレース命名インターセプター(トレース名の正規化用)。
- An エラーハンドラー(slf4jとSpring Cloud Sleuthのトレーシングを通じてエラーを出力)
- An 拡張実装されたトレース属性で、出力される各トレースに、サービスのバージョン、サービスインスタンスID、マシンID、ポッド名、コンテナーID、コンテナー名、名前空間名などの追加情報をエンコードします。
- A トレース用ステートメントインスペクターは、Hibernateが発行するSQL文の前に付けるコメントにトレースIDを挿入します。現在では、これはSQLCommenterでも実現できるようですが、まだ移行していません。
さらに、Spring互換のHTTPクライアントを実装しました。これはApache HTTP Clientを基盤とし、サービス間のHTTP呼び出しでより多くのメトリクスと高いカスタマイズ性を得ることを目的としています。この実装では、依存先のサービスを呼び出す際にトレース識別子とスパン識別子をヘッダーとして渡すことで、トレース出力に含められるようにしています。また、HTTP接続プールのメトリクスも提供し、OpenTelemetryがこれらを集約します。
総じて、Spring Cloud SleuthとOpenTelemetryを連携させてトレーシングを機能させるには苦労しましたが、それだけの価値はあったと考えています。このプロジェクトと記事が、同じ取り組みを進めたい方々の道しるべになれば幸いです。
NGINXの分散トレーシング
リクエストのライフサイクル全体にわたってすべてのサービスをつなぐトレースを取得するには、OpenTelemetryをNGINXに統合する必要がありました。このために、OpenTelemetry NGINX module(現在もベータ版)を使用しました。NGINXのすべてのバージョンで動作するモジュールのバイナリを入手するのは難しい可能性があると考え、サポート対象外のNGINXモジュールを組み込んだコンテナーイメージのGitHubリポジトリを作成しました。毎晩ビルドを実行し、モジュールのバイナリを容易にインポートできるDockerイメージを通じて配布しています。
このプロセスは、ビルドプロセス(NGINX Ingress Controller、MARAプロジェクト)にまだ統合していませんが、近いうちに統合する予定です。
メトリクス収集の実装
OpenTelemetryによるトレースの統合を完了した後、次にメトリクスに取り組みました。Pythonベースのアプリケーションには既存のメトリクスがなく、追加は当面見送ることにしました。Javaアプリケーションについては、元のBank of Anthosのソースコードが、MicrometerをGoogle CloudのStackdriverと組み合わせて使用し、メトリクスをサポートしています。ただし、このコードではメトリクスのバックエンドを設定できなかったため、Bank of Anthosをフォークした後、Bank of Siriusから削除しました。それでも、メトリクス用のフックがすでに存在していたことは、メトリクスを適切に統合する必要性を示していました。
設定可能で実用的なソリューションを実現するために、まずOpenTelemetry JavaライブラリとMicrometerのメトリクスサポートを調べました。両者の比較情報を検索すると、OpenTelemetryのメトリクス機能は執筆時点でまだアルファ版であるにもかかわらず、JVMでメトリクスAPIとして使用した場合のOpenTelemetryの欠点を列挙した記事がいくつも見つかりました。Micrometerは、JVM向けの成熟したメトリクスファサード層です。slf4jと同様に、独自のメトリクス実装を提供するのではなく、設定可能なメトリクス実装の窓口となる共通APIラッパーを提供します。興味深いことに、SpringのデフォルトのメトリクスAPIでもあります。
この時点で、以下の事実を考慮して検討していました。
- OpenTelemetry Collectorは、Prometheus、StatsD、ネイティブのOpenTelemetry Protocol(OTLP)など、ほぼあらゆるソースからメトリクスを取り込むことができます。
- Micrometerも、PrometheusやStatsDをはじめとする多数のメトリクスバックエンドをサポートしています。
- JVM向けのOpenTelemetry Metrics SDKは、OTLP経由でのメトリクス送信をサポートしています。
いくつかの実験を経て、Prometheusをバックエンド実装とするMicrometerファサードを使用し、OpenTelemetry CollectorがPrometheus APIを使ってアプリケーションからメトリクスをプルするように設定するのが、最も現実的な方法だと判断しました。OpenTelemetryで未対応のメトリクスタイプがあると問題が生じる可能性があることは、多くの記事から認識していました。ただし、今回のユースケースではそれらのタイプは不要なため、この妥協は許容できました。
OpenTelemetry Collectorについて、興味深いことが1つわかりました。トレースはOTLP経由、メトリクスはPrometheus API経由で受信するように設定していても、両方のデータをOTLPまたはその他のサポート対象プロトコルで外部のデータ受信先に送信するように設定できます。これにより、LightStepを使ってアプリケーションを簡単に試すことができました。
全体として、Javaでのメトリクスの実装は比較的簡単でした。サンプルやチュートリアルが豊富なMicrometer APIに準拠して実装したためです。メトリクスとトレーシングの両方でおそらく最も難しかったのは、pom.xmlファイル(telemetry-common用)のMaven依存関係グラフを正確に設定することでした。
エラー集約の実装
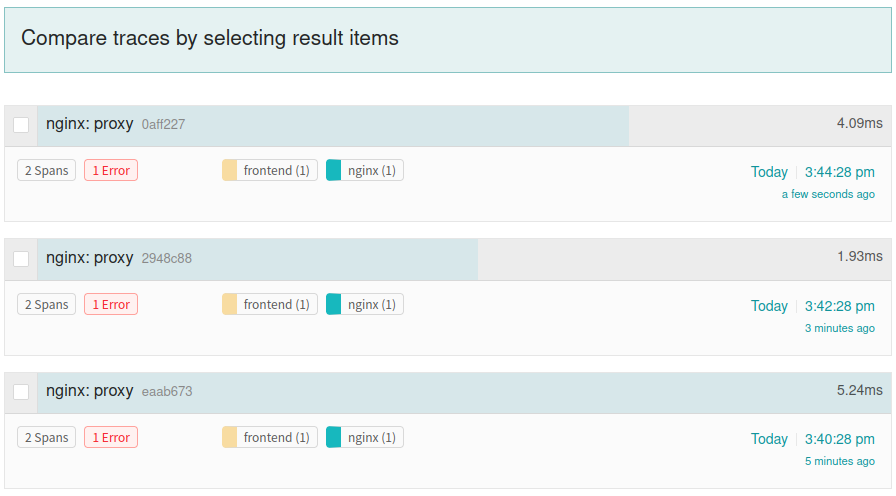
OpenTelemetryプロジェクトは、エラー集約そのものを使命には掲げておらず、エラーのタグ付けの実装も、SentryやHoneybadger.ioなどのソリューションほど洗練されていません。それでも、別のツールを追加するのではなく、当面はOpenTelemetryをエラー集約に使うことにしました。Jaegerのようなツールでは、error=trueを検索して、エラー状態を含むすべてのトレースを見つけることができます。これにより、少なくとも、どのような問題がよく発生しているかを把握できます。将来的には、Sentryとの連携の追加を検討する可能性もあります。
ヘルスチェックとランタイムイントロスペクションの実装
このアプリケーションでは、ヘルスチェックによって、サービスが正常かどうか、または起動フェーズが完了したかどうかをKubernetesに通知します。サービスが正常でない場合は、インスタンスを終了または再起動するようにKubernetesを設定できます。このアプリケーションでは、ドキュメントが不十分だと判断したため、OpenTelemetryのヘルスチェックを使用しないことにしました。
代わりに、JVMサービスには、SpringプロジェクトのSpring Boot Actuatorを使用しています。これは、ヘルスチェック用エンドポイントに加え、実行時の内部状態の確認やヒープダンプ用のエンドポイントも提供します。Pythonサービスには、Flask Management Endpoints moduleを使用しています。これはSpring Boot Actuatorの機能の一部を提供するもので、現時点ではカスタマイズ可能なアプリケーション情報とヘルスチェックのみを提供しています。
Spring Boot ActuatorはJVMおよびSpringと連携し、イントロスペクション、監視、ヘルスチェック用のエンドポイントを提供します。また、各エンドポイントが返すデフォルトのデータにカスタム情報を追加するためのフレームワークも提供します。これらのエンドポイントでは、キャッシュの状態、実行環境、データベースのマイグレーション、ヘルスチェック、カスタマイズ可能なアプリケーション情報、メトリクス、定期ジョブ、HTTPセッションの状態、スレッドダンプなどについて、実行時の内部情報を取得できます。
Spring Boot Actuatorのヘルスチェックエンドポイントはモジュール構成になっており、livenessまたはreadinessに分類される複数の個別チェックを組み合わせて、サービスの健全性を確認できます。すべてのチェックモジュールを表示する完全なヘルスチェックも利用でき、通常はこのように表示されます。
情報提供用エンドポイントは、JSONドキュメント内で、単一の上位JSONオブジェクトと階層構造を持つ一連のキーと値として定義されます。通常、このドキュメントには、サービス名とバージョン、アーキテクチャ、ホスト名、OS情報、プロセスID、実行可能ファイル名に加え、マシンIDや一意のサービスIDなど、ホストに関する詳細情報が記載されます。
ヒープダンプとコアダンプの実装
「ツールの機能と要件リストの比較」の表でご紹介したとおり、いずれのツールもランタイムイントロスペクションやヒープダンプ、コアダンプに対応していません。ただし、基盤となるフレームワークのSpringは、どちらの機能にも対応しています。とはいえ、これらのオブザーバビリティ機能をアプリケーションに組み込むには、多少の作業が必要でした。前のセクションで詳しく説明したとおり、ランタイムイントロスペクションにはPythonモジュールとSpring Boot Actuatorを組み合わせて使用しています。
同様に、ヒープダンプについても、Spring Boot Actuatorが提供するスレッドダンプ用エンドポイントを使用して、求めていた機能の一部を実現しています。必要なときにコアダンプを取得することも、理想とする細かい粒度でJVMのヒープダンプを取得することもできませんが、わずかな追加作業で必要な機能の一部を実現できています。残念ながら、Pythonサービスのコアダンプにはかなりの追加作業が必要なため、対応を後回しにしています。
まとめ
何度も泣き、自分たちの人生の選択にまで疑問を抱いた末に、MARAのオブザーバビリティには次の技術を使用することに落ち着きました(以下、OTelはOpenTelemetryを指します)。
- ログ収集(すべてのコンテナ対象)– Filebeat → Elasticsearch / Kibana
- 分散トレーシング
- Java – Spring Cloud Sleuth → Spring Cloud SleuthのOTel用エクスポーター → OTel Collector → Jaeger、Lightstep、Splunkなどのプラグイン可能なエクスポーター
- Python – OTel Pythonライブラリ → OTel Collector → 差し替え可能なストア
- NGINXとNGINX Plus(NGINX Ingress Controllerはまだサポートされていません)– NGINX OTelモジュール → OTel Collector → プラガブルなエクスポーター
- メトリクスの収集
- Java – Spring経由のMicrometer → Prometheusエクスポーター → OTel Collector
- Python – まだ実装されていません
- Python WSGI – GUnicorn StatsD → Prometheus(StatsD / ServiceMonitor経由)
- NGINX – Prometheusエンドポイント → Prometheus(ServiceMonitor経由)
- エラー集約 – OTel分散トレース → プラグイン可能なエクスポーター → エクスポーターの検索機能で、次のマークが付いたトレースを検索:
error - ヘルスチェック
- Java – Spring Boot Actuator → Kubernetes
- Python – Flask Management Endpointsモジュール → Kubernetes
- ランタイムイントロスペクション
- Java – Spring Boot Actuator
- Python – Flask Management Endpointsモジュール
- ヒープダンプとコアダンプ
- Java – スレッドダンプに対応するSpring Boot Actuatorのサポート
- Python – 現時点では未対応
この実装は、現時点の状態を示すものです。開発が進むにつれて、確実に変化し、進化していきます。近いうちに、アプリケーションに対して大規模な負荷テストを実施する予定です。これにより、現在のオブザーバビリティのアプローチにおける課題について多くの知見を得て、オブザーバビリティ機能を追加できると考えています。
ぜひModern Apps Reference Architectureとサンプル アプリケーション(Bank of Sirius)をお試しください。改善のアイデアがありましたら、GitHubリポジトリへのご協力をお待ちしています。
関連記事
この記事はシリーズの一部です。MARAに機能を順次追加するのに合わせて、その詳細をブログで公開しています。
- 新しいオープンソースのモダンアプリケーション向けリファレンスアーキテクチャ
- Modern Apps Reference ArchitectureへのOpenTelemetryの統合 – 進捗報告 (本記事)
- MARA:身近なワークステーションで実行可能に
- NGINX Modern Apps Reference Architectureバージョン1.0.0の発表
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。
SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります