NGINX Plus R9では、UDPトラフィックのリバースプロキシと負荷分散が可能になり、NGINX Plusのレイヤー4負荷分散機能が大幅に強化されました。
このブログ記事では、最新のアプリケーションインフラストラクチャでDNSサーバーを運用する際の課題を取り上げ、NGINX Open SourceとNGINX Plusのどちらでも、UDPトラフィックとTCPトラフィックを効果的かつ効率的に負荷分散できることを説明します。(アプリケーションの[アクティブ]ヘルスチェックはNGINX Plusのみの機能ですが、それ以外の内容はNGINX Open Sourceにも同様に当てはまります。簡潔にするため、以降はNGINX Plusと表記します)。
[編集者注:NGINX Plus R9のすべての新機能の概要については、ブログ記事「NGINX Plus R9の発表」をご覧ください。]
UDPトラフィックを負荷分散する理由
TCPとは異なり、UDPはその設計上、データがエンドツーエンドで確実に配信されることを保証しません。これは伝書鳩でメッセージを送るようなものです。送信したことは確実に分かりますが、届いたかどうかは確認できません。この「コネクションレス」方式にはいくつかの利点があります。特に、UDPでは個々のメッセージが小さいため使用する帯域幅が少なく、接続を確立するためのハンドシェイクも不要なので、TCPよりもレイテンシーを抑えられます。一方、タイムアウトなどのネットワークレベルの問題を検出する処理は、アプリケーション開発者が実装する必要があります。では、これはDNSにとって何を意味するのでしょうか。
他のいくつかのUDPベースのプロトコルと同様に、DNSではリクエスト/レスポンス型のデータフローが使用されます。たとえば、DNSクライアントがホスト名に対応するIPアドレスを問い合わせると、応答が返されます。所定のタイムアウト時間内に応答がない場合、DNSクライアントは同じリクエストを「バックアップ」DNSサーバーに送信します。しかし、リクエストを再試行するまでタイムアウトを待つ必要があるため、通常はミリ秒単位で完了する非常に高速な処理が、秒単位の非常に遅い処理になることがあります。
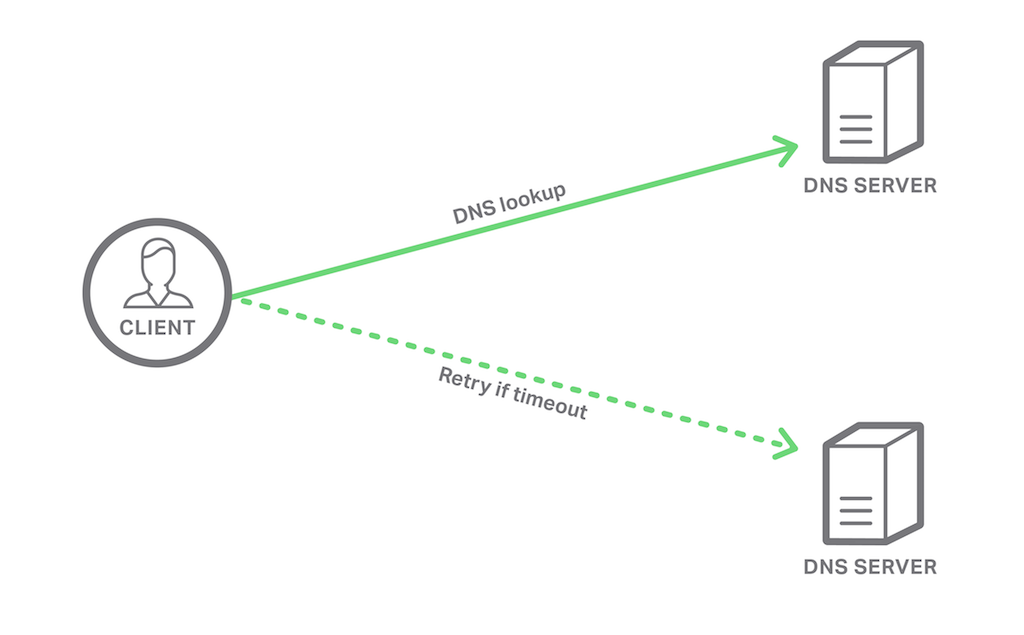
NGINX Plusを使用してDNSトラフィックをプロキシし、負荷分散することで、クライアントでタイムアウトが発生する頻度を低減できます。NGINX Plusロードバランサーの背後に複数のDNSサーバーを配置すると、クライアントでタイムアウトが発生するのは、クライアントとNGINX Plusの間でネットワークパーティションが発生した場合に限られます。NGINX Plusでアプリケーションヘルスチェックを使用すると、DNSサーバー自体の問題がクライアントに影響することはありません。NGINX Plusは各サーバーの可用性と応答時間を監視し、正常でないサーバーへのクライアントリクエストの送信を回避します。
DNSはUDPだけのプロトコルではない
DNSトラフィックの大部分はUDPを使用しますが、一般的なDNS処理の中にはTCPを使用するものもあります。DNSでは、小さいメッセージ(最大512 バイト)にはUDPを使用し、より大きなメッセージを必要とする(または必要とする可能性が高い)処理にはTCPを使用します。従来、DNSでTCPが使用されるのは、権威プライマリネームサーバーからセカンダリネームサーバーへのゾーン転送に限られていました。しかし、コンテナとイミュータブルインフラストラクチャへの移行に伴い、DNSはSRVレコードを使用する主要なサービスディスカバリメカニズムとして、ますます利用されるようになっています。
DNS SRVレコードは元々、Voice over IP(VoIP)ハンドセットがSIPを使用してサーバーを検出するために導入されましたが、あらゆる種類のサービスに使用できます。ただし、SRVレコードには、他のほとんどのDNSレコードタイプよりもはるかに多くの情報が含まれます。そのため、標準の512 バイトのUDP応答に収まるのは約10件のSRVレコードのみです。これに対し、Aレコードは約30件収まります。DNS応答が512 バイトの上限を超えると、先頭の512 バイトが返されますが、応答には「切り詰め」と示すフラグが設定されます。この場合、DNSクライアントは切り詰められた応答を可能な範囲で処理するか、TCPを使用して同じリクエストを再試行できます。
つまり、最新のネットワークインフラストラクチャでDNSサーバーの負荷分散を行う場合、NGINX PlusはUDPトラフィックとTCPトラフィックの両方を受信することが想定されます。
マイクロサービス環境におけるDNS
次の図は、2つのロードバランサーを備えたマイクロサービス環境を簡略化して示しています。フロントエンドのロードバランサーは、アプリケーションのパブリッククライアントからのリクエストをプロキシし、最適なマイクロサービスインスタンスを選択するとともに、その他の多くの機能を実行しますが、ここでは説明しません。ここでは、マイクロサービス環境と、マイクロサービスにサービスディスカバリ情報を提供するDNSサーバーとの間に配置されるDNSロードバランサーに焦点を当てます。
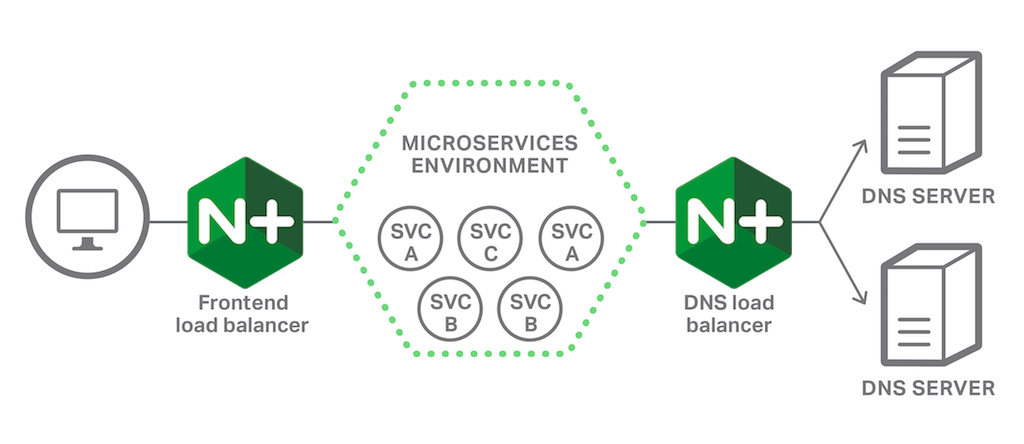
基本的なDNSロードバランシングの設定
NGINX Plusでは、レイヤー4ロードバランシングがStreamモジュールに実装されているため、UDPおよびTCPのロードバランシングは、次のスニペットに示すようにstreamブロックで設定します。
警告:この構成スニペットを新しいファイルとして/etc/nginx/conf.dディレクトリに追加するだけでは機能しません。デフォルトのNGINX Plus nginx.conf構成ファイルでは、conf.dディレクトリ内のファイルの内容がhttpブロックにインクルードされるため、検証エラー(「stream directive is not allowed here」)が発生します。最も簡単な解決策は、完全なstreamブロックをnginx.confに直接記述することです。
stream {    upstream dns_servers {
        server 192.168.136.130:53;
        server 192.168.136.131:53;
    }

    server {
        listen 53  udp;
        listen 53; #tcp
        proxy_pass dns_servers;
        error_log  /var/log/nginx/dns.log info;
    }
}まず、DNSサーバーのアップストリームグループを定義します。serverディレクティブでは、アップストリームサーバーがリッスンするポート番号として、DNSのウェルノウンポートである53を指定します。
The server{}ブロックでは、NGINX Plusが受信DNSトラフィックを処理する方法を定義します。2つのlistenディレクティブにより、NGINX PlusはUDPとTCPの両方のトラフィックをポート53で待ち受けます。TCPはStreamモジュールのデフォルトのレイヤー4プロトコルであるため、UDPの場合とは異なり、パラメーターとして明示的に指定する必要はありません。
The proxy_passディレクティブは、NGINX Plusがリッスンしているトラフィックの転送先を指定します。ここでは、このトラフィックをdns_serversアップストリームグループにプロキシします。NGINX Plusは、クライアントのUDPリクエストをアップストリームサーバーに転送する際にはUDPを(クライアントのTCPリクエストにはTCPを)自動的に使用するため、アップストリームグループでレイヤー4プロトコルを明示的に指定する必要はありません。
Streamモジュールにはaccess_logディレクティブがありません。これは、NGINX PlusがHTTPパケットの場合とは異なり、TCPセグメントやUDPデータグラムのペイロードを検査しないためです。ただし、error_logディレクティブにinfoパラメーターを指定すると、接続処理とプロキシイベントをログに記録できます。
[編集者注:このブログの公開後、NGINX Open Source 1.11.4およびNGINX Plus R11で、Streamモジュールのアクセスログが有効になりました。]
高可用性のためのチューニング
DNSサーバーの可用性を向上させるために、さらにいくつかのディレクティブを追加し、アクティブ(アプリケーション)ヘルスチェックを設定できます。
プロキシ応答数とタイムアウト時間の設定
1つ目の追加ディレクティブはproxy_responsesです。これは、プロキシされたUDPリクエストごとにNGINX Plusが想定するレスポンス数を指定します。この例では、NGINX Plusはレスポンスを1つ受信すると、それ以上のレスポンスを待機せず、そのセッションで使用していたメモリとソケットを解放します。
2つ目の追加ディレクティブである「proxy_timeout」は、NGINX Plusがサーバーからの応答を待機する時間を指定します(ここでは、デフォルトの10分から1秒に短縮しています)。この時間内に応答がない場合、NGINX Plusはアップストリームグループ内の次のサーバーへの接続を試み、応答しなかったアップストリームサーバーを一定期間(デフォルトでは10秒)利用不可としてマークします。これにより、その間、他のクライアントでタイムアウトによる遅延が発生するのを防ぎます。
server {    listen 53  udp;
    listen 53; #tcp
    proxy_pass      dns_servers;
    error_log       /var/log/nginx/dns.log info;
    proxy_responses 1;
    proxy_timeout 1s;
}また、アップストリームグループのfail_timeoutオプションをserverディレクティブに指定することで、サーバーが利用不可と見なされる時間を変更できます。次の設定では、NGINX Plusは障害が発生したアップストリームサーバーを60秒間利用不可と見なします。
upstream dns_servers {    server 192.168.136.130:53 fail_timeout=60s;
    server 192.168.136.131:53 fail_timeout=60s;
}
これにより、いずれかのDNSサーバーに障害が発生した場合に、クライアントで生じる遅延を制御できます。ただし、障害が発生したDNSサーバーにTCPリクエストが送信されると、TCPに組み込まれたエラーチェック機能により、NGINX Plusはそのサーバーを自動的に利用不可としてマークし、以降はそのサーバーへのTCPまたはUDPリクエストを回避します。
アクティブヘルスチェックの設定
NGINX Plusのアクティブヘルスチェック機能は、DNSを含むあらゆる負荷分散サービスの高可用性を実現するうえで、非常に有用な追加ツールです。DNSクライアントからの実際のTCPリクエストが失敗してからDNSサーバーをダウンと判定するのではなく、health_checkディレクティブとそのport=53パラメーターをserver{}ブロックに含めることで、NGINX Plusがポート53へのTCP接続を定期的に試行し、DNSサーバーが稼働中で正常に動作しているかどうかを確認します。(NGINX Plusはデフォルトで、listenディレクティブに指定されたポート(この場合は53)にヘルスチェックを送信します。そのため、ここではこのパラメーターを使用してデフォルト値を明示的に設定していますが、DNSサーバー側も別のポートへのトラフィックに応答するよう変更すれば、そのポートを指定することもできます。)
UDPでは、さらに一歩進めて、既知のレコードを実際にDNS検索するアクティブヘルスチェックを設定できます。たとえば、マイクロサービス環境内のサービスディスカバリに使用するものと同じサブドメインのゾーンファイルに、次のCNAMEレコードを追加できます。
healthcheck IN CNAME healthy.svcs.example.com.UDPは軽量なプロトコルであるため、ネットワークトラフィックを監視し、DNSルックアップを表すバイト列を容易に抽出できます。次に、その文字列をmatch設定ブロックのsendディレクティブのパラメーターとして指定します。expectディレクティブでは、サーバーが正常と見なされるために返す必要がある応答を指定します。
match dns_lookup {
    send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...;
    expect ~* "healthy.svcs.example.com.";
}
この詳細なアプリケーションレベルのヘルスチェックでは、ネームサーバーが稼働している場合でも、本番ドメインに対して実際にDNSルックアップを実行することで、放置すると後続処理で問題を引き起こす可能性のある設定上の問題やデータ破損を検出できます。
The NGINX Plusサポートチームは、DNSルックアップやその他のプロトコル向けのUDPヘルスチェックの準備を支援します。
次のスニペットでは、アクティブヘルスチェックに必要な追加ディレクティブを示します。
stream {    upstream dns_servers {
        zone dns_mem 64k;
        server 192.168.136.130:53 fail_timeout=60s;
        server 192.168.136.131:53 fail_timeout=60s;
    }

    match dns_lookup { send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...; expect ~* "healthy.svcs.example.com."; }

    server {
        listen 53  udp;
        listen 53; #tcp
        health_check match=dns_lookup interval=20 fails=2 passes=2 udp;
        health_check interval=20 fails=1 passes=2 port=53; #tcp
        proxy_pass      dns_servers;
        error_log       /var/log/nginx/dns.log debug;
        proxy_responses 1;
        proxy_timeout   1s;

    }
}
The zoneディレクティブは、dns_memという共有メモリゾーンを定義します。これにより、ヘルスチェックの結果(およびその他の状態情報)をすべてのNGINX Plusワーカープロセスで利用できるようになります。
The matchディレクティブについては、すぐ上で説明しています。
The health_checkディレクティブには、環境に合わせて調整できるパラメーターが複数あります。ここでは、UDPとTCPにそれぞれ個別のヘルスチェックを定義します。UDPとTCPの違いを考慮し、DNSサーバーを異常と判定する条件を、UDPではヘルスチェックが2回連続で失敗した場合、TCPでは1回失敗した場合としています。どちらのプロトコルでも、サーバーを再び正常と判定するには2回の応答成功を必要とし、状態が頻繁に変動する不安定なサーバーにリクエストが送信されないようにします。
UDPとTCPの両方のトラフィックに対してDNSサーバーのアップストリームグループを1つだけ定義すると、いずれかのプロトコルのヘルスチェックに失敗した場合に、そのサーバーが異常と判定され、負荷分散プールから除外されるという利点があります。
スケーラビリティ向上のためのチューニング
バックエンドサーバーを2台だけ導入することも効果的な高可用性ソリューションとなり得ますが、NGINX Plusの負荷分散機能を使用すれば、クライアントに意識させることなくバックエンドサーバーを水平方向にスケールできます。
前述のサンプルマイクロサービス環境では、バックエンドDNSサーバーのスケーリングが必要になる可能性は低いでしょう。一方、すべての加入者にDNSサービスを提供するISPでは、継続的な負荷に加えて負荷が急増する可能性もあるため、多数のDNSサーバーと、それらのサーバー間でトラフィックを負荷分散するフロントエンドプロキシが必要になります。
NGINXおよびNGINX Plusのすべての負荷分散アルゴリズムは、HTTPだけでなくTCPとUDPでも利用できます。
- ラウンドロビン(デフォルト)
- 汎用ハッシュとそのコンシステントハッシュ版(ketamaアルゴリズム)
- IPハッシュ
- 最小接続数
- Least Time(NGINX Plusのみ)
(すべてのアルゴリズムに重みを設定して、効率をさらに高めることもできます。詳しくは、F5のブログ記事「NGINX Plusの負荷分散手法の選択」の重みに関するセクションをご覧ください。)
HTTPリクエストがバックエンドサーバーにかける負荷や処理要件は大きく異なる場合がありますが、DNSリクエストが生成する負荷は通常どれも同じです。そのため、Least ConnectionsアルゴリズムとLeast Timeアルゴリズムは、Round Robinよりも優位になる可能性が低いと考えられます。特にLeast Connectionsでは、NGINX Plusがアップストリームサーバーからの応答を待機しているUDPリクエストも接続数に含まれます。proxy_responsesとproxy_timeoutの値で指定された条件に達していない限り、NGINX Plusは、すでに処理を完了している可能性があるアップストリームサーバーへの接続も引き続きカウントします。
多数のクライアントが存在し、RADIUSのチャレンジレスポンスフローのように、クライアントとサーバー間で複数のメッセージをやり取りする「対話」の多いプロトコルを使用する場合、送信元IPハッシュを使用すると、その対話を単一のバックエンドサーバーで処理できます。つまり、セッション維持が確立され、NGINX Plusは特定のクライアントからのすべてのリクエストを同じサーバーに転送します。次の例では、送信元(クライアント)IPアドレス($remote_addr変数で取得)をキーとして、2台のRADIUS認証サーバーにHashロードバランシングアルゴリズムを設定します。
upstream radius_servers {    hash $remote_addr; # Source-IP hash
    server 192.168.136.201:1812;
    server 192.168.136.202:1812;
}
詳細情報
UDPおよびTCPの負荷分散の詳細については、以下のリソースをご覧ください。
- TCPおよびUDPの負荷分散(NGINX Plus管理者ガイド)
- NGINX「Stream」モジュールと「
upstream」設定コンテキスト - 導入ガイド:TCPベースとHTTPベースの両方のトラフィックを処理する必要があるMicrosoft® Exchange™サーバーの負荷分散
- NGINX PlusとGalera ClusterによるMySQLの高可用性<.htmla>(TCPロードバランシングのユースケース)
NGINX Plus R9のその他の優れた機能については、ブログ記事「NGINX Plus R9の発表」をご覧いただき、オンデマンドウェビナー「NGINX Plus R9の新機能」をご視聴ください。
NGINX Plusをお試しいただくには、今すぐ30日間の無料トライアルを開始するか、ユースケースについてご相談ください。
著者について

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります