2023年1月に、多数の重要な新機能と機能強化を盛り込んだバージョン3.0の「NGINX Ingress Controller」をリリースしました。新機能の中でも特に有用なのが、NGINX Ingress ControllerのNGINX Plusエディションで利用できるDeep Service Insightです。
Deep Service Insightは、1つ以上のKubernetesクラスターの前段にロードバランサーなどのルーティング決定システムが配置されている場合に、最適な動作を妨げる制約に対処します。具体的には、このシステムはIngress Controllerの背後にあるクラスターで稼働する個々のサービスの正常性情報にアクセスできません。そのため、正常なサービスを提供しているクラスターだけにトラフィックをルーティングできず、ユーザーがサービス停止や404、500などのエラーに遭遇する可能性があります。
Deep Service Insightは、NGINX Ingress Controllerが収集したバックエンドサービスPodの正常性ステータスを専用エンドポイントで公開します。システムはこの情報にアクセスし、より適切なルーティング判断に活用できるため、この問題を解消できます。
この記事では、Deep Service Insightが解決する問題を詳しく取り上げ、一般的なユースケースにおける仕組みと設定方法を説明します。
Deep Service Insightが必要な理由
標準のKubernetes liveness、readiness、startupプローブからは、クラスター内で稼働するバックエンドサービスについて一定の情報を得られます。しかし、スタック全体でより適切なルーティング判断を行うために必要なレベルのインサイトは得られません。Kubernetes環境の複雑化が進み、無停止稼働に対するビジネス要件が厳しくなるほど、適切な情報が不足していることがさらに大きな問題となります。
Kubernetes環境の拡張に伴って稼働時間を向上させる一般的な方法は、クラスターの前段にロードバランサー、DNSマネージャー、その他の自動意思決定システムを導入することです。しかし、Ingressコントローラーの仕組み上、Kubernetesクラスターの前段に配置されたロードバランサーは通常、クラスター内のIngressコントローラーの背後にあるサービスのステータス情報にアクセスできません。確認できるのは、IngressコントローラーのPod自体が正常で、トラフィックを受け入れていることだけです。
一方、NGINX Ingress Controllerはサービスの正常性に関する情報を保持しています。クラスター内のアップストリームPodの正常性を監視するため、HTTP、TCP、UDP、gRPCサービスに対して定期的なパッシブヘルスチェックを実施し、リクエストへの応答状況を監視するとともに、正常なレスポンスコードなどのメトリクスを追跡しています。この情報を基に、サービスの各Podへのトラフィックの分散方法を決定し、一貫性のある予測可能なユーザーエクスペリエンスを提供します。通常、NGINX Ingress Controllerはこうした処理をバックグラウンドで目立たないように実行するため、その内部動作を意識することはほとんどありません。Deep Service Insightは、この有用な情報を「可視化」し、スタックの他のレイヤーでより効果的に活用できるようにします。
Deep Service Insightの仕組み
Deep Service Insightは、NGINXのカスタムリソースである「VirtualServer」と「TransportServer」(それぞれHTTPとTCP/UDPに対応)を使用してデプロイするサービスで利用できます。Deep Service Insightは、「NGINX Plus API」を使用し、バックエンドサービス内の個々のPodについてNGINX Ingress Controllerが把握している情報を、Deep Service Insight専用のエンドポイントで共有します。
- VirtualServerの場合 – <IP_address> :<port> /probe/<hostname>
- TransportServerの場合 – <IP_address> :<port> /probe/ts/<service_name>
各項目の意味は次のとおりです。
- <IP_address> はNGINX Ingress Controllerに属します
- <port>はDeep Service Insightのポート番号です(デフォルトは9114)
- <hostname> は、VirtualServerリソースの
spec.hostフィールドで定義されているサービスのドメイン名です - <service_name> は、
spec.upstreams.serviceフィールドで定義されているTransportServerリソースのサービス名です
出力には、次の2種類の情報が含まれます。
- ホスト名またはサービス名のHTTPステータスコード:
200OK– 少なくとも1つのPodが正常です418I’mateapot– 正常なポッドはありません404NotFound– 指定されたホスト名またはサービス名に一致するPodがありません
- 指定したホスト名またはサービス名に関する3つのカウンター:
合計サービスインスタンス(ポッド)数- ポッド数(
Up(正常)状態) - Number of pods in the
Unhealthy状態のポッド数
サービスの3つのPodがすべて正常な場合の例を次に示します。
HTTP/1.1 200 OKContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}
詳細については、NGINX Ingress Controllerの「ドキュメント」を参照してください。
アクティブヘルスチェックを設定することで、NGINX Ingress ControllerがPodを正常と判断する基準をさらにカスタマイズできます。ヘルスチェックの送信先となるパスとポート、Podを異常と見なすために指定期間内に必要なチェック失敗回数、想定されるステータスコード、接続または応答受信のタイムアウトなどを設定できます。Upstream.HealthcheckフィールドをVirtualServerまたはTransportServerリソースに含めます。
Deep Service Insightのユースケース例
Deep Service Insightが特に有用なユースケースの1つは、たとえば高可用性を確保するために2つのクラスターで稼働しているサービスへ、ロードバランサーがトラフィックをルーティングする場合です。各クラスター内では、前述のとおり、NGINX Ingress ControllerがアップストリームPodの正常性を追跡します。Deep Service Insightを有効にすると、正常なアップストリームPodと異常なアップストリームPodの数に関する情報も、専用エンドポイントで公開されます。ルーティング決定システムはこのエンドポイントにアクセスし、その情報を使用して、異常なPodを避けて正常なPodへアプリケーショントラフィックを振り分けることができます。
この図は、このシナリオにおけるDeep Service Insightの仕組みを示しています。
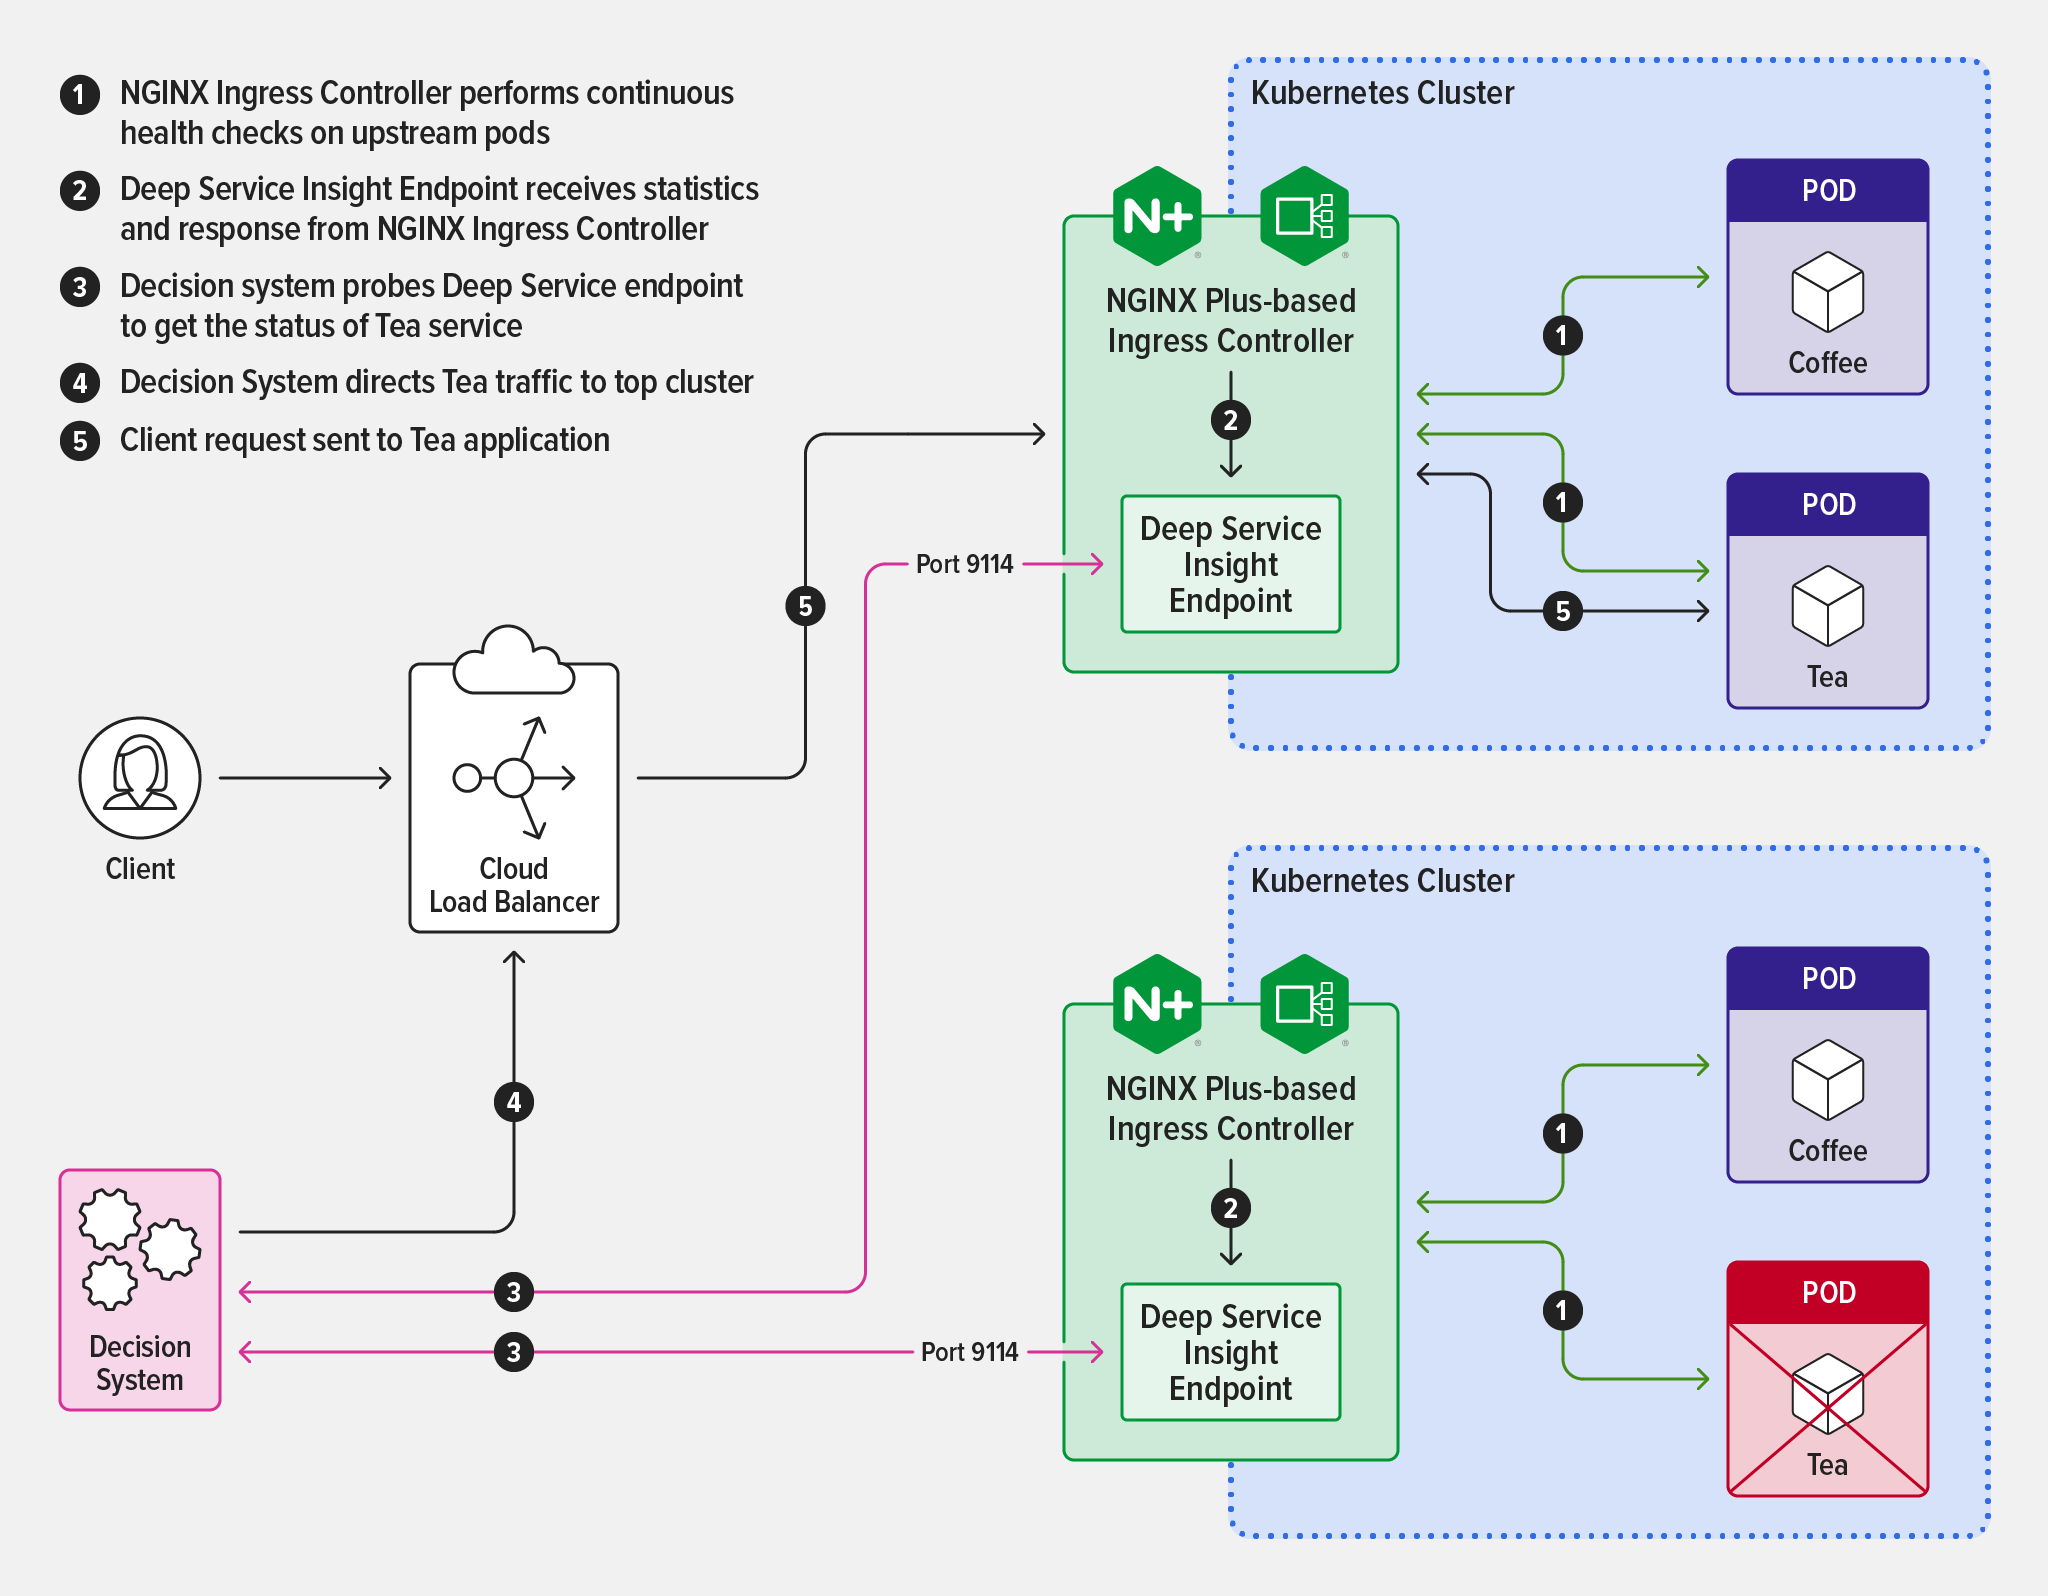
高可用性構成でクラスターのメンテナンスを行う際にも、Deep Service Insightを活用できます。メンテナンス対象のクラスターで、サービスのPod数を0にスケールダウンするだけです。正常なPodが存在しないことがDeep Service Insightエンドポイントに自動的に反映され、ルーティング決定システムはその情報を使用して、もう一方のクラスター内の正常なPodにトラフィックを送信します。NGINX Ingress Controllerとルーティング決定システムのどちらの設定も変更することなく、実質的に自動フェイルオーバーが実現し、お客さまのサービスが中断することもありません。
Deep Service Insightの有効化
Deep Service Insightを有効にするには、Kubernetesマニフェストに-enable-service-insightコマンドライン引数を含めるか、Helmを使用している場合はserviceInsight.createパラメーターをtrueに設定します。
環境に合わせてエンドポイントを調整するために、次の2つのオプション引数を指定できます。
-service-insight-listen-port<port>– Deep Service Insightのポート番号をデフォルトの9114から変更します(<port>には1024~65535の範囲の整数を指定します)。Helmでは、serviceInsight.portパラメーターに相当します。-service-insight-tls-string<secret>– Deep Service InsightエンドポイントでTLSを終端するためのKubernetesシークレット(TLS証明書とキー)です(<secret>は、次の形式の文字列です:<namespace>/<secret_name>)。対応するHelmの設定は、serviceInsight.secretパラメーターです。
例:Cafe ApplicationでDeep Service Insightを有効にする
Deep Service Insightの動作を確認するには、NGINX Ingress Controllerのドキュメントで例としてよく使用されるCafe applicationに対して有効にできます。
- NGINXカスタムリソースのサポートとDeep Service Insightを有効にして、NGINX Ingress ControllerのNGINX Plusエディションをインストールします:
- If using Helmを使用する場合は、
serviceInsight.createパラメーターをtrueに設定します。 - If using a Kubernetesマニフェスト(DeploymentまたはDaemonSet)を使用する場合は、マニフェストファイルに
-enable-service-insight引数を含めます。
- If using Helmを使用する場合は、
- NGINX Ingress Controllerが実行中であることを確認します:
$ kubectl get pods -n nginx-ingressNAME                                          READY ...
ingress-plus-nginx-ingress-6db8dc5c6d-cb5hp   1/1   ...

    ...  STATUS   RESTARTS   AGE
... Running 0 9d- 「README」の手順に従ってCafeアプリケーションをデプロイします。
- Cafeアプリケーション用のNGINX VirtualServerカスタムリソースがデプロイされていることを確認します(読みやすくするため、IPアドレスは省略しています)。
$ kubectl get vs NAME   STATE   HOST               IP    PORTS      AGE
cafe Valid cafe.example.com ... [80,443] 7h1m- CafeサービスのアップストリームPodが3つ、cafe.example.comで稼働していることを確認します:
$ kubectl get pods NAME                     READY   STATUS    RESTARTS   AGE
coffee-87cf76b96-5b85h   1/1     Running   0          7h39m
coffee-87cf76b96-lqjrp   1/1     Running   0          7h39m
tea-55bc9d5586-9z26v 1/1 Running 0 111m- Deep Service Insightエンドポイントにアクセスします:
$ curl -i <NIC_IP_address>:9114/probe/cafe.example.com- The
200OKレスポンスコードは、サービスがトラフィックを受け入れる準備ができていること(少なくとも1つのPodが正常であること)を示します。この場合、3つのPodはすべてUp状態です。
HTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}- The
418I’mateapotステータスコードは、サービスが利用できないことを示します(すべてのPodが異常な状態です)。
HTTP/1.1 418 I'm a teapotContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":0,"Unhealthy":3}- The
404NotFoundステータスコードは、指定されたホスト名で実行中のサービスがないことを示します。
HTTP/1.1 404 Not FoundDate: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 0
リソース
NGINX Ingress Controllerリリース3.0.0の完全な変更履歴については、「リリースノート」を参照してください。
NGINX PlusおよびNGINX App ProtectとともにNGINX Ingress Controllerをお試しいただくには、30日間の無料トライアルを今すぐ開始するか、ユースケースについてご相談いただくためにお問い合わせください。
著者について

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります