「パーフェクトストーム」はよく使われる表現ですが、制御不能に膨らむクラウドコンピューティングコストを説明するうえで的確です。複数の要因が相互に重なり合い、このパーフェクトストームを引き起こしています。
- ワークロードをデプロイする担当者と、その費用を負担する担当者が異なる
- インフラストラクチャは、オンデマンドかつプログラムによって簡単に利用できます
- 簡単にアクセスできるコードリポジトリを利用すれば、他者が作成した既存のコードから機能を「借用」できます
- CI/CDパイプラインとSREプラクティスは、開発者によるコードの迅速な統合とデプロイを支援します
これらを総合すると、開発者は既存のコードブロックを活用し、新機能を迅速にデプロイすることが求められています。しかし、そのコードは通常、新しいアプリでの用途に合わせて簡素化も最適化もされていません。市場投入までの時間が最優先されるため、最適化は後回し(しかも、はるか後回し)になります。最適化されていないコードがパフォーマンスを低下させても、APIを1回呼び出すだけで、より高性能なインフラストラクチャをプロビジョニングできます。これで問題解決です!
問題をさらに深刻にしているのは、コードを書く人と費用を負担する人の間に、意識と組織構造の両面で隔たりがあることです。企業のクラウドコストが増大するにつれ、CFOは頭を悩ませます。しかし、クラウド料金の増加を招いた開発者は、迅速な製品提供を評価される一方で、そのインセンティブによって生じた後々の財務上の問題には気づかないままです。
この問題を解決するため、F5 NGINXとOpsaniは提携し、既存のデプロイメントからさらなるメリットを得られる最適化ソリューションをF5 NGINX Ingress Controllerのサブスクライバーに提供します。Opsani ServoコンテナをKubeNestワークロードにデプロイすると、NGINX Ingress Controllerが最適化されます。このコンテナはPrometheusを活用して、レート、エラー、継続時間(RED)のメトリクスを収集します。Opsaniは、機械学習を活用した自律最適化機能によってインフラストラクチャを継続的に最適化し、適切な量のリソースを消費することで、パフォーマンスの向上とコストの削減を実現します。
クラウド最適化によるコスト削減
NGINXユーザーには、クラウドコストを削減する最も基本的な方法がすでにおなじみでしょう。それは、レイテンシーを最小限に抑えながら、極めて高速なパフォーマンスを実現する軽量なツールを使用することです。もちろん、Kubernetesの世界では、シンプルでありながら強力なツールが、デプロイを成功させるための前提条件となります。本ブログでは、次の3つのツールを活用して、コスト削減とパフォーマンス向上を同時に実現する方法をご紹介します。
- NGINX Ingress Controller – F5 NGINX Plusをベースとし、他のNGINXベースのIngress Controllerを大幅に上回るパフォーマンスを発揮します。イベントハンドラーや設定の再読み込みを必要とせず、バックエンドエンドポイントの変更に動的に対応できるためです。
- Opsani – CI/CDパイプラインにCOを追加できる独自のContinuous Optimization as a Service(COaaS)ソリューションです。コードを迅速にデリバリーし、可能な限り低いコストで最適なパフォーマンスを実現できるよう、そのコードを最適化します。
- Prometheus – 監視とアラート通知に広く利用されているオープンソースプロジェクトです。NGINX Plus Prometheus moduleを使用すると、NGINXnbsp;PlusベースのNGINX Ingress Controllerから数百種類のメトリクスをPrometheusサーバーにエクスポートできます。
NGINX PlusベースのNGINX Ingress Controllerの特に有力なユースケースの1つは、Kubernetesの可視性を向上させる機能です。これには、NGINX Plusダッシュボードによるリアルタイム監視と、Prometheusによる履歴データを活用します。さらに、NGINX Ingress Controllerはワークロードのフロントエンドとして、レート、エラー、処理時間(RED)のメトリクスを収集し、Prometheus経由でOpsaniに送信できます。Opsaniは機械学習を使用して、これらのメトリクスと現在デプロイされているインフラストラクチャを関連付け、NGINX Ingress Controller、アプリケーション、または技術スタック全体を最適化するための変更を推奨します。さらに、NGINX Ingress Controllerに設定したレイテンシとパフォーマンスのしきい値について通知するよう、Opsaniを構成することもできます。
数値で見る最適化テストの結果
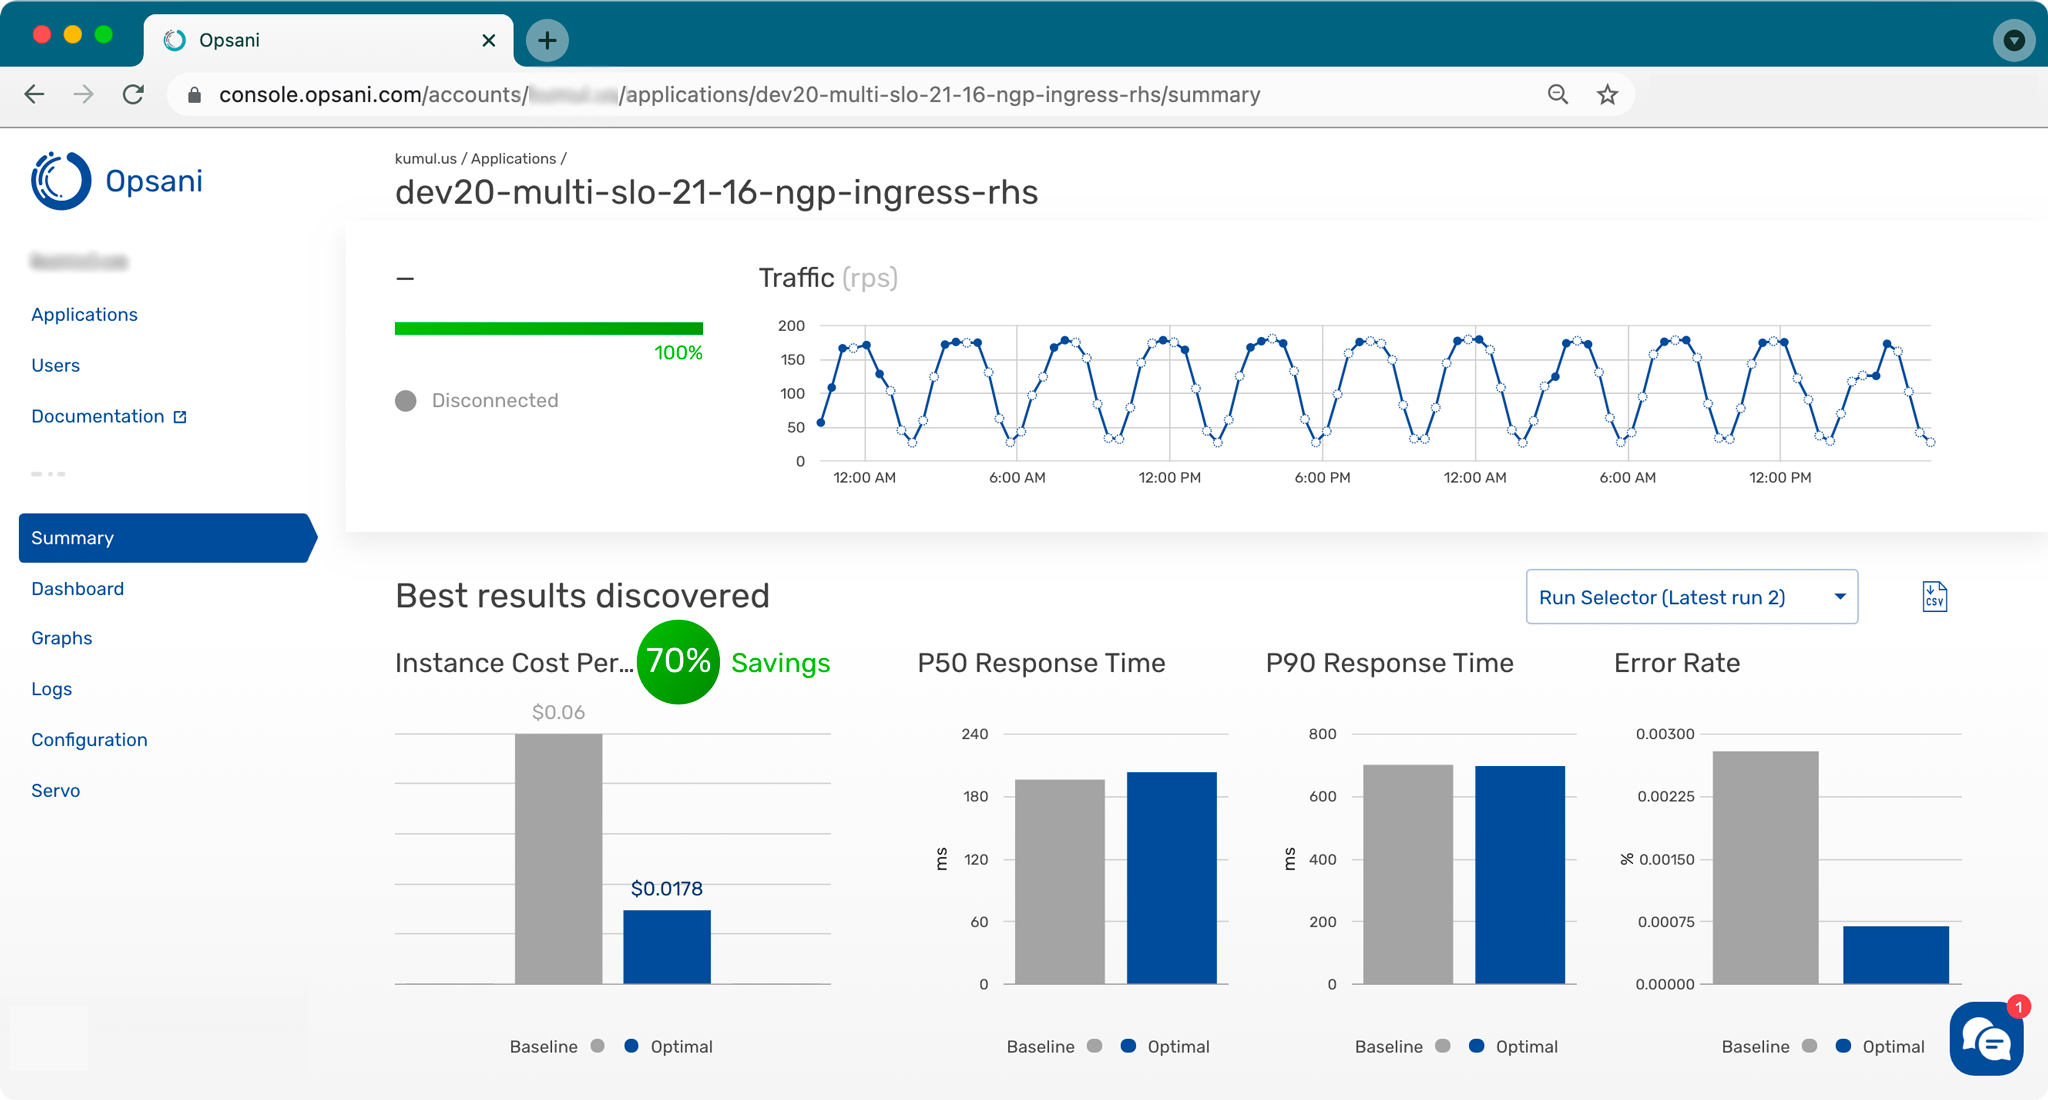
OpsaniおよびPrometheusとともに、NGINX PlusベースのNGINX Ingress Controllerを導入した場合に期待できる結果の例を見てみましょう。スクリーンショットに示すように、Opsaniの[Summary]ページには、一定期間のトラフィック量(1秒あたりのリクエスト数、RPS)が表示され、ベースライン設定と比較した最適化の効果が強調されています。この例では、[Instance Cost Per Hour]が70%削減され、[P50 Response Time]が5%改善されています。
そこで、これらの結果を、最もよく知られているIngressコントローラーの1つである、KubernetesコミュニティがGitHubのkubernetes/ingress-nginxリポジトリでメンテナンスしているNGINX Open SourceベースのIngressコントローラーと比較するとどうなるかを検証しました。(従来のNGINXの慣例に従い、以降このブログではこれを「コミュニティIngressコントローラー」と呼びます。NGINX PlusベースのNGINX Ingress Controllerは、NGINXエンジニアリングチームがGitHubのnginxinc/kubernetes-ingressリポジトリで、NGINX Open Sourceベースの姉妹製品であるNGINX Ingress Controllerとともにメンテナンスしています。)
2つのIngressコントローラーについて、3つのトポロジーでパフォーマンスをテストしました。
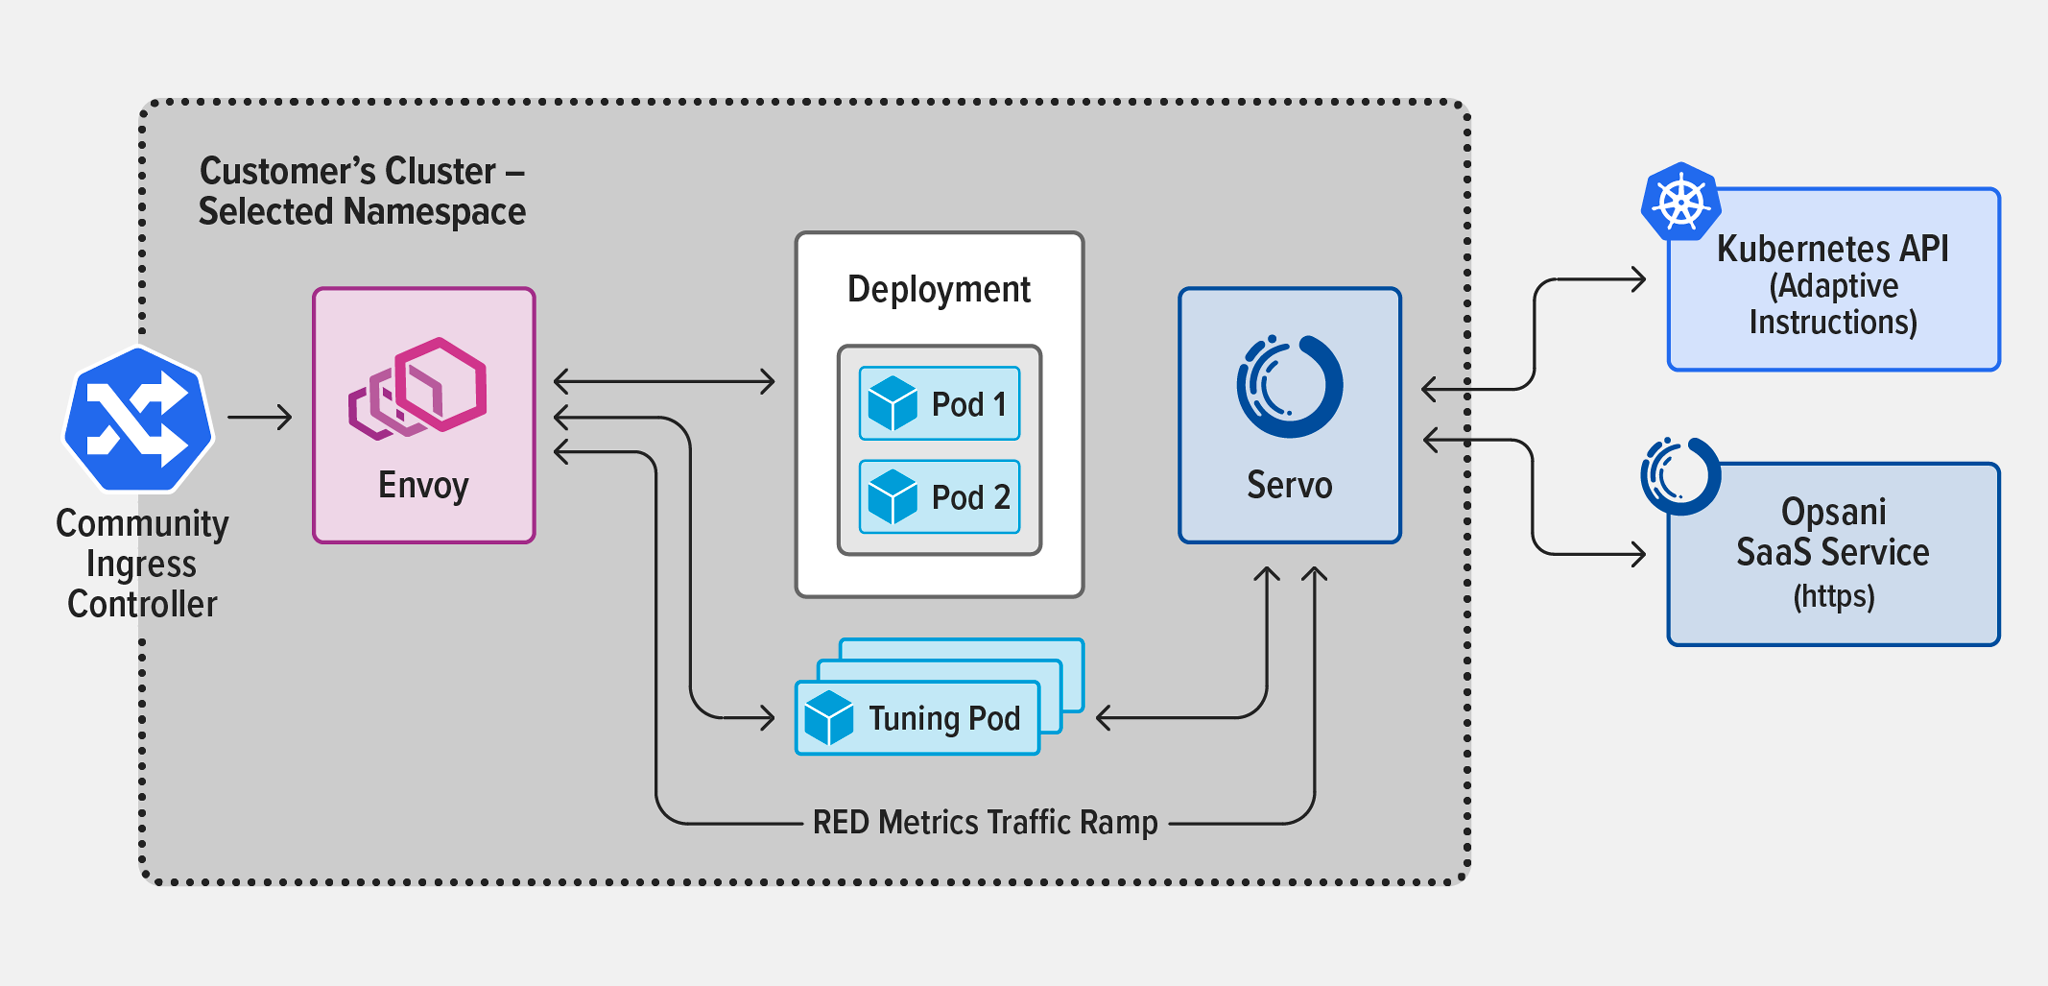
- トポロジー1 – コミュニティ版Ingressコントローラー。標準プロセスを使用してデプロイしました。アプリケーションPod内のサイドカーコンテナに、テスト対象アプリケーションとインラインで接続するEnvoyプロキシを追加し、メトリクスを収集しました。
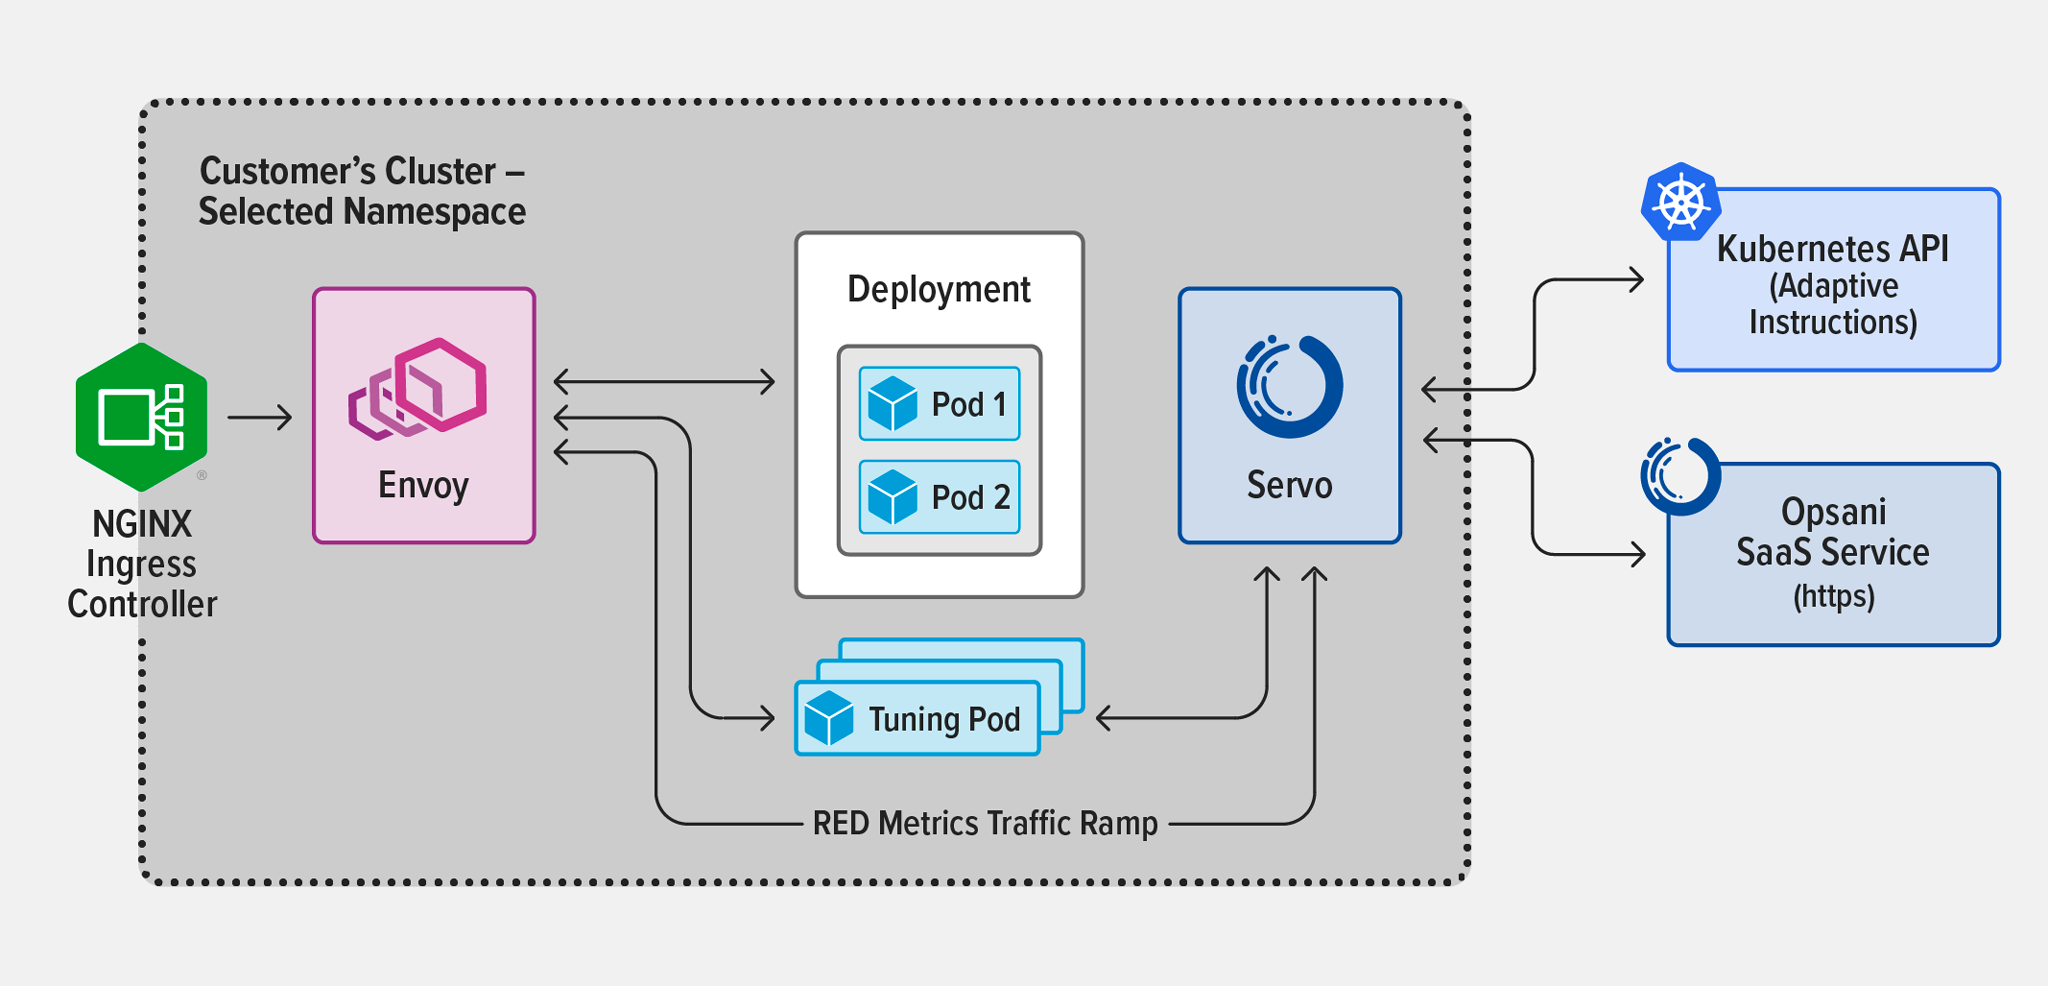
- トポロジ2 – NGINX PlusベースのNGINX Ingress Controller。Helmを使用してデプロイしました。メトリクス収集が最適化のパフォーマンスプロセスに影響しないよう、コミュニティ版Ingress Controllerと同じEnvoyのデプロイおよび構成でメトリクスを収集しました。
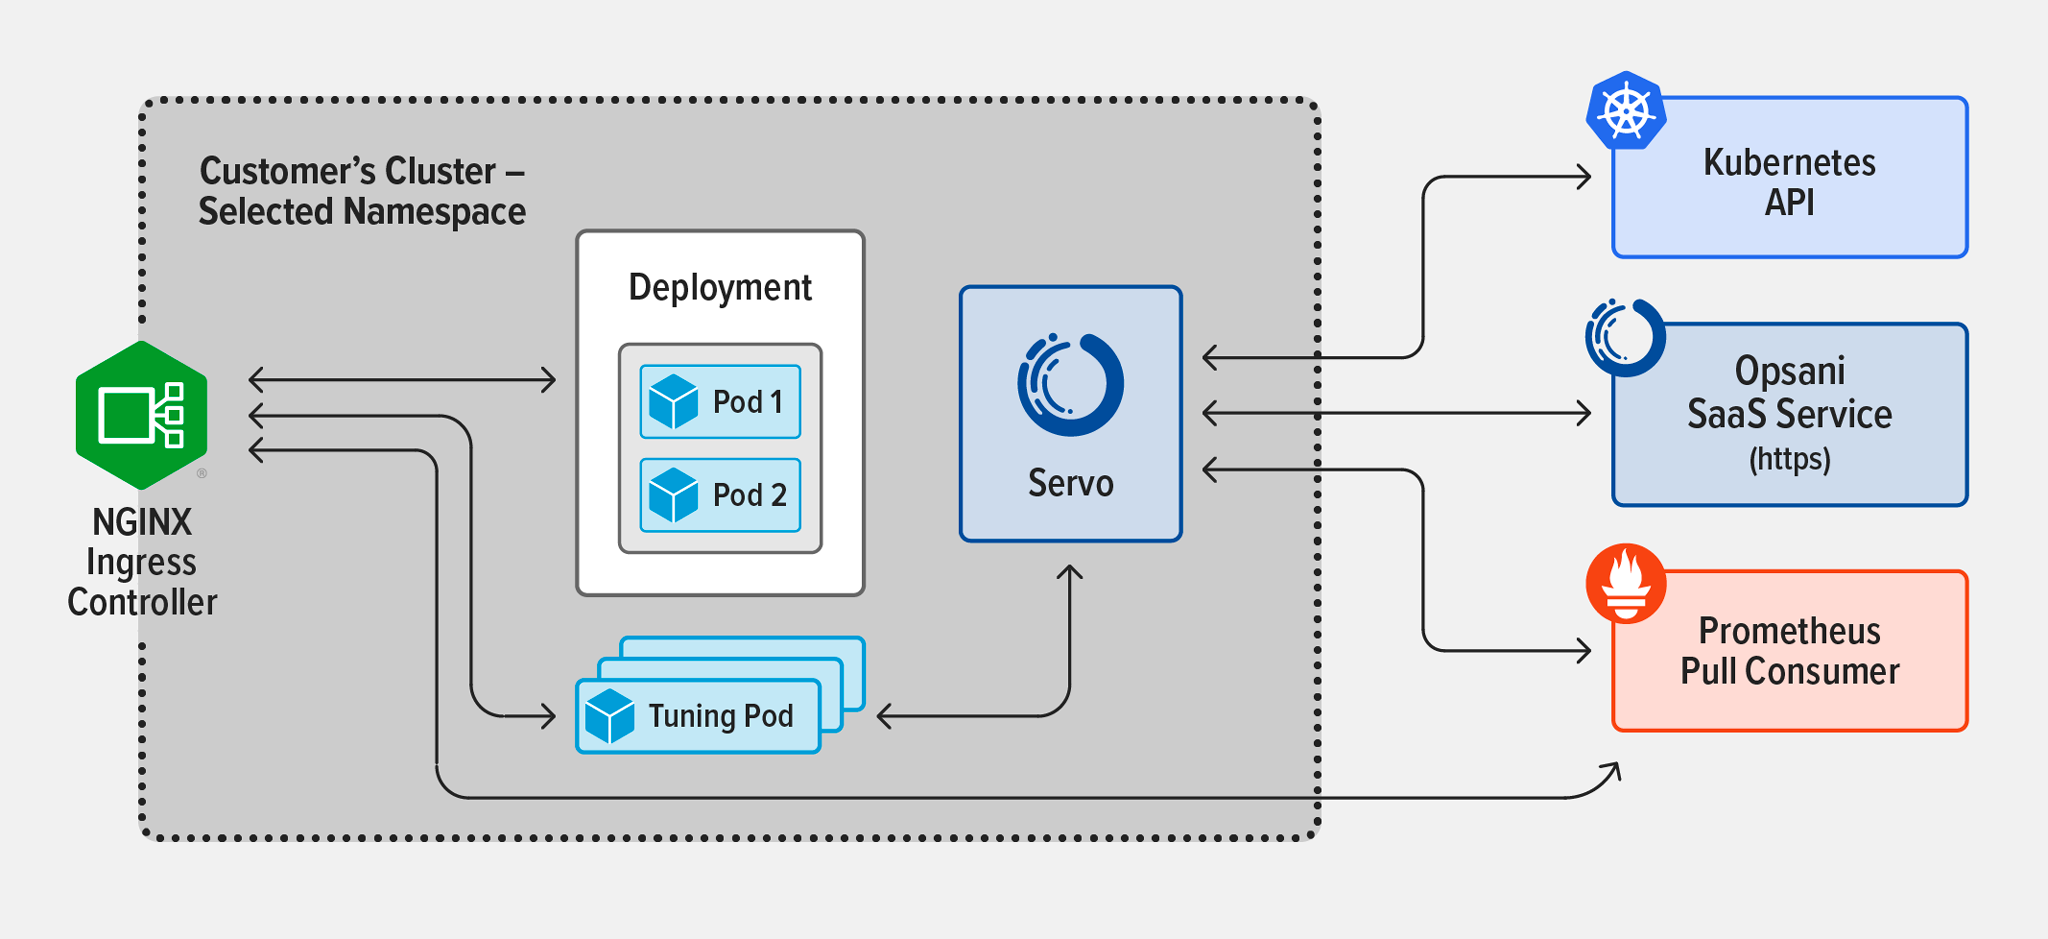
- トポロジ3 – NGINX PlusベースのNGINX Ingress Controller。こちらもHelmを使用してデプロイしました。メトリクスはPrometheusを使用して収集しました。
この表は、テスト結果をまとめたものです。ご覧のとおり、NGINX Ingress Controllerは、コミュニティ版Ingress Controllerと比較して、コスト削減、CPU最適化、メモリ最適化の面で優れた成果を上げています。これは、NGINX Ingress Controllerの負荷分散がより効率的であるためだと考えられます。
P50応答時間の結果から、Prometheusは、Envoyサイドカーの仕組みで必要となる余分なホップを排除できるため、メトリクス収集に最適な方法であることがわかります。EnvoyはCommunity Ingress controllerのP50応答時間には影響しませんが、NGINX Ingress Controllerではレイテンシーが実際に4%悪化します。一方、Prometheusを使用すると、NGINX Ingress ControllerのP50応答時間が5%改善します。
| トポロジー | コスト削減率(%) | P50レスポンスタイム(%) | CPU最適化率(%) | メモリ最適化率(%) |
|---|---|---|---|---|
| 1 –Envoyを使用するCommunity Ingress Controller | 44 | 0 | 44 | 44 |
| 2 – Envoyを使用するNGINX Ingress Controller | 70 | 4 | 63 | 81 |
| 3 – Prometheusを使用するIngress Controller | 70 | -5 | 63 | 81 |
テストの実施方法については、「付録」をご覧ください。
OpsaniによるNGINX Ingress Controllerの最適化
Opsaniは、動的な環境で負荷分散が不十分な場合でも、アプリケーションを最適化できます。また、あらゆる種類のメトリクス入力を活用できますが、ネットワークメトリクスを収集する既存のツールから入力を取得すると、接続されたサービスの最適化が大幅に向上します。そのため、シンプルな導入プロセスを使用して、OpsaniをNGINX Ingress Controllerと統合します。
現在、多くのアプリケーションで採用されているNGINXをIngressコントローラーとして使用する環境では、NGINX PlusベースのNGINX Ingress Controllerに簡単に切り替えることで、アプリケーションの動作に影響を与えることなく、より効率的な負荷分散アルゴリズムを利用できます。さらに、NGINX Ingress Controllerで負荷分散されるアプリケーションのメトリクスも利用できるようになります。
追加で必要なのは、最適化用の名前空間にアプリケーションとともにOpsaniポッドを1つデプロイすることだけです。NGINX PlusベースのNGINX Ingress Controller向けOpsaniテンプレートでは、メトリクスエンドポイントをIngressサービスに指定し、最適化に必要なアプリケーション固有のメトリクスを取得します。3~4回のピーク期間のメトリクスを処理することで、Opsaniエンジンはわずか数時間で最適な最適化レベルに到達します。これまでに、ピーク負荷を30%~70%最適化しています。
OpsaniとNGINX Ingress Controllerを使い始める
無料トライアルをお申し込みください:NGINX Ingress Controller、Opsani。続いて、GitHubリポジトリで、Prometheusを使用するNGINX Ingress ControllerとOpsani向けのスクリプトおよび構成ファイルをご確認ください。
付録:テスト方法
前提条件
- NGINX PlusベースのNGINX Ingress Controllerは、コンテナとしてビルドされています。
- Kubernetesが構成済みであり、レジストリアクセスシークレットを使用して、セキュアなプライベートDockerレジストリにアクセスできます。
- NGINX PlusベースのNGINX Ingress Controllerは、Helmを使用してingress名前空間にデプロイされています。
- An NGINX VirtualServerリソースは、最適化対象のサービス(通常、デフォルトではフロントエンドサービス)を参照するように設定されています。例については、GitHutリポジトリの「frontend-virtualserver.yaml」を参照してください。
トポロジと構成
3つのOpsaniインスタンスを作成します。トポロジ1と2では、すべてのOpsaniアカウントで利用できる標準のOpsani Devテンプレートを使用し、NGINX Ingress Controllerをアプリケーションのフロントエンドとして配置して、アプリケーションサービスを参照するように設定します。
For トポロジー3では、同じデフォルトテンプレートを使用し、GitHubリポジトリ内の「opsani-manifests-nginx-plus.yaml」で定義されているConfigMapを使用してServo構成を変更します。標準テンプレートと同様に、ConfigMap内の以下の変数を適切な値に置き換えます。
{{ NAMESPACE }}– ターゲットリソースの名前空間{{ DEPLOYMENT }}– 対象のデプロイメント{{ CONTAINER }}– 対象アプリケーションコンテナ名
さらに、アプリケーションのデプロイ時に公開されるドキュメントに従って、OPSANI_ACCOUNT_NAME、OPSANI_APPLICATION_NAME、およびOPSANI_TOKENを設定します。
Opsani Devのデフォルトの「ServoX」にはPrometheusインスタンスが含まれていますが、ClusterRoleを設定する必要性を減らすため、ここではPrometheusインスタンスをNGINX Ingress Controllerと同じ名前空間にデプロイします。
また、Servoポッドが正しいインスタンスを検出してクエリを実行できるように、サービスも構成します。このアーティファクトについては、opsani-manifests-nginx-plus.yamlで説明しています。
サンプルWebアプリケーションとしてBank of Anthosが稼働し、Ingressが検証されたら、Ingress Prometheusインスタンスを起動します。最後に、opsani-manifests-nginx-plus.yamlファイルを適用してOpsaniの最適化を開始できます。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります