このブログは、「多数のKubernetesクラスターを運用するための優れたコントロールプレーンとは」の続編です。前回のブログでは、インフラストラクチャサイトとアプリケーション群を管理するVolterra独自のFleet Operationsアプローチについて説明しました。今回は、多数のクラスターやサイトにわたって構成を変更する際に、運用チームが直面する構成ドリフトという重要な課題について説明します。私はこの課題を「Time to Effect」と呼んでいます。
Time-to-Effectとは
簡単に言えば、操作の意図が反映されるまでにかかる時間です。たとえば、次のようなものがあります。
- セキュリティポリシーの設定がすべてのサイトに反映されるまで、どのくらいかかりますか?
- アプリケーションの最新バージョンがすべてのサイトに反映されるまで、どのくらい時間がかかりますか?
- 世界各地に分散しているすべてのサイトで、オペレーティングシステムまたはインフラストラクチャソフトウェアのアップグレードが完了するまでに、どのくらいの時間がかかりますか?
なぜ重要なのか
この問いについて、実際のお客さまの事例をいくつかご紹介します。
- MeltdownとSpectre — Meltdown/Spectreのニュースが報じられた後、すべてのCISOにとって最大の関心事は、インフラストラクチャ全体のオペレーティングシステムにいかに迅速にパッチを適用するかということでした。運用チームは、意図した変更(OSバージョンのアップグレード)が反映されるまでの時間を1時間単位で評価されていました。
- 自動販売機の一群が大学にサービス拒否攻撃を仕掛けた事件をご存じでしょうか。この攻撃をご存じない方のために、要点を説明します。ハッカーはゼロデイ脆弱性を悪用してマルウェアをインストールし、複数の自動販売機を相互に接続してボット群を構築しました。このボット群が大量のトラフィックを送信し、大学にサービス拒否攻撃を引き起こしました。攻撃を検知した大学は、コマンド&コントロールサーバーへのアクセスを防ぐため、自動販売機ごとにネットワークポリシールールを1台ずつ設定する必要がありました。被害の拡大を食い止めるには、意図した設定(特定のWebサイトへのアクセスをブロックすること)をすべての自動販売機に直ちに反映させることが極めて重要でした。
Time to Effectは、インフラストラクチャソフトウェア、アプリケーションソフトウェア、ネットワークポリシー、セキュリティポリシーなど、さまざまなカテゴリーで重要です。
課題は何か?
運用チームが管理を担う際に、この課題の深刻さが最も顕著になります
- 大規模な数のサイト
- 世界各地に分散したサイト
- 異種混在環境(プライベートクラウド、パブリッククラウド、通信事業者クラウドのサイト、エッジデバイスなど)
- サイトごとに異なる接続性
その好例が、自動車のソフトウェア更新と接続管理を担う自動車OEMの運用チームです(以下、自動車を「顧客サイト」と呼びます)。一般的な導入環境にはプライベートデータセンターが含まれ、運用チームはそこから世界各地の自動車を制御します(組織構造によっては地域単位で制御します)。
この課題を理解するために、運用チームが利用できるソリューションを見てみましょう。多くのソリューションでは、お客さまのプライベートデータセンターでホストされる管理ソフトウェアを提供し、大規模に分散したサイトを一元管理します。自動車OEMがすべての自動車に適用する必要があるポリシーを設定すると、中央管理ソフトウェアは基本的に、各車両へ1台ずつ構成スクリプトをダウンロードします。構成スクリプトには、各サイトで一連の構成コマンドを実行するAnsible PlaybookやHelm Chartなどを使用できます。この仕組みを図示すると、以下のようになります。
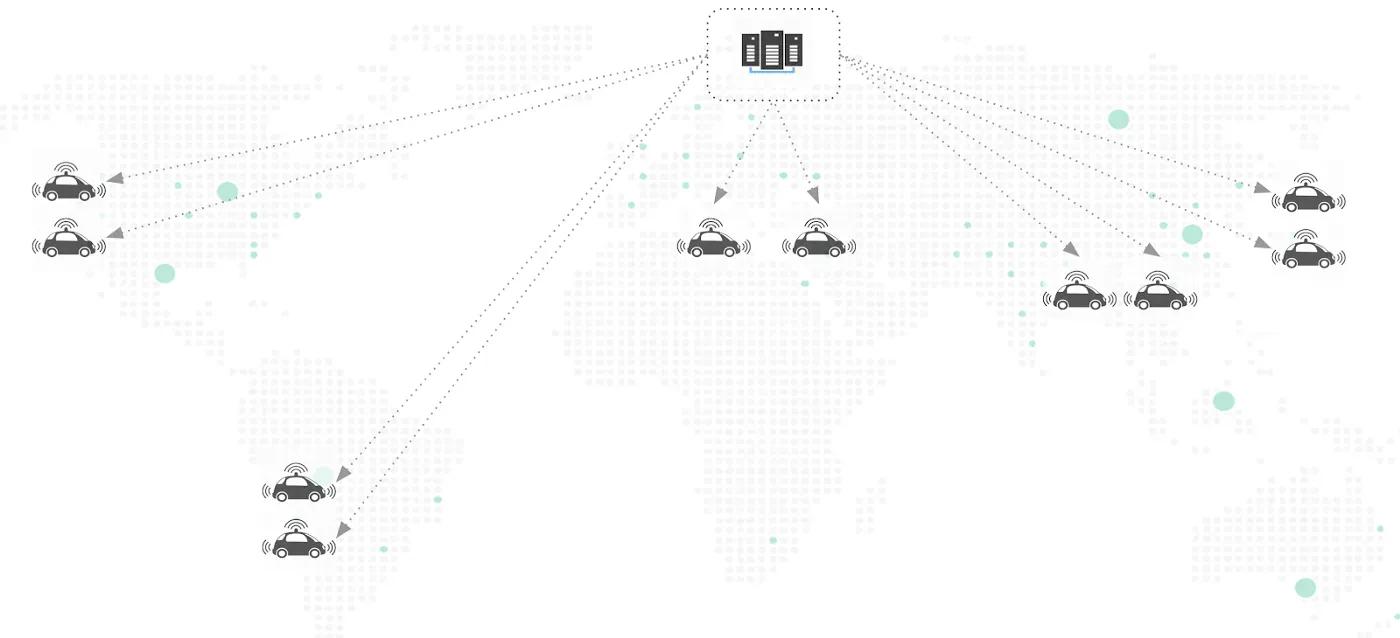
問題は、Time to Effectがサイト数に正比例することです。集中管理ソフトウェアのベンダーは、すべての運用をリモートかつ自動で実行できる限り、これが実現可能な最善の方法だと主張するでしょう。
Volterraはこの見解に異を唱えます。その根拠を本ブログでご紹介します。Volterraは、Time to Effectを最小限に抑えるよう設計された、階層型のスケールアウトアーキテクチャを採用した分散コントロールプレーンを構築しました。
効果発現までの時間を最小限に抑えるVolterraアーキテクチャ
Time to Effectを最小限に抑えるための基本的な構成要素は次のとおりです。
- 階層型ツリーベースアーキテクチャ
- 専用設計の分散コントロールプレーン
次に、アーキテクチャの概要を示します。
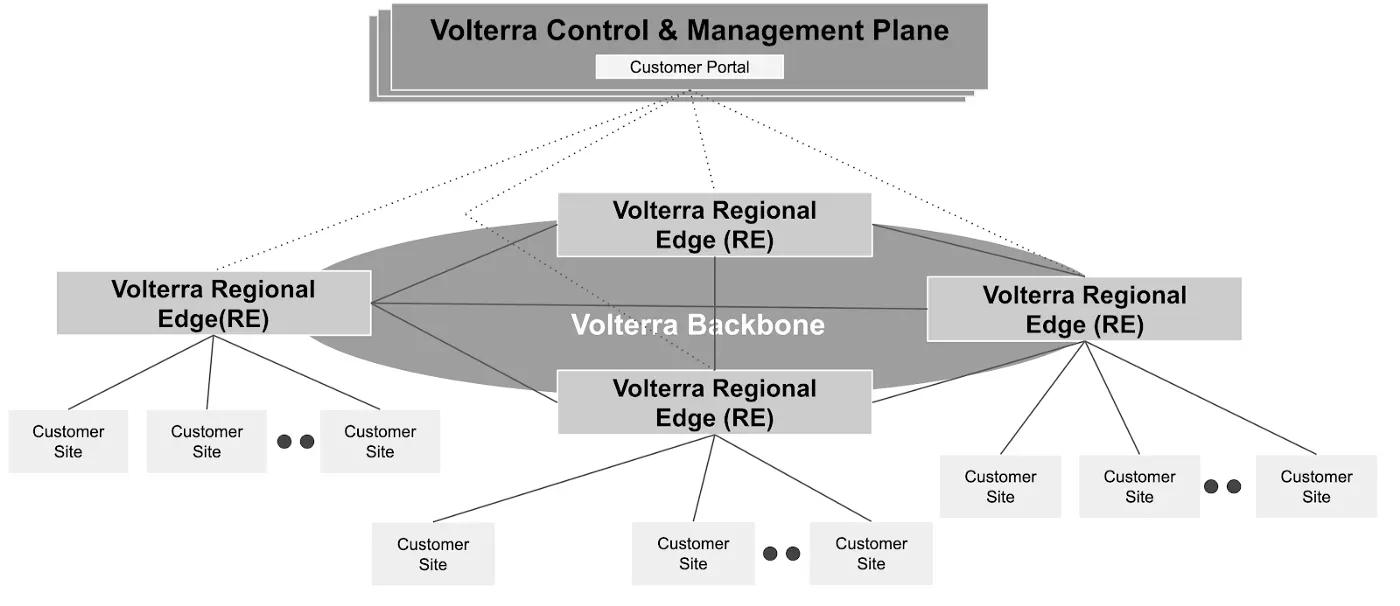
Volterraの階層型アーキテクチャでは、設定を配布するためにノードをツリー状に構成します。各ノードはストアアンドフォワードを行います。つまり、設定をローカルに保存してから、その子ノードに転送します。具体例を挙げると分かりやすいでしょう。ユーザーがVolterra Consoleでネットワークポリシーなどのオブジェクトを設定すると、制御および管理プレーンは、直下の子ノードであるRegional Edge(RE)にその設定を配布します。各REは設定をローカルに保存し、その子ノードに転送します。REの子ノードは、そのREに接続されている顧客サイトです。
階層型のツリーベースアーキテクチャにより、Time to Effectを最小限に抑えます。Time to Effectは、ツリーの階層数とノードあたりの子ノード数によって決まります。ツリーの最大階層数は3階層です(コントローラー → RE → 顧客サイト)。ノードあたりの子ノード数は、REに接続されているサイト数に正比例します。RE上にサービスインスタンスが生成され、一連のサイトの構成を処理します。REに接続されるサイト数が増加すると、Volterraのスケールアウト型コントロールプレーンが必要に応じて新しいサービスインスタンスを生成します。
テスト環境
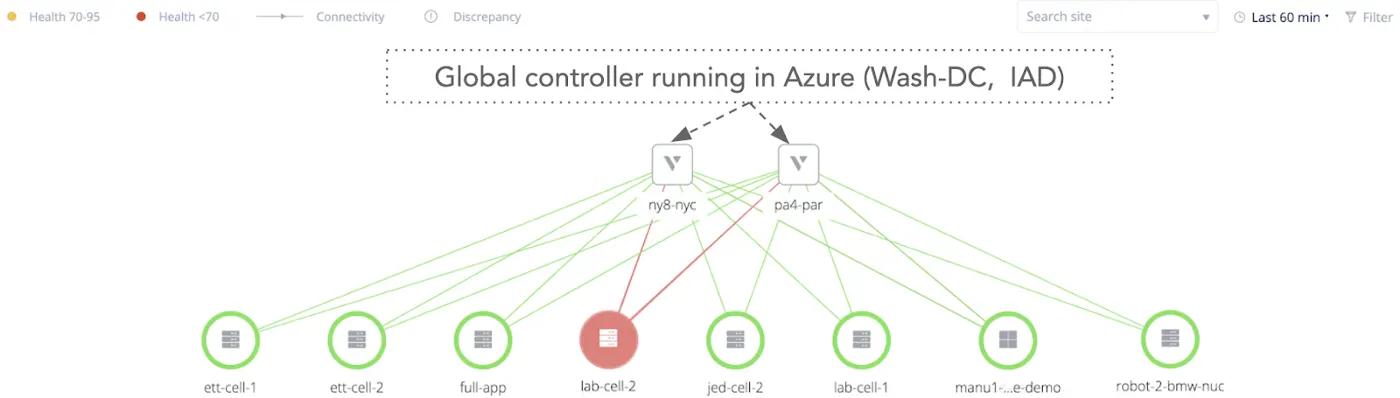
Time to Effectの測定は、ニューヨーク(NY8-NYC)とパリ(PA4-PAR)にある2つのRegional Edgeに接続された多数の顧客サイトを対象に、大規模に実施しました。顧客サイトは、サンタクララ(カリフォルニア州)、ヒューストン(テキサス州)、マドリード(スペイン)、プラハ(チェコ共和国)、ロンドン(英国)など、世界各地に分散していました。また、顧客サイトは、AWS、仮想マシン(ESXi)、Intel NUCやFitlet2を含むEdge Gatewayなど、異種混在環境にまたがっていました。
Volterraのカスタマーポータルとグローバルコントロールプレーンは、Azure(Washington-IAD)上で稼働していました。実際の運用環境を再現するため、カスタマーサイトは複数の名前空間とテナントに分散して配置されていました。
RE上のサービスインスタンスを停止し、REと顧客サイト間に品質の低い接続リンクを使用することで、障害状態をシミュレーションしました。単一の名前空間におけるフリート全体の一部を特定時点で捉えたスナップショットを図3に示します。
テスト方法
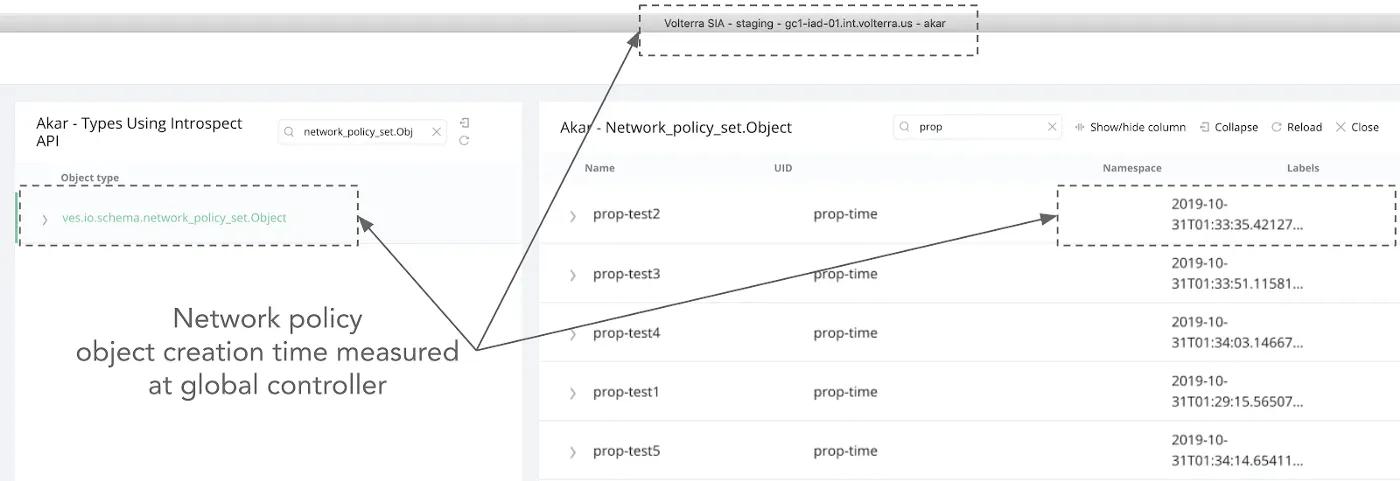
Volterraコンソールでオブジェクトを設定し、その設定が各顧客サイトに適用されるたびに、タイムスタンプ付きの監査ログがVolterraシステムに記録されます。伝播時間は、ポータルで設定してから顧客サイトにその設定が適用されるまでの時間差として測定しました。次に、詳細な手順を説明します。
- カスタマーポータルでオブジェクトを設定します。
- 開始時刻は、カスタマーポータル(本書ではVolterra Global Controllerと呼びます)でのオブジェクト作成時刻として測定します。例については図4を参照してください。
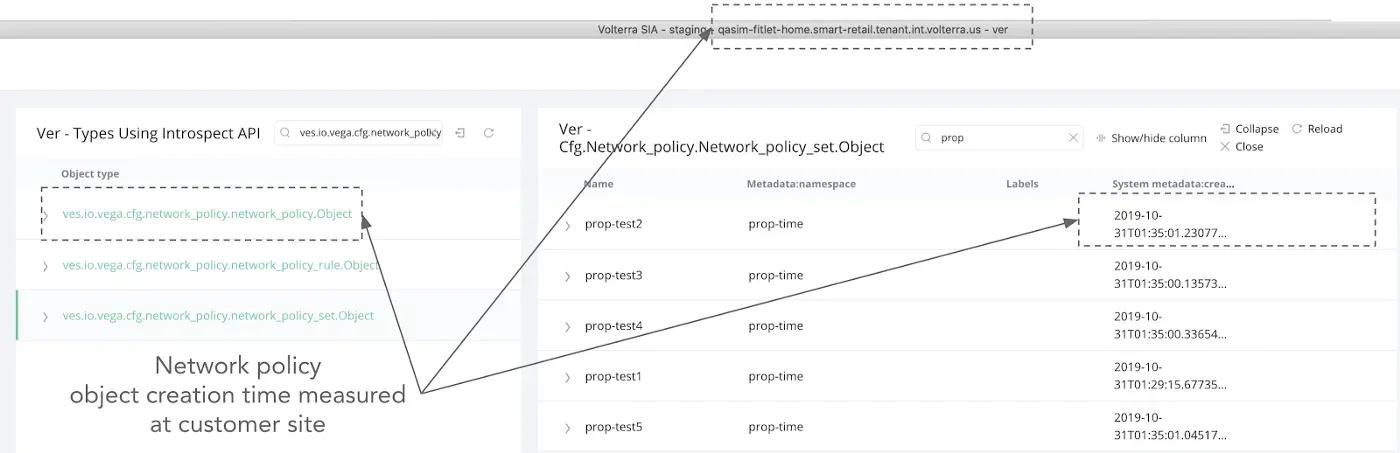
- 終了時刻は、カスタマーサイトでのオブジェクト作成時刻として測定します。例については図5を参照してください。
表示されているスクリーンショットはサンプルであり、同一の測定回のものではないことに注意してください。
構成開始時刻
設定終了時刻
テスト結果
伝播時間のテスト結果を図6と図7に示します。図6のグラフから、測定サンプルの大半で伝播時間が0~400 msであったことがわかります。これは、すべてのカスタマーサイトが0~400 msで新しい構成に更新されることを意味します。前述のとおり、RE上のサービスを再起動し、カスタマーサイトで接続障害や遅延を発生させることで、障害条件をシミュレーションしました。これらの障害条件では構成の伝播時間が長くなり、今回のテストでは障害の種類に応じて600 ms~9秒となりました。たとえば、REとカスタマーサイト間で接続障害が発生すると、構成がカスタマーサイトに到達するまでの時間が長くなります。ただし、Volterraの分散コントロールプレーンには、結果整合性のある構成というパラダイムに従うという利点があります。つまり、すべてのカスタマーサイトの構成が、お客さまが定義した意図と一致するよう、再試行を継続します。
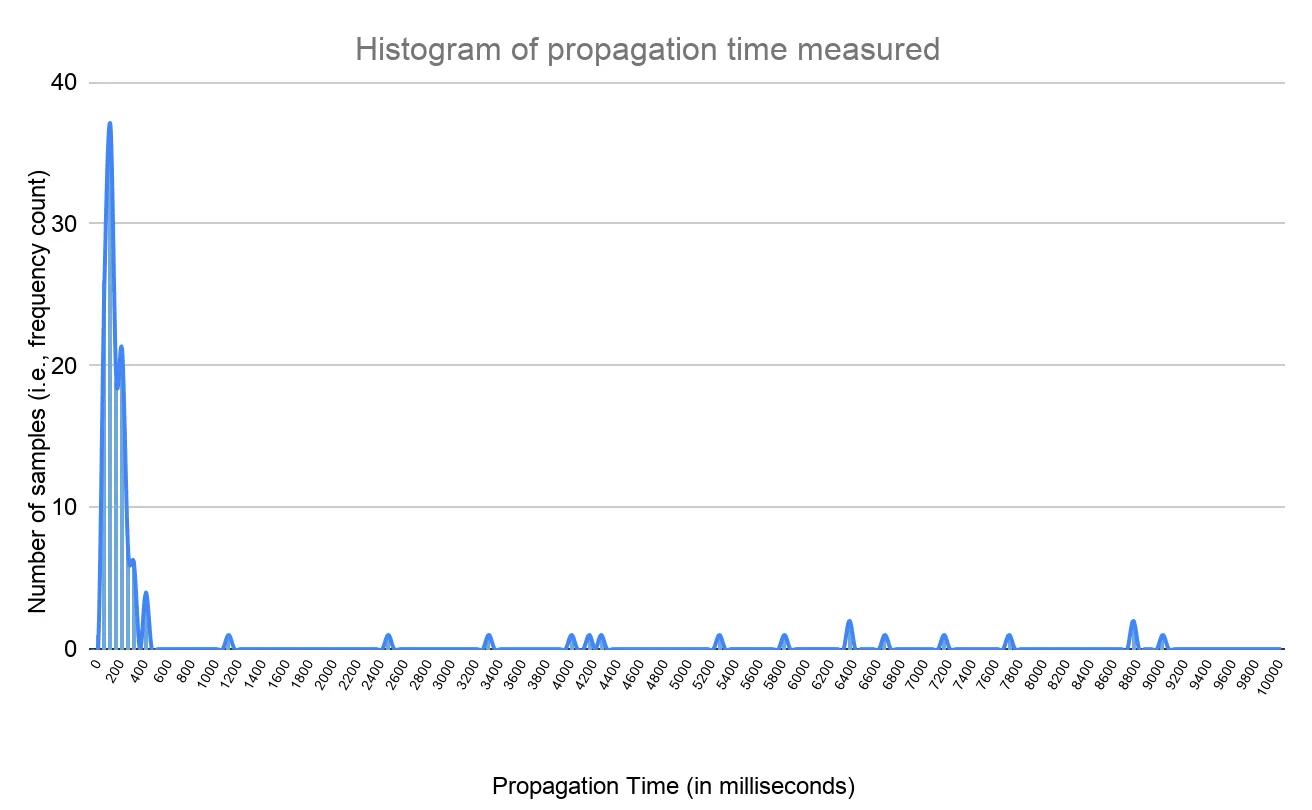
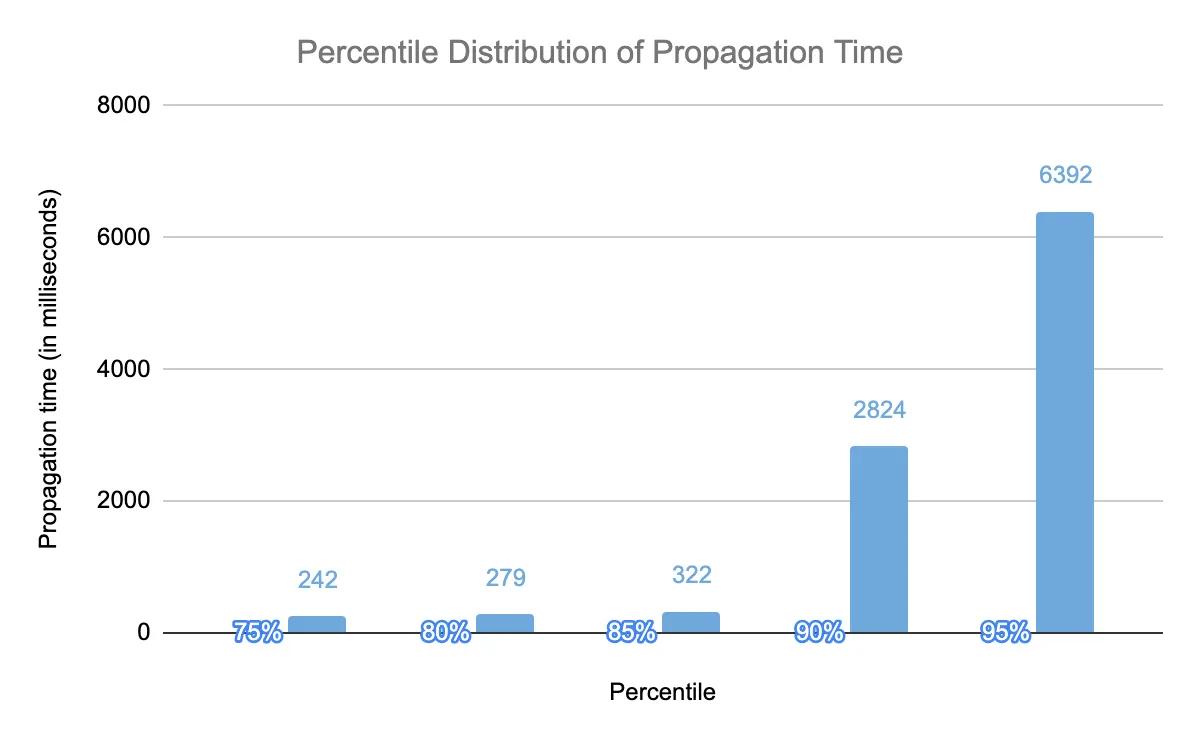
図7のグラフは、85%の確率で、すべての 顧客サイトが322ミリ秒以内に新しい構成へ更新されることを示しています。障害条件が発生した場合、一部の顧客サイトでは伝播に約3~9秒かかる可能性があります。
免責事項: これらの測定結果は、シミュレーションで使用したトポロジ、規模、デプロイ環境、および障害状況に大きく依存します。考えられるすべての障害状況やその他の環境を測定したわけではありません。そのため、テストしていない状況や環境での伝播遅延については断定できません。たとえば、Kubernetesクラスターに障害が発生した場合、システムは障害の検出、再起動、構成の再試行を待つ必要があるため、伝播遅延が長くなります。
関連ブログ
著者について
関連するブログ記事

F5 Application Study Tool:OpenTelemetryによるF5 BIG-IP環境の監視
F5の新しいオープンソースツールは、BIG-IP環境を詳細に可視化し、データを追跡するとともに、強力でカスタマイズ可能なインサイトを得るための基盤を提供します。

F5 BIG-IPでAI防御を実現
F5 BIG-IP Advanced WAF、BIG-IP APM、BIG-IP SSL Orchestratorが、生成AIアプリ向けに包括的なセキュリティソリューションを提供する仕組みをご覧ください。
F5 Advanced WAFによるGraphQL APIの保護
ここ数年、多くの組織がデジタルトランスフォーメーションを進めており、COVID-19のパンデミックによってその動きは加速しています。
アプリケーションサービスの現状 通信業界版:リーダーとしての台頭
通信ネットワークが進化し、さまざまな業界の幅広いユースケースに対応するなか、通信業界の回答者がテクノロジーリーダーとしての存在感を高めていることがわかります。
デジタルトランスフォーメーションは、単なるペーパーレス化ではない
デジタルトランスフォーメーションは、単なるペーパーレス化ではありません。真のモダナイゼーションにアプリケーションアーキテクチャとセキュリティの再構築が必要な理由を、F5ブログでご覧ください。
やめましょう。もう本当にやめましょう。HTTPSはHTTPより高速ではありません。
もうやめましょう。HTTPSはHTTPより高速ではありません。プロトコルのパフォーマンスに関する微妙な違いと、暗号化トラフィックを適切に最適化する方法については、F5ブログをご覧ください。