
背景
これまでの2本の記事では、データドリブン設計で考慮すべき点、特にビジネスデータに潜在的なビジネス価値がどのように内在しているかに焦点を当ててきました。そこでお伝えした重要なポイントは、構造化されたデータアーキテクチャが、その内在する価値を引き出すための技術基盤になるということです。ただし、これらの記事では、関連するトピックを概念レベルで紹介することに重点を置いていました。今回は、より具体的で身近な例として、データファーストの考え方に沿ってアプリケーションを設計する方法を検討するストーリーを通じて、これらの概念をご紹介します。
その前に、なぜこれが重要なのでしょうか?
本題に入る前に、データが以前にも増して重要になっている理由を振り返ってみましょう。これまで多くの企業は、監査やコンプライアンスなどのガバナンス上の理由から、主にデータを収集・保存すること自体を目的としてきました。そのため、データの収集と保存は、事業運営に直接もたらす価値がほとんど認識されないまま、事業運営に課される一種の「税金」と見なされてきました。
現在では、収集したデータを活用してビジネスプロセスを最適化し、顧客体験を向上できるという認識が深まっています。たとえば、デジタル小売企業を対象とした最近の調査によると、ビジネスプロセスと顧客体験の向上という2つの目標が、調査対象となった全企業の57%にとってデジタルトランスフォーメーションの主な推進要因でした。「なぜ重要なのか」という本質を理解するうえで重要なのは、データドリブンなワークフローが、顧客体験などの対外的な領域と、コアビジネスプロセスなどの社内領域の両方に影響を及ぼすという点です。そのため、最も重要なビジネスワークフローの品質とコスト効率を高めるには、十分に検討された明確なデータ戦略が不可欠です。さらに、ワークフローから生成される観測データをデータ収集・分析インフラストラクチャに送信できるよう計測機能を組み込むことで、ワークフロー自体を継続的に分析して改善できます。その結果、変化に常に適応し、最適化されるビジネスワークフローを実現できます。
余談ですが、これらの企業がデジタルトランスフォーメーションに関して最も強く懸念していたのは、こうしたデジタルプロセスのサイバーセキュリティを確保することでした。そして実は、この領域でも、同じデータテレメトリと分析のアプローチが重要な役割を果たします。ただし、この点については別の記事で取り上げます。
アプリケーション:レストランの注文とデリバリー
思考実験を進めるにあたり、コロナ禍に適応した今日の生活様式において、多くの方にとって身近に感じられるであろう事例を選びました。レストランの料理の注文と配達をオンラインで提供するアプリケーションです。利用者は指定したレストランの料理をオンラインで注文し、自分で受け取るか、サービスによる配達を利用するかを選択できます。
このストーリーでは、アプリケーションオーナーの役割を担います。この役割では、さまざまな課題に対処する必要があります。これらの課題を、必要な運用活動と将来を見据えた戦略的課題の2つに分類します。
1つ目のカテゴリーである必須の運用業務には、次のような課題があります。
- レストランの所在地や営業時間などの情報を検索し、把握すること
- メニュー項目と価格に関するデータの収集
- レストランへの注文情報の通知
- 支払いの処理
- 注文の集荷・配達を担当できる人員の稼働状況に関するデータの保持
- 注文の準備状況と配送状況の追跡
2つ目の懸念事項は、日常業務との直接的な関わりは比較的少ないものの、同様に重要です。これらの課題を事前に検討しておくことで、ビジネスは俊敏性と適応力を高め、継続的に改善できるようになります。具体例は次のとおりです。
- 需要をどのように予測できるでしょうか。時間帯別や曜日別の総需要を単純に予測することも、店舗別など、より細かい単位で予測することもできます。
- サプライヤー(レストラン)にビジネス上のインサイトを提供するには、どのようなツール、プロセス、ワークフローが有効ですか?
- 料理または配達の料金を動的に調整するには、どうすればよいでしょうか?
- アプリケーションがパブリッククラウドでホストされている場合、運用インフラストラクチャのコストをどのように最適化できますか?
もちろん、これは考慮すべき多岐にわたる事項の一部にすぎませんが、この限られた範囲だけでも、拡張可能なデータ処理パイプラインを支える構造化データアーキテクチャの重要性について十分に議論できます。
データアーキテクチャかデータパイプラインか/鶏が先か卵が先か
アプリケーションオーナーの立場を想定して全体的なデータ戦略を検討する場合、まずビジネスワークフローを列挙し、それぞれに必要なデータ処理を特定できます。たとえば、近隣で営業中のレストランを検索し、各店のメニューと価格を表示するワークフローでは、所在地と営業時間でレストランを絞り込んだうえで、選択したレストランのメニューを検索する必要があります。さらに、配達ドライバーの稼働状況で絞り込むことも考えられます。同様に、決済処理やドライバーと配達のマッチングなど、各ワークフローについて必要なデータ処理を特定できます。
あるいは、同じく妥当なアプローチとして、必要なデータの構成要素である基本的なデータ「アトム」から検討を始めることもできます。重要なデータアトムを特定して列挙し、表現の統一と意味の一貫性に加え、ビジネスワークフローを支えるために必要なメタデータ語彙にも特に注意を払います。サンプルアプリケーションにおけるデータアトムの例は次のとおりです。位置情報(レストラン、顧客、ドライバー用)、食品項目(メニューと請求書に必要)、時間(フィルタリングと配達品質の追跡に使用)、および支払い情報(顧客とドライバーへの支払いワークフローに関連)。
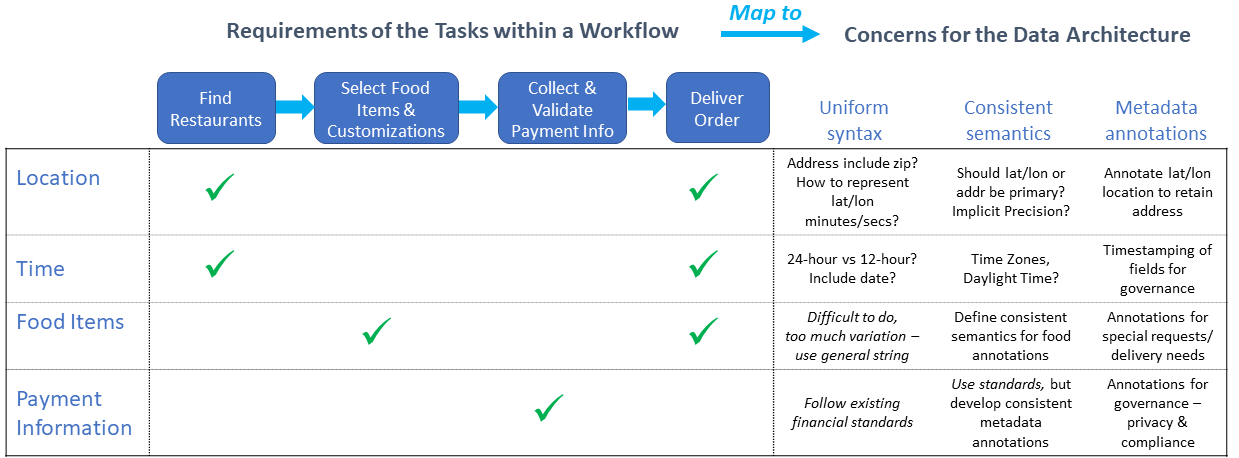
データ戦略の出発点として、ワークフローのデータ処理パイプラインとデータの「アトム」のどちらを選ぶべきかは、鶏が先か卵が先かという問題です。どちらの視点も有用であり、さらに重要なのは、両者が相互に依存していることです。基盤となるデータアトムを考慮せずにデータ処理パイプラインを検討することはできません。同様に、処理パイプラインのニーズを考慮せずにデータアーキテクチャを構築することもできません。とはいえ、一般的には、まずワークフロー全体を確認してデータアトムを洗い出し、その後、データパイプラインの詳細設計に着手する前に、データアーキテクチャを体系的に設計するアプローチを推奨します。これは、ワークフローの方が変化しやすいためです。ビジネスの進展に伴ってワークフローは追加・変更されますが、基盤となるデータにはより長い履歴と慣性があります。そのため、データアーキテクチャでは事前に十分な検討を行うことがより大きな効果につながります。
データアーキテクチャとパイプラインを包括的に捉えるアプローチの具体例への適用
先ほどの例に戻りましょう。アプリケーションオーナーとして、ビジネス上重要な主要ワークフローと、それらを支えるために必要なデータアトムについて、かなり具体的に把握できているものとします。ここまでの説明では、ワークフローに必要な基礎的なデータ要素として、場所、時間、食品、支払い情報を挙げました。また、これまでの記事を振り返ると、データアーキテクチャでは、構文の統一、セマンティクスの一貫性、データの分析とガバナンスに使用するメタデータ語彙という3つの主要な目標を実現できる必要があります。ここからは、これらの原則を適用し、今回の例で挙げた具体的なデータアトムについて、データアーキテクチャ上の考慮事項を検討します。
データアトムの「場所」に焦点を当て、データアーキテクチャの3つの主要な目標をそれぞれ検討します。
- まず、統一されたデータ表現構文とは何でしょうか?
レストランや顧客は通常、所在地を住所で表すため、当初は位置情報を住所で表現することが考えられます。しかし、配達中のドライバーを追跡する際に必要となる位置情報について考えてみましょう。ドライバーは移動中であることが多く、幹線道路上や、住所では正確に表せない場所にいる可能性もあります。そのため、このワークフローでは緯度と経度で位置情報を表す方が適している場合があり、この形式はレストランや顧客の所在地にも使用できます。ただし、ドライバーは通常、レストランや顧客の所在地まで移動する必要があるため、ドライバーの位置情報(緯度/経度)と顧客の所在地(住所)を関連付ける方法も必要です。したがって、より慎重に検討した選択肢として、正規化により、すべての位置情報を緯度と経度(必須の「正規」表現)で統一しつつ、住所が最初に提供された時点で緯度/経度に変換できるようにする方法(「取り込み」ワークフロー)が考えられます。 - 2つ目の考慮事項は、一貫したセマンティクスです。
位置情報が緯度/経度として正規化されていると仮定すれば、これは明確に解釈できる確立された標準であるため、比較的容易です。ただし、一貫したセマンティクスには、データに暗黙的に示される正確さ、つまり精度という側面もあります。GPSと地図データの精度には本質的に限界があるため、データソースの品質に応じて、位置情報を一定の精度(たとえば、最も近い1秒単位、約100フィート)または可変精度で指定できます。柔軟性を考慮して後者を選択する場合は、次に説明するメタデータを使用して、位置情報データの各インスタンスの精度を注記する必要があります。 - データアーキテクチャの3つ目の目標は、収集したデータ要素に注釈を付け、情報を追加できるようにすることです。
位置情報の場合、前述のとおり、データの精度を含めることが考えられます。さらに、人が理解しやすいように位置情報に住所を付加し、特に取り込んだ住所データを保持できるようにすることも考えられます。これは、集合住宅など、複数の住所が同じ緯度/経度に対応する場合に特に重要です。ほかにも、位置情報フィールドを収集した時刻を示すタイムスタンプを追加できます。移動中のドライバーの場合、位置情報がすぐに古くなるため、この情報が重要になることがあります。
ここまでは、位置情報に関する要件のみを取り上げてきました。他の各データフィールドについても、同様に検討できます。しかし、データアトムごとにすべての検討事項を列挙するのではなく、ここでは注目すべき点をいくつか取り上げます。
- データアトム「時間」について:時刻値の表現は、扱いが難しいことで知られています。構文上(例:24時間形式と、AM/PMを伴う12時間形式)も、意味上(例:タイムゾーンの概念や、夏時間の実施状況による違い)も異なる場合があります。そのため、時刻の表現は正規化が必要になる可能性があります(GMTに統一する、またはUnix/Linuxユーザー向けに「エポックからの経過秒数」で表すなど)。
- 食品項目のデータインスタンスは多種多様で、それぞれ固有の要件があります。これらのデータアトムは自由形式であることが多いため、構文の統一を図るよりも、標準化されたメタデータ語彙を使用する方が有用です。一部のメタデータフィールドは、「要冷蔵」や「ナッツを含む」など、項目ごとに固定されたプロパティに使用します。一方、「辛さのレベル」や「希望する調味料」など、インスタンス(注文)ごとの食品項目情報には、別のメタデータフィールドが必要です。いずれの場合も、メニュー項目の全インベントリで共有できるよう、メタデータフィールドの構文を統一し、セマンティクスに一貫性を持たせることが設計目標となります。
- その他の重要な考慮事項として、データコンプライアンスとデータガバナンスがあります。その1つがデータ保持ポリシーです。顧客のIPアドレスやドライバーの位置情報履歴など、一部のフィールドは短期間しか保持できません。また、一部のフィールドにはセキュリティやプライバシー上の制約が課される場合があります。その一例が支払い情報です。どちらの場合も、メタデータの付加が解決策となります。データ保持のため、IPアドレスや位置情報の値には、データの有効期限をメタデータで付加する必要があります。支払い情報の場合は、保存データの暗号化が必要であることや、永続データストアの地理的位置に関する制約など、セキュリティ要件をメタデータで伝達できます。
この例ではまだ表面的な部分に触れたにすぎませんが、実際のシナリオに伴う多くの課題が明らかになりました。しかし現実には、データ戦略を検討するプロセスはここで終わるものではなく、反復的かつ継続的に進められます。データ要素がビジネスワークフローを具現化するデータ処理パイプラインに取り込まれるにつれて、データアーキテクチャは繰り返し調整、強化されます。既存のワークフローを強化し、新しいワークフローを追加する中で、新たなデータアトムが生まれるとともに、既存のデータアトムに対するデータアーキテクチャ上の追加要件も明らかになります。
まとめ
この例は簡潔にするために単純化されていますが、ワークフローをデータアーキテクチャへの影響に対応付ける際の主要な原則を示しています。このプロセスでは、まずビジネスニーズ、すなわち顧客体験と、そのニーズを満たすために必要なビジネスプロセスを検討します。次に、ビジネスプロセスによってビジネス用語体系の要素が定義されます。さらに具体化すると、プロセスはデータパイプラインに対応付けられ、そのパイプラインではデータ用語体系が活用されます。
重要な原則は、構文、セマンティクス、アノテーションを定義する堅牢なデータアーキテクチャによって、データパイプラインを効率的に拡張し、新しいワークフローを容易に追加できる基盤を構築することです。ビジネスレイヤーの抽象化では、既存のビジネスプロセスを容易に変更し、新規または新たに生じるビジネスプロセスを迅速に稼働させられることを意味します。逆に、データ語彙、データアーキテクチャフレームワーク、またはこれらとビジネスニーズとの関連付けのいずれかについて十分に検討せずに意思決定すると、最終的には壊れやすく脆弱なシステムとなり、新たなビジネス要件に柔軟に対応できなくなります。
関連するブログ記事
SOAS 2025:足並みの乱れが凡庸さを招く
AI導入における方針の不一致は、非効率を招きます。セキュリティ、自動化、導入の各戦略を整合させ、AIの可能性を最大限に引き出す方法をご紹介します。
WebAssemblyが重要な理由
WebAssembly(Wasm)は、あらゆるプラットフォームで高性能なアプリケーションを実現する、ポータブルで高速かつセキュアなバイナリ命令セットです。

インフラストラクチャは依然として格好の攻撃経路
クラウドコンピューティングでは、APIやドラッグ&ドロップ式の設定ツールを活用し、ネットワークやインフラストラクチャを敬遠する人がそれらを直接扱わずに済むようにすることで、インフラストラクチャへの対応を不要にすることが長年追求されてきました。しかし、インフラストラクチャを無視することも、攻撃の主要な標的であるという事実を見過ごすこともできません。
堅牢なデータアーキテクチャがもたらす戦略的メリット
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開にもつながり、これらすべてをより俊敏に実行できるようになります。
デジタルワークフローにおける不正検知には、データだけでは不十分
2019年には、業界全体でクレジットカード詐欺の試みが約25万件確認されました。これは約2分に1件の割合です。今日、不正を検知するには、デジタルワークフロー上のできるだけ多くのポイントから収集したデータを相互に関連付け、手作業によるデータ処理をはるかに上回る速度で分析する能力が求められます。