
データオーケストレーションとは、システム、パイプライン、環境間でのデータの連携、変換、移動を自動化することです。データを収集、標準化、ガバナンスの適用を行ったうえで、分析、アプリケーション、AIワークロードに確実に提供できるようにします。
データオーケストレーションとは
データオーケストレーションは、データの取り込みと変換から、データレイク、データウェアハウス、運用システム、AIパイプライン全体での活用と配信に至るまで、ライフサイクル全体を管理します。手作業による受け渡しやサイロ化したスクリプトに代わるワークフローを自動化し、分散環境でもデータの正確性と適時性を維持しながら、形式の一貫性を確保します。
データオーケストレーション、データ統合、ETLの違い
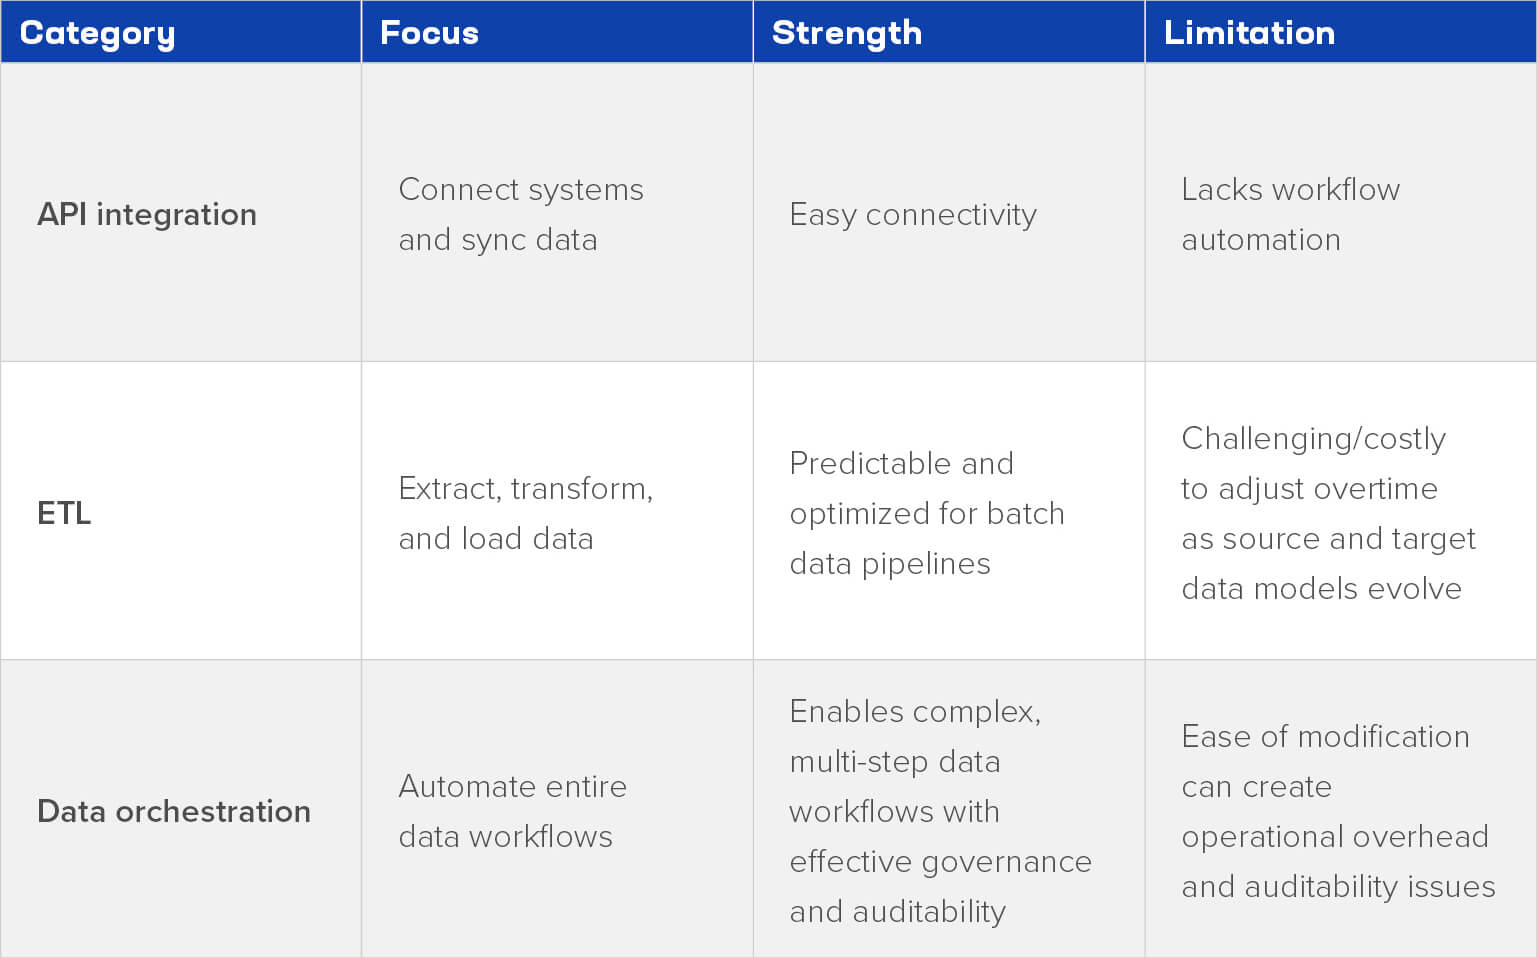
データ統合は複数のソースからデータを組み合わせますが、通常は接続性に重点を置きます。ETLツールはデータを抽出、変換し、ターゲットシステムにロードします。多くの場合、バッチモードで処理します。
データオーケストレーションは、バッチ、ストリーミング、マルチクラウド、分析、AIを含むすべてのデータワークフローを調整し、品質、ガバナンス、監視を確保しながら適切な順序で実行されるようにします。
最新のデータスタックにはデータオーケストレーションが不可欠
組織がマルチクラウド環境、リアルタイム分析、AI駆動型アプリケーションへと展開を広げるにつれ、データの量と速度は手作業で処理できる範囲を超えます。データオーケストレーションにより、パイプラインは高品質でガバナンスの効いたデータを下流システムへ継続的に提供し、処理できるようにします。
AIオーケストレーションはデータオーケストレーションを基盤とする
データオーケストレーションはデータ管理の基盤であり、データワークフロー、データ収集、データクレンジング、利用可能なデータの移動が含まれます。AIオーケストレーションは、データオーケストレーションを機械学習(ML)のライフサイクル全体へと拡張します。これには、特徴量パイプライン(予測用に特化して構成)の調整、モデルのトレーニング(リソースのスケジューリングとデータセット管理)、モデルのデプロイ、モデルドリフトと精度の監視、再トレーニングまたはチューニングのためのフィードバックループが含まれます。
データオーケストレーションが重要な理由
データオーケストレーションは、企業に次のようなメリットをもたらします。
- データの信頼性と品質を向上:複数のソースにわたってデータを標準化し、ガバナンスポリシーを適用することで、分析システムやAIシステムに一貫した形でデータを提供できるようにします。
- データおよびAIパイプラインを高速化:ワークフローの順序制御とエラー処理を自動化し、手作業によるエンジニアリングの負担を軽減します。
- リアルタイムのインサイト取得を支援:ストリーミングおよびイベントベースのワークフローをネイティブにサポートし、迅速な意思決定を可能にします。
- ガバナンスとコンプライアンスを強化:メタデータを使用して、追跡(ソース、変更、進捗状況)、リネージ(監査証跡)、アクセス制御(適用)を行い、チームが規制要件とセキュリティ要件を満たせるよう支援します。
- マルチクラウドおよびハイブリッド環境に合わせて拡張:従来の脆弱なポイントツーポイント型レガシーシステム統合を使用せず、分散アーキテクチャ全体のデータをオーケストレーションします。
データオーケストレーションの仕組み
データオーケストレーションは通常、次の4つの段階で進みます。
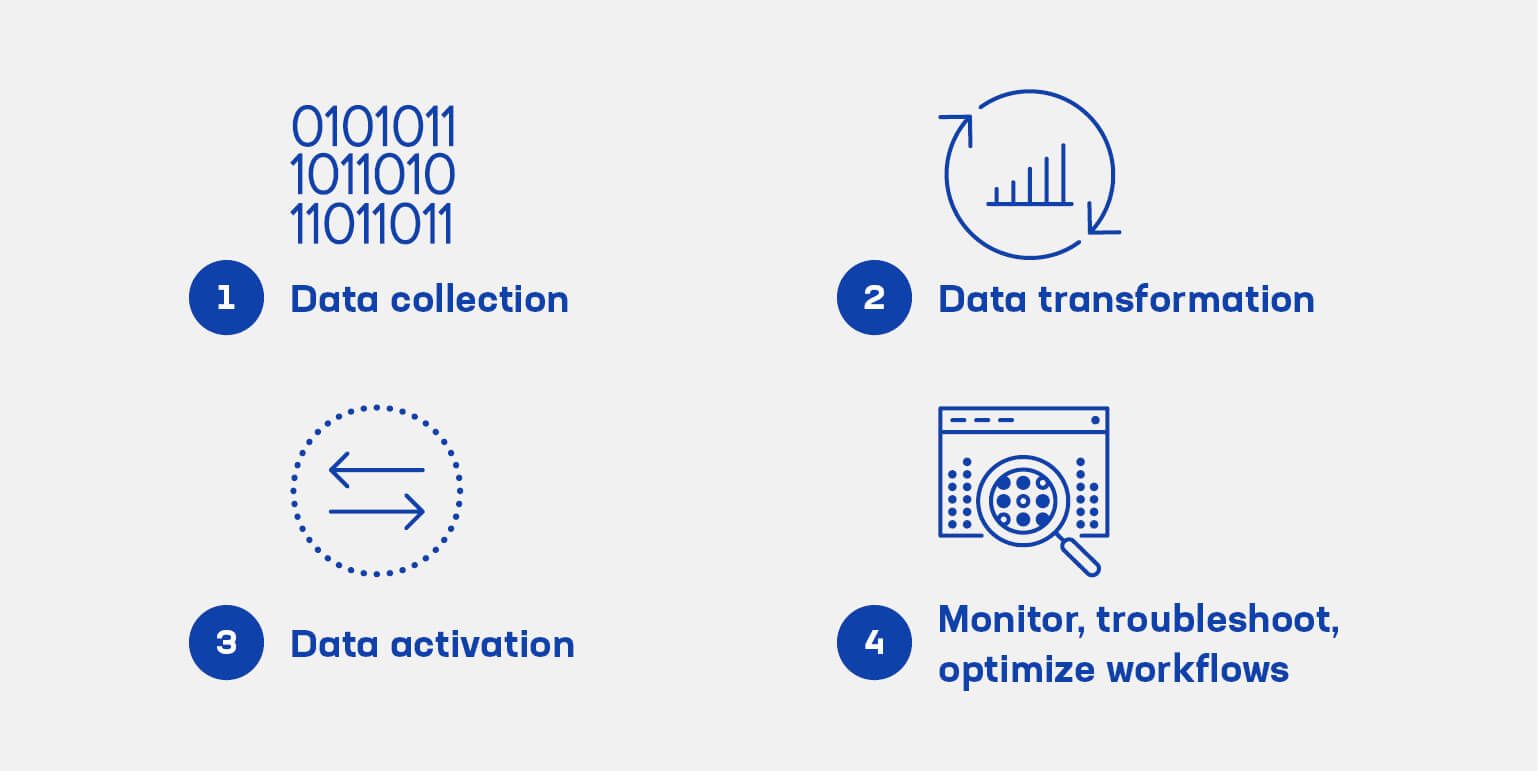
1. データの取り込みと収集:データベース、SaaSシステム、ログ、API、IoTデバイス、ストリーミングプラットフォームに接続します。
2. データの変換と標準化:スキーマ検証、クリーンアップ、正規化、エンリッチメント、品質チェックをデータに適用します。
3. データの活用と配信:処理済みのデータをデータレイク、データウェアハウス、BIツール、業務システム、AI/MLパイプラインに振り分けます。
4. ワークフローの監視、トラブルシューティング、最適化:パフォーマンス、リネージ、データの鮮度、パイプラインの健全性を追跡します。
データオーケストレーションシステムの主な構成要素は次のとおりです。
- パイプラインの実行順序を制御するワークフローエンジン
- コネクターと統合フレームワーク
- メタデータの管理とリネージ
- 品質チェックとポリシーの適用
- オブザーバビリティとロギング
- エラー処理と再試行
F5はデータオーケストレーションをどのように処理しますか?
F5は、データおよびAIパイプラインを支えるトラフィック、API、オブザーバビリティの基盤を強化することで、組織がオーケストレーションされたパイプラインを安全かつ確実に、大規模に運用できるようにします。
セキュアでガバナンスの効いたデータ配信:AIデータパイプラインは、API、サービス、分散ストレージシステムに依存しています。F5は、インライン検査、APIガバナンス、ロールベースのアクセス制御(RBAC)、暗号化トラフィック管理によってこれらの経路を保護し、ハイブリッド環境やマルチクラウド環境全体で機密データを安全かつセキュアに移動できるようにします。
最適化された高性能な接続:データオーケストレーションは、多くの場合、複数のネットワーク、クラウド、アプリケーションにまたがります。F5 Application Delivery and Security Platform (ADSP)は、高帯域幅ルーティング、負荷分散、パフォーマンス最適化を提供し、パイプライン全体のレイテンシーを最小限に抑え、ボトルネックを防ぎます。
AIガバナンスとモデルを考慮した保護:F5 AI Guardrailsは、アプリケーションとAIモデル間のリクエスト、レスポンス、データフローを監視し、リアルタイムでポリシー制御を適用します。データ漏えいを防止し、安全でないトラフィックをブロックして、準拠したやり取りのみを許可します。
データおよびAIパイプラインの可視性を一元化:F5 AI Assistantは、ログ、リネージ、テレメトリ、ポリシーデータを分析して、分散パイプライン全体のボトルネックやパフォーマンス上の問題を特定できる、環境横断的なオブザーバビリティを提供します。
データオーケストレーション導入のメリット
データオーケストレーションは、運用面と戦略面の両方で大きなメリットをもたらします。
- 効率性:取り込み、変換、パイプラインのスケジューリングなど、反復的な手作業によるデータエンジニアリングタスクを自動化します。これにより、作業負担を軽減し、チームは分析や開発などの他の業務に注力できます。
- スピード:システム間でデータが継続的に流れるようにすることで、リアルタイム分析や高速パイプラインを支援し、ビジネスおよびAIワークロードに不可欠なインサイトへより迅速にアクセスできるようにします。
- 信頼性:スキーマの一貫性、品質チェック、自動再試行ロジックを適用します。これにより、分析やモデルのパフォーマンスに影響するデータエラー、パイプラインの問題、後続処理の中断を低減します。
- スケーラビリティ:ハイブリッド環境やマルチクラウド環境にまたがる数百から数千のパイプラインを連携させることができる、統合オーケストレーションレイヤーを提供します。データの量と処理速度が増大しても、オーケストレーションによって予測可能なパイプラインパフォーマンスが確保されます。
企業におけるデータオーケストレーションのユースケース
企業は、運用および分析に関する幅広いワークフローでデータオーケストレーションを活用しています。
- リアルタイム分析とダッシュボード:アプリケーション、IoTセンサー、トランザクションからのストリーミングデータを連携させ、即時にインサイトを提供
- 顧客・パーソナライゼーションプラットフォーム:CRM、Web上のインタラクション、サポートシステム、マーケティングツールからデータを集約し、統合された顧客プロファイルデータを提供します。
- 不正検知とリスクスコアリング:イベントログ、トランザクション、ユーザー行動、サードパーティデータを準リアルタイムの検知モデルに同期します。
- サプライチェーンの可視化と最適化:物流システム、在庫データベース、IoTデバイスのデータを連携させ、予測とルート最適化に活用します。
- AI/ML特徴量パイプライン:MLワークフローの一環として、データを作成、検証し、トレーニング環境と推論環境に移動します。
- 規制報告:監査、財務報告書、その他の業界規制に基づく提出物に必要な、規制に準拠したデータ準備を自動化します。
データガバナンスにおけるデータオーケストレーションの役割
データオーケストレーションは、データライフサイクルに制御を直接組み込むことで、ガバナンスを強化します。
- リネージ:ソースシステムからすべての変換ステップを経るデータの経路全体を追跡し、監査、デバッグ、モデル結果の調査に不可欠な可視性を提供します。
- アクセス制御:パイプライン全体で権限、RBAC、最小権限の原則を適用し、ユーザーとシステムがアクセスを許可されたデータのみを操作できるようにします。
- 監査証跡:データの移動、変換、承認、ポリシーに関する詳細なログを保持し、明確な説明責任とコンプライアンス認証を可能にします。
- プライバシー規制への対応:データマスキング、トークン化、PII削除要求(GDPRなど)、保持ポリシーといったチェックを自動化します。オーケストレーションにより、すべてのパイプラインとシステムで機密データが一貫して取り扱われるようにします。
AIオーケストレーションの定義と範囲
AIオーケストレーションとは、MLおよびAIシステムの開発、デプロイ、保守に使用されるすべての要素を監督、管理、自動化することです。特徴量パイプライン、トレーニングプロセス、モデルのパッケージ化、デプロイ、監視、改善を管理することで、データオーケストレーションをAIライフサイクル全体に拡張します。
AIオーケストレーションは、ハイブリッド環境とマルチクラウド環境全体にわたるML運用(MLOps)ワークフロー、モデルガバナンス、運用の可観測性、インフラストラクチャの準備状況、ポリシー適用を対象とします。
AIオーケストレーションシステムの主要コンポーネント
AIオーケストレーションシステムは、MLライフサイクルの各段階を標準化し、自動化します。
- データおよび特徴量パイプライン:データの特徴量(高品質かつ最新のデータ)を準備、検証し、トレーニング環境と推論環境に提供します。
- トレーニングオーケストレーション:トレーニングジョブのスケジュール設定、コンピューティングリソース(GPU/CPU)の構成、分散トレーニング環境のスケジュール管理、モデルのトレーニング状況の追跡を行います。
- モデルのデプロイ:モデルのパッケージ化、バージョン管理、テストロールアウト、デプロイ、およびリアルタイム推論をサポートするルーティングを自動化します。
- 監視とパフォーマンス分析:モデルドリフト、精度、レイテンシ、リソース使用量、入力データの変化を追跡し、本番環境での信頼性を確保します。
- フィードバックループ:予測、結果、ユーザー操作、モデルのテレメトリを収集し、再トレーニング、チューニング、継続的学習を支援します。
AIオーケストレーション導入の主なメリット
AIオーケストレーションにより、企業のAI運用を簡素化し、強化できます。
- 再現可能なAIデリバリー:標準化されたワークフローにより、場当たり的なスクリプトや手作業のプロセスを削減し、AIの開発とデプロイの一貫性と予測可能性を高めるとともに、人為的ミスを排除します。
- ガバナンスの効いたAI運用:モデルの系譜、承認、データ消費、バージョン管理を可視化し、責任あるコンプライアンスに準拠したAI運用を実現します。
- 信頼性の高い本番環境対応パイプライン:一貫したパフォーマンスと適切なレイテンシーでモデルを実行し、自動監視によって障害を防止します。
- イテレーションサイクルの短縮:再トレーニング、検証、デプロイを効率化することで、イノベーションを加速し、AI機能が価値を生み出すまでの時間を短縮します。
- スケーラブルなマルチモデル運用:異なるクラウド、エッジロケーション、コンピューティング環境にまたがるワークロードを調整し、AIポートフォリオを支えます。
AIオーケストレーションプラットフォームと汎用ワークフロー自動化の比較
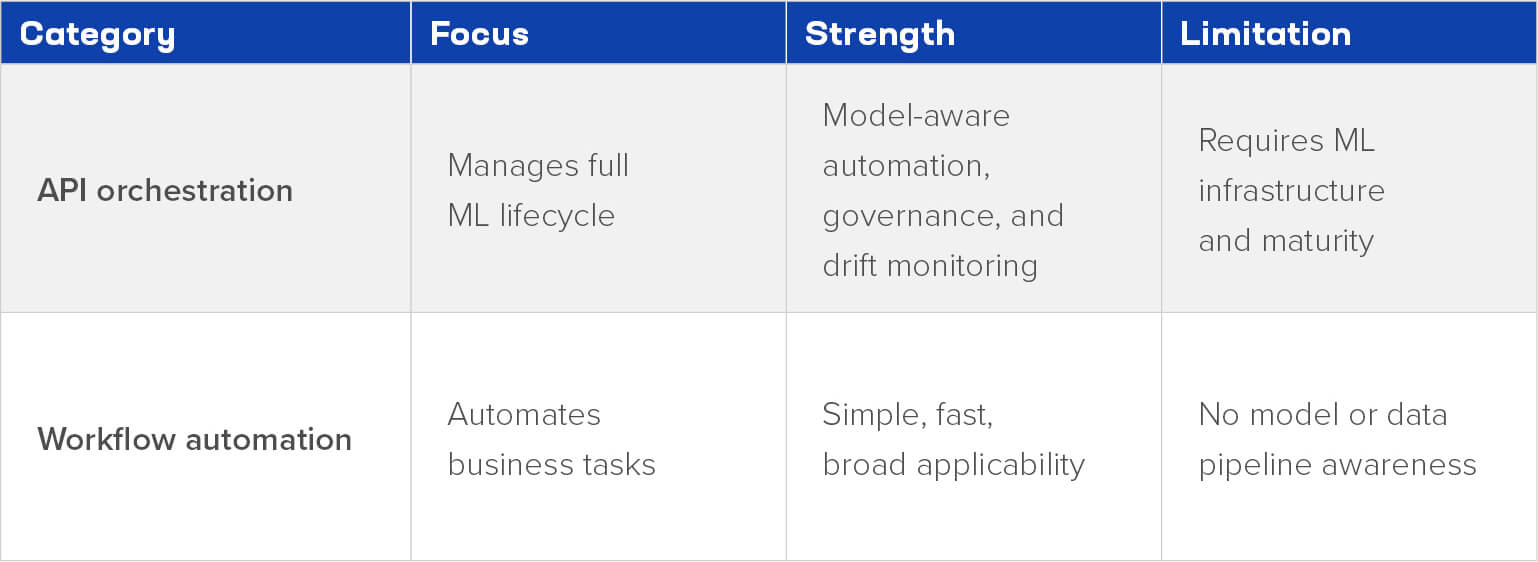
AIオーケストレーションプラットフォームは、MLと生成AIに特化して設計されています。モデルのライフサイクル要件を把握し、モデル固有の監視機能と分散トレーニングのサポートを提供するとともに、AIのセキュリティとコンプライアンスを適用します。
一般的な機能は次のとおりです。
- 特徴量ストアとの統合
- モデルのリネージとバージョン管理
- GPU/アクセラレーターのスケジューリング
- ドリフト検出と自動再トレーニング
- ポリシーとガバナンスの管理
- 推論トラフィック管理
一方、汎用ワークフロー自動化には、ビジネスプロセスを自動化するものの、ML機能を備えていない従来型のワークフローエンジン(Business Process Management、スケジューラーなど)が含まれます。これらは、トレーニングの追跡、モデルドリフトの監視、GPUインフラストラクチャの管理、モデル固有のガバナンスの適用には対応していません。
ビジネスにおけるAIオーケストレーションのユースケースとデジタルトランスフォーメーションへの影響
企業はAIオーケストレーションを活用し、AIプログラムを概念実証の段階から拡大しています。
- 事業部門全体でのモデル導入の自動化:不正検知モデル、価格設定エンジン、需要予測モデルを使用するソリューションの一貫した展開を支援します。
- リアルタイムのパーソナライゼーションとレコメンデーション:データの取り込み、トレーニングの更新、推論エンドポイントを管理し、個々に最適化されたエクスペリエンスを大規模に提供します。
- 予知保全とIoT分析:異常の検出、障害の予測、パフォーマンスの最適化が可能なストリーミングデータと推論パイプラインを管理します。
- 対話型AIと生成AIアプリケーション:データベース、検索パイプライン、プロンプトガバナンス、モデルサービスをオーケストレーションし、顧客対応業務を支援します。
- エンタープライズAI変革:AIオーケストレーションは、再現可能でコンプライアンスに準拠し、適切にガバナンスされたAIワークフローの基盤を構築します。これにより、組織はAIを個別のシステムだけでなく、ビジネスプロセス全体で運用できるようになります。
AIオーケストレーションにおけるガバナンスとコンプライアンス
AIオーケストレーションは、モデル運用にガバナンスを直接組み込むことで、企業のAIの安全性、説明責任、コンプライアンスを確保します。
- データの追跡:データセット、特徴量、変換処理、データソースを監視し、不正使用を防止するとともに、監査に必要な追跡可能性を維持します。
- モデルの追跡:モデルのバージョン、トレーニングデータ、構成、パフォーマンス、承認、デプロイ履歴を記録し、透明性と規制遵守を確保します。
- 意思決定の追跡:推論結果、説明、意思決定を記録し、モデルの影響、バイアス、公平性を包括的にレビューできるようにします。
- ポリシーとアクセス制御:ロールベースの権限、データマスキング、APIガバナンスを適用し、許可されたシステムとユーザーのみがモデルまたは機密データを操作できるようにします。
- 規制対応への備え:AIライフサイクル全体の監査可能性とトレーサビリティを確保することで、AIに特化した規制(European Union Artificial Intelligence Act(EU AI Act)、National Institute of Standards and Technology Artificial Intelligence Risk Management Framework(NIST AI RMF)、業界固有の規制など)への準拠を支援します。
データオーケストレーション|よくあるご質問
データオーケストレーションとは何か、どのような手順で機能するのか?
データオーケストレーションは、分散システム間におけるデータの移動、変換、配信を自動化します。通常、次の4つのステップで構成されます。
- データベース、SaaSアプリ、ログ、ストリーミングサービス、APIからデータを取り込み、収集します。
- 検証、正規化、エンリッチメント、書式設定のルールを使用して、データを変換し標準化します。
- データを有効化し、データウェアハウス、データレイク、アプリケーション、分析プラットフォーム、MLシステムに配信します。
- 鮮度、品質、リネージ、運用状態を追跡し、パイプラインを監視・最適化します。
データオーケストレーションは、データ統合やETLツールとどのように異なりますか?
データ統合はシステム同士を接続します。ETLツールはデータを抽出、変換、ロードし、多くの場合はバッチ処理を行います。データオーケストレーションは、バッチ、ストリーミング、クラウド、AIの各環境にまたがるこれらのワークフローを管理し、適切なガバナンス、品質チェック、監視によってパイプラインの信頼性を確保します。
データオーケストレーションシステムの主要な構成要素とは?
一般的なオーケストレーションプラットフォームには、以下が含まれます。
- スケジューリングと依存関係を管理するワークフローエンジン
- 取り込み用のコネクターと統合フレームワーク
- データを追跡するためのメタデータおよびデータリネージソリューション
- 品質検証とポリシー適用
- パイプラインのパフォーマンスに関するオブザーバビリティとログ記録
- エラー処理と再試行ロジック
企業にとって、データオーケストレーションの主なメリットとユースケースは何ですか?
メリットとして、効率の向上、インサイト獲得の迅速化、信頼性の向上、ハイブリッド環境全体での拡張性が挙げられます。ユースケースには、リアルタイムダッシュボード、顧客システム、不正検知、サプライチェーン分析、規制報告、AI/MLトレーニングパイプラインなどがあります。
AIオーケストレーションとは何か、データオーケストレーションやMLOpsとどのように関連するのか?
AIオーケストレーションは、データをモデルに変換し、モデルを本番環境に移行する各コンポーネントを連携させることで、データ準備、トレーニング、デプロイ、監視、改善を含む機械学習ライフサイクル全体を管理します。MLOpsと連携し、ガバナンス、自動化、ライフサイクルの追跡を強化します。
データとAIのオーケストレーションに一般的に使用されるツールやプラットフォームには、どのようなものがありますか?
標準的なデータオーケストレーションツールには、Apache Airflow、Dagster、Prefect、クラウドネイティブのスケジューラーなどがあります。AIオーケストレーションプラットフォームには、MLflow、Kubeflow、Vertex AI Pipelines、SageMaker Pipelines、Databricks Workflows、特化型のMLOpsソリューションなどがあります。多くの企業では、自社のデータスタック、クラウドプロバイダー、モデル戦略のいずれか、または複数に適合する組み合わせを採用しています。
AIオーケストレーションの実装における最大の課題は何ですか。また、チームはどのように対処できますか?
課題としては、データの分断、トレーニングの不整合、リネージの可視性不足、手動でのデプロイ、モデルドリフトとバイアス、コンプライアンス上の問題などが挙げられます。チームは、標準化されたパイプラインの採用、リネージおよびオブザーバビリティツールの導入、デプロイの自動化、ガバナンスポリシーの適用、ライフサイクル全体を通じた監視によって、これらの課題に対処できます。
データとAIのオーケストレーションは、ガバナンスとコンプライアンスをどのように支援しますか?
データリネージ、アクセス制御、データ変換、監査証跡、モデルによるデータ利用の検証を追跡することで、ワークフローにガバナンスを組み込みます。AIオーケストレーションでは、モデルのバージョン、データ、意思決定、パフォーマンスの追跡も含まれ、透明性とコンプライアンスを支援します。
データとAIのオーケストレーションに初めて取り組む企業は、何から始めるべきでしょうか?
組織は、主要な機能や分析ワークフローなど、効果の高い少数のパイプラインから着手し、その後拡張していくことが重要です。早い段階でメタデータ、データリネージ、品質管理を一元化することで、複雑さを軽減できます。また、クラウド戦略に適したオーケストレーションツールを評価し、データとAIのワークロードに対応できるスケーラブルなガバナンスフレームワークを導入する必要があります。
F5がどのように支援するか
企業がリアルタイム分析を拡大し、より大規模なモデルを導入してマルチクラウド環境を活用する中、信頼性の高い自動化されたパイプラインを確保するデータとAIのオーケストレーションは、最新の戦略に不可欠です。これにより、適切なデータフロー、高品質な入力、一貫したAIの動作が保証されます。成功には、データネットワーク、セキュリティ、配信テクノロジーなどの堅牢なインフラストラクチャが欠かせません。トラフィックのレジリエンス、セキュアなエンドポイント、可視性がなければ、高度なプラットフォームであっても高負荷への対応は困難です。
オーケストレーションには、強固な基盤が欠かせません。レジリエントなトラフィック管理により、データサービスとモデルサービスを拡張できます。APIセキュリティは、ガバナンスを確保し、機密データを保護します。統合オブザーバビリティにより、複数の環境にわたるパフォーマンス、ドリフト、エラー、動作を把握できるため、チームは確信を持ってパイプラインを運用できます。
企業は、次の点を確認する必要があります。高負荷時でもパイプラインは安定して稼働するか。ガバナンスに一貫性があるか。複数のクラウドにまたがって問題を追跡できるか。ネットワーク、セキュリティ、デリバリの各チームは、データおよびAIと連携できているか。答えが「いいえ」または「不明」であれば、オーケストレーションとインフラストラクチャを一体のシステムとして見直すことをご検討ください。
詳しくはf5.comをご覧ください。
