
高可用性とは
高可用性(HA)とは、通常、組み込みのフェイルオーバーメカニズムを使用することで、ダウンタイムや障害を発生させずにシステムを継続稼働させる能力を指します。高可用性システムは、予期しない事象が発生した場合でも、障害なく稼働できるように設計されています。
高可用性が重要な理由
HAの主な目的は、ダウンタイムを回避することです。ダウンタイムとは、システム、サービス、アプリケーション、クラウドサービス、または機能が利用できない、あるいは正常に動作しない期間を指します。ダウンタイムは、収益の損失、生産性の低下、企業の評判の毀損につながります。そのため、HAは以下にとって重要です。
- 事業継続性 – HAは、重要なシステム、機能、処理が常に期待どおりに稼働することを保証します。HAシステムは障害から迅速に復旧するため、組織は期待どおりに顧客へのサービス提供を継続できます(目立った停止が発生しないことが理想です)。
- ユーザーエクスペリエンスの向上 – 高速で信頼性の高いシステムは、顧客満足度の維持に役立ち、収益の損失、データの侵害、生産性の低下による悪影響を回避します。
- 競争優位性 – 高い可用性は、競合他社よりも高速で信頼性の高いサービスを提供する組織として差別化するうえで役立ちます。これは、全体的な品質と顧客満足度を重視する姿勢の表れです。
高可用性の種類
HAにはいくつかの種類があり、必要な冗長性のレベル、求められる耐障害性の種類、保護対象となるシステムの種類に基づいて分類できます。代表的なHAの種類は次のとおりです。
- アクティブ/パッシブ – バックアップシステムをパッシブモードまたはスタンバイモードで待機させ、プライマリシステムに障害が発生した場合にのみアクティブ化します。このフェイルオーバー保護方式では、バックアップシステムへの切り替えに手動操作が必要になる場合があります。
- アクティブ/アクティブ – 複数のシステムが同時に稼働し、ワークロードを分担します。1つのシステムに障害が発生すると、他のシステムが自動的にワークロードを引き継ぎます。このタイプのHAでは、より複雑な構成とシステム間の連携が必要ですが、手動で切り替える方式よりもパフォーマンスと拡張性が向上します。
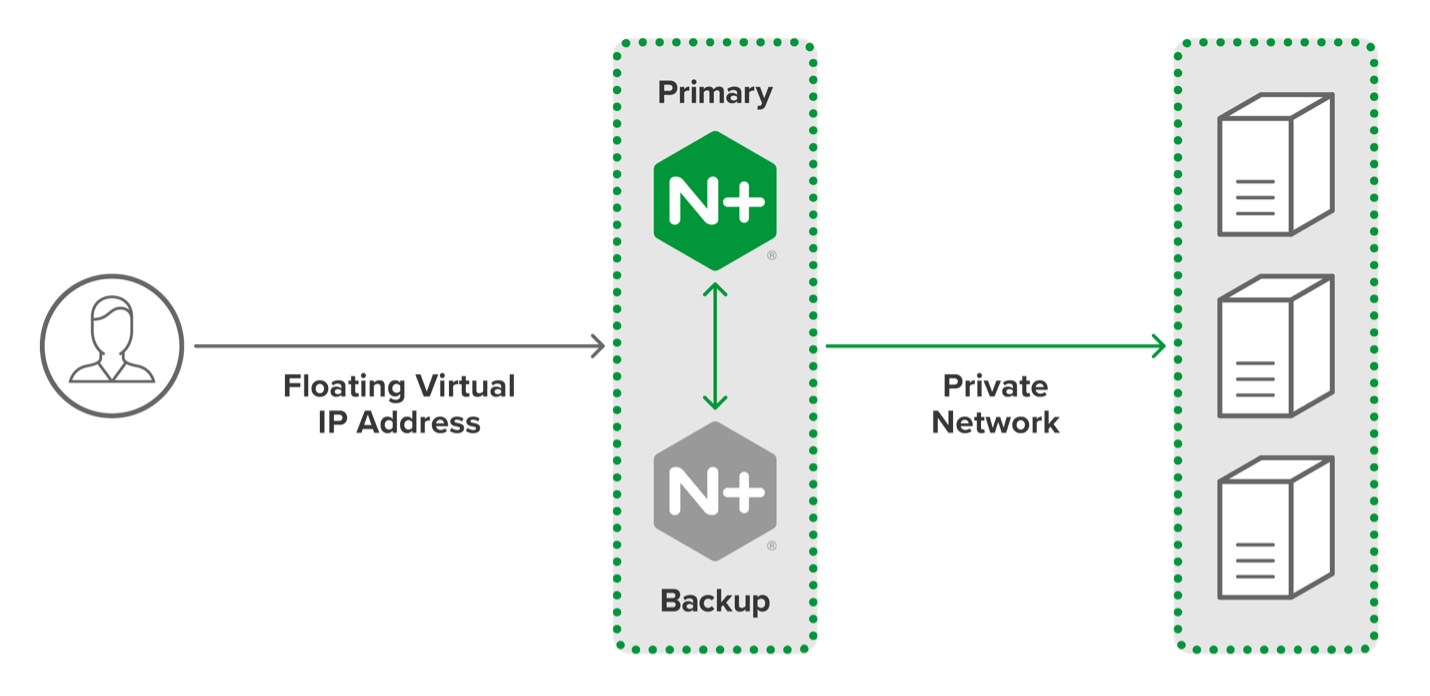
この図は、2台のNGINX Plusサーバーで構成されるアクティブ/パッシブHAクラスターを示しています。NGINXは、アクティブ/アクティブ構成やその他のHA構成にも対応しています。
高可用性はどのように実装されるのか
冗長化とフェイルオーバーのメカニズムにより単一障害点を排除し、コンポーネントに障害が発生しても、システム、アプリケーション、または機能全体の動作に影響が及ばないようにします。一般的なメカニズムには、次のものがあります。
- 冗長コンポーネント — システム内に複数のサーバー、ネットワーク接続、ストレージシステム、電源を配置します。1つのコンポーネントに障害が発生しても、別のコンポーネントが中断なく処理を引き継ぎます。
- 監視とアラート – パフォーマンスを継続的に監視し、可用性を常時確認します。停止やその他の問題が検出されると、アラートが生成されます。システム管理者は問題を迅速に特定して解決できるため、ダウンタイムのリスクを軽減できます。
- 負荷分散 – 1台以上の専用サーバーが、複数の(バックエンド)システム宛てのリクエストを受け取り、最適なパフォーマンスが得られるようにトラフィックを各システムへ分散します。いずれかのバックエンドシステムに障害が発生した場合、ロードバランサーは受信リクエストを他のシステムへ自動的にリダイレクトします。
- フェイルオーバーメカニズム – アクティブ/パッシブ構成、アクティブ/アクティブ構成、またはフェイルオーバークラスタリングを導入することで、1つのシステムに障害が発生しても、別のシステムが最小限の中断で処理を引き継げるようにします。
- バックアップおよび復旧システム – 障害発生時にデータとアプリケーションを迅速に復元できるようにします。システムはハイブリッド構成、複数の拠点への配置、クラウドベースの構成、または障害発生後に迅速に稼働できる構成にすることが可能です。
高可用性を実現する方法
HAを実現するために導入が必要なサービスとリソースは、システムの種類、HAの方式、組織固有の要件によって異なります。構成要素には次のものがあります。
- テクニカルサポート – HAシステムに関する支援を必要とする組織にとって、最初の相談窓口となります。専任のサポート担当者が、問題のトラブルシューティング、診断、解決を支援します。また、高い可用性を維持するためのベストプラクティスについても助言します。
- メンテナンスとアップグレード – HAシステムの稼働とセキュリティを維持するには、定期的なメンテナンスを実施し、利用可能な最新バージョンのソフトウェアを使用する必要があります。
- 災害復旧計画 – システムを迅速に復旧する必要がある組織にとって不可欠です。手順をあらかじめ定めて文書化しておくことで、システム管理者が緊急時に手順を思い出したり、解決策を考え出したりする必要がなくなります。
- ドキュメントとトレーニング – システム管理者がHAシステムの管理方法を理解するのに役立ちます。ドキュメントには、ベストプラクティス、チュートリアル、トレーニングセッションが含まれる場合があります。
ベストプラクティス:高可用性
ベストプラクティスに従うことで、運用パフォーマンスが向上し、多大なコストを伴うダウンタイムを最小限に抑えられます。これらの一般的なベストプラクティスは、組織のシステム、拠点、目標とする成果に合わせて調整できます。
- 冗長性を組み込む — ハードウェアコンポーネントからネットワーク接続まで、システムのあらゆるレベルを冗長化することで、1つのコンポーネントに障害が発生しても、システムは想定どおりに動作し続けます。
- トラフィックを負荷分散する – 受信リクエストを複数のシステムに分散することで、1つのシステムに障害が発生した場合でも、稼働中のシステムが処理を引き継げるようにします。
- パフォーマンスと可用性を監視する – 継続的な監視とアラートにより、問題の特定と解決にかかる時間を短縮します。
- フェイルオーバーメカニズムを頻繁にテストして検証する – 障害発生時にフェイルオーバーメカニズムが引き続き確実に機能を引き継げるかどうかを、定期的なテストで確認します。
- バックアップと復旧の手順 – 障害発生時にデータとアプリケーションを迅速に復元できるようにします。
- システムを定期的にアップグレードして保守する – アプリケーションとシステムの稼働とセキュリティの維持につながります。
- 担当者をトレーニングする – 特にHAを担当する個人やチームでは、定期的なテストと手順の徹底を標準業務手順とする必要があります。
- クラウドソリューションを検討する – クラウドストレージとディザスタリカバリを活用することで、障害の発生場所にかかわらずシステムの運用を継続できます。
- セキュリティを監視する – データ侵害や、悪意のある攻撃者または権限のないユーザーによるシステムへのアクセスを防止する対策を実施します。