In letzter Zeit ist viel über eine bestimmte These gesprochen worden – in Vorstandsetagen, bei Telefonkonferenzen zu Geschäftszahlen und in einer nicht abreißenden Flut von Meinungsbeiträgen: Der nächste große Fortschritt bei der Wirtschaftlichkeit von KI wird nicht allein durch schnellere Chips erzielt werden.
Das Argument ist stichhaltig, doch die Erkenntnis reicht weiter. Der erste drastische Rückgang der Kosten pro Token war das Ergebnis sich gegenseitig verstärkender Fortschritte bei Hardware und Software: schnellere Beschleuniger, bessere Speichersysteme, Formate mit geringerer Präzision, PagedAttention, kontinuierliches Batching, die Optimierung des Key-Value-Caches und Inferenz-Frameworks wie vLLM. Die Branche wurde erheblich besser darin, aus jedem Beschleuniger nutzbare Rechenleistung herauszuholen.
Dann suchte die Branche nach dem nächsten Bereich, auf den sie dieselbe Disziplin anwenden konnte, und wurde beim Datenpfad fündig, insbesondere beim Speicher. Diese Arbeit ist unerlässlich, aber sie ist auch nur die halbe Geschichte.
Der Datenpfad ist nur die halbe Wahrheit
Speicher ist in einer KI-Fabrik längst nicht mehr passiv. Modelle werden daraus geladen. Checkpoints werden daraus wiederhergestellt. Retrieval-Augmented Generation ist auch unter hohem Latenzdruck darauf angewiesen. Ab einer gewissen Größenordnung können Kontext- und Cache-Ebenen über den GPU- und Systemspeicher hinausreichen, da die erneute Berechnung bereits abgeschlossener Aufgaben eine kostspielige Nutzung eines Beschleunigers darstellt.
Die Wirtschaftlichkeit von KI wird jedoch von zwei miteinander verbundenen Datenströmen bestimmt. Der eine betrifft die Bewegung der Daten, mit denen das Modell gespeist wird: wo die Bytes gespeichert sind, wie schnell sie abgerufen werden können und wie oft sie verschoben werden müssen. Der andere betrifft den Weg, den eine Inferenzanfrage zurücklegt – von einem Benutzer, einer Anwendung oder einem Agenten über die Datenverkehrssteuerung und die Durchsetzung von Richtlinien bis zu einem Modellserver und wieder zurück.
Dieser zweite Datenfluss transportiert Daten während der Übertragung. Im Vergleich zu Rechenleistung und Speicher wird er in vielen Produktionsumgebungen nach wie vor unzureichend gemessen und optimiert. Hier entscheidet sich, wo die nächsten Effizienzgewinne erzielt werden – und wo die nächste Verschwendung entsteht.
Die Token-Steuer
Auf einem GPU-Knoten ist die zentrale Verarbeitungseinheit des Hosts nicht untätig. Sie übernimmt Netzwerkaufgaben, terminiert die Transport Layer Security, setzt Richtlinien durch, verarbeitet den Ost-West-Datenverkehr, erzeugt Telemetriedaten und überträgt Daten zwischen Schnittstellen und Beschleunigern. Keine dieser Aufgaben erzeugt direkt Tokens. Wird die CPU zum Engpass, sinkt die nutzbare Inferenzleistung.
Nennen wir es die Token-Steuer: Infrastruktur-Overhead, der Host-Ressourcen beansprucht und unbemerkt die wirtschaftliche Leistung des Knotens schmälert. Die Lösung ist nicht immer ein schnellerer Host-Prozessor. In großem Maßstab lassen sich geeignete Netzwerk-, Verschlüsselungs-, Datenverkehrsmanagement- und Sicherheitsfunktionen auf programmierbare Infrastruktur verlagern, die sich bereits im Datenpfad befindet.
In von F5 in Auftrag gegebenen unabhängigen Tests der Tolly Group, F5 BIG-IP Next for Kubernetes auf NVIDIA BlueField-3-DPUs wurden ein bis zu 40 % höherer Token-Durchsatz, eine um 61 % kürzere Zeit bis zum ersten Token und eine um 34 % geringere Anfragelatenz als bei den getesteten CPU-basierten Alternativen erzielt.
Die finanziellen Auswirkungen liegen auf der Hand. Wenn eine fest vorgegebene Infrastruktur innerhalb der erforderlichen Service-Level-Ziele 1,4-mal so viele verkäufliche Token erzeugt, sinken die Infrastrukturkosten pro Token um etwa 29 %. Bei entsprechender Nachfrage kann auch der Umsatz pro Beschleuniger steigen. Das ist eine aussagekräftigere geschäftliche Kennzahl als die bloße Feststellung, dass das Netzwerk schneller ist.
Routing wurde zur Ablaufplanung
Herkömmlicher Lastenausgleich verteilt Anfragen. Das funktioniert, wenn die Anfragen weitgehend austauschbar sind. Bei der Inferenz großer Sprachmodelle trifft diese Annahme jedoch nicht zu, da die Kosten einer Anfrage von der Kontextlänge, der Ausgabelänge, dem Cache-Status, der Modellauswahl, der Warteschlangentiefe und der aktuellen Auslastung des Beschleunigers abhängen.
- Ein kurzer Prompt mit einer knappen Vervollständigung kann um Größenordnungen kostengünstiger sein als ein sehr langer Kontext mit einer langen Antwort.
- Eine Anfrage, die auf einen bereits gefüllten Key-Value-Cache zugreift, kann eine aufwendige erneute Berechnung des Prefill-Schritts vermeiden.
- Anfragen mit hohem Prefill- bzw. Decode-Anteil können sich gegenseitig beeinträchtigen, wenn sie auf demselben Beschleuniger ausgeführt werden.
- Ein Modellserver mit acht Anfragen in der Warteschlange und einer ohne wartende Anfragen können bei einer zustandslosen Prüfung gleichermaßen fehlerfrei erscheinen.
Ein Traffic-Manager, der keinen Einblick in diese Bedingungen hat, trifft zwangsläufig schlechte Entscheidungen bei der Zuweisung. Die Kosten fallen doppelt an: durch die Latenz, die der Nutzer als Zeit bis zum ersten Token wahrnimmt, und durch die erneute Berechnung, für die das Unternehmen in Form doppelt ausgeführter Arbeit bezahlt.
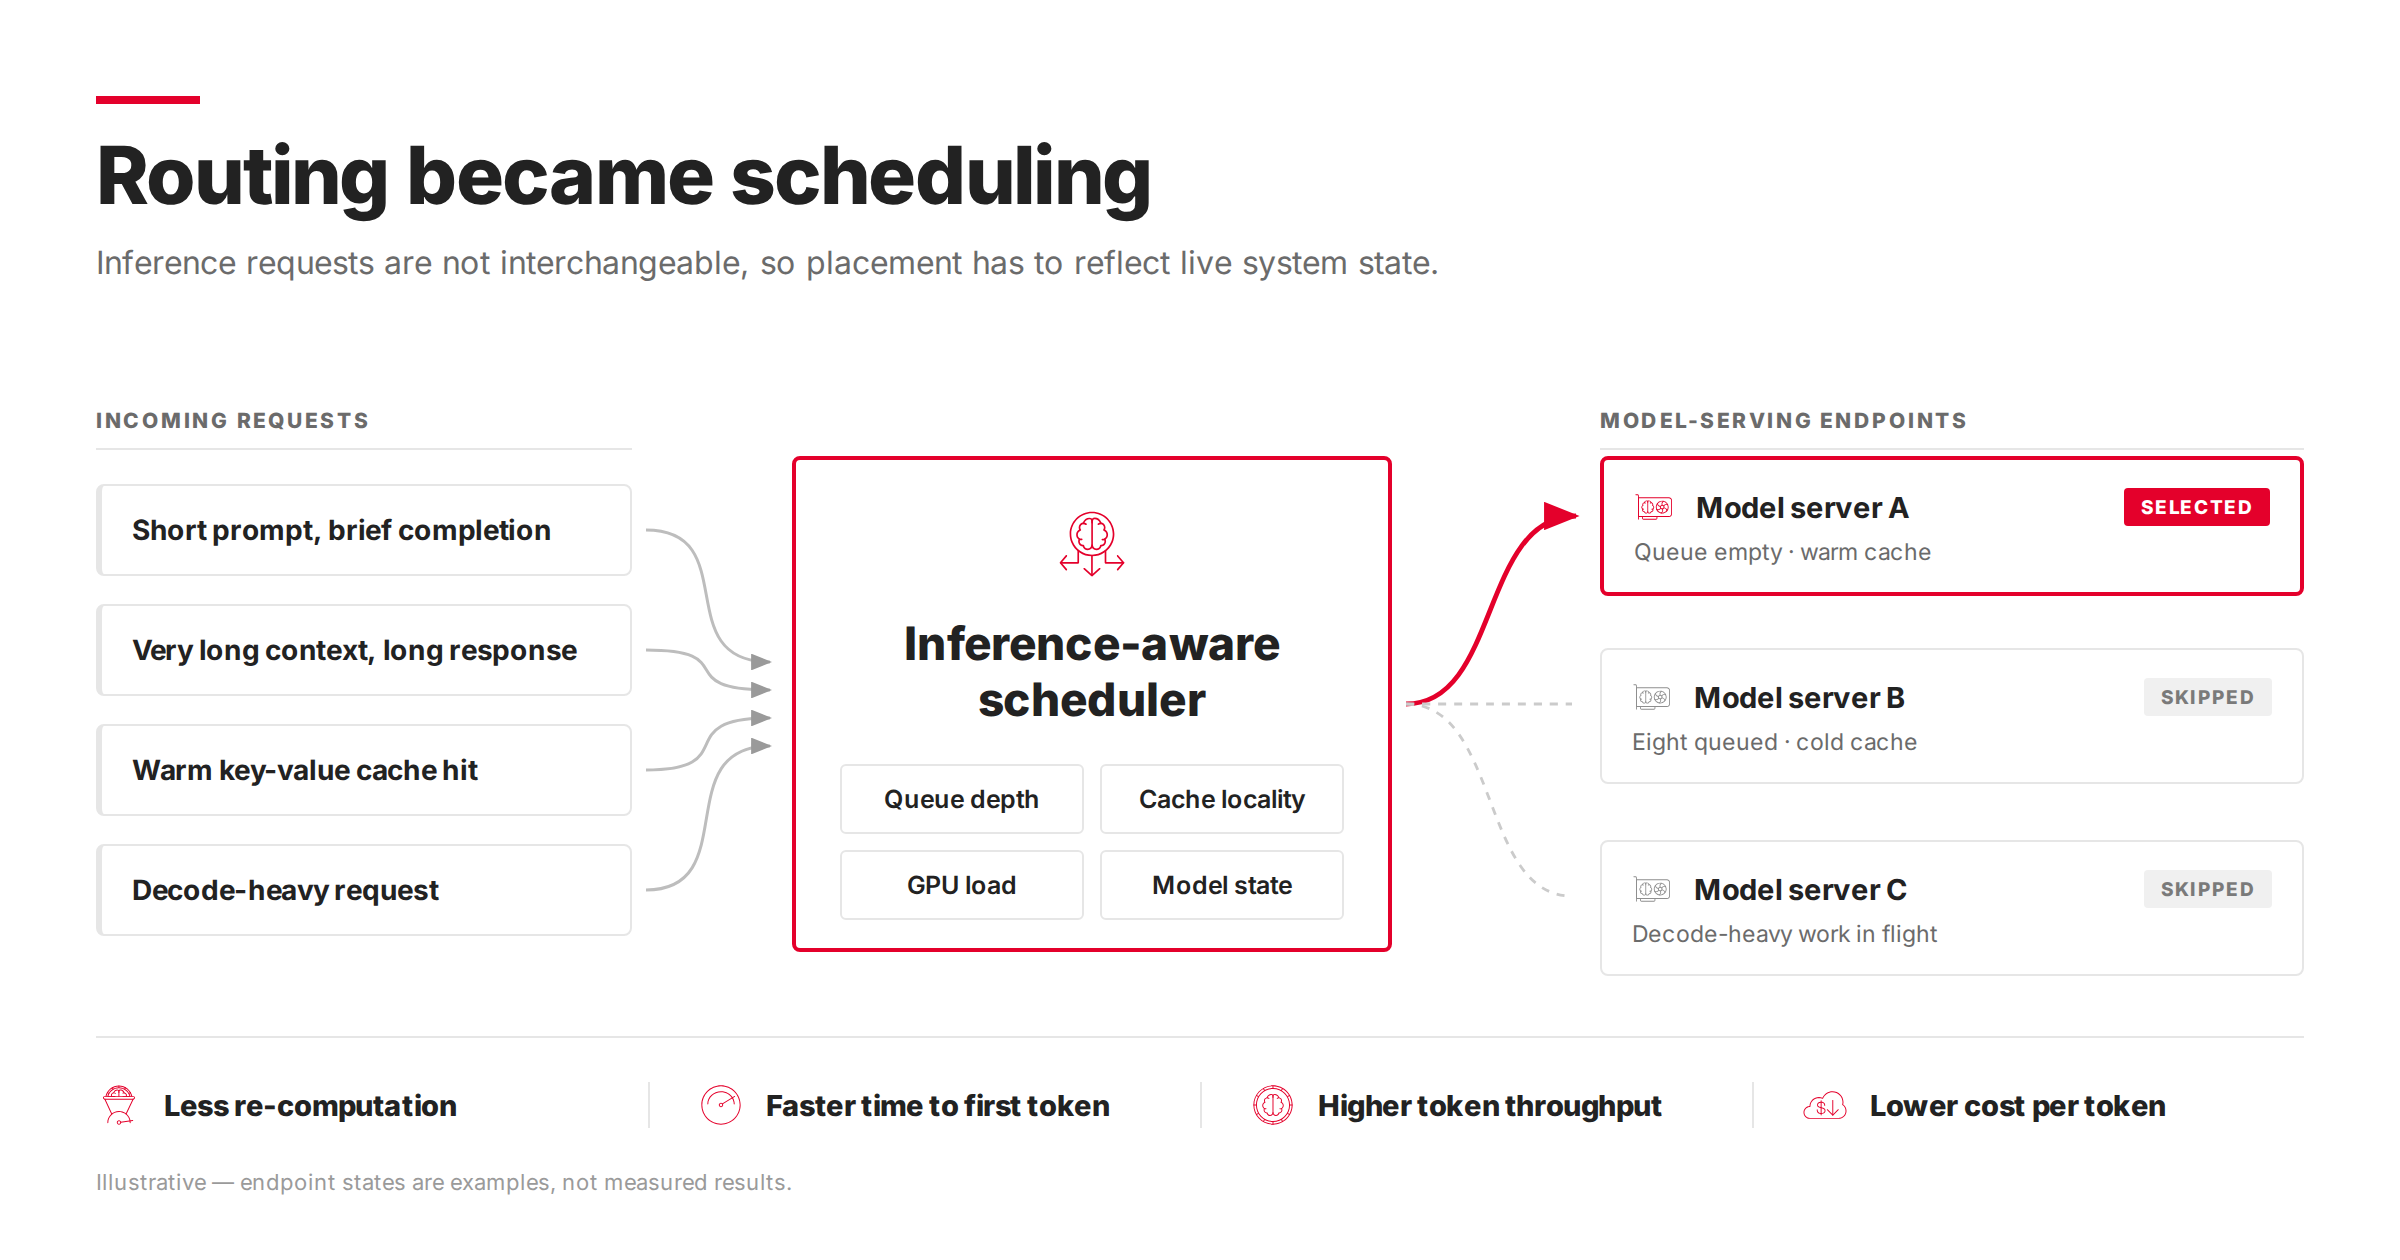
Das Routing in einer KI-Fabrik ist daher nicht mehr nur eine Netzwerkfunktion. Es ist eine Planungsentscheidung, die im Netzwerk getroffen wird. Dabei profitiert es von denselben Eingabedaten, die jeder Scheduler benötigt: dem aktuellen Zustand der Modellserver, der Warteschlangentiefe, Telemetriedaten der Beschleuniger, der Cache-Lokalität und Laufzeitsignalen des Inferenz-Frameworks.
Sicherheit ist ebenfalls eine Kostenfunktion
Sicherheit wird im Zusammenhang mit einer KI-Fabrik meist unter dem Aspekt des Risikos betrachtet: Prompt-Injection, Datenlecks, Agenten, die ihre Befugnisse überschreiten, und regulatorische Risiken. All diese Risiken sind real. Untersuchungen von F5 haben ergeben, dass 88 % der Unternehmen von mindestens einer operativen oder sicherheitsbezogenen Herausforderung im Zusammenhang mit KI berichten.
Auch aus Sicht der Stückkosten gibt es ein Argument. Anfragen, die vor der Modellausführung blockiert werden, vermeiden unnötige Inferenzkosten. Anfragen, die erst nach der Generierung einer vollständigen Antwort geprüft werden, verbrauchen Rechenleistung, bevor die Richtlinie greift. Rechnet man dies auf Scraping-Traffic, massenhafte Wiederholungsversuche, einen in einer Schleife festhängenden Agenten oder wiederholte Jailbreak-Versuche hoch, wirkt sich die Platzierung der Durchsetzungsmechanismen nicht nur auf das Risiko, sondern auch auf die Kosten aus.
Das Prinzip besteht nicht darin, alle Kontrollen an einer Stelle zu bündeln. Einige Schutzmaßnahmen erfordern eine eingehendere Prüfung auf Anwendungs- oder Modellebene, die wiederum eigene Rechenkosten verursacht. Ziel ist es, die kostengünstigste wirksame Kontrolle so früh wie praktikabel anzuwenden und anschließend dort eine eingehendere Prüfung vorzunehmen, wo sie einen Mehrwert bietet.
Agentenbasierter Datenverkehr verschärft dieses Problem. Agenten starten neue Versuche, fächern Anfragen auf und rufen Tools auf, die Modelle aufrufen, die wiederum andere Modelle aufrufen. So erzeugen sie Datenverkehr in Maschinengeschwindigkeit, für den auf menschliche Nutzung ausgelegte Ratenbegrenzungen nicht konzipiert sind. Das Ergebnis ist nicht immer eine Sicherheitsverletzung. Manchmal ist es schlicht eine hohe Rechnung.
Die kommerzielle Ebene fehlt
Wenn ein Betreiber Tokens nicht nach Mandant, Modell, Benutzer und Anwendung erfassen kann, wird es schwierig, Preise festzulegen, die Nutzung zu messen, Kosten intern weiterzuverrechnen, eine faire Nutzung durchzusetzen oder eine Marge zu sichern. Die Infrastruktur liefert möglicherweise hervorragende Telemetriedaten zu Stromverbrauch und Systemzustand, bietet jedoch nur begrenzte Einblicke in die Zuordnung von Umsätzen.
Mandantenfähigkeit verschärft das Problem. Eine gemeinsam genutzte GPU-Infrastruktur ohne wirksame Isolierung und mandantenspezifische Abrechnung kann dazu führen, dass eine Lastspitze eines Mandanten bei einem anderen eine Verletzung der Service-Level-Vereinbarung verursacht. Ein ressourcenintensiver Nachbar in einem KI-Cluster ist nicht nur ein Leistungsärgernis. Er kann zur Kundenabwanderung führen.
Der Inferenzpfad bietet den zuverlässigsten übergreifenden Beobachtungspunkt, da er Anfragen und Antworten über Benutzer, Anwendungen, Modelle und Mandanten hinweg erfassen kann. Modellserver und Abrechnungssysteme sind weiterhin wichtig, doch im Inferenzpfad lassen sich Messung und Durchsetzung einheitlich umsetzen.
Die Inferenz-Serviceebene
Betrachtet man diese Aspekte zusammen, zeichnet sich eine dritte Architekturebene ab. Die Rechenebene umfasst die GPUs und Beschleuniger, die alle bei ihrer Budgetplanung berücksichtigen. Der Datenpfad deckt Speicherung, Abruf, Caching und Arbeitsspeicher ab. Die Inferenz-Serviceebene steuert, wie Anfragen die Beschleuniger erreichen, wie sie unter Berücksichtigung des tatsächlichen Systemzustands eingeplant werden, was gestoppt wird, bevor es unnötig Rechenleistung verbraucht, was erfasst wird und wem die Kosten in Rechnung gestellt werden.
Diese Ebene existiert bereits, ist jedoch häufig eher ein zufälliges Sammelsurium einzelner Komponenten: hier ein Load Balancer, dort ein API-Gateway, dazu ein Service Mesh, eine Web Application Firewall, Telemetrie-Kollektoren und am Ende eine Tabellenkalkulation. Nur selten wurde sie als kohärentes System mit gemeinsam genutzten Telemetriedaten, einheitlichen Richtlinien und gezielt platzierten Durchsetzungspunkten konzipiert.
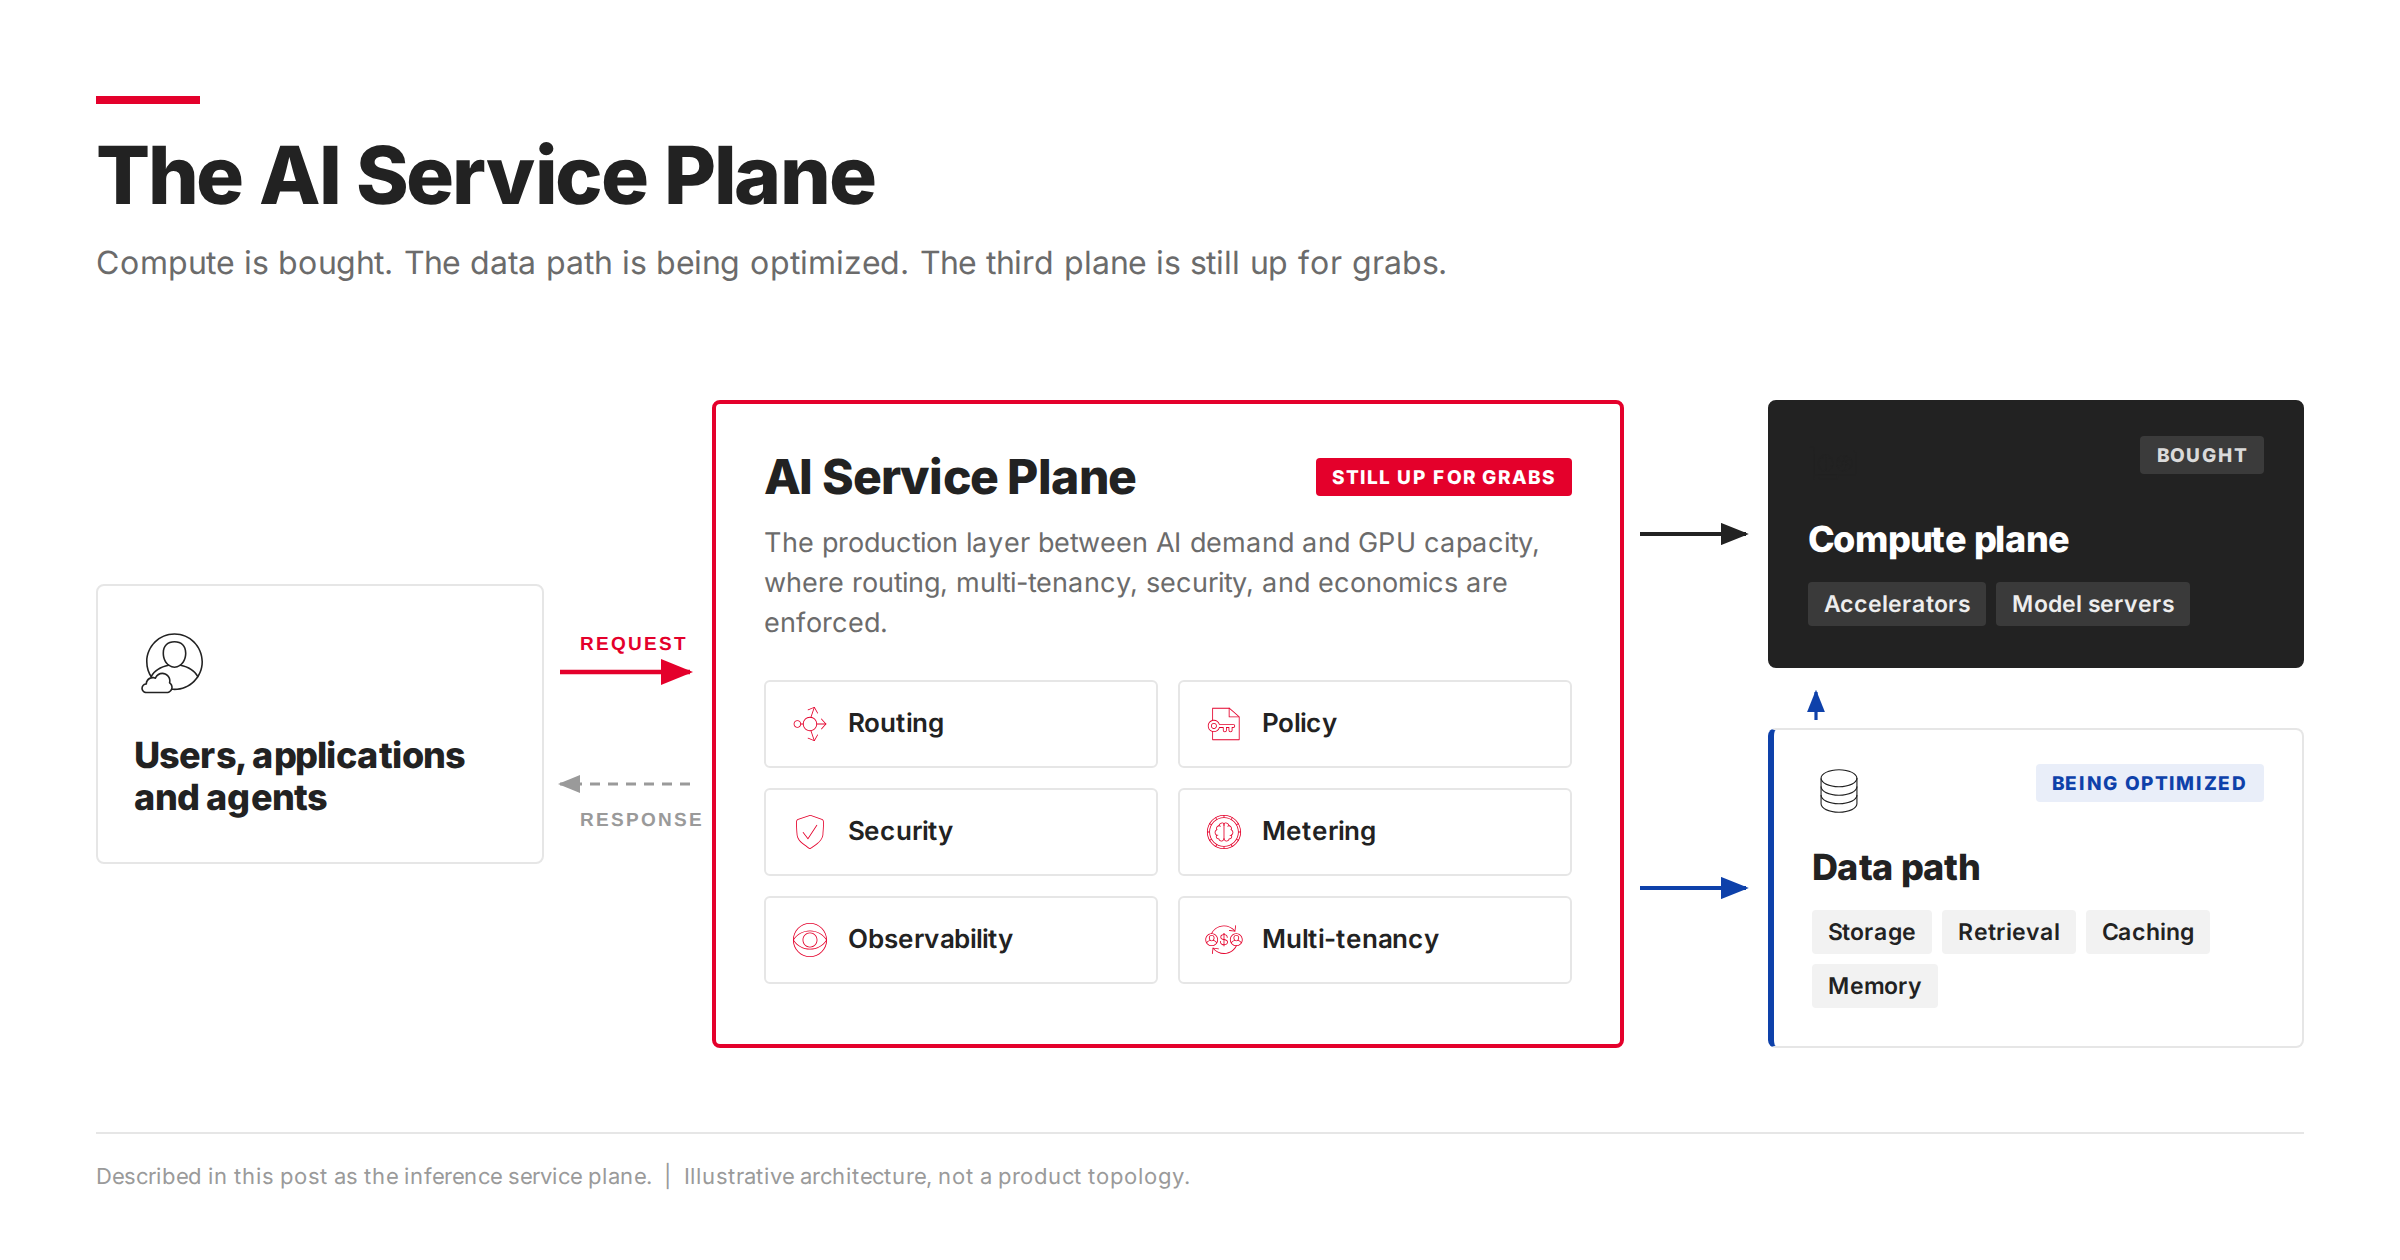
F5 BIG-IP Next for Kubernetes kann auf dem Host oder auf NVIDIA BlueField DPUs ausgeführt werden. Es bietet Kubernetes-natives Traffic-Management, Sicherheit, mandantenfähige Richtlinien, Observability, intelligente Lastverteilung und Token-Governance entlang des gesamten Inferenzpfads.
Auf der Anwendungsebene bietet F5 AI Gateway Governance für Modelle und Agenten sowie Routing, Caching, Verbrauchserfassung, Sicherheitskontrollen und Auditierbarkeit für Prompts, Antworten, Modelle und Tools.
Die architektonische Ausrichtung ist wichtiger als jedes einzelne Produkt: Richtlinien müssen klar formuliert, dort durchgesetzt werden, wo sie am wirksamsten sind, und Telemetriedaten müssen über Infrastruktur- und Anwendungsebenen hinweg gemeinsam genutzt werden. So können Betreiber blinde Flecken reduzieren und verhindern, dass verschiedene Teams voneinander abweichende Kontrollen pflegen.
Den Pfad bewusst gestalten
Drei Fragen gehören in die nächste Überprüfung der KI-Infrastruktur: Wie hoch ist die Ausbeute an nutzbaren Tokens aus den bereits bereitgestellten Beschleunigerkapazitäten? Wie viel Host-Rechenleistung wird für Aufgaben verbraucht, die nicht direkt Tokens erzeugen? Welche Kosten verursacht eine abgelehnte Anfrage, wenn sie die Modellausführung erreicht, bevor die Durchsetzung greift?
Branchenweit verlagert sich die Diskussion von der Kapazität hin zur Wertschöpfung – weg von der Frage, welche Infrastruktur vorhanden ist, hin zu dem, was sich zuverlässig aus ihr herausholen lässt. Der nächste große Fortschritt bei der Wirtschaftlichkeit von KI wird weder allein durch schnellere Chips noch allein durch Speicher erzielt werden. Er wird daraus entstehen, dass der Inferenzpfad als wirtschaftliches System betrachtet wird.
Die Rechenebene ist gekauft. Der Datenpfad wird optimiert. Die Inferenz-Serviceebene ist noch nicht vergeben.
Weitere Informationen finden Sie im Bericht zur KI-Performance.
Über den Autor
Ähnliche Blogbeiträge

Vier Gründe, warum Sie den F5 Post-Mythos Security Summit nicht verpassen sollten
Holen Sie sich Expertenrat, um Ihre Apps, APIs und Modelle in der Post-Mythos-Welt zu schützen.

Von einer App zu einer ganzen Agentenflotte: Ein 90-Tage-Framework für KI-Sicherheit
Vermeiden Sie den kostspieligen Ansatz „Jetzt bereitstellen, später absichern“ – mit einem umfassenden Framework zum Schutz von KI-Modellen, Anwendungen und autonomen Agenten.

Fünf Stufen antifragiler Cyberresilienz verwandeln Praxis in Ergebnisse
Erfahren Sie, wie fünf Stufen antifragiler Resilienz Störungen in adaptive Verhaltensweisen überführen, die Ausfälle begrenzen und hybride Multicloud-Architekturen stärken.

Warum Ihre KI-Richtlinien, Governance und Leitplanken nicht warten können
KI-Richtlinien und -Governance dürfen nicht länger als reine Formalitäten oder Zukunftsthemen betrachtet werden. Sie müssen durch praktische, durchsetzbare Leitplanken ergänzt werden.

Wenn „privat“ nicht privat ist: Wie ChatGPT-Unterhaltungen öffentlich wurden
KI verändert die Arbeitsabläufe in Unternehmen, doch eine übersehene Einstellung hat bereits Tausende vertraulicher Unterhaltungen öffentlich zugänglich gemacht
KI-Nutzung verstehen: Warum Unternehmen Transparenz brauchen
Anstatt einen zu laxen oder zu strengen Ansatz zu verfolgen, können Unternehmen durch mehr Transparenz bei der KI-Nutzung fundierte und durchsetzbare Entscheidungen treffen.