Geschwindigkeit – sie ist in der heutigen digitalen Welt entscheidend, denn Verbraucher können problemlos zu einem Wettbewerber wechseln, wenn Ihre App zu langsam ist. Die Geschwindigkeit einer App hängt letztlich von reaktionsschnellen, stabilen und anpassungsfähigen APIs ab. Einer der entscheidenden Faktoren für die Reaktionsfähigkeit einer API ist die durch Ihr API-Gateway verursachte Latenz. Doch nicht alle API-Gateways bieten die gleiche Leistung.
Wie wichtig dieser Punkt ist, wurde uns im vergangenen Herbst deutlich, als uns ein NGINX-Kunde – ein bedeutendes Unternehmen der Verbraucherkreditbranche – von der zunehmenden Bedeutung einer API-Performance in „Echtzeit“ berichtete, da immer mehr Apps und andere Komponenten miteinander kommunizieren müssen, um das von den Benutzern erwartete digitale Erlebnis zu bieten. Wir waren hocherfreut zu erfahren, dass NGINX Plus das einzige API-Gateway war, das die vom Kunden benötigten extrem niedrigen API-Latenzen – bis hinunter zu 10 Millisekunden (ms) – erreichte. Viele weitere Kunden, darunter Capital One, haben uns ebenfalls berichtet, wie sie mit NGINX Open Source oder NGINX Plus als API-Gateway die Latenz reduziert und den Durchsatz verbessert haben.
Wir beschlossen, das API-Ökosystem genauer zu untersuchen und herauszufinden, was eine API zu einer „Echtzeit-API“ macht. Anhand verschiedener Faktoren kamen wir zu dem Schluss, dass eine Echtzeit-API API-Aufrufe durchgängig in weniger als 30 ms verarbeiten muss – und zwar bei jedem Perzentil bis einschließlich des 99. Perzentils (das heißt, dass im Durchschnitt nur 1 von 100 Aufrufen länger als 30 ms dauert).
Vergleich von API-Management-Lösungen
Unsere eigenen Tests zeigen durchweg, dass sich mit unserer API-Management-Lösung problemlos API-Performance in Echtzeit erzielen lässt. Sie kombiniert NGINX Plus als API-Gateway zur Verarbeitung von API-Aufrufen mit dem NGINX Controller API Management Module zur Verwaltung sowohl der NGINX Plus-Instanzen als auch Ihrer APIs über deren gesamten Lebenszyklus hinweg – von der Definition und Veröffentlichung bis hin zur Verwaltung und Überwachung.
Wir verstehen jedoch, dass Sie sich vielleicht nicht allein auf unsere Aussage verlassen möchten. Daher haben wir GigaOm, ein unabhängiges Unternehmen für technische Forschung und Analyse, mit einem objektiven und transparenten Benchmarking unserer API-Management-Lösung und anderer beliebter Lösungen auf dem Markt beauftragt: zwei Lösungen, die wie NGINX lokal oder in der Cloud bereitgestellt werden können, Apigee und Kong Enterprise, sowie zwei vollständig verwaltete Cloud-Angebote, Amazon API Gateway und Kong Cloud.
In diesem Blog fassen wir die Ergebnisse der Tests von GigaOm zusammen (Spoiler: NGINX Plus stellte APIs unter allen getesteten Bedingungen in Echtzeit bereit, die anderen Lösungen hingegen nicht). Wenn Sie alle Einzelheiten zu den Lösungen, der Testmethodik und den Ergebnissen erfahren möchten, wenden Sie sich an ein Mitglied unseres Teams.
Hinweis: Die Apigee-Endbenutzer-Lizenzvereinbarung (EULA) untersagt die Veröffentlichung von Testergebnissen ohne die ausdrückliche Genehmigung von Google. Daher enthalten leider weder der Bericht noch dieser Blog Informationen zu Apigee.
Benchmark-Übersicht
GigaOm verwendete das HTTP-Lasttesttool Vegeta, um Anfragen (API-Aufrufe) zu generieren, und maß, wie viel Latenz – also die Zeit bis zur Rückgabe der Antwort auf einen API-Aufruf – das API-Gateway bei verschiedenen Anzahlen von Anfragen pro Sekunde (RPS) verursachte, die GigaOm als „Angriffsraten“ bezeichnet. GigaOm führte Testläufe mit Angriffsraten durch, die bei 1.000 RPS begannen und auf 5.000, 10.000, 20.000 usw. erhöht wurden, bis Vegeta Fehlerstatuscodes meldete. Jeder Testlauf dauerte 60 Sekunden und wurde dreimal wiederholt. Wie in den nachstehenden Diagrammen dargestellt, erfasste GigaOm die Latenzen beim 50., 90., 95., 99., 99,9. und 99,99. Perzentil und zeichnete außerdem die längste während des Testlaufs beobachtete Latenz auf (Max. in den Diagrammen).
Ergebnisse: NGINX vs. Kong Enterprise
GigaOm führte zwei Benchmarks durch, in denen NGINX Plus (bereitgestellt mit NGINX Controller) und Kong Node (bereitgestellt mit Kong Enterprise) verglichen wurden. Im ersten Benchmark gab es einen einzelnen Worker-Knoten (eine Instanz von NGINX Plus oder Kong Node). Im zweiten Benchmark gab es drei Worker-Knoten, deren Last von NGINX Open Source im Round-Robin-Modus verteilt wurde. (GigaOm betont, dass die Verwendung von NGINX Open Source als Load Balancer keinen Vorteil für NGINX Plus darstellte und dass selbst Kong diese Lösung als Load Balancer für geclusterte Kong Node-Instanzen empfiehlt.)
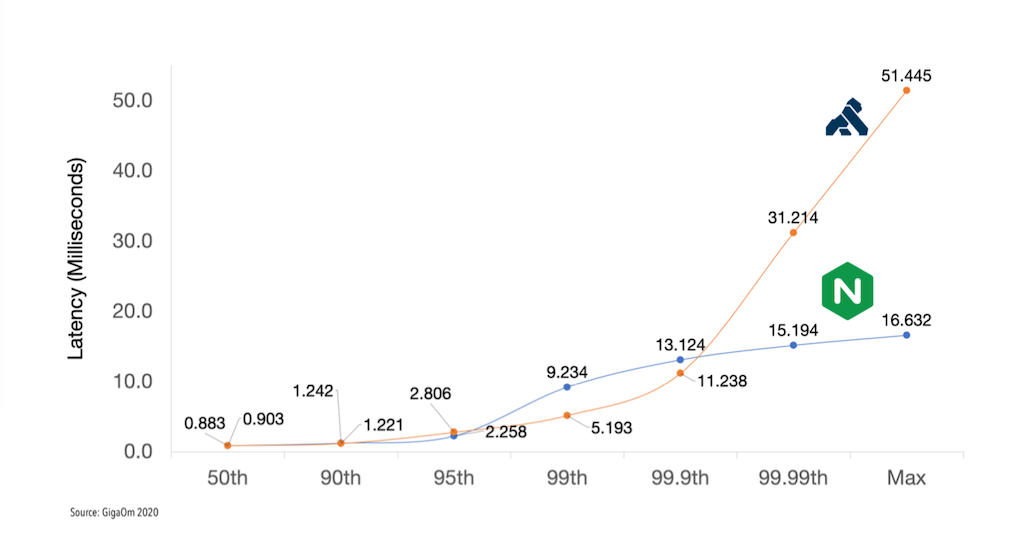
Wie die folgenden Diagramme zeigen, ist der Unterschied bei der Latenz zwischen NGINX und Kong bis zum 99. Perzentil vernachlässigbar. Ab diesem Punkt steigt die Latenz von Kong exponentiell an. Beim 99,99. Perzentil ist die Latenz von Kong in den beiden Benchmarks drei- beziehungsweise doppelt so hoch wie die von NGINX.
Das 99. Perzentil ist ein sinnvoller Mindestwert, um eine API als echtzeitfähig zu definieren. GigaOm weist jedoch darauf hin, dass es bei realen Implementierungen „äußerst wichtig“ ist, auch bei höheren Perzentilen wie dem 99,9. und 99,99. Perzentil eine niedrige Latenz aufrechtzuerhalten. Im Bericht heißt es:
Latenzergebnisse weisen im Zeitverlauf häufig mehrere Häufungen auf, wobei die Spitzen kurzzeitige „Aussetzer“ bei den Antwortzeiten darstellen.
Diese Aussetzer sind relevant. Wenn die mediane Antwortzeit oder Latenz weniger als 30 ms beträgt, es aber Aussetzer von 1 Sekunde oder Latenzen von mehr als 1 Sekunde gibt, wirkt sich dies kumulativ auf die nachfolgende Benutzererfahrung aus. Stellen Sie sich beispielsweise vor, Sie fahren zu einem Drive-in-Schnellrestaurant, in dem die mediane Wartezeit auf das Essen 1 Minute beträgt. Das würden Sie wahrscheinlich als gutes Kundenerlebnis empfinden. Doch was passiert, wenn der Kunde vor Ihnen ein Problem mit seiner Bestellung hat und dessen Lösung 10 Minuten dauert? Ihre Wartezeit würde dann tatsächlich 11 Minuten betragen. Da Ihre Anfrage nach dem Aussetzer in die Warteschlange eingereiht wurde, kann die Verzögerung des verzögerten 99,99. Perzentils auch zu Ihrer Verzögerung werden.
Die negativen Auswirkungen ungewöhnlich hoher Latenzen in den oberen Perzentilen sind bei verteilten Anwendungen noch gravierender, da eine einzelne Clientanfrage mehrere nachgelagerte API-Aufrufe auslösen kann. Angenommen, eine Clientanfrage erzeugt beispielsweise 10 API-Aufrufe an ein Subsystem, das mit einer Wahrscheinlichkeit von 1 % langsam antwortet. Mathematisch lässt sich zeigen, dass die Wahrscheinlichkeit, dass die Clientanfrage dadurch von einer langsamen Antwort betroffen ist, bei fast 10 % liegt. Einzelheiten zur Berechnung finden Sie unter Wer hat die Latenz meines 99. Perzentils verschoben?
Abbildung 1 zeigt die Ergebnisse für eine Angriffsrate von 30.000 RPS mit einem einzelnen Worker-Knoten. Beim 99,99. Perzentil ist die Latenz von Kong mehr als dreimal so hoch wie die von NGINX und überschreitet den Schwellenwert von 30 ms für Echtzeit-APIs. Im Gegensatz dazu erreicht NGINX Plus bei jedem Perzentil Echtzeitlatenz – selbst die höchste gemessene (Max) Latenz von 13 ms liegt unter der Hälfte des Echtzeit-Schwellenwerts.
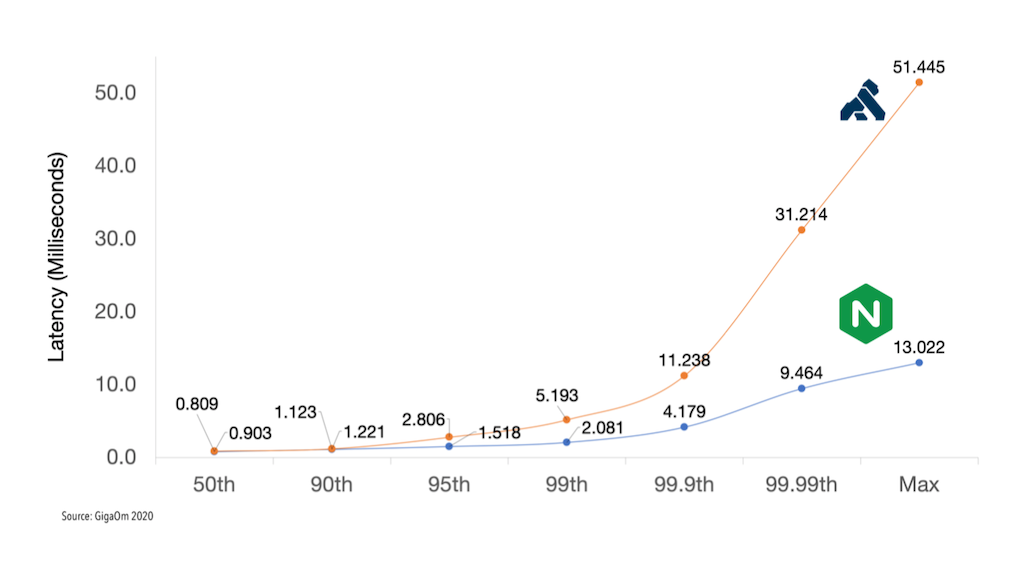
Abbildung 2 zeigt sehr ähnliche Ergebnisse für den Benchmark mit drei Worker-Knoten, ebenfalls bei einer Anfragerate von 30.000 RPS. Interessanterweise übertrifft Kong NGINX beim 99. und 99,9. Perzentil, verzeichnet jedoch beim 99,99. Perzentil erneut einen enormen Latenzanstieg. Diesmal ist die Latenz etwa doppelt so hoch wie bei NGINX. Wie beim ersten Benchmark bleibt NGINX bei allen Perzentilen unter dem Echtzeit-Schwellenwert von 30 ms.
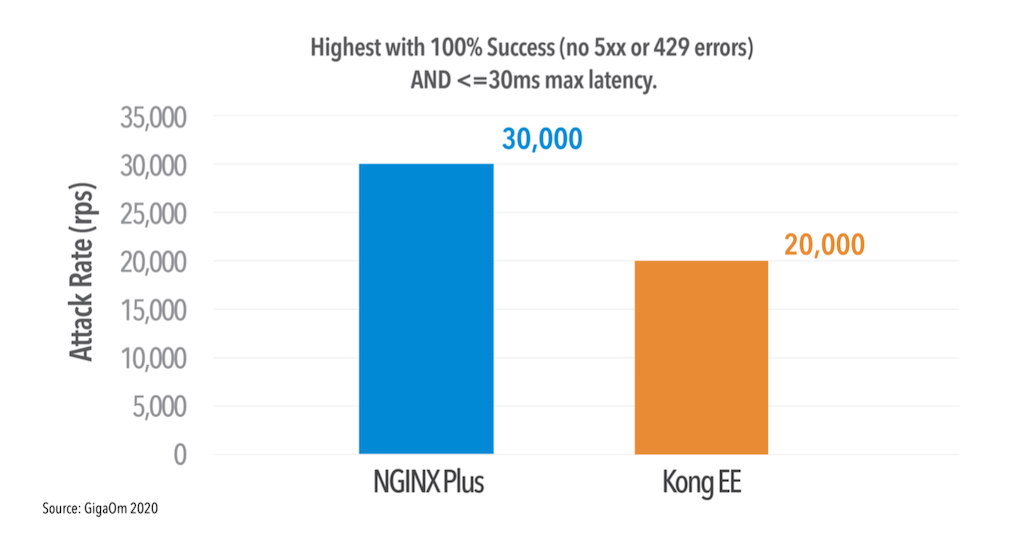
Eine weitere Möglichkeit, die Leistung eines API-Gateways zu beurteilen, besteht darin, die maximale Anzahl an RPS zu ermitteln, die es mit einer Erfolgsquote von 100 % verarbeiten kann (keine 5xx- oder 429-[Too Many Requests]-Fehler), wobei die Latenz bei allen Perzentilen unter 30 ms liegt. Dies gilt sowohl für Konfigurationen mit einem einzelnen Knoten als auch für solche mit drei Knoten. Abbildung 3 zeigt, dass NGINX nach diesem Maßstab 50 % mehr RPS als Kong bewältigt: 30.000 gegenüber 20.000.
Ergebnisse: NGINX im Vergleich zu Kong Cloud und Amazon API Gateway
In der dritten Benchmark-Reihe verglich GigaOm NGINX Plus mit Kong Cloud und Amazon API Gateway. GigaOm betont, dass ein direkter Vergleich äußerst problematisch ist, da Kong Cloud und Amazon API Gateway vollständig verwaltete SaaS-Angebote sind, während NGINX Controller ein PaaS-Angebot ist und derzeit nicht als SaaS verfügbar ist. Insbesondere legt keines der beiden SaaS-Angebote offen, welche Instanztypen, Rechenleistung, Arbeitsspeicher- oder Netzwerkressourcen es nutzt. Daher musste GigaOm die vergleichbaren Einstellungen für NGINX Plus bestmöglich abschätzen.
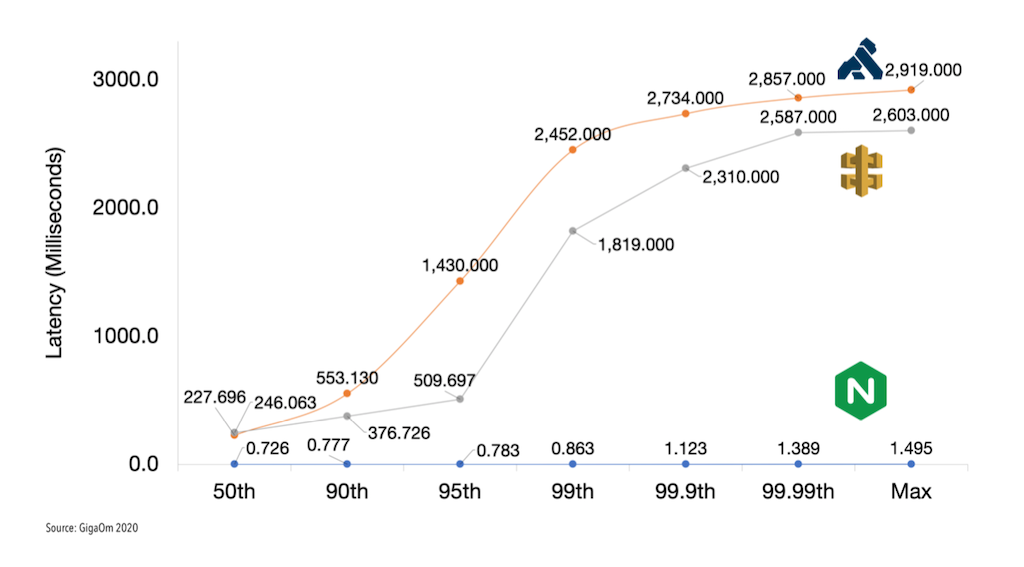
Selbst wenn man den Vergleich mit NGINX Plus außer Acht lässt, wird sofort deutlich, dass die SaaS-Angebote bei keinem der getesteten Perzentile APIs in Echtzeit bereitstellen können – nicht einmal bei der in Abbildung 4 dargestellten zweitniedrigsten Anfragerate (5.000 RPS). Beim 50. Perzentil liegt die Latenz der SaaS-Angebote bereits mehr als siebenmal über dem Schwellenwert von 30 ms; beim 99,99. Perzentil überschreitet sie diesen Schwellenwert um mehr als 8.000 %. Daraus folgt eindeutig, dass Kong Cloud und Amazon API Gateway unter keinen Bedingungen eine Erfolgsquote von 100 % bei einer Latenz von unter 30 ms erreichen.
NGINX als einzige Echtzeit-API-Lösung validieren
Zusammenfassend lässt sich sagen, dass NGINX die einzige von GigaOm getestete Lösung ist, die die Anforderungen an die Echtzeit-API-Verarbeitung erfüllt und bei jedem Perzentil eine Latenz von weniger als 30 ms erreicht. Kong Enterprise erzielt beim 99. Perzentil Echtzeitleistung, doch bei höheren Perzentilen steigt die Latenz deutlich an. Daher eignet sich die Lösung nicht für Produktionsumgebungen, die auch nur ein moderates Volumen an Echtzeit-API-Verarbeitung erfordern. Keine der getesteten SaaS-Lösungen kann als echtzeitfähig eingestuft werden.
Der GigaOm-Bericht bestätigt sowohl unsere bisherigen Benchmarks als auch die Rückmeldungen unserer Kunden. NGINX Plus ist das schnellste API-Gateway auf dem Markt und die einzige API-Lösung, die bei allen Perzentilen eine Latenz von weniger als 30 ms aufrechterhalten kann. In Kombination mit NGINX Controller erhalten Sie zudem Zugriff auf eine einzigartig konzipierte API-Management-Lösung, bei der sich die API-Management-Steuerungsebene (NGINX Controller) dank sorgfältiger Entkopplung in keiner Weise auf die Leistung der Datenebene des API-Gateways (NGINX Plus) auswirkt.
Sie können die Leistung Ihrer eigenen APIs mit unserem Latenzmesswerkzeug rtapi testen. Probieren Sie es aus und kontaktieren Sie uns, um zu besprechen, wie wir Ihnen helfen können, Ihre APIs echtzeitfähig zu machen.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.