Die als Twelve-Factor-App bekannten Richtlinien wurden erstmals vor mehr als zehn Jahren veröffentlicht. Seitdem haben sich nahezu alle darin vorgeschriebenen Praktiken zum De-facto-Standard für die Entwicklung und Bereitstellung von Webanwendungen entwickelt. Auch wenn sie trotz der Veränderungen bei der Organisation und Bereitstellung von Anwendungen weiterhin anwendbar sind, ist in einigen Fällen eine differenziertere Betrachtung erforderlich, um zu verstehen, wie sich diese Praktiken auf Microservices-Muster für die Entwicklung und Bereitstellung von Anwendungen übertragen lassen.
Dieser Blogbeitrag befasst sich mit Faktor 3, „Konfiguration in der Umgebung speichern“. Dieser besagt:
- Konfiguration umfasst alles, was sich zwischen Bereitstellungsumgebungen unterscheidet (die in der Zwölf-Faktoren-App als „Deployments“ bezeichnet werden).
- Die Konfiguration muss strikt vom Code der App getrennt sein – wie könnte sie sonst je nach Deployment variieren?
- Konfigurationsdaten werden in Umgebungsvariablen gespeichert.
Beim Umstieg auf Microservices können Sie diese Richtlinien weiterhin befolgen, allerdings lassen sie sich nicht immer eins zu eins im Sinne einer wörtlichen Auslegung der Zwölf-Faktoren-App umsetzen. Einige Richtlinien, etwa die Bereitstellung von Konfigurationsdaten als Umgebungsvariablen, lassen sich problemlos übertragen. Andere gängige Microservices-Praktiken wahren zwar die Grundprinzipien der Zwölf-Faktoren-App, sind jedoch eher als deren Erweiterungen zu verstehen. In diesem Beitrag betrachten wir drei zentrale Konzepte des Konfigurationsmanagements für Microservices aus der Perspektive von Faktor 3:
- Ihre Dienstkonfiguration klar definieren
- Wie die Konfiguration für einen Dienst bereitgestellt wird
- Einen Dienst als Konfiguration verfügbar machen
Wichtige Begriffe und Konzepte rund um Microservices
Bevor wir uns mit der Anpassung von Faktor 3 an Microservices befassen, ist es hilfreich, einige wichtige Begriffe und Konzepte zu verstehen.
- Monolithische Anwendungsarchitektur – Ein traditionelles Architekturmodell, das Anwendungsfunktionen in Komponentenmodule unterteilt, jedoch alle Module in einer einzigen Codebasis zusammenfasst.
- Microservices-App-Architektur – Ein Architekturmodell, bei dem eine große, komplexe App aus mehreren kleinen Komponenten aufgebaut wird, die jeweils klar abgegrenzte Aufgaben übernehmen (z. B. Authentifizierung, Benachrichtigungen oder Zahlungsabwicklung). „Microservice“ ist auch die Bezeichnung für diese kleinen Komponenten selbst. In der Praxis können manche „Microservices“ tatsächlich recht groß sein.
- Dienst – Ein allgemeiner Begriff für eine einzelne Anwendung oder einen Microservice in einem System.
- System – Im Kontext dieses Blogs bezeichnet dies die Gesamtheit aller Microservices und der unterstützenden Infrastruktur, die zusammen den vollständigen Funktionsumfang bereitstellen, den die Organisation anbietet.
- Artefakt – Ein Objekt, das von einer Test- und Build-Pipeline erstellt wird. Es kann verschiedene Formen annehmen, beispielsweise ein Docker-Image, das den Code einer Anwendung enthält.
- Bereitstellung – Eine laufende „Instanz“ eines Artefakts, die in einer Umgebung wie Staging, Integration oder Produktion ausgeführt wird.
Microservices versus Monolithen
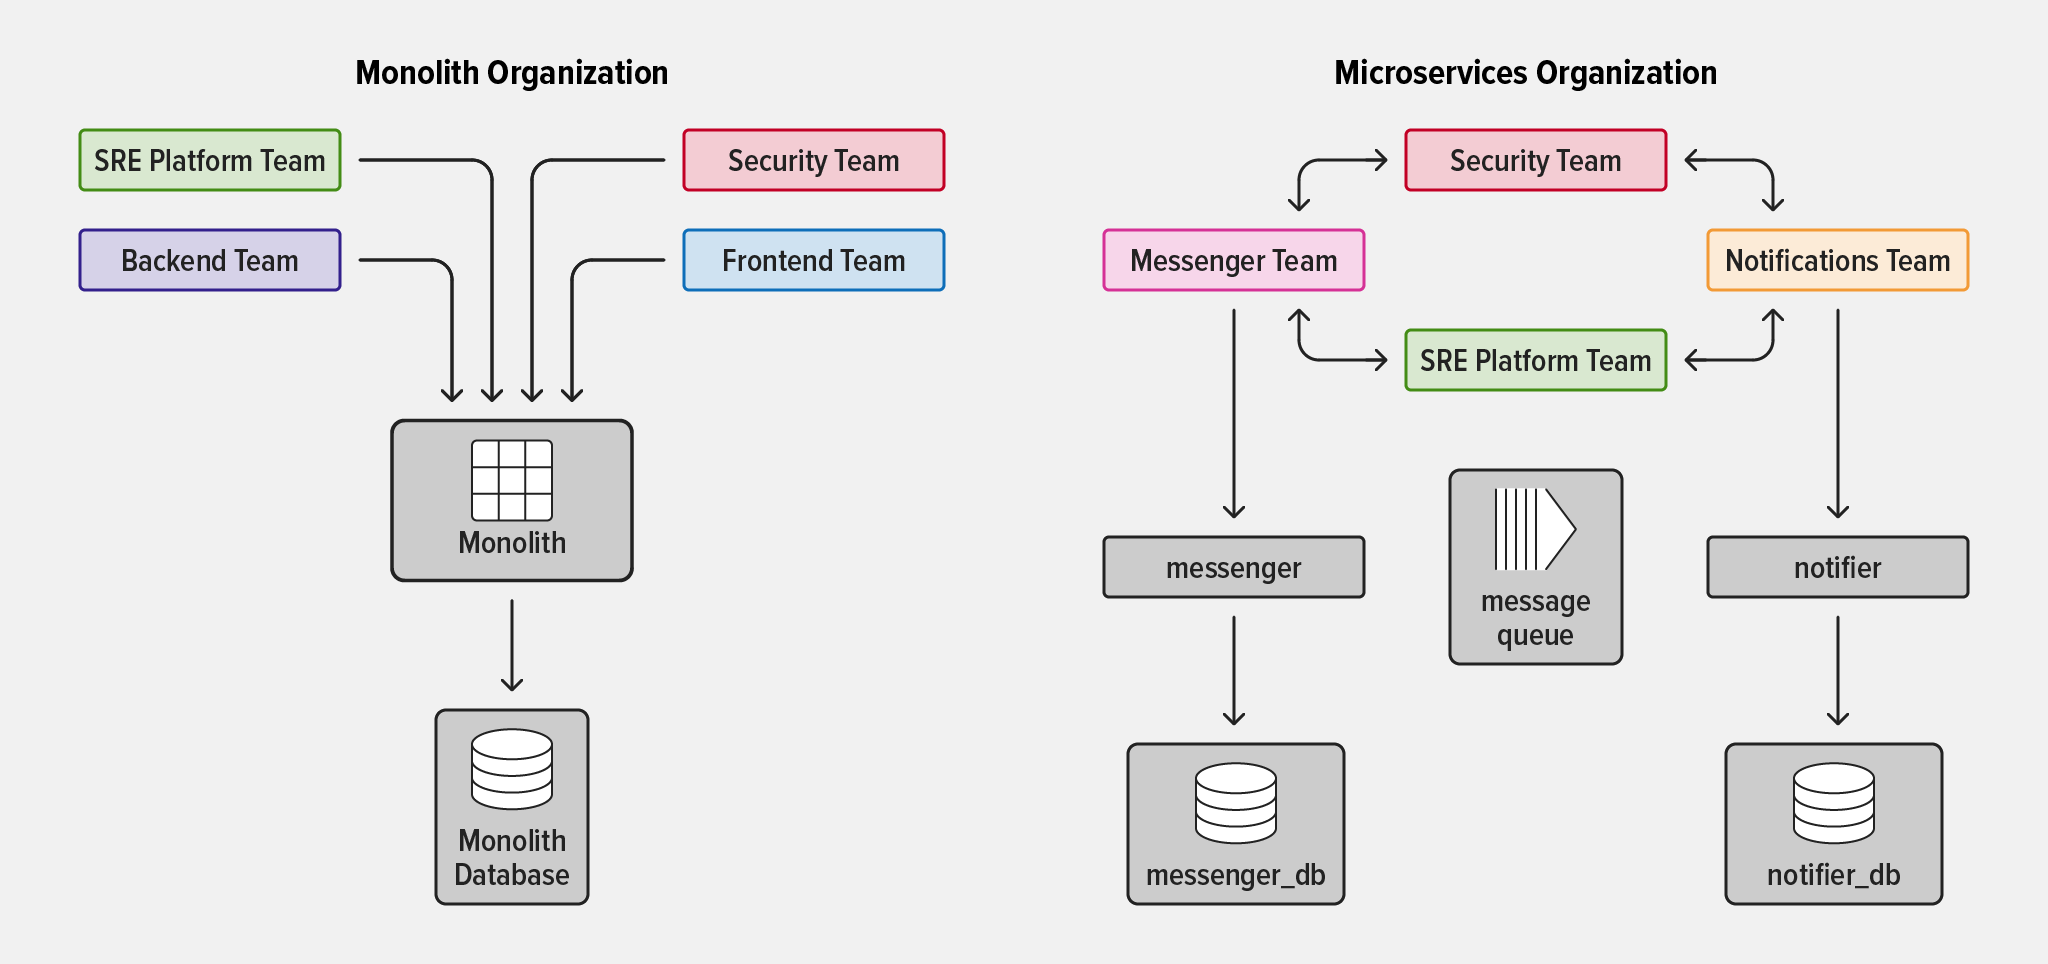
Bei einer monolithischen Anwendung arbeiten alle Teams im Unternehmen an derselben Anwendung und der zugehörigen Infrastruktur. Obwohl monolithische Anwendungen auf dem Papier im Allgemeinen einfacher erscheinen als Microservices, gibt es mehrere häufige Gründe, warum sich Unternehmen für den Umstieg auf Microservices entscheiden:
- Teamautonomie – In einem Monolithen kann es schwierig sein, die Zuständigkeit für Funktionen und Subsysteme festzulegen. Wenn Organisationen wachsen und sich weiterentwickeln, wird die Verantwortung für die Anwendungsfunktionen häufig auf immer mehr Teams verteilt. Dadurch entstehen Abhängigkeiten zwischen den Teams, da das Team, das für eine bestimmte Funktion zuständig ist, nicht für alle damit verbundenen Subsysteme im Monolithen verantwortlich ist.
- Verringerung des „Auswirkungsradius“ – Wenn eine große Anwendung als eine einzige Einheit entwickelt und bereitgestellt wird, kann ein Fehler in einem Subsystem die Funktionalität der gesamten Anwendung beeinträchtigen.
- Funktionalität unabhängig skalieren – Selbst wenn nur ein einziges Modul einer monolithischen Anwendung stark ausgelastet ist, muss das Unternehmen viele Instanzen der gesamten Anwendung bereitstellen, um einen Systemausfall oder Leistungseinbußen zu vermeiden.
Natürlich bringen Microservices auch ihre eigenen Herausforderungen mit sich – darunter eine höhere Komplexität, eine geringere Beobachtbarkeit und die Notwendigkeit neuer Sicherheitsmodelle –, doch viele Unternehmen, insbesondere große oder schnell wachsende, sind der Ansicht, dass sich diese Herausforderungen lohnen, um ihren Teams mehr Autonomie und Flexibilität bei der Schaffung zuverlässiger, stabiler Grundlagen für die Erlebnisse zu geben, die sie ihren Kunden bieten.
Erforderliche Änderungen für Microservices-Architekturen
Wenn Sie eine monolithische Anwendung in Microservices umstrukturieren, müssen Ihre Services:
- Konfigurationsänderungen auf vorhersehbare Weise übernehmen
- Sich dem übergeordneten System auf vorhersehbare Weise bekannt machen
- Gut dokumentiert sein
Bei einer monolithischen Anwendung sind kleinere Unstimmigkeiten in den Prozessen und die Abhängigkeit von gemeinsamen Annahmen nicht kritisch. Bei einer Vielzahl separater Microservices können diese Unstimmigkeiten und Annahmen jedoch erhebliche Probleme und Chaos verursachen. Viele der Änderungen, die beim Einsatz von Microservices erforderlich sind, sind technisch notwendig. Überraschend viele betreffen jedoch die interne Arbeitsweise von Teams und ihre Zusammenarbeit mit anderen Teams.
Zu den wichtigsten organisatorischen Veränderungen bei einer Microservices-Architektur gehören:
- Anstatt gemeinsam an derselben Codebasis zu arbeiten, agieren die Teams völlig unabhängig voneinander, wobei jedes Team die alleinige Verantwortung für einen oder mehrere Services trägt. Bei der gängigsten Umsetzung von Microservices werden die Teams zudem „funktionsübergreifend“ organisiert. Das bedeutet, dass ihre Mitglieder über alle erforderlichen Kompetenzen verfügen, um die Ziele des Teams mit möglichst wenigen Abhängigkeiten von anderen Teams zu erreichen.
- Plattformteams (die für den Gesamtzustand des Systems verantwortlich sind) müssen nun mehrere Dienste koordinieren, die von verschiedenen Teams betreut werden, anstatt sich mit einer einzigen Anwendung zu befassen.
- Tooling-Teams müssen weiterhin in der Lage sein, den verschiedenen für die Services verantwortlichen Teams Werkzeuge und Orientierungshilfen bereitzustellen, damit diese ihre Ziele schnell erreichen können und das System gleichzeitig stabil bleibt.
Ihre Servicekonfiguration klar definieren
Ein Bereich der Microservices-Architektur, in dem wir Faktor 3 erweitern müssen, betrifft die Notwendigkeit, bestimmte wesentliche Informationen über einen Service – einschließlich seiner Konfiguration – klar zu definieren und möglichst wenig gemeinsamen Kontext mit anderen Services vorauszusetzen. Faktor 3 geht darauf nicht direkt ein, doch dies ist besonders wichtig, wenn eine große Anzahl separater Microservices zur Funktionalität einer Anwendung beiträgt.
Als Serviceverantwortlicher in einer Microservices-Architektur ist Ihr Team für Services zuständig, die im Gesamtsystem bestimmte Aufgaben erfüllen. Andere Teams, deren Services mit Ihren interagieren, benötigen Zugriff auf das Repository Ihres Service, um Code und Dokumentation zu lesen und Beiträge beizusteuern.
Darüber hinaus gehört es leider zur Realität in der Softwareentwicklung, dass sich die Zusammensetzung von Teams häufig ändert – nicht nur, weil Entwickler in das Unternehmen eintreten oder es verlassen, sondern auch aufgrund interner Umstrukturierungen. Zudem wird die Verantwortung für einen bestimmten Service häufig von einem Team auf ein anderes übertragen.
Angesichts dieser Gegebenheiten müssen Ihre Codebasis und Dokumentation äußerst klar und konsistent sein. Dies erreichen Sie durch:
- Den Zweck jeder Konfigurationsoption klar definieren
- Das erwartete Format des Konfigurationswerts klar definieren
- Klar definieren, in welcher Form die Anwendung die Bereitstellung von Konfigurationswerten erwartet
- Diese Informationen in einer begrenzten Anzahl von Dateien erfassen
Viele Anwendungsframeworks bieten eine Möglichkeit, die erforderliche Konfiguration zu definieren. Beispielsweise verwendet das NPM-Paket convict für Node.js-Anwendungen ein vollständiges Konfigurationsschema, das in einer einzigen Datei gespeichert ist. Es dient als zentrale Referenz für die gesamte Konfiguration, die eine Node.js-Anwendung zur Ausführung benötigt.
Ein robustes und leicht auffindbares Schema ermöglicht es sowohl Mitgliedern Ihres Teams als auch anderen, sicher mit Ihrem Dienst zu interagieren.
Wie Konfiguration für einen Dienst bereitgestellt wird
Nachdem Sie klar definiert haben, welche Konfigurationswerte Ihre Anwendung benötigt, müssen Sie auch die wichtige Unterscheidung zwischen den beiden primären Quellen berücksichtigen, aus denen eine bereitgestellte Microservices-Anwendung ihre Konfiguration bezieht:
- Bereitstellungsskripte, die Konfigurationseinstellungen explizit definieren und zusammen mit dem Quellcode der Anwendung bereitgestellt werden
- Externe Quellen, die zum Zeitpunkt der Bereitstellung abgefragt werden
Deployment-Skripte sind ein gängiges Muster zur Codeorganisation in Microservices-Architekturen. Da sie erst nach der ursprünglichen Veröffentlichung der Twelve-Factor-App aufgekommen sind, stellen sie zwangsläufig eine Erweiterung dieses Konzepts dar.
Muster: Bereitstellungs- und Infrastrukturkonfiguration direkt bei der Anwendung
In den letzten Jahren hat es sich eingebürgert, einen Ordner namens „infrastructure“ (oder eine Variante dieses Namens) im selben Repository wie den Anwendungscode zu führen. Er enthält in der Regel:
- Infrastructure as Code (Terraform ist ein gängiges Beispiel), die die Infrastruktur beschreibt, von der der Dienst abhängt, beispielsweise eine Datenbank
- Konfiguration für Ihr Container-Orchestrierungssystem, z. B. Helm-Charts und Kubernetes-Manifeste
- Alle weiteren Dateien, die mit der Bereitstellung der Anwendung zusammenhängen
Auf den ersten Blick mag dies wie ein Verstoß gegen die Vorgabe von Faktor 3 erscheinen, dass die Konfiguration strikt vom Code getrennt sein muss.
Tatsächlich bedeutet die Platzierung des Infrastrukturordners direkt neben Ihrer Anwendung, dass die Regel eingehalten wird und zugleich wertvolle Prozessverbesserungen ermöglicht werden, die für Teams in Microservices-Umgebungen von entscheidender Bedeutung sind.
Zu den Vorteilen dieses Musters gehören:
- Das Team, das für den Service verantwortlich ist, ist auch für dessen Bereitstellung sowie für die Bereitstellung der servicespezifischen Infrastruktur (z. B. Datenbanken) verantwortlich.
- Das verantwortliche Team kann sicherstellen, dass Änderungen an all diesen Elementen den eigenen Entwicklungsprozess durchlaufen (Code-Review, CI).
- Das Team kann die Bereitstellung seines Dienstes und der unterstützenden Infrastruktur problemlos ändern, ohne darauf angewiesen zu sein, dass externe Teams die erforderlichen Arbeiten übernehmen.
Beachten Sie, dass die Vorteile dieses Musters die Autonomie der einzelnen Teams stärken und zugleich sicherstellen, dass der Bereitstellungs- und Konfigurationsprozess mit zusätzlicher Sorgfalt durchgeführt wird.
Welche Art von Konfiguration gehört wohin?
In der Praxis verwenden Sie die in Ihrem Infrastrukturordner gespeicherten Bereitstellungsskripte, um sowohl die explizit in den Skripten selbst definierte Konfiguration als auch das Abrufen von Konfigurationen aus externen Quellen zum Zeitpunkt der Bereitstellung zu verwalten. Dazu lassen Sie das Bereitstellungsskript für einen Dienst:
- Bestimmte Konfigurationswerte direkt definieren
- Definieren Sie, wo der Prozess, der das Bereitstellungsskript ausführt, in externen Quellen nach den gewünschten Konfigurationswerten suchen kann
Konfigurationswerte, die für eine bestimmte Bereitstellung Ihres Dienstes gelten und vollständig unter der Kontrolle Ihres Teams stehen, können direkt in den Dateien im Infrastrukturordner angegeben werden. Ein Beispiel wäre etwa eine Begrenzung der maximalen Laufzeit einer von der App initiierten Datenbankabfrage. Dieser Wert kann geändert werden, indem die Bereitstellungsdatei angepasst und die Anwendung erneut bereitgestellt wird.
Ein Vorteil dieses Ansatzes besteht darin, dass Änderungen an einer solchen Konfiguration zwangsläufig eine Codeüberprüfung und automatisierte Tests durchlaufen. Dadurch sinkt die Wahrscheinlichkeit, dass ein falsch konfigurierter Wert einen Ausfall verursacht. Änderungen an Werten, die eine Codeüberprüfung durchlaufen, sowie die Werte von Konfigurationsschlüsseln zu einem beliebigen Zeitpunkt lassen sich im Verlauf Ihres Versionsverwaltungssystems nachvollziehen.
Werte, die für die Ausführung der Anwendung erforderlich sind, aber nicht unter der Kontrolle Ihres Teams stehen, müssen von der Umgebung bereitgestellt werden, in der die Anwendung bereitgestellt wird. Ein Beispiel hierfür sind der Hostname und der Port, über die der Dienst eine Verbindung zu einem anderen Microservice herstellt, von dem er abhängig ist.
Da dieser Dienst nicht Ihrem Team gehört, können Sie keine Annahmen über Werte wie die Portnummer treffen. Solche Werte können sich jederzeit ändern und müssen bei einer Änderung in einem zentralen Konfigurationsspeicher hinterlegt werden – unabhängig davon, ob die Änderung manuell oder durch einen automatisierten Prozess erfolgt. Anwendungen, die von diesen Werten abhängig sind, können sie anschließend abfragen.
Diese Richtlinien lassen sich in zwei Best Practices für die Konfiguration von Microservices zusammenfassen.
Ein No-Go bei der Microservices-Konfiguration: Verlassen Sie sich nicht auf fest codierte oder gemeinsam vereinbarte Werte
Es mag am einfachsten erscheinen, bestimmte Werte in Ihren Bereitstellungsskripten fest zu codieren, beispielsweise den Standort eines Dienstes, mit dem Ihr Dienst interagiert. In der Praxis ist die feste Codierung dieser Art von Konfiguration jedoch riskant, insbesondere in modernen Umgebungen, in denen sich die Standorte von Diensten häufig ändern. Besonders riskant ist dies, wenn der zweite Dienst nicht von Ihnen verwaltet wird.
Sie könnten meinen, dass Sie sich auf Ihre eigene Sorgfalt verlassen können, um den Standort eines Dienstes in Ihren Skripten aktuell zu halten – oder, schlimmer noch, darauf, dass das zuständige Team Sie über Änderungen des Standorts informiert. In stressigen Zeiten lässt die Sorgfalt jedoch häufig nach, und wenn Sie sich auf menschliche Gewissenhaftigkeit verlassen, riskieren Sie, dass Ihr System ohne Vorwarnung ausfällt.
Empfehlung für die Microservices-Konfiguration: Lassen Sie den Dienst fragen: „Wo ist meine Datenbank?“
Unabhängig davon, ob Standortinformationen fest codiert sind oder nicht, darf Ihre Anwendung nicht davon abhängig sein, dass sich kritische Infrastruktur an einem bestimmten Standort befindet. Stattdessen muss ein neu bereitgestellter Service eine zentrale Quelle innerhalb des Systems beispielsweise fragen: „Wo befindet sich meine Datenbank?“, und eine präzise Auskunft über den aktuellen Standort dieser externen Ressource erhalten. Wenn sich jeder Service bei seiner Bereitstellung selbst im System registriert, vereinfacht dies die Abläufe erheblich.
Einen Dienst als Konfiguration verfügbar machen
So wie das System Antworten auf die Fragen „Wo befindet sich meine Datenbank?“ und „Wo befindet sich der ‚Dienst X‘, von dem ich abhängig bin?“ liefern muss, muss ein Dienst dem System so zur Verfügung gestellt werden, dass andere Dienste ihn leicht finden und mit ihm kommunizieren können, ohne etwas darüber wissen zu müssen, wie er bereitgestellt wird.
Eine zentrale Konfigurationspraxis in Microservices-Architekturen ist die Serviceerkennung: Dabei werden Informationen zu neuen Services registriert und dynamisch aktualisiert, wenn andere Services darauf zugreifen. Nachdem wir erläutert haben, warum die Serviceerkennung für Microservices notwendig ist, sehen wir uns anhand eines Beispiels an, wie sie sich mit NGINX Open Source und Consul umsetzen lässt.
Es ist gängige Praxis, mehrere Instanzen (Deployments) eines Dienstes gleichzeitig auszuführen. Dadurch lässt sich nicht nur zusätzlicher Datenverkehr bewältigen, sondern ein Dienst kann durch das Starten eines neuen Deployments auch ohne Ausfallzeit aktualisiert werden. Tools wie NGINX fungieren als Reverse-Proxy und Load Balancer, verarbeiten eingehenden Datenverkehr und leiten ihn an die am besten geeignete Instanz weiter. Dieses Muster ist vorteilhaft, da Dienste, die von Ihrem Dienst abhängig sind, Anfragen ausschließlich an NGINX senden und nichts über Ihre Deployments wissen müssen.
Nehmen wir als Beispiel an, Sie haben eine einzelne Instanz eines Dienstes namens messenger, die hinter NGINX ausgeführt wird, das als Reverse-Proxy fungiert.
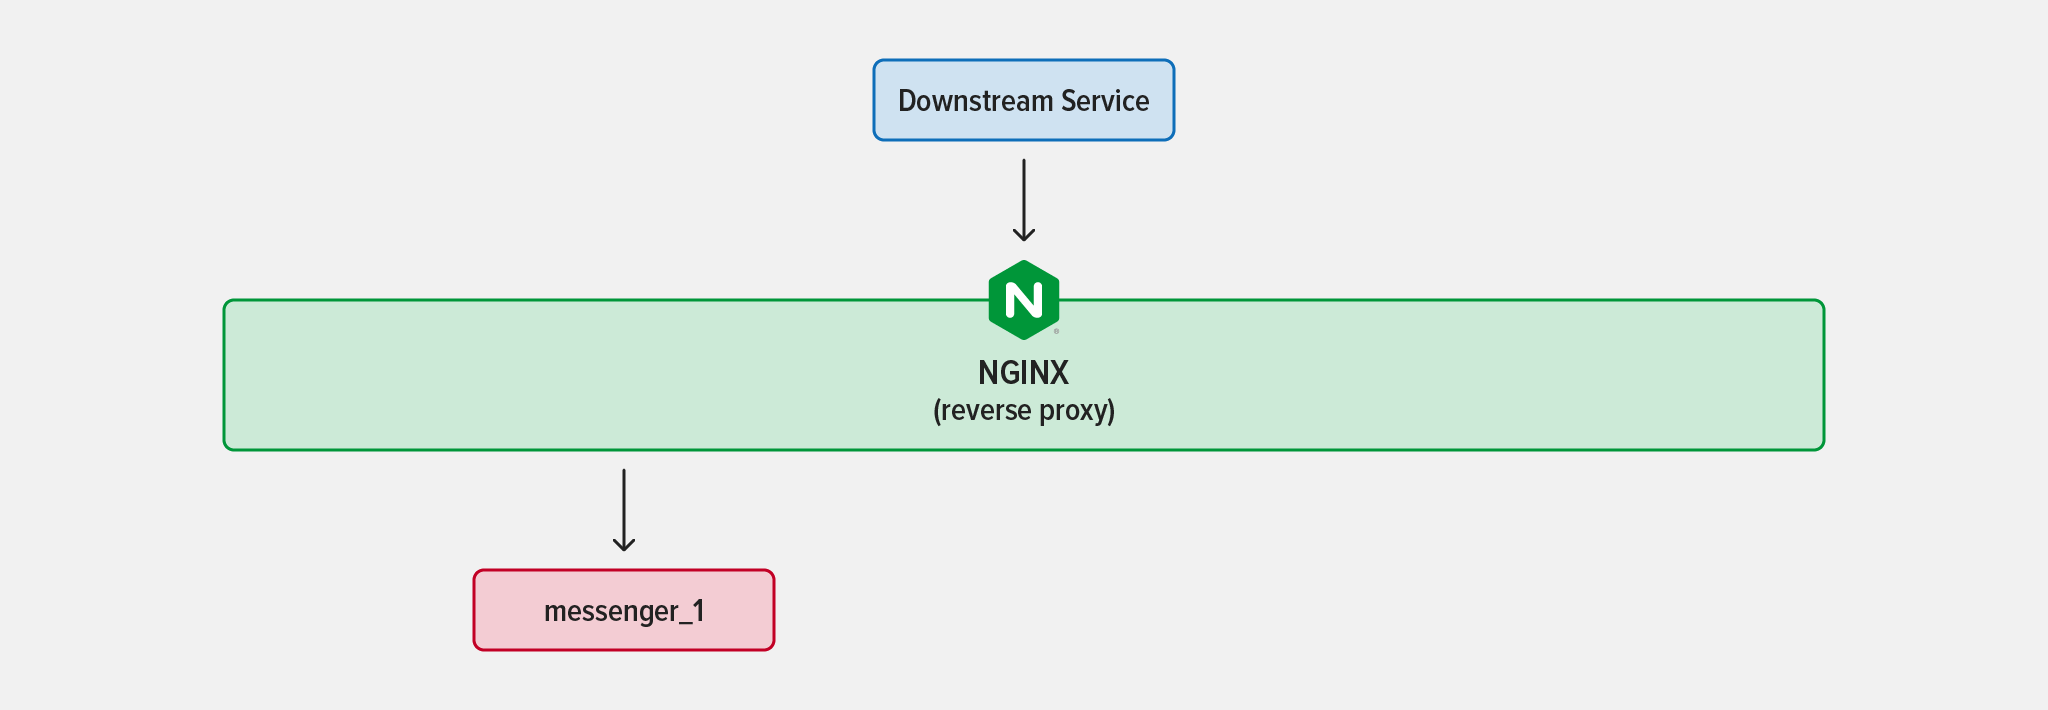
Was aber, wenn Ihre App immer beliebter wird? Das sind zwar gute Nachrichten, doch dann stellen Sie fest, dass die messenger-Instanz aufgrund des gestiegenen Datenverkehrs viel CPU-Leistung beansprucht und länger für die Verarbeitung von Anfragen benötigt, während die Datenbank offenbar problemlos zurechtkommt. Dies deutet darauf hin, dass Sie das Problem möglicherweise lösen können, indem Sie eine weitere Instanz des messenger-Dienstes bereitstellen.
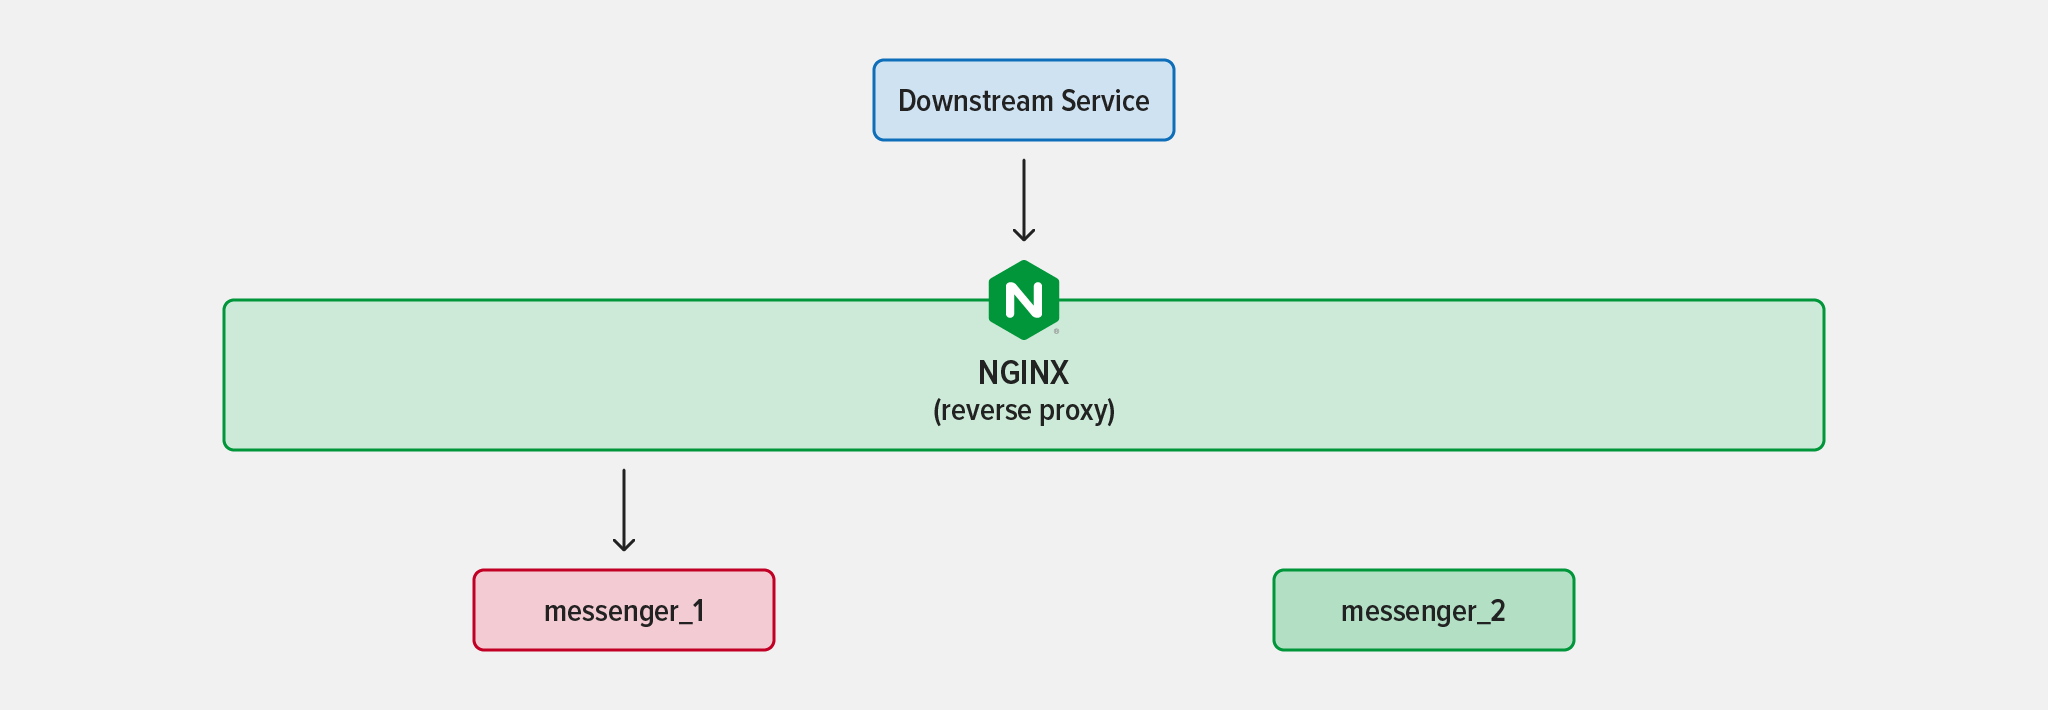
Wenn Sie die zweite Instanz des messenger-Dienstes bereitstellen, woher weiß NGINX, dass sie aktiv ist, und beginnt, Datenverkehr an sie weiterzuleiten? Neue Instanzen manuell zu Ihrer NGINX-Konfiguration hinzuzufügen, ist eine Möglichkeit, wird jedoch schnell unübersichtlich, wenn immer mehr Dienste hoch- und herunterskaliert werden.
Eine gängige Lösung besteht darin, die Dienste in einem System mithilfe einer hochverfügbaren Dienstregistrierung wie Consul zu erfassen. Neue Dienstinstanzen registrieren sich bei der Bereitstellung bei Consul. Consul überwacht den Status der Instanzen, indem es regelmäßig Integritätsprüfungen durchführt. Wenn eine Instanz diese Prüfungen nicht besteht, wird sie aus der Liste der verfügbaren Dienste entfernt.
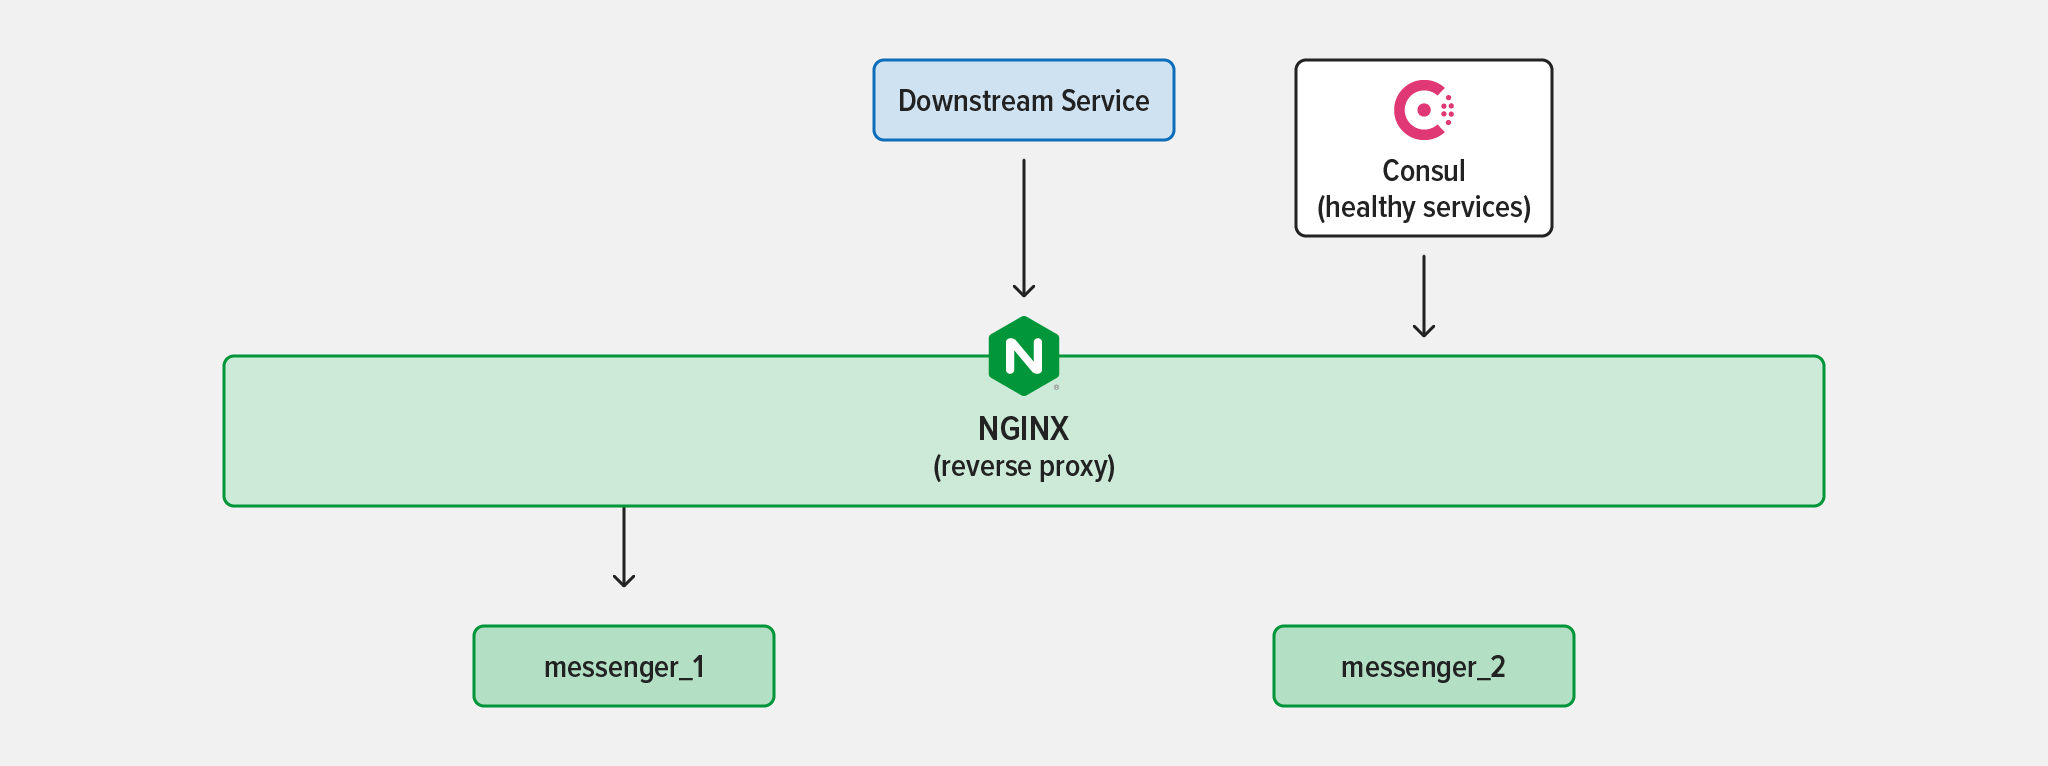
NGINX kann eine Registry wie Consul auf verschiedene Arten abfragen und sein Routing entsprechend anpassen. Zur Erinnerung: Wenn NGINX als Reverse-Proxy oder Load-Balancer fungiert, leitet es den Datenverkehr an „Upstream“-Server weiter. Betrachten Sie diese einfache Konfiguration:
# Define an upstream group called "messenger_service"
upstream messenger_service {
    server 172.18.0.7:4000;
    server 172.18.0.8:4000;
}

server {
    listen 80;

    location /api {
        # Proxy HTTP traffic with paths starting with '/api' to the
        # 'upstream' block above. The default load-balancing algorithm,
        # Round-Robin, alternates requests between the two servers
        # in the block.
        proxy_pass http://messenger_service;
        proxy_set_header X-Forwarded-For $remote_addr;
    }
}
Standardmäßig muss NGINX die genaue IP-Adresse und den Port jeder messenger-Instanz kennen, um den Datenverkehr an sie weiterzuleiten. In diesem Fall ist das bei 172.18.0.7 und 172.18.0.8 jeweils Port 4000.
Hier kommen Consul und Consul Template ins Spiel. Consul Template wird im selben Container wie NGINX ausgeführt und kommuniziert mit dem Consul-Client, der das Dienstverzeichnis verwaltet.
Wenn sich die Informationen in der Registry ändern, generiert Consul Template eine neue Version der NGINX-Konfigurationsdatei mit den korrekten IP-Adressen und Ports, schreibt sie in das NGINX-Konfigurationsverzeichnis und weist NGINX an, seine Konfiguration neu zu laden. Wenn NGINX seine Konfiguration neu lädt, kommt es zu keiner Ausfallzeit, und die neue Instanz empfängt Datenverkehr, sobald das Neuladen abgeschlossen ist.
Mit einem Reverse-Proxy wie NGINX gibt es in einer solchen Situation einen zentralen Zugriffspunkt, der im System als Anlaufstelle für andere Dienste registriert wird. Ihr Team kann einzelne Dienstinstanzen flexibel verwalten, ohne befürchten zu müssen, dass andere Dienste den Zugriff auf den Dienst als Ganzes verlieren.
Sammeln Sie praktische Erfahrungen mit NGINX und Microservices March
Microservices erhöhen zugegebenermaßen die Komplexität – sowohl in technischer Hinsicht für Ihre Services als auch in organisatorischer Hinsicht für die Zusammenarbeit mit anderen Teams. Um die Vorteile einer Microservices-Architektur nutzen zu können, ist es wichtig, die für Monolithen entwickelten Praktiken kritisch zu überprüfen und sicherzustellen, dass sie auch in einer völlig anderen Umgebung dieselben Vorteile bieten. In diesem Blogbeitrag haben wir untersucht, wie Faktor 3 der Zwölf-Faktoren-App auch im Microservices-Kontext einen Mehrwert bietet, seine konkrete Umsetzung jedoch durch kleine Anpassungen verbessert werden kann.
Wenn Sie mehr über die Anwendung der Zwölf-Faktoren-App auf Microservices-Architekturen erfahren möchten, sehen Sie sich Einheit 1 des Microservices March 2023 an (demnächst im Blog verfügbar). Kostenlos registrieren und Zugang zu einem Webinar zu diesem Thema sowie zu einem praxisorientierten Lab erhalten.

Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.