Wir haben bereits ausführlich darüber geschrieben, wie Sie mit NGINX Plus und NGINX Open Source die Last Ihrer Websites und Apps verteilen können, um optimale Verfügbarkeit und Zuverlässigkeit zu gewährleisten. Lastverteilung ist ein grundlegendes Werkzeug für die Steigerung der App-Performance, die Bereitstellung von Apps im großen Maßstab und die Bereitstellung von Containern und Microservices.
Wir haben bereits erläutert, wie Sie NGINX Plus im Rechenzentrum (gegebenenfalls zusammen mit älteren Application Delivery Controllern), in Containern und in Cloud-Umgebungen bereitstellen können, darunter Amazon Web Services (AWS), Google Cloud Platform und Microsoft Azure.
In diesem Beitrag konzentrieren wir uns auf die Lastverteilungstechniken (auch Lastverteilungsmethoden oder algorithmen genannt) in NGINX Plus und NGINX und geben einige Tipps zur Auswahl der richtigen Methode für unterschiedliche Anwendungsfälle. NGINX bietet vier Lastverteilungstechniken (Round Robin, Hash, IP Hash und Least Connections). NGINX Plus ergänzt diese um eine weitere (Least Time). Alle Methoden für HTTP-Datenverkehr sind mit Ausnahme von IP Hash auch für TCP verfügbar (und ab NGINX Plus Release 9 auch für UDP).
[Anmerkung der Redaktion – NGINX Plus R16 und NGINX Open Source 1.15.1 führten „Random with Two Choices“ als zusätzlichen Lastverteilungsalgorithmus ein. Weitere Informationen finden Sie im Beitrag NGINX und der Lastverteilungsalgorithmus „Power of Two Choices“ in unserem Blog.]
Überblick über die Lastverteilungstechniken
Wir gehen davon aus, dass Sie mit den Grundlagen der Konfiguration von Lastverteilung vertraut sind. Wenn Sie Ihr Wissen auffrischen möchten, können Sie sich diese Ressourcen ansehen:
- Die Artikel im NGINX Plus-Administratorhandbuch bieten einen umfassenden Überblick.
- Hochleistungs-Lastverteilung enthält Links zu ausführlichen Erläuterungen erweiterter Funktionen von NGINX Plus, mit denen sich die Effizienz eines Lastverteilungsverfahrens noch weiter steigern lässt.
- Lastverteilung mit NGINX und NGINX Plus, Teil 1 und Teil 2, ist eine Schritt-für-Schritt-Anleitung, die zeigt, wie sich ein einfacher Reverse-Proxy mithilfe der erweiterten Funktionen von NGINX Plus zu einer umfassenden Lösung für die Lastverteilung ausbauen lässt.
- Die Lösungsseite zum Thema Lastverteilung enthält Links zu weiteren Ressourcen, darunter E-Books, Webinare und Whitepapers.
Der Einfachheit halber konzentrieren wir uns auf das HTTP-Load-Balancing, das Sie im Kontext http konfigurieren. TCP-Load-Balancing wird hingegen im Kontext stream konfiguriert (ebenso wie UDP-Load-Balancing ab NGINX Plus Release 9). Obwohl die HTTP- und TCP/UDP-Load-Balancer denselben Funktionsumfang bieten, unterscheiden sich die verfügbaren Direktiven und Parameter aufgrund grundlegender Unterschiede zwischen den Protokollen etwas. Einzelheiten finden Sie in der Dokumentation zu den Upstream-Modulen für HTTP und TCP/UDP.
Sie aktivieren den Lastenausgleich mit zwei Konfigurationsblöcken, die wir hier in ihrer Grundform ohne optionale Parameter oder zusätzliche Funktionen zeigen:
- Der
server-Block definiert einen virtuellen Server, der auf Datenverkehr mit den von Ihnen festgelegten Merkmalen wartet und diesen an eine benannte Gruppe von Upstream-Servern weiterleitet. In unseren Beispielen wartet der virtuelle Server am Standardport (80) auf HTTP-Datenverkehr an www.example.com und leitet ihn an die Upstream-Servergruppe namens backend weiter. Dieser Block ist in allen unseren Beispielen gleich.
server {    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}- (NGINX Plus und NGINX können die Last auch auf FastCGI-, memcached-, SCGI- und uwsgi-Backend-Server verteilen. Ersetzen Sie
proxy_passdurch die entsprechende Direktive –fastcgi_pass,memcached_pass,scgi_passoderuwsgi_pass.) - Der
upstream-Block benennt eine Upstream-Gruppe und listet die zugehörigen Server auf, die durch Hostnamen, IP-Adressen oder UNIX-Domain-Socket-Pfade identifiziert werden. In unseren Beispielen umfasst die Upstream-Gruppe namens backend drei Server: web1, web2 und web3. Imupstream-Block legen Sie das Lastverteilungsverfahren fest, auf das wir in den folgenden Abschnitten näher eingehen. Als Beispiel sehen Sie hier den Block für das Standardverfahren Round Robin:
upstream backend {    server web1;
    server web2;
    server web3;
}
Round-Robin
Round Robin ist das standardmäßige Lastverteilungsverfahren für NGINX Plus und NGINX. Der Load Balancer durchläuft die Liste der Upstream-Server der Reihe nach und weist jedem Server abwechselnd die nächste Verbindungsanfrage zu.
Bei der folgenden Beispielkonfiguration der Upstream-Gruppe backend sendet der Load Balancer die ersten drei Verbindungsanfragen der Reihe nach an web1, web2 und web3, die vierte an web1, die fünfte an web2 und so weiter.
upstream backend {    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hash
Bei der Hash-Methode berechnet der Load Balancer für jede Anfrage einen Hash auf Grundlage der von Ihnen angegebenen Kombination aus Text und NGINX-Variablen und ordnet diesen einem der Server zu. Alle Anfragen mit diesem Hash werden an diesen Server gesendet. Damit stellt diese Methode eine einfache Form der Sitzungspersistenz her.
Im folgenden Beispiel verwendet die Direktive hash das Schema (http oder https) und den vollständigen URI der Anfrage als Grundlage für den Hash:
upstream backend {    hash $scheme$request_uri;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
IP-Hash
IP Hash (nur für HTTP verfügbar) ist eine vordefinierte Variante der Hash-Methode, bei der der Hash auf der IP-Adresse des Clients basiert. Sie wird mit der Direktive ip_hash festgelegt.
upstream backend {    ip_hash;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Wenn der Client eine IPv6-Adresse hat, wird der Hash auf Grundlage der gesamten Adresse berechnet. Bei einer IPv4-Adresse werden dagegen nur die ersten drei Oktette der Adresse verwendet. Dies dient der Optimierung für Clients von Internetanbietern, denen IP-Adressen dynamisch aus einem /24-Subnetz zugewiesen werden. Bei einem Neustart oder einer erneuten Verbindung erhält der Client häufig eine andere Adresse innerhalb desselben /24-Netzbereichs. Da die Verbindung jedoch weiterhin vom selben Client stammt, gibt es keinen Grund, die Zuordnung zum Server zu ändern.
Wenn jedoch der Großteil des Datenverkehrs zu Ihrer Website von Clients im selben /24-Netzwerk stammt, ist IP Hash nicht sinnvoll, da dabei alle Clients demselben Server zugeordnet werden. Verwenden Sie in diesem Fall (oder wenn Sie aus einem anderen Grund alle vier Oktette für die Hash-Berechnung verwenden möchten) stattdessen die Hash-Methode mit der Variablen $remote_addr.
hash $remote_addr;Wenigste Verbindungen
Bei der Least-Connections-Methode vergleicht der Load Balancer die aktuelle Anzahl seiner aktiven Verbindungen zu den einzelnen Servern und leitet die Anfrage an den Server mit den wenigsten Verbindungen weiter. Sie konfigurieren diese Methode mit der Direktive least_conn.
upstream backend {
    least_conn;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Geringste Zeit
Bei der Least-Time-Methode (nur in NGINX Plus verfügbar) verknüpft der Load Balancer für jeden Server zwei Kennzahlen mathematisch miteinander – die aktuelle Anzahl aktiver Verbindungen und die gewichtete durchschnittliche Antwortzeit für vergangene Anfragen – und leitet die Anfrage an den Server mit dem niedrigsten Wert weiter.
Mit der Wahl des Parameters für die Direktive least_time legen Sie fest, welche der beiden Antwortzeiten erfasst wird: entweder die Zeit bis zum Empfang des Antwort-Headers (header) oder die Zeit bis zum Empfang der vollständigen Antwort (last_byte).
upstream backend {    least_time (header | last_byte);

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hinweise:
- Beim TCP- und UDP-Lastenausgleich (im Kontext
stream) können Sie mit diesen Parametern der Direktiveleast_timezwischen drei Arten der Antwortzeit wählen:connect– Zeit zum Herstellen einer Verbindung zum Upstream-Serverfirst_byte– Zeit bis zum Empfang des ersten Bytes der Antwortdatenlast_byte– Zeit bis zum Empfang des letzten Bytes der Antwortdaten
- Fügen Sie in NGINX Plus R12 und höher sowohl für HTTP- als auch für TCP/UDP-Datenverkehr den Parameter
inflighthinzu, um noch nicht abgeschlossene Verbindungen in jede Metrik einzubeziehen; in früheren Versionen werden solche Verbindungen standardmäßig berücksichtigt.
Auswahl eines Load-Balancing-Verfahrens
Doch woher wissen Sie, welche Technik zur Lastverteilung für Ihre Website oder App am besten geeignet ist?
Die Datenverkehrsmuster unterscheiden sich von Website zu Website – und sogar innerhalb einer einzelnen Website je nach Tageszeit – so stark, dass es nicht sinnvoll ist, die Wahl der Load-Balancing-Technik von einem einzigen Merkmal abhängig zu machen (etwa stoßartiger oder gleichmäßiger Datenverkehr, kurzlebige oder langlebige Verbindungen usw.). Dennoch betrachten wir die Vor- und Nachteile der einzelnen Methoden, um Ihnen zu helfen, die Auswahl der infrage kommenden Optionen einzugrenzen.
Tests zum Vergleich der Methoden durchführen
Unabhängig davon, welche Lastausgleichsmethoden Sie in Betracht ziehen, empfehlen wir Ihnen, diese zu testen, um herauszufinden, welche für Ihren Datenverkehr am besten geeignet ist. „Am besten“ bedeutet in der Regel, dass Antworten möglichst schnell an die Clients übermittelt werden. Für Sie können jedoch andere Kriterien ausschlaggebend sein.
Application Performance Management-Tools sind für diese Art von Tests sehr nützlich – Sie können benutzerdefinierte Ansichten mit Diagrammen für jeden Server in der Upstream-Gruppe erstellen und die Server so in Echtzeit vergleichen, während sich die Werte im Verlauf des Tests ändern. Mehrere APM-Anbieter bieten spezielle Plug-ins für NGINX Plus und NGINX an, darunter AppDynamics, Datadog, Dynatrace und New Relic.
Am einfachsten sind Tests, wenn alle Server die gleiche Kapazität haben. Andernfalls müssen Sie die Servergewichtungen so festlegen, dass Rechner mit höherer Kapazität mehr Anfragen erhalten. Siehe dazu unten Gewichtungen für unterschiedliche Server festlegen.
Einige Kennzahlen, die Sie während der Tests überprüfen sollten, sind:
- CPU- und Arbeitsspeicherauslastung – Prüfen Sie sowohl bei der CPU als auch beim Arbeitsspeicher, wie viel Prozent der Gesamtkapazität genutzt werden. Wenn nicht alle Server gleichmäßig ausgelastet sind, wird der Datenverkehr nicht effizient verteilt.
- Serverantwortzeit – Wenn die Antwortzeit bei einigen Servern durchgehend höher ist als bei anderen, werden „aufwendigere“ Anfragen (die mehr Rechenleistung oder Aufrufe einer Datenbank oder anderer Dienste erfordern) ungleichmäßig auf diese Server verteilt. Versuchen Sie, die Gewichtungen anzupassen, denn das Ungleichgewicht könnte auf falsche Gewichtungen statt auf ein Problem mit dem Lastverteilungsverfahren zurückzuführen sein.
- Gesamtzeit bis zur Antwort an den Client – Auch hier deuten konstant höhere Zeiten bei einigen Servern darauf hin, dass sie einen unverhältnismäßig hohen Anteil zeitaufwendiger Anfragen erhalten. Versuchen Sie auch in diesem Fall, die Gewichtungen anzupassen, um zu sehen, ob sich das Problem dadurch beheben lässt.
- Fehler und fehlgeschlagene Anfragen – Sie müssen sicherstellen, dass die Anzahl fehlgeschlagener Anfragen und anderer Fehler während der Tests nicht höher ist als für Ihre Website üblich. Andernfalls stützen Sie Ihre Entscheidung auf Fehlerzustände statt auf realistischen Datenverkehr. Bei manchen Fehlern kann der Server seine Antwort schneller senden als bei einer erfolgreichen Anfrage. Beim HTTP-Statuscode
404(FileNotFound) beispielsweise gibt der Server den Fehler vermutlich deutlich schneller zurück, als er die eigentliche Datei ausliefern könnte, wenn sie vorhanden wäre. Bei den Lastverteilungsalgorithmen „Least Connections“ und „Least Time“ kann dies dazu führen, dass der Load Balancer einen Server bevorzugt, der tatsächlich nicht ordnungsgemäß funktioniert.
Vor- und Nachteile sowie Anwendungsfälle
Sehen wir uns nun die Vor- und Nachteile der einzelnen Lastverteilungsmethoden an und beschreiben einige Anwendungsfälle, für die sie sich besonders gut eignen. Wir besprechen sie in aufsteigender Reihenfolge ihrer Eignung für die meisten Anwendungsfälle. Eines vorweg: Wir halten Least Connections (und bei NGINX Plus auch Least Time) für die beste Wahl für das breiteste Spektrum an Anwendungsfällen.
Hash und IP-Hash
Die Lastverteilungsverfahren Hash und IP Hash stellen eine feste Zuordnung zwischen einem bestimmten Typ von Client-Anfragen (erfasst im Hashwert) und einem bestimmten Server her. Dieses Prinzip kennen Sie vielleicht als Sitzungspersistenz – alle Anfragen mit einem bestimmten Hashwert werden immer an denselben Server weitergeleitet.
Der größte Nachteil dieser Methoden besteht darin, dass sie nicht garantieren, Anfragen in gleicher Anzahl auf die Server zu verteilen, geschweige denn die Last gleichmäßig auszugleichen. Der Hashing-Algorithmus teilt die Menge aller möglichen Hashwerte gleichmäßig in „Buckets“ auf, einen für jeden Server in der Upstream-Gruppe. Es lässt sich jedoch nicht vorhersagen, ob die Hashwerte der tatsächlich eingehenden Anfragen gleichmäßig verteilt sein werden. Angenommen, zehn Clients greifen auf eine Website zu und der IP-Hash-Algorithmus ordnet zufällig die Hashwerte von sieben IP-Adressen dem Server web1 zu, einen dem Server web2 und zwei dem Server web3. Der Server web1 erhält dann mehr als doppelt so viele Anfragen wie alle anderen Server zusammen.
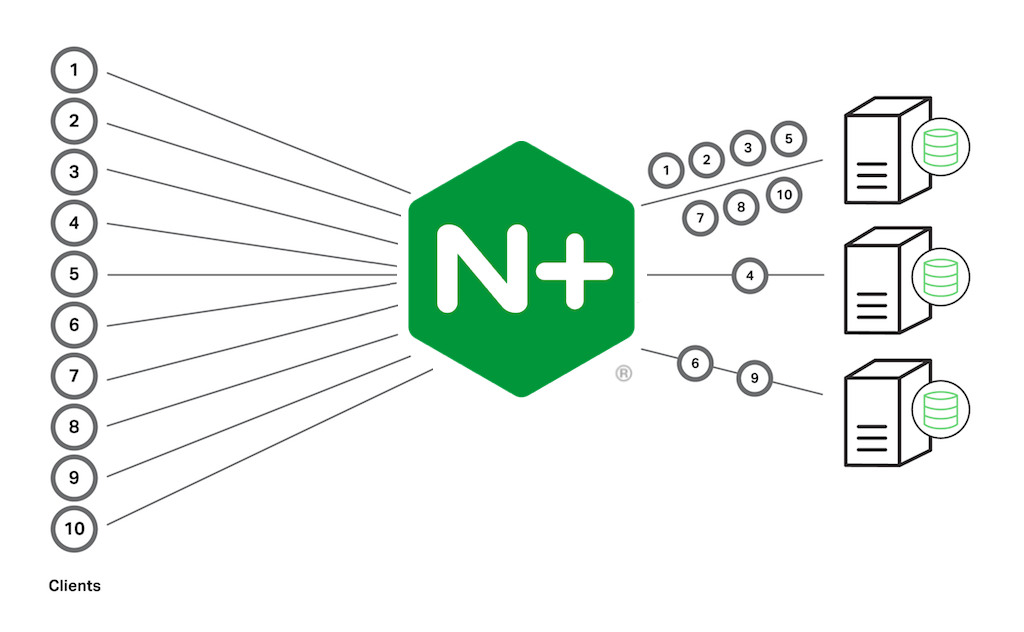
Daher ist der Einsatz von Hash oder IP Hash sinnvoll, wenn die Vorteile der Sitzungspersistenz die möglichen Nachteile einer ungleichmäßigen Lastverteilung überwiegen. Sie sind die einzige in NGINX verfügbare Form der Sitzungspersistenz. NGINX Plus bietet drei weitere Mechanismen für die Sitzungspersistenz, die ausgereifter sind und in Kombination mit einem tatsächlichen Lastausgleich funktionieren (sie werden mit der Direktive sticky konfiguriert). Doch auch bei NGINX Plus kann die Wahl auf Hash oder IP Hash fallen, da die drei Mechanismen in den folgenden Fällen nicht funktionieren:
- Der Browser oder die Client-App akzeptiert keine Cookies, und die Anwendung kann die Mechanismen zur Sitzungspersistenz nicht ohne Cookies nutzen. Verwenden Sie die IP Hash-Methode, um jeden Client (genauer gesagt seine IP-Adresse) einem bestimmten Server zuzuordnen.
- Sie möchten Anfragen für eine bestimmte URL jedes Mal an denselben Server senden, um das Caching auf dem Server selbst zu nutzen. Verwenden Sie die Hash-Methode mit der Variablen
$request_uri, um die Datei jedes Mal vom selben Server abzurufen. Angenommen, Sie wissen, dass die Bereitstellung einer bestimmten .php-Datei mehrere zeitaufwendige Datenbankabfragen erfordert, die abgerufenen Daten sich jedoch nur selten ändern und daher zwischengespeichert werden können. Wenn Sie alle Anfragen für diese Datei an denselben Server leiten, entsteht nur beim ersten Client eine lange Verzögerung durch die Datenbankabfragen. Für alle nachfolgenden Clients werden die Daten schnell aus dem Cache abgerufen. Ein weiterer Vorteil ist, dass nur ein Server diesen bestimmten Datenbestand zwischenspeichern muss. Da Sie dieselben Daten nicht auf jedem Server redundant zwischenspeichern, können Sie kleinere Caches verwenden.
Es gibt einige Fälle, in denen IP Hash – und Hash, wenn die IP-Adresse des Clients Teil des Schlüssels ist – nicht funktionieren:
- Wenn sich die IP-Adresse des Clients während der Sitzung ändern kann, beispielsweise wenn ein mobiler Client von einem WLAN in ein Mobilfunknetz wechselt.
- Wenn die Anfragen einer großen Anzahl von Clients über einen Forward-Proxy laufen, da für alle diese Anfragen die IP-Adresse des Proxys verwendet wird.
Hashes sind deterministisch (der Hashing-Algorithmus liefert jedes Mal dieselben Ergebnisse). Dies hat einige positive Nebeneffekte: Alle NGINX Plus- oder NGINX-Instanzen in einer Bereitstellung verteilen Anfragen auf genau dieselbe Weise, und die Zuordnung von Hashes zu Servern bleibt auch bei Neustarts des Load Balancers erhalten. (Tatsächlich wird sie nach dem Neustart neu berechnet, aber da das Ergebnis immer gleich ist, bleibt sie faktisch bestehen.)
Andererseits erfordert eine Änderung der Gruppe von Upstream-Servern in der Regel, dass zumindest einige der Zuordnungen neu berechnet werden, wodurch die Sitzungspersistenz unterbrochen wird. Die Anzahl der neu zu berechnenden Zuordnungen lässt sich etwas reduzieren:
- Fügen Sie bei der Hash-Methode den Parameter
consistentzur Direktivehashhinzu; NGINX Plus verwendet den Hashing-Algorithmus ketama, wodurch weniger Neuzuordnungen erforderlich sind. - Fügen Sie bei der IP-Hash-Methode vor dem vorübergehenden Entfernen eines Servers aus der Upstream-Gruppe den Parameter
downzu dessenserver-Direktive hinzu, wie für web2 im folgenden Beispiel gezeigt. Die Zuordnungen werden nicht neu berechnet, da davon ausgegangen wird, dass der Server bald wieder verfügbar ist.
upstream backend {    ip_hash;

    server web1;
    server web2 down;
    server web3;
}
Round Robin
Wie bereits erwähnt, ist Round Robin die standardmäßige Lastverteilungsmethode in NGINX Plus und NGINX. Damit ist sie sicherlich die einfachste Wahl – Sie müssen lediglich die Upstream-Gruppe selbst konfigurieren.
Allgemein gilt, dass Round Robin am besten funktioniert, wenn aufgrund der Eigenschaften der Server und Anfragen nicht zu erwarten ist, dass einzelne Server im Vergleich zu anderen überlastet werden. Zu den Voraussetzungen gehören:
- Alle Server haben ungefähr die gleiche Kapazität. Diese Anforderung ist weniger wichtig, wenn Unterschiede zwischen den Servern durch die Servergewichtung genau abgebildet werden.
- Alle Server hosten dieselben Inhalte.
- Anfragen unterscheiden sich kaum hinsichtlich der benötigten Zeit oder Rechenleistung. Wenn der Ressourcenbedarf der Anfragen stark variiert, kann ein Server überlastet werden, weil der Load Balancer ihm zufällig viele ressourcenintensive Anfragen kurz hintereinander zuweist.
- Das Datenverkehrsaufkommen ist nicht so hoch, dass die Server häufig nahezu vollständig ausgelastet sind. Sind die Server bereits stark ausgelastet, kann die schematische Verteilung der Anfragen durch Round Robin eher dazu führen, dass einige Server ihre Belastungsgrenze überschreiten und – wie im vorherigen Aufzählungspunkt beschrieben – überlastet werden.
Round Robin eignet sich besonders für Testszenarien, da es sicherstellt, dass Anfragen gleichmäßig auf alle Server verteilt werden (oder entsprechend der festgelegten Gewichtung). Einige andere Verfahren verteilen den Datenverkehr bei geringem Aufkommen nicht immer gleichmäßig, was die Testergebnisse verfälschen kann.
Die gleichmäßige Verteilung kann auch Aufschluss darüber geben, ob die Caches gut funktionieren und ihre Kapazität voll ausschöpfen: Da sich Anfragen für eine bestimmte Datei mit Round Robin nicht gezielt an denselben Server senden lassen, wird jeder Server wahrscheinlich eine Vielzahl von Dateien ausliefern und zwischenspeichern (darunter in der Regel viele, die auch auf den anderen Servern liegen). Dadurch ist es wahrscheinlicher, dass sich der Cache füllt.
Schließlich hilft die anfänglich gleichmäßige Verteilung dabei, Probleme mit der Sitzungspersistenz in NGINX Plus aufzudecken (wie sie mit der Direktive sticky konfiguriert wird).
Wenigste Verbindungen und kürzeste Zeit
Wie bereits erwähnt, ist Least Connections für die meisten Anwendungsfälle und insbesondere für den Produktivverkehr das am besten geeignete Lastverteilungsverfahren. Dies bestätigen auch Erfahrungsberichte unserer Kunden. Die Leistung ist stabil und vorhersehbar.
Least Connections verteilt die Arbeitslast zudem effektiv entsprechend der Leistungsfähigkeit auf die Server. Ein leistungsstärkerer Server bearbeitet Anfragen schneller, sodass er zu einem beliebigen Zeitpunkt wahrscheinlich weniger Verbindungen hat, die noch verarbeitet werden (oder sogar noch auf den Beginn der Verarbeitung warten), als ein leistungsschwächerer Server. Least Connections leitet jede Anfrage an den Server mit den wenigsten aktuellen Verbindungen weiter und sendet Anfragen somit mit höherer Wahrscheinlichkeit an leistungsstarke Server. (Durch die Festlegung von Gewichtungen lassen sich Anfragen jedoch noch effizienter verteilen, wie weiter unten unter „Gewichtungen bei unterschiedlichen Servern festlegen“ beschrieben.)
Sie können Least Time (nur NGINX Plus) als eine feinfühligere Variante von Least Connections betrachten. Durch die Einbeziehung der durchschnittlichen Antwortzeit berücksichtigt das Verfahren die jüngste Leistungshistorie des Servers (tatsächlich handelt es sich um einen exponentiell gewichteten gleitenden Durchschnitt, sodass ältere Antwortzeiten den Durchschnitt weniger stark beeinflussen als neuere).
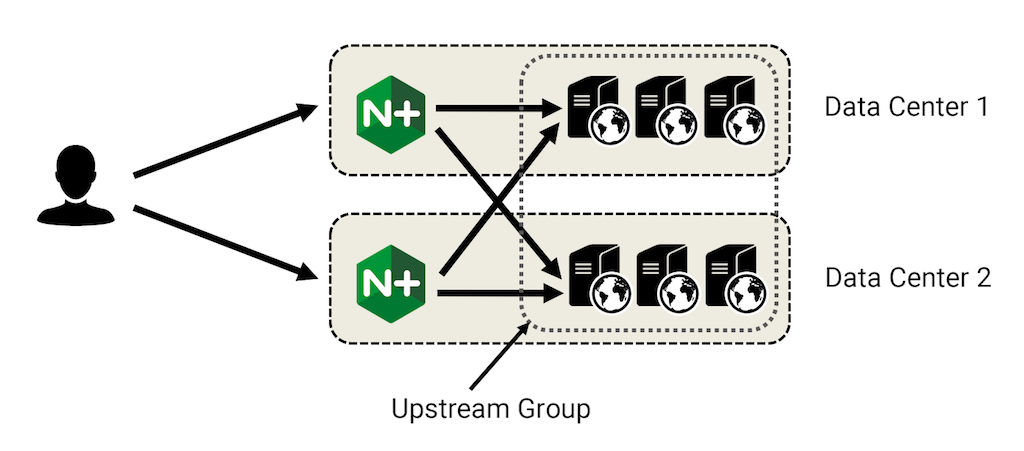
Least Time eignet sich besonders dann, wenn die Upstream-Server sehr unterschiedliche durchschnittliche Antwortzeiten aufweisen. Wenn Sie beispielsweise zur Notfallwiederherstellung Server in verschiedenen Rechenzentren betreiben, sendet Least Time tendenziell mehr Anfragen an die lokalen Server, da diese schneller antworten. Ein weiterer Anwendungsfall sind Cloud-Umgebungen, in denen die Serverleistung oft nur schwer vorhersehbar ist.
Gewichtungen festlegen, wenn Server nicht identisch sind
Wir haben bereits mehrfach betont, wie wichtig es ist, Servergewichtungen festzulegen, wenn die Server in der Upstream-Gruppe unterschiedliche Kapazitäten haben. Dies ist besonders beim Round-Robin-Load-Balancer wichtig, der andernfalls jedem Server die gleiche Anzahl an Anfragen zuweist. Das führt wahrscheinlich dazu, dass ein weniger leistungsfähiger Server überlastet wird, während ein leistungsfähigerer nur teilweise ausgelastet ist.
Um Gewichtungen festzulegen, fügen Sie den Parameter weight in eine oder mehrere server-Direktiven im upstream-Block ein. Der Standardwert ist 1.
Die Auswirkungen der Gewichtung bei den verschiedenen Lastverteilungsverfahren lassen sich wie folgt veranschaulichen. Beachten Sie, dass die Beschreibungen konzeptionell korrekt sind, die Implementierung im Code von NGINX Plus jedoch nicht unbedingt die angegebenen mathematischen Operationen verwendet. Hier ist die Upstream-Gruppe für unsere Beispiele:
upstream backend {    server web1 weight=6;
    server web2 weight=3;
    server web3;
}- Round Robin – Jeder Server erhält einen Anteil der eingehenden Anfragen, der seinem Gewicht geteilt durch die Summe aller Gewichte entspricht. In unserem Beispiel erhält web1 sechs von zehn Anfragen (60 %), web2 drei (30 %) und web3 eine (10 %).
- Hash und IP Hash – Zur Erinnerung: Ohne Gewichtung verteilt der Hashing-Algorithmus die Menge aller möglichen Hashwerte gleichmäßig auf „Buckets“, einen für jeden Server in der Upstream-Gruppe. Bei einer Gewichtung addiert er stattdessen die Gewichtungen, verteilt die Menge der möglichen Hashwerte auf eine entsprechende Anzahl von Buckets und ordnet jedem Server so viele Buckets zu, wie seiner Gewichtung entsprechen. In unserem Beispiel gibt es zehn Buckets, die jeweils 10 % der möglichen Hashwerte enthalten. Sechs Buckets (60 % der möglichen Hashwerte) sind web1 zugeordnet, drei Buckets (30 %) web2 und ein Bucket (10 %) web3.
- Least Connections und Least Time – Wie bereits erwähnt, verteilen diese Algorithmen die Arbeitslast auch ohne Gewichtungen recht effektiv entsprechend der Kapazität der einzelnen Server. Durch Gewichtungen lässt sich die Lastverteilung noch weiter verbessern. Zur Erinnerung: Least Connections und Least Time senden jede Anfrage an den Server mit dem niedrigsten „Score“ (der Anzahl der Verbindungen beziehungsweise einer mathematischen Kombination aus Verbindungen und Zeit). Wenn Sie Gewichtungen zuweisen, dividiert der Load Balancer den Score jedes Servers durch dessen Gewicht und sendet die Anfrage wiederum an den Server mit dem niedrigsten Wert. Hier ein Beispiel für Least Connections mit unseren Beispielgewichtungen und der angegebenen Anzahl aktiver Verbindungen: web1 hat mit 100 den niedrigsten Score und erhält die Anfrage, obwohl seine Verbindungsanzahl von 600 das 1,5-Fache der Verbindungsanzahl von web2 und mehr als das Vierfache der Verbindungsanzahl von web3 beträgt.
- web1 – 600 aktive Verbindungen ÷ 6 = 100
- web2 – 400 aktive Verbindungen ÷ 3 = 133
- web3 – 125 aktive Verbindungen ÷ 1 = 125
Zusammenfassung
Nach Abwägung der Vor- und Nachteile der in NGINX Plus und NGINX verfügbaren Lastverteilungsverfahren halten wir Least Connections (und bei NGINX Plus auch Least Time) für die Verfahren, die sich für die meisten Anwendungsfälle am besten eignen. Es ist jedoch wichtig, dass Sie mehrere Methoden in Ihrer Bereitstellung testen, da die spezifische Kombination aus Datenverkehr und Servereigenschaften dazu führen kann, dass eine andere Methode für Sie besser geeignet ist.
Um den Lastausgleich mit NGINX Plus selbst auszuprobieren, starten Sie noch heute Ihre kostenlose 30-tägige Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Wir würden uns freuen, von Ihren Erfahrungen mit Lastverteilung in verschiedenen Anwendungsfällen zu hören. Teilen Sie uns diese bitte unten im Kommentarbereich mit.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.
Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.
Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.