Haben Sie schon einmal die Leistung eines Servers im Labor gemessen und ihn anschließend für den realen Datenverkehr eingesetzt, nur um festzustellen, dass er nicht annähernd die Benchmark-Leistung erreicht? Die CPU-Auslastung ist niedrig und es stehen reichlich freie Ressourcen zur Verfügung, dennoch beklagen sich die Clients über langsame Antwortzeiten und Sie finden keine Möglichkeit, den Server besser auszulasten.
Was Sie beobachten, ist eine Auswirkung dessen, was wir als „HTTP-Schwerstarbeit“ bezeichnen können. In diesem Blogbeitrag untersuchen wir, wie HTTP funktioniert und wie gängige HTTP-Server HTTP-Transaktionen verarbeiten. Wir betrachten einige der dabei möglichen Leistungsprobleme und zeigen, wie das ereignisgesteuerte Modell von NGINX es zu einem äußerst effektiven Beschleunigungs-Proxy für diese HTTP-Server macht. Mit NGINX können Sie die Leistung unter realen Bedingungen wieder auf das Niveau Ihrer lokalen Benchmarks bringen.
Hinweise zur Optimierung von Linux und NGINX, um die Geschwindigkeit und Skalierbarkeit Ihrer Anwendungen zu verbessern, finden Sie im Beitrag „NGINX für mehr Leistung optimieren“ in unserem Blog.
Eine Einführung in HTTP und Keepalive-Verbindungen
HTTP-Keepalive-Verbindungen sind eine unverzichtbare Leistungsfunktion, die Latenzzeiten reduziert und dafür sorgt, dass Webseiten schneller geladen werden.
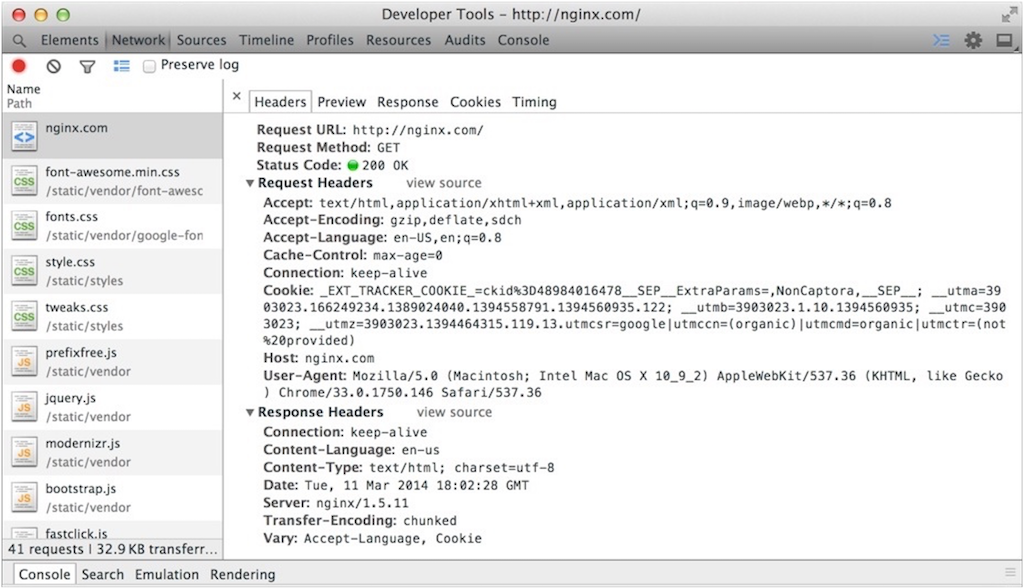
HTTP ist ein einfaches, textbasiertes Protokoll. Falls Sie dies noch nicht getan haben, sehen Sie sich die Ausgabe eines HTTP-Debugging-Tools an, beispielsweise des Tools in Ihrem Webbrowser, und betrachten Sie die Standardstruktur von Anfragen und Antworten:
In der einfachsten Implementierung stellt ein HTTP-Client eine neue TCP-Verbindung zum Zielserver her, sendet die Anfrage und empfängt die Antwort. Anschließend schließt der Server die TCP-Verbindung, um Ressourcen freizugeben.
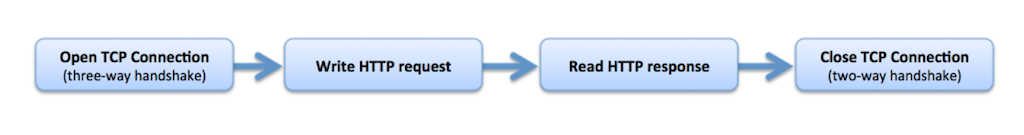
Diese Betriebsweise kann sehr ineffizient sein, insbesondere bei komplexen Webseiten mit einer großen Anzahl von Elementen oder bei langsamen Netzwerkverbindungen. Der Aufbau einer neuen TCP-Verbindung erfordert einen „Drei-Wege-Handshake“, und auch ihr Abbau umfasst ein zweistufiges Verfahren zum Beenden der Verbindung. Für jede Nachricht erneut eine TCP-Verbindung aufzubauen und zu schließen, ist vergleichbar damit, bei einem Telefongespräch nach jedem Wortbeitrag aufzulegen und erneut anzurufen.
HTTP verwendet einen Mechanismus namens „Keep-Alive-Verbindungen“, um die TCP-Verbindung zwischen Client und Server nach Abschluss einer HTTP-Transaktion offen zu halten. Wenn der Client eine weitere HTTP-Transaktion durchführen muss, kann er die inaktive Keep-Alive-Verbindung verwenden, anstatt eine neue TCP-Verbindung aufzubauen.
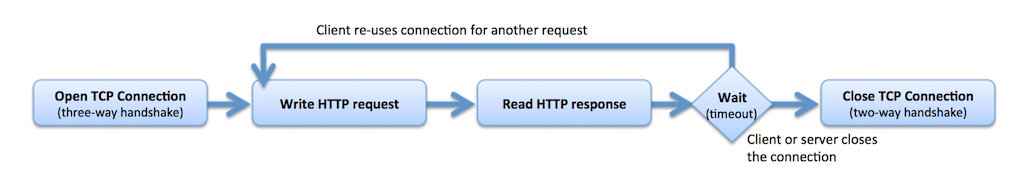
Clients öffnen in der Regel mehrere gleichzeitige TCP-Verbindungen zu einem Server und führen über alle diese Verbindungen Keepalive-Transaktionen durch. Diese Verbindungen bleiben geöffnet, bis entweder der Client oder der Server entscheidet, dass sie nicht mehr benötigt werden – üblicherweise aufgrund eines Inaktivitäts-Timeouts.
Moderne Webbrowser öffnen in der Regel 6 bis 8 Keepalive-Verbindungen und halten sie mehrere Minuten lang offen, bevor sie wegen Zeitüberschreitung beendet werden. Webserver können so konfiguriert werden, dass diese Verbindungen früher wegen Zeitüberschreitung beendet und geschlossen werden.
Welche Auswirkungen haben Keepalives auf den HTTP-Server?
Wenn viele Clients HTTP-Keepalives verwenden und der Webserver eine Begrenzung für gleichzeitige Verbindungen oder ein Skalierbarkeitsproblem aufweist, bricht die Leistung ein, sobald diese Grenze erreicht ist.
Der oben beschriebene Ansatz ist darauf ausgelegt, einem einzelnen Client die bestmögliche Leistung zu bieten. Wenn jedoch in einem Szenario ähnlich der „Tragik der Allmende“ alle Clients auf diese Weise arbeiten, kann sich dies leider nachteilig auf die Leistung vieler gängiger Webserver und Webanwendungen auswirken.
Der Grund dafür ist, dass viele Server eine feste Obergrenze für gleichzeitige Verbindungen haben. Beispielsweise kann der Apache HTTP Server in gängigen Konfigurationen nur eine begrenzte Anzahl gleichzeitiger TCP-Verbindungen verarbeiten: 150 mit dem worker-Multiprocessing-Modul (MPM) und 256 mit dem prefork-MPM. Jede inaktive HTTP-Keep-Alive-Verbindung belegt einen dieser Plätze. Sobald alle Plätze belegt sind, kann der Server keine weiteren HTTP-Verbindungen mehr annehmen.
Allgemein wird empfohlen, Keep-Alive-Verbindungen auf dem Webserver zu deaktivieren oder ihre Dauer stark zu begrenzen. Sie bieten eine sehr einfache Angriffsfläche für die Denial-of-Service-Angriffe SlowHTTPTest und Slowloris (eine schnelle Lösung finden Sie unter „Schutz vor Keep-Dead-Denial-of-Service-Angriffen“ auf serverfault.com).
Darüber hinaus weisen diese Web- und Anwendungsserver in der Regel jeder Verbindung einen Betriebssystem-Thread oder -Prozess zu. Eine TCP-Verbindung ist ein sehr schlankes Betriebssystemobjekt, ein Thread oder Prozess hingegen ist sehr ressourcenintensiv. Threads und Prozesse benötigen Arbeitsspeicher, müssen vom Betriebssystem aktiv verwaltet werden, und der „Kontextwechsel“ zwischen Threads oder Prozessen beansprucht CPU-Ressourcen. Jeder Verbindung einen eigenen Thread oder Prozess zuzuweisen, ist äußerst ineffizient.
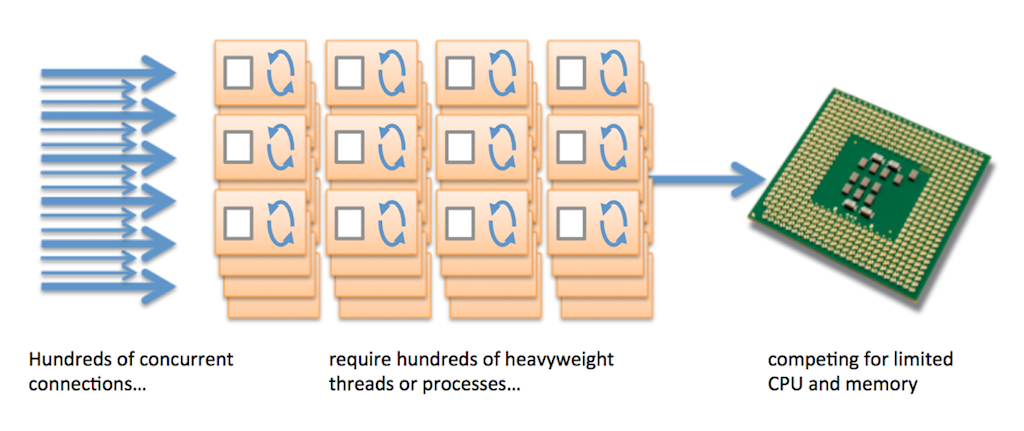
Die große Anzahl gleichzeitiger Clientverbindungen und die Zuweisung eines Threads oder Prozesses zu jeder Verbindung führen zu dem als „HTTP Heavy Lifting“ bekannten Phänomen, bei dem für die Verarbeitung einer einfachen HTTP-Transaktion ein unverhältnismäßig hoher Aufwand erforderlich ist.
Was bedeutet das in der Praxis?
Bei vielen modernen Web- und Anwendungsservern genügen bereits wenige Clients, um die maximale Anzahl gleichzeitiger Verbindungen auszuschöpfen.
Wenn ein Client 8 TCP-Verbindungen öffnet und jede davon nach der letzten Nutzung noch 15 Sekunden lang aufrechterhält, belegt er 15 Sekunden lang 8 Slots für gleichzeitige Verbindungen. Wenn Ihre Website von einem Client pro Sekunde aufgerufen wird, sind kontinuierlich 120 Slots durch inaktive Keep-Alive-Verbindungen belegt. Bei zwei Clients pro Sekunde sind 240 Slots belegt. Sobald alle Slots belegt sind, können neue Clients erst dann eine Verbindung herstellen, wenn die bestehenden Verbindungen wegen Zeitüberschreitung beendet werden.
Dies kann zu einer sehr ungleichmäßigen Servicequalität führen. Clients, die erfolgreich eine Keepalive-Verbindung herstellen, können Ihren Dienst uneingeschränkt nutzen. Clients, die versuchen, eine Verbindung herzustellen, wenn alle Slots für gleichzeitige Verbindungen belegt sind, werden abgewiesen und müssen in einer Warteschlange warten.
Warum treten diese Effekte bei Benchmark-Tests nicht auf?
Diese Probleme treten nur in langsamen Netzwerken mit vielen Clients auf. Bei Benchmark-Tests mit einem einzelnen Client über ein schnelles lokales Netzwerk sind sie nicht zu beobachten.
Es gibt mehrere Gründe, warum diese Effekte in einem Benchmark möglicherweise nicht zu beobachten sind.
- Wenn Sie Keepalives nicht aktivieren, während Sie den Benchmark ausführen, stellt der Client für jede Transaktion eine neue TCP-Verbindung her (die nach Abschluss der Transaktion wieder getrennt wird). Da Sie den Benchmark höchstwahrscheinlich über ein schnelles lokales Netzwerk ausführen, verläuft er erfolgreich, und die Leistungsprobleme, die durch den Verzicht auf Keepalives entstehen, bleiben unbemerkt.
- Wenn Sie Keepalives aktivieren, können Sie höchstwahrscheinlich weniger gleichzeitige Verbindungen als das Limit Ihres Servers nutzen, und Ihr Benchmark-Client lastet jede Verbindung vollständig aus (indem er sie wiederholt verwendet), sodass Ihr Server seine maximale Kapazität erreicht. Dies entspricht jedoch nicht dem Verbindungsprofil unter realen Bedingungen.
Beachten Sie, dass die meisten Benchmark-Tools nur erfolgreiche Transaktionen erfassen. Verbindungen, die aufgrund erschöpfter Ressourcen ins Stocken geraten, werden möglicherweise nicht erfasst oder machen scheinbar nur einen winzigen Bruchteil der erfolgreichen Verbindungen aus. Dadurch wird das wahre Ausmaß des Problems bei realem Datenverkehr verschleiert.
Wie häufig tritt das Problem auf?
Jeder thread- oder prozessbasierte Web- oder Anwendungsserver ist anfällig für Einschränkungen bei der Parallelverarbeitung.
Dieses Problem ist jeder Web- oder Anwendungsplattform inhärent, die jeder Verbindung einen Thread oder Prozess zuweist. In einer optimierten Benchmark-Umgebung ist es nicht leicht zu erkennen, doch unter realen Bedingungen äußert es sich in schlechter Leistung und übermäßiger CPU-Auslastung.
Es gibt mehrere Maßnahmen, die Sie ergreifen können, um dieses Problem zu beheben:
- Erhöhen Sie die Anzahl der Threads oder Prozesse – Dies ist nur eine sehr kurzfristige Maßnahme. Threads und Prozesse sind ressourcenintensive Betriebssystemobjekte, deren Verwaltungsaufwand mit zunehmender Anzahl schnell ansteigt.
- Deaktivieren oder beschränken Sie die Verwendung von HTTP-Keepalives – Dadurch wird das Erreichen der Obergrenze für gleichzeitige Verbindungen hinausgezögert, allerdings auf Kosten einer deutlich schlechteren Leistung für jeden Client.
- Spezialisierte Keepalive-Verarbeitung verwenden – Der Apache HTTP Server (Webserver) verfügt über ein relativ neues event-MPM, das Verbindungen zwischen Worker-Threads und einem dedizierten Event-Thread verschiebt, wenn sie zwischen den Zuständen „aktiv“ und „inaktives Keepalive“ wechseln. Dies kann eine Option sein, wenn die anderen von Ihnen verwendeten Module dieses MPM unterstützen. Beachten Sie jedoch, dass SSL/TLS-Verbindungen weiterhin vollständig in dedizierten Threads verarbeitet werden.
- Verwenden Sie ein effizienteres Verarbeitungsmodell – Die mit Abstand einfachste und wirksamste Maßnahme besteht darin, Ihren Web- oder Anwendungsservern einen effizienten HTTP-Proxy vorzuschalten. Ein ereignisgesteuerter Proxy wie NGINX unterliegt nicht den oben beschriebenen Einschränkungen bei der Anzahl gleichzeitiger Verbindungen. Langsame Verbindungen und inaktive Keepalive-Verbindungen bringen ihn nicht aus der Ruhe. Darüber hinaus wandelt er langsame clientseitige Verbindungen mit mehreren inaktiven Keepalive-Verbindungen effektiv in schnelle, lokale und hocheffiziente Verbindungen nach Art eines Benchmarks um, die Ihren Web- und Anwendungsservern die bestmögliche Leistung entlocken.
NGINX als beschleunigenden HTTP-Proxy verwenden
NGINX verwendet eine andere Architektur, bei der die oben beschriebenen Probleme mit gleichzeitigen Verbindungen nicht auftreten. Langsame Clientverbindungen werden in optimierte, Benchmark-ähnliche Verbindungen umgewandelt, um die bestmögliche Leistung aus Ihren Servern herauszuholen.
NGINX verwendet ein hocheffizientes ereignisgesteuertes Modell zur Verwaltung von Verbindungen.
Jeder NGINX-Prozess kann mehrere Verbindungen gleichzeitig verarbeiten. Wenn eine neue Verbindung angenommen wird, ist der zusätzliche Aufwand sehr gering (er besteht aus einem neuen Dateideskriptor und einem neuen Ereignis, das abgefragt werden muss) – anders als beim oben beschriebenen Modell mit einem Prozess oder Thread pro Verbindung. NGINX verfügt über eine äußerst effiziente Ereignisschleife:
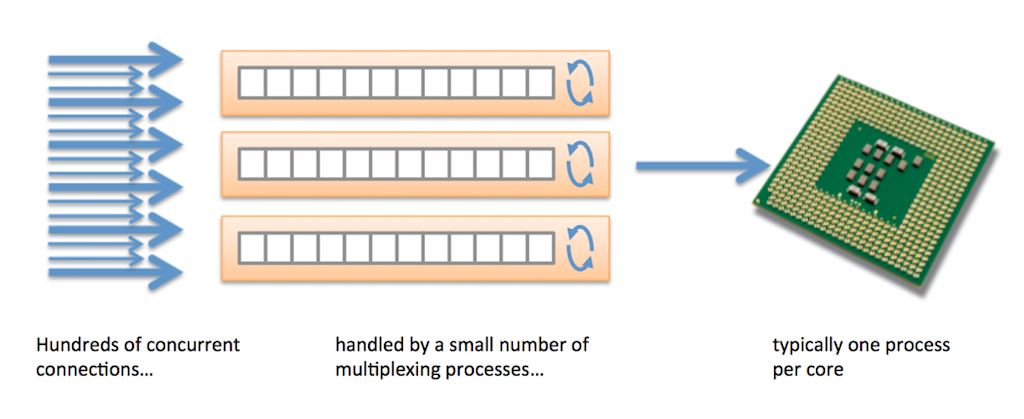
Dadurch kann jeder NGINX-Prozess problemlos auf Dutzende, Tausende oder Hunderttausende gleichzeitige Verbindungen skaliert werden.
NGINX leitet die Anfragen dann über einen lokalen Pool von Keepalive-Verbindungen an den Upstream-Server weiter. Dadurch entfällt der Aufwand für das Öffnen und Schließen von TCP-Verbindungen, und die TCP-Stacks passen sich schnell an die optimale Fenstergröße und die optimalen Parameter für Wiederholungsversuche an. Das Senden von Anfragen und das Lesen von Antworten erfolgt über das lokale, optimierte Netzwerk wesentlich schneller:
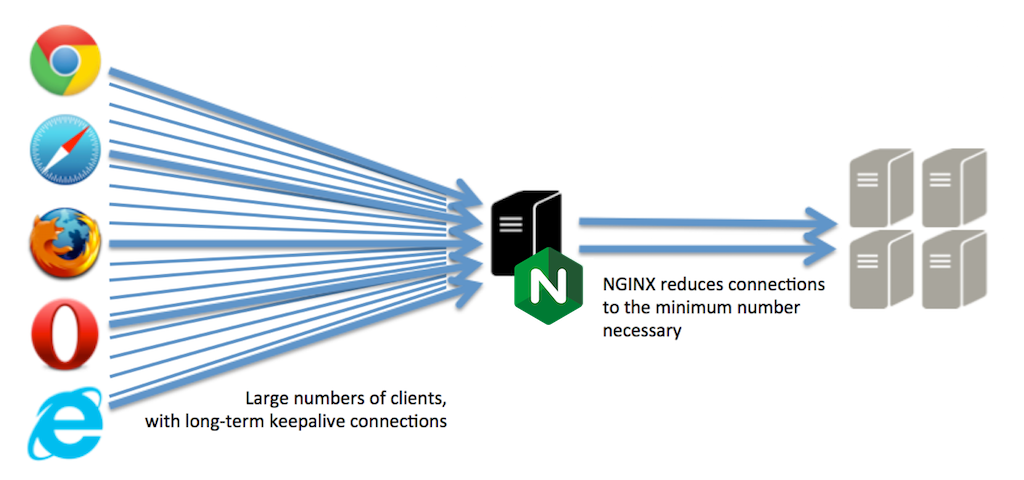
Im Endeffekt kommuniziert der Upstream-Server über ein schnelles Netzwerk mit einem einzigen lokalen Client (NGINX), der HTTP-Keepalive-Verbindungen optimal nutzt, um den Aufwand für den Verbindungsaufbau zu minimieren, ohne Verbindungen unnötig lange offen zu halten. Dadurch arbeitet der Server wieder in einer optimalen, benchmarkähnlichen Umgebung.
Wenn NGINX als HTTP-Proxy fungiert, ergibt sich Folgendes:
- Bessere Auslastung vorhandener Ressourcen. Ihre Web- und Anwendungsserver können mehr Transaktionen pro Sekunde verarbeiten, da sie nicht mehr die rechenintensive HTTP-Verarbeitung übernehmen müssen.
- Geringere Fehlerraten. HTTP-Zeitüberschreitungen sind deutlich unwahrscheinlicher, da NGINX als zentrale Steuerungsinstanz für alle Clients fungiert.
- Bessere Leistung für Endbenutzer. Server arbeiten effizienter und verarbeiten Verbindungen schneller.
Weitere Möglichkeiten, wie NGINX Dienste beschleunigen kann
Die Entlastung von aufwendiger HTTP-Verarbeitung ist nur eine der leistungssteigernden Maßnahmen, mit denen NGINX Ihre überlastete Anwendungsinfrastruktur unterstützen kann.
Die HTTP-Caching-Funktion von NGINX kann Antworten der Upstream-Server zwischenspeichern und anhand standardmäßiger Cache-Regeln steuern, was wie lange im Cache gespeichert wird. Fordern mehrere Clients dieselbe Ressource an, kann NGINX die Anfrage aus seinem Cache beantworten, ohne die Upstream-Server mit doppelten Anfragen zu belasten.
NGINX kann auch andere Vorgänge vom Upstream-Server übernehmen. Sie können die Datenkomprimierung zur Reduzierung der Bandbreitennutzung auslagern, die SSL/TLS-Ver- und -Entschlüsselung zentralisieren, eine anfängliche Clientauthentifizierung durchführen (beispielsweise mit HTTP-Basisauthentifizierung, Unteranfragen an externe Authentifizierungsserver und JSON Web Tokens) und bei Bedarf verschiedenste Regeln zur Begrenzung der Datenverkehrsrate anwenden.
Kein gewöhnlicher Load Balancer oder ADC
Vergessen Sie schließlich nicht, dass NGINX im Gegensatz zu anderen Beschleunigungs-Proxys, Load Balancern oder Application Delivery Controllern (ADCs) auch ein vollwertiger Webserver ist. Mit NGINX können Sie statische Inhalte bereitstellen, Datenverkehr an Anwendungsserver für Java, PHP, Python, Ruby und andere Sprachen weiterleiten, Medieninhalte (Audio und Video) ausliefern, Authentifizierungs- und Sicherheitssysteme integrieren und mithilfe von Regeln, die in die NGINX-Konfiguration eingebettet sind, sogar direkt auf Transaktionen reagieren.
Da es keine integrierten Leistungsbeschränkungen gibt, nutzen NGINX und NGINX Plus die Hardware, auf der sie bereitgestellt werden, jetzt und in Zukunft voll aus.
Wenn Sie NGINX Plus ausprobieren möchten, starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.