NodePort, LoadBalancer, Ingress-Controller … du meine Güte!
Wenn wir mit Kunden und der Community darüber sprechen, wie sich Kubernetes produktionsreif machen lässt, lautet eine der häufigsten Fragen: Brauche ich einen Ingress-Controller? Diese Frage lässt sich selten mit einem einfachen Ja oder Nein beantworten. Vielmehr muss man die verschiedenen Möglichkeiten kennen, wie sich Datenverkehr zu den Pods leiten lässt. In diesem Blogbeitrag erläutern wir die Grundlagen der Kubernetes-Netzwerkarchitektur, damit Sie fundiert entscheiden können, ob – und wann – Sie einen Ingress-Controller benötigen.
Kubernetes unterstützt verschiedene Ansätze und Ebenen für die Weiterleitung von externem Datenverkehr an einen Pod – doch sie sind nicht alle gleichwertig. Das Standardmodell ist kube-proxy, das eigentlich kein Proxy ist und weder für den Lastenausgleich noch für die Steuerung von APIs oder die Überwachung des Verhaltens von Diensten konzipiert wurde.
Glücklicherweise gibt es noch andere Möglichkeiten, externen Datenverkehr zu verwalten. Bevor wir fortfahren, werfen wir jedoch einen kurzen Blick auf die Kubernetes-Komponenten:
- Kubernetes-Bereitstellungen bestehen aus Knoten, bei denen es sich um physische oder virtuelle Maschinen handelt.
- Knoten schließen sich zu einem Cluster zusammen.
- Jeder Cluster verwaltet Pods, die auf Netzwerk- und Infrastrukturebene in Kubernetes die kleinste gemeinsame Einheit darstellen. Ein oder mehrere Pods bilden zusammen einen Service.
- In jedem Pod befinden sich ein oder mehrere Container (abhängig von der Größe der Anwendung).
Kubernetes überwacht die Pods, aus denen ein Dienst besteht, und skaliert sie nach Bedarf, um die Anforderungen der Anwendung zu erfüllen. Doch wie leitet man den Datenverkehr an die Pods weiter? Hier kommen zwei Arten von Kubernetes-Objekten ins Spiel: Services und Ingress-Controller.
Was ist ein Kubernetes-Service?
Laut der Kubernetes-Dokumentation ist ein Service „eine abstrakte Möglichkeit, eine Anwendung bereitzustellen, die auf einer Gruppe von Pods ausgeführt wird“. Ein Service verbindet Pods in einem Cluster oder Container-Netzwerk so miteinander, dass es keine Rolle spielt, auf welchem konkreten Node sie sich befinden. Dadurch kann externer Datenverkehr auch dann an bestimmte Pods weitergeleitet werden, wenn sich deren Speicherort ändert oder sie gelöscht und neu gestartet werden. Auf diese Weise funktioniert ein Service ähnlich wie ein sehr einfacher Reverse-Proxy.
Es gibt mehrere Arten von Services und Serviceobjekten, die für die Weiterleitung von externem Datenverkehr an Kubernetes relevant sind. Sie werden häufig miteinander verwechselt, erfüllen jedoch jeweils ganz unterschiedliche Aufgaben. Daher lohnt es sich, ihre Funktionen, Einsatzmöglichkeiten und Nachteile näher zu betrachten.
ClusterIP
ClusterIP ist der Standarddienst, der innerhalb von Kubernetes einen Dienst bereitstellt, auf den andere Dienste im Cluster zugreifen können. Von außerhalb des Clusters ist er nicht erreichbar. Die einzige Möglichkeit, einen ClusterIP-Dienst zugänglich zu machen, besteht darin, etwas wie kube-proxy zu verwenden. Es gibt jedoch nur wenige Szenarien, in denen dies sinnvoll ist. Dazu gehören etwa der Zugriff auf einen Dienst von Ihrem Laptop aus, die Fehlerbehebung bei einem Dienst oder die Einsicht in Überwachungsdaten und Metriken.
NodePort
Ein NodePort-Dienst öffnet auf jedem Knoten im Cluster einen bestimmten Port und leitet sämtlichen Datenverkehr, der über diesen Port an den Knoten gesendet wird, an die entsprechende Anwendung weiter. Dies ist eine sehr einfache Möglichkeit, Datenverkehr zu Ihren Anwendungen zu leiten, weist jedoch bei realen Anwendungsfällen der Datenverkehrssteuerung viele Einschränkungen auf. Pro NodePort kann nur ein Dienst verwendet werden, und es stehen nur Ports im Bereich von 30000 bis 32767 zur Verfügung. Auch wenn 2768 Ports nach viel klingen, gehen sie Organisationen, die Kubernetes in großem Maßstab betreiben, schnell aus. Außerdem verwendet NodePort Routingregeln auf Layer 4 sowie das Linux-Dienstprogramm iptables, wodurch das Routing auf Layer 7 eingeschränkt wird.
Neben den Einschränkungen beim Routing hat die Verwendung von NodePort drei weitere große Nachteile:
- Nachgelagerte Clients müssen die IP-Adresse jedes Knotens kennen, um eine Verbindung zu ihm herzustellen. Dies wird problematisch, wenn sich die IP-Adresse des Knotens oder der Host der virtuellen Maschine ändert.
- NodePort kann Datenverkehr nicht an mehrere IP-Adressen weiterleiten.
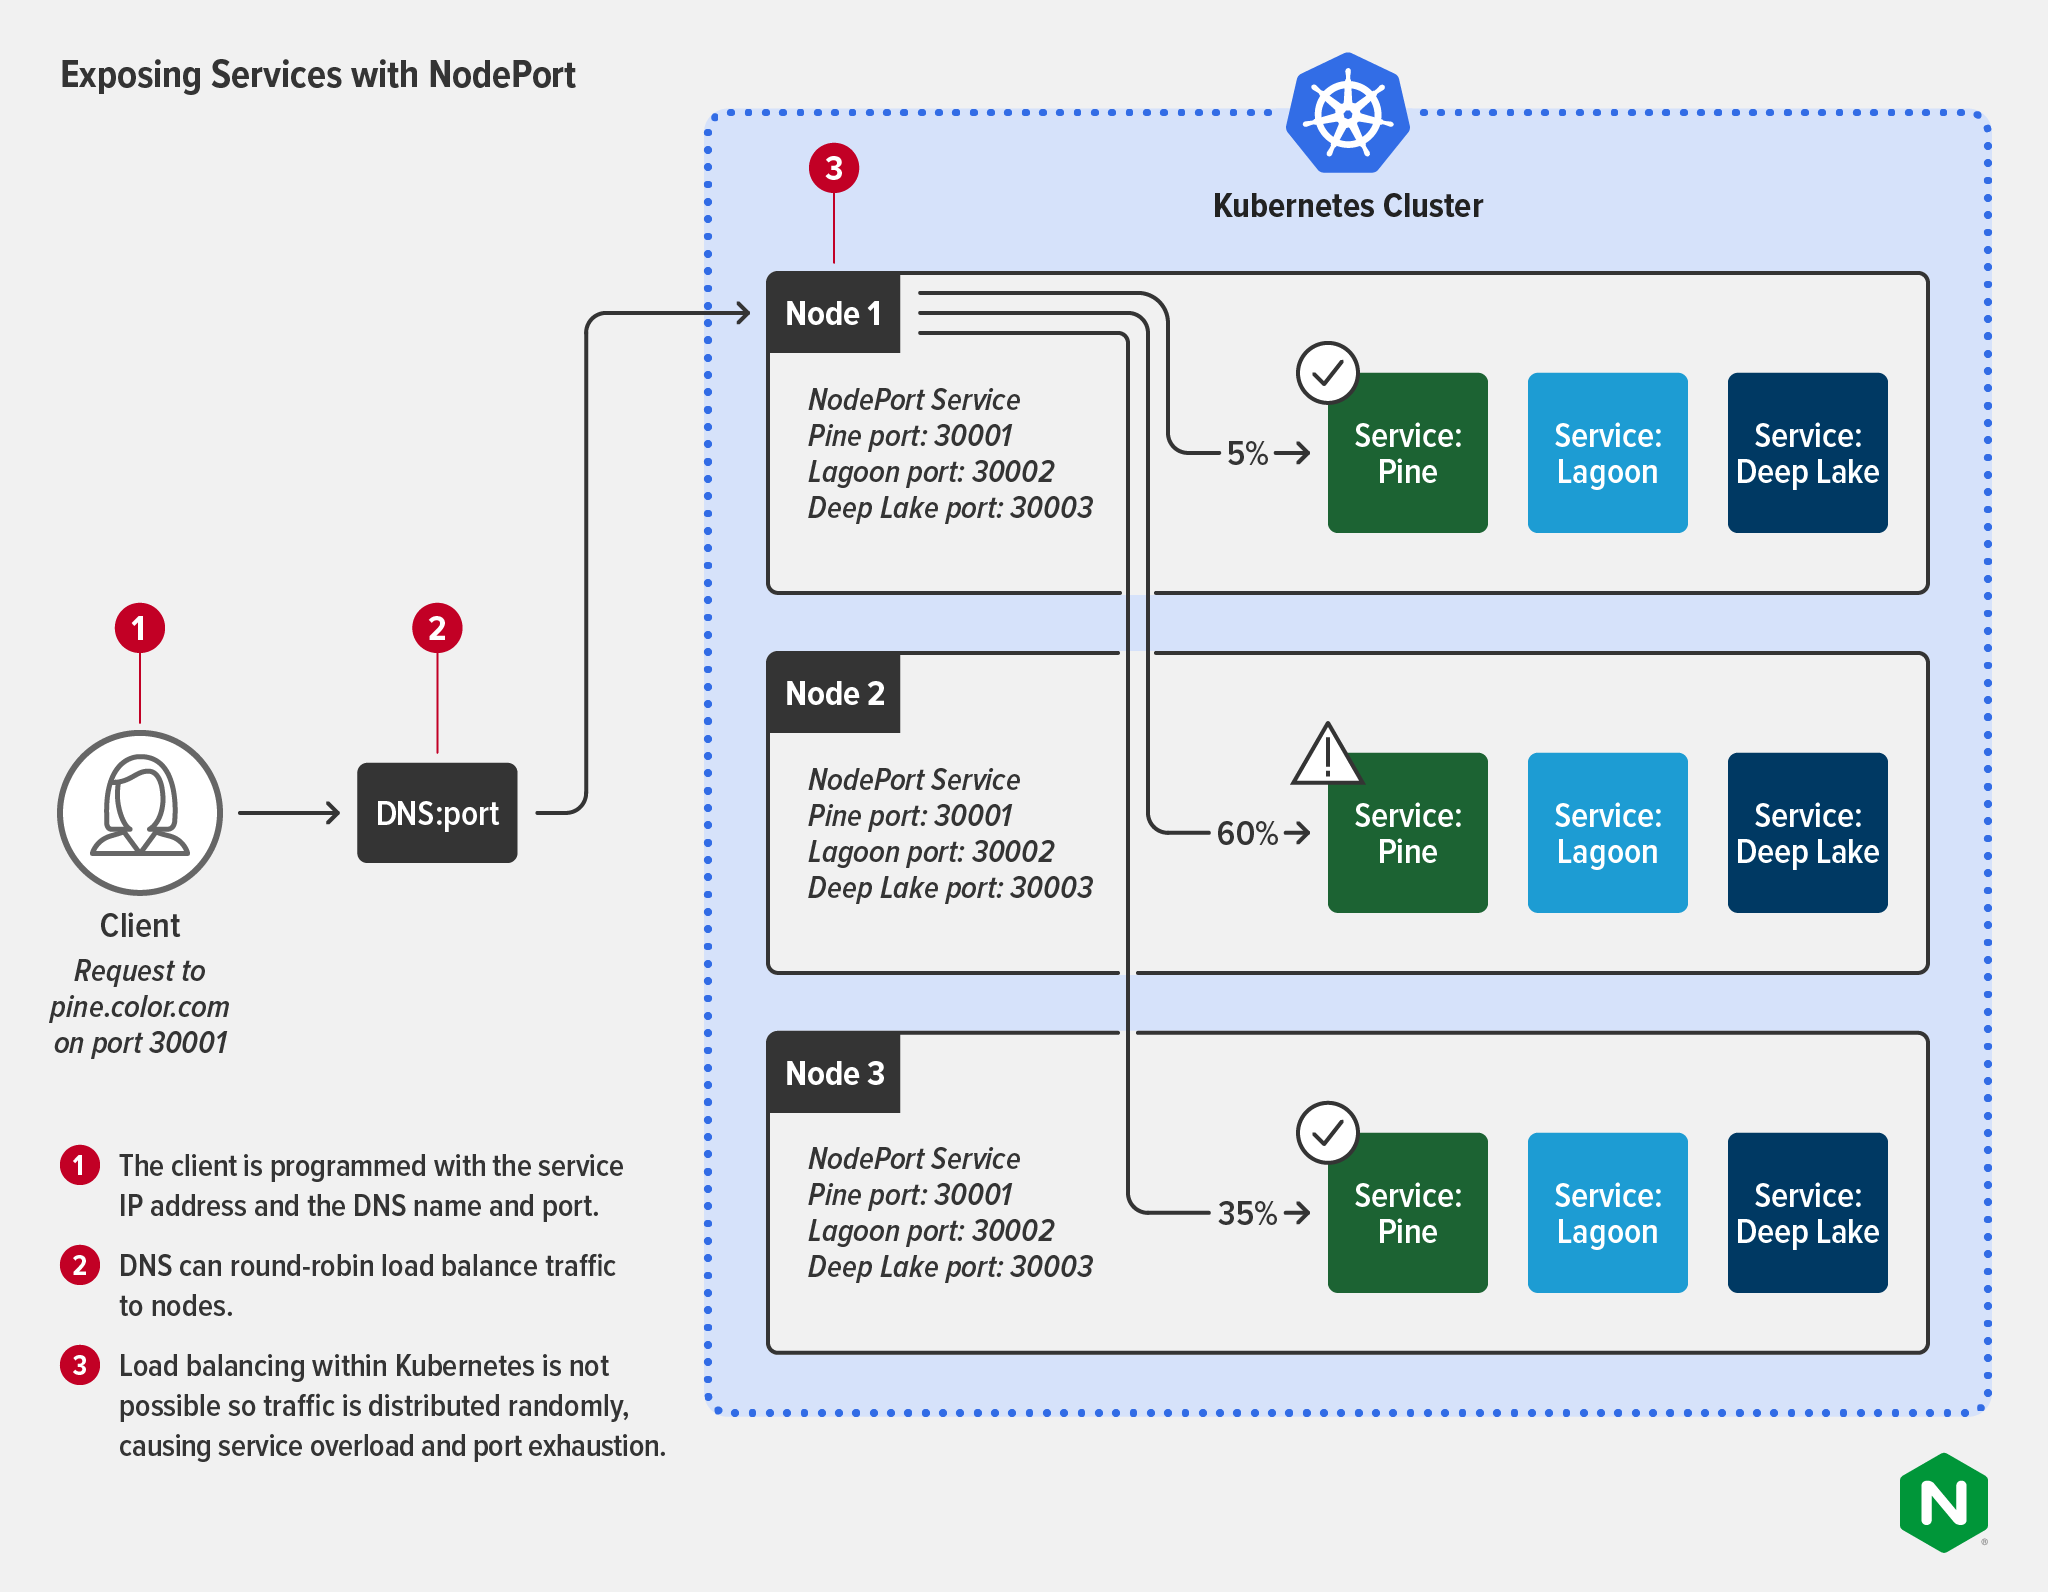
- Wie in der Abbildung dargestellt, bietet NodePort keinen Lastenausgleich innerhalb von Kubernetes-Clustern. Daher wird der Datenverkehr zufällig auf die Services verteilt. Dies kann zu einer Überlastung der Services und einer Erschöpfung der verfügbaren Ports führen.
LoadBalancer
Ein LoadBalancer-Dienst akzeptiert externen Datenverkehr, benötigt jedoch einen externen Load Balancer als Schnittstelle für diesen Datenverkehr. Dies unterstützt Layer-7-Routing (zu Pod-IP-Adressen), sofern der externe Load Balancer ordnungsgemäß abgestimmt und neu konfiguriert wird, um den Datenverkehr den ausgeführten Pods zuzuordnen. LoadBalancer ist eine der beliebtesten Möglichkeiten, Dienste extern bereitzustellen. Er wird meist auf einer Cloud-Plattform eingesetzt und eignet sich gut für kleine, statische Bereitstellungen.
Wenn Sie einen verwalteten Kubernetes-Dienst verwenden, erhalten Sie automatisch den vom Cloud-Anbieter ausgewählten Load Balancer. Auf der Google Cloud Platform können Sie beispielsweise mit dem Diensttyp LoadBalancer einen Network Load Balancer bereitstellen, während in AWS standardmäßig ein Application Load Balancer (ALB) verwendet wird. Jeder von Ihnen bereitgestellte Dienst erhält eine eigene öffentliche IP-Adresse, die den gesamten Datenverkehr weiterleitet, jedoch ohne jegliche Filterung oder Routing. Das bedeutet, dass Sie nahezu jede Art von Datenverkehr senden können (HTTP, TCP/UDP, WebSocket usw.). Wenn Sie die Tools des Cloud-Anbieters nicht verwenden möchten – beispielsweise weil Sie einen größeren Funktionsumfang oder ein plattformunabhängiges Tool benötigen –, können Sie sie alternativ durch eine Lösung wie F5 BIG-IP (als externen Load Balancer) und F5 Container Ingress Services (als Operator, der die LoadBalancer-Funktion übernimmt) ersetzen. Weitere Informationen zu diesem Muster finden Sie im Beitrag Bereitstellung von BIG-IP und NGINX Ingress Controller in derselben Architektur in unserem Blog.
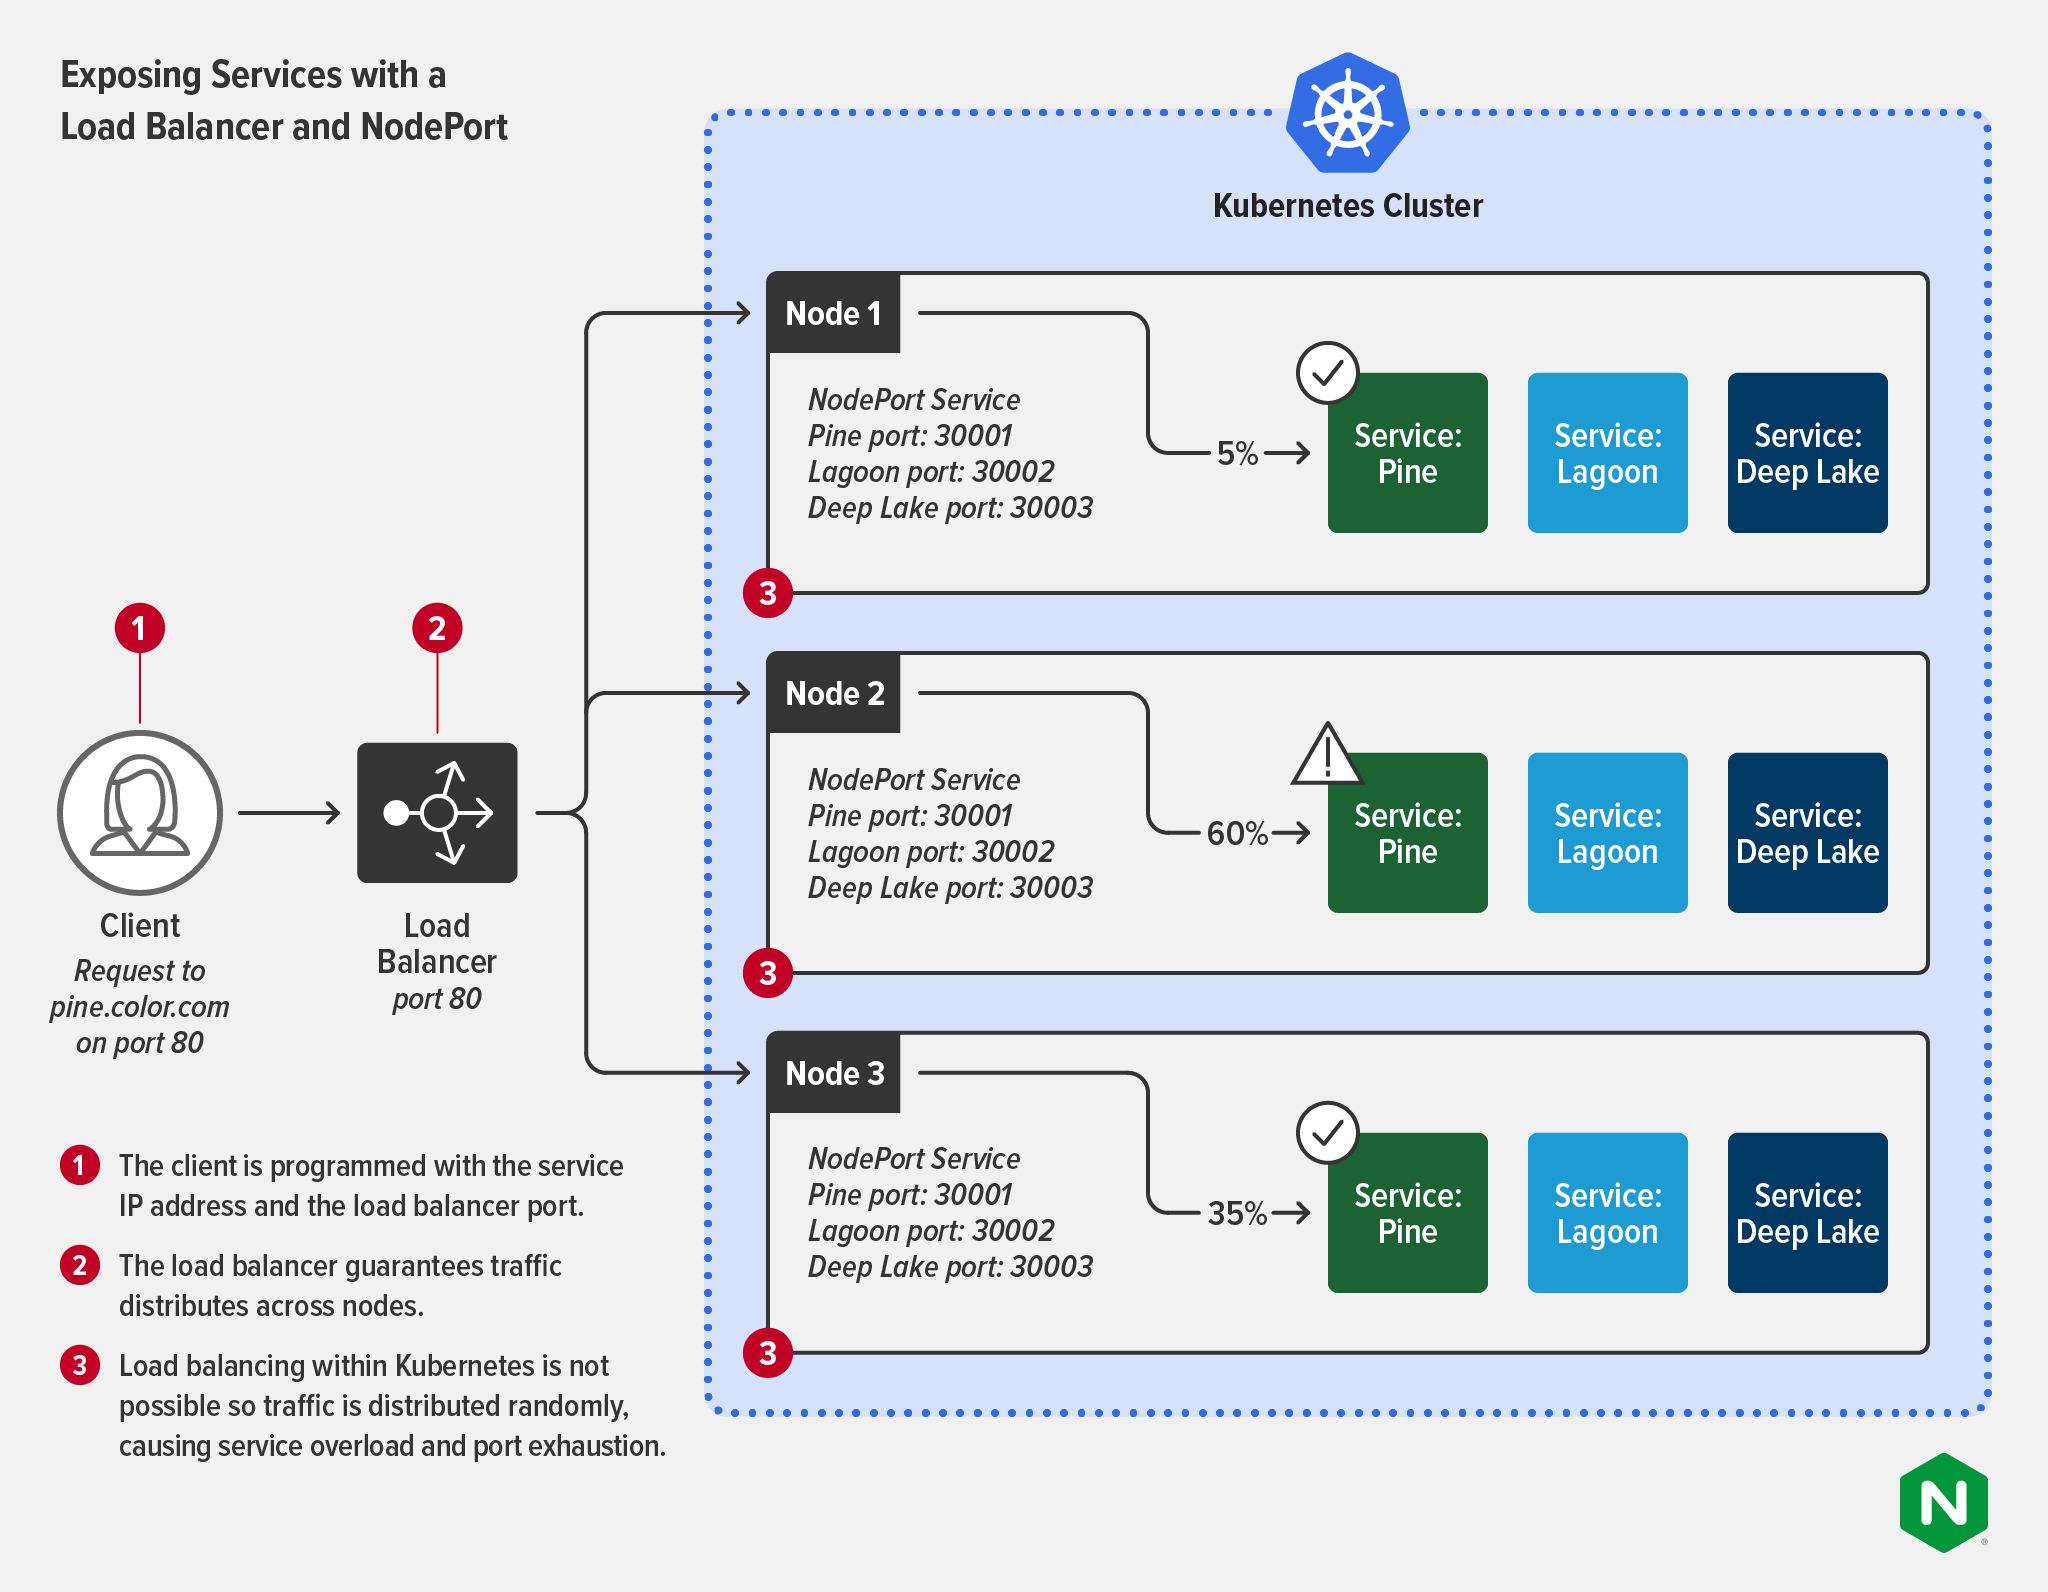
Die Bereitstellung Ihrer Anwendungen über LoadBalancer wird in dynamischen Umgebungen zur Herausforderung, wenn Ihre Anwendungs-Pods skaliert werden müssen, um wechselnden Anforderungen gerecht zu werden. Da jeder Dienst eine eigene IP-Adresse erhält, müssen für eine beliebte Anwendung unter Umständen Hunderte – oder sogar Tausende – von IP-Adressen verwaltet werden. In den meisten Fällen stellt der externe Load Balancer die Verbindung zu den Diensten über NodePort her, wie im folgenden Diagramm dargestellt. Dadurch wird zwar gewährleistet, dass der Datenverkehr gleichmäßig auf die Knoten verteilt wird, ein Lastenausgleich zwischen den Diensten ist jedoch weiterhin nicht möglich, sodass es nach wie vor zu einer Überlastung der Dienste und einer Erschöpfung der verfügbaren Ports kommen kann.
Was ist ein Kubernetes-Ingress-Controller?
Laut der Kubernetes-Dokumentation sind „Controller Regelkreise, die den Zustand Ihres Clusters überwachen und bei Bedarf Änderungen vornehmen oder anfordern. Jeder Controller versucht, den aktuellen Zustand des Clusters dem gewünschten Zustand anzunähern.“ Controller werden in Kubernetes für viele Aufgaben zur Zustandsverwaltung eingesetzt, etwa für die korrekte Zuweisung von Ressourcen, die Bereitstellung von persistentem Speicher und die Verwaltung von Cronjobs.
Im Zusammenhang mit dem Routing bietet ein Ingress-Controller eine Möglichkeit, die Einschränkungen von NodePort und LoadBalancer zu überwinden.
Ein Ingress-Controller dient dazu, externe Interaktionen mit Pods zu konfigurieren und zu verwalten, die einem bestimmten Service zugeordnet sind. Ingress-Controller sind darauf ausgelegt, dynamisches Layer-7-Routing als zentrale Funktion zu behandeln. Dadurch ermöglichen sie eine wesentlich granularere Steuerung und Verwaltung bei geringerem Aufwand. Ein Ingress-Controller lässt sich nicht nur zur Steuerung des eingehenden Datenverkehrs einsetzen, sondern auch zur Bereitstellung von Leistungsmetriken auf Service-Ebene und als Bestandteil einer Sicherheitsrichtlinie. Ingress-Controller bieten viele Funktionen herkömmlicher externer Load Balancer, darunter TLS-Terminierung, die Verwaltung mehrerer Domains und Namespaces sowie natürlich die Lastverteilung. Sie können den Datenverkehr auf Anfrageebene statt auf Service-Ebene verteilen. Dies ermöglicht eine aussagekräftigere Betrachtung des Layer-7-Datenverkehrs und eine deutlich bessere Durchsetzung von SLAs.
Und es gibt noch einen weiteren Vorteil! Ingress-Controller können auch Egress-Regeln durchsetzen, die ausgehenden Datenverkehr von bestimmten Pods nur zu bestimmten externen Diensten zulassen oder sicherstellen, dass der Datenverkehr mittels mTLS gegenseitig verschlüsselt wird. Die Anforderung von mTLS ist für die Bereitstellung regulierter Dienste in Branchen wie dem Gesundheitswesen, dem Finanzsektor, der Telekommunikation und dem öffentlichen Sektor von entscheidender Bedeutung – und ein zentraler Bestandteil einer Strategie für Ende-zu-Ende-Verschlüsselung (E2EE). Die Steuerung des ausgehenden Datenverkehrs mit demselben Tool vereinfacht zudem die Anwendung von Geschäftslogik auf Dienste. Geeignete Ressourcenregeln lassen sich wesentlich einfacher einrichten, wenn Ingress und Egress in derselben Steuerungsebene miteinander verknüpft sind.
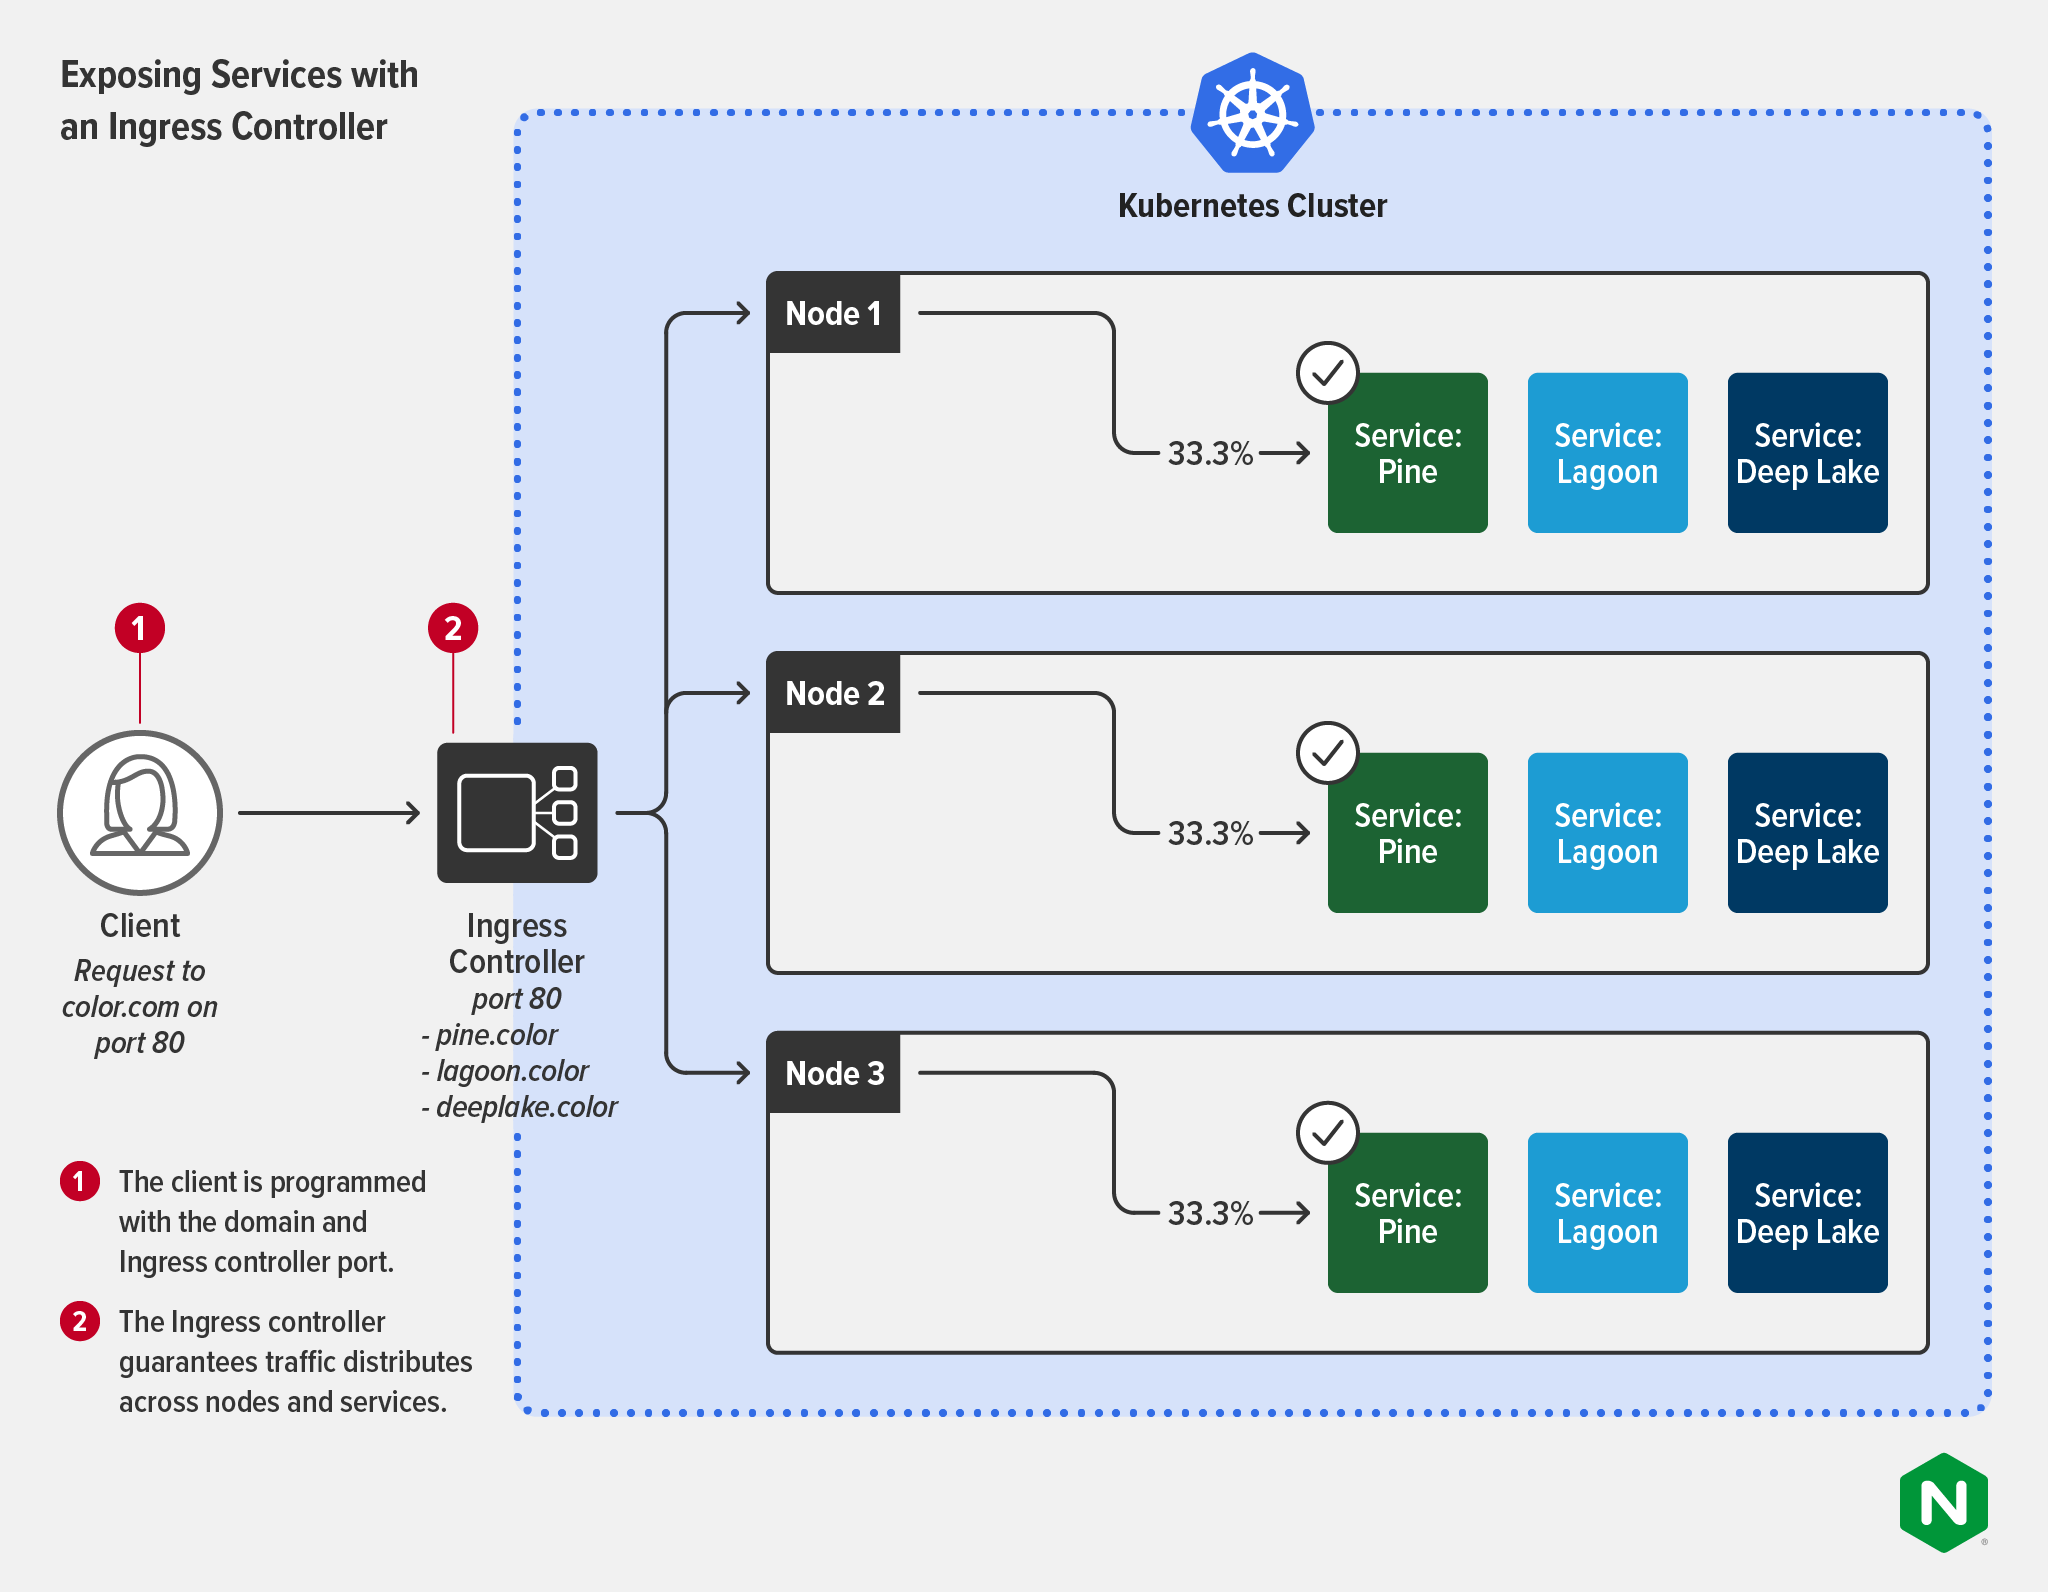
Das folgende Diagramm zeigt, wie ein Ingress-Controller die Komplexität für den Client reduziert, da dieser die IP-Adresse oder den Port eines Dienstes nicht mehr kennen muss. Die Verteilung des Datenverkehrs auf die Dienste ist gewährleistet. Einige Ingress-Controller unterstützen mehrere Lastverteilungsalgorithmen und bieten dadurch mehr Flexibilität und Kontrolle.
Bereitstellen eines Load Balancers mit einem Ingress-Controller
Wie wir in Bereitstellung von BIG-IP und NGINX Ingress Controller in derselben Architektur erläutern, gibt es in vielen Unternehmen Anwendungsfälle, die von der Bereitstellung eines externen Load Balancers mit einem Ingress Controller (oder in den meisten Fällen mehreren Ingress-Controller-Instanzen) profitieren. Dies ist besonders häufig der Fall, wenn Unternehmen Kubernetes skalieren müssen oder in Umgebungen mit hohen Compliance-Anforderungen tätig sind. Die Tools werden in der Regel von verschiedenen Teams verwaltet und für unterschiedliche Zwecke eingesetzt:
- Load Balancer (oder ADC):
- Verantwortlich: ein NetOps-Team (oder möglicherweise ein SecOps-Team)
- Anwendungsfall: Außerhalb von Kubernetes als einziger öffentlich zugänglicher Endpunkt für Dienste und Anwendungen, die Benutzern außerhalb des Clusters bereitgestellt werden. Wird als allgemeinere Appliance eingesetzt, die die Sicherheit unterstützt und ein übergeordnetes Netzwerkmanagement ermöglicht.
- Ingress-Controller:
- Verantwortlich: ein Platform-Ops- oder DevOps-Team
- Anwendungsfall: Innerhalb von Kubernetes für die granulare Lastverteilung des Nord-Süd-Datenverkehrs (HTTP2, HTTP/HTTPS, SSL/TLS-Terminierung, TCP/UDP, WebSocket, gRPC), für API-Gateway-Funktionen sowie für zentralisierte Sicherheit und Identitätsverwaltung.
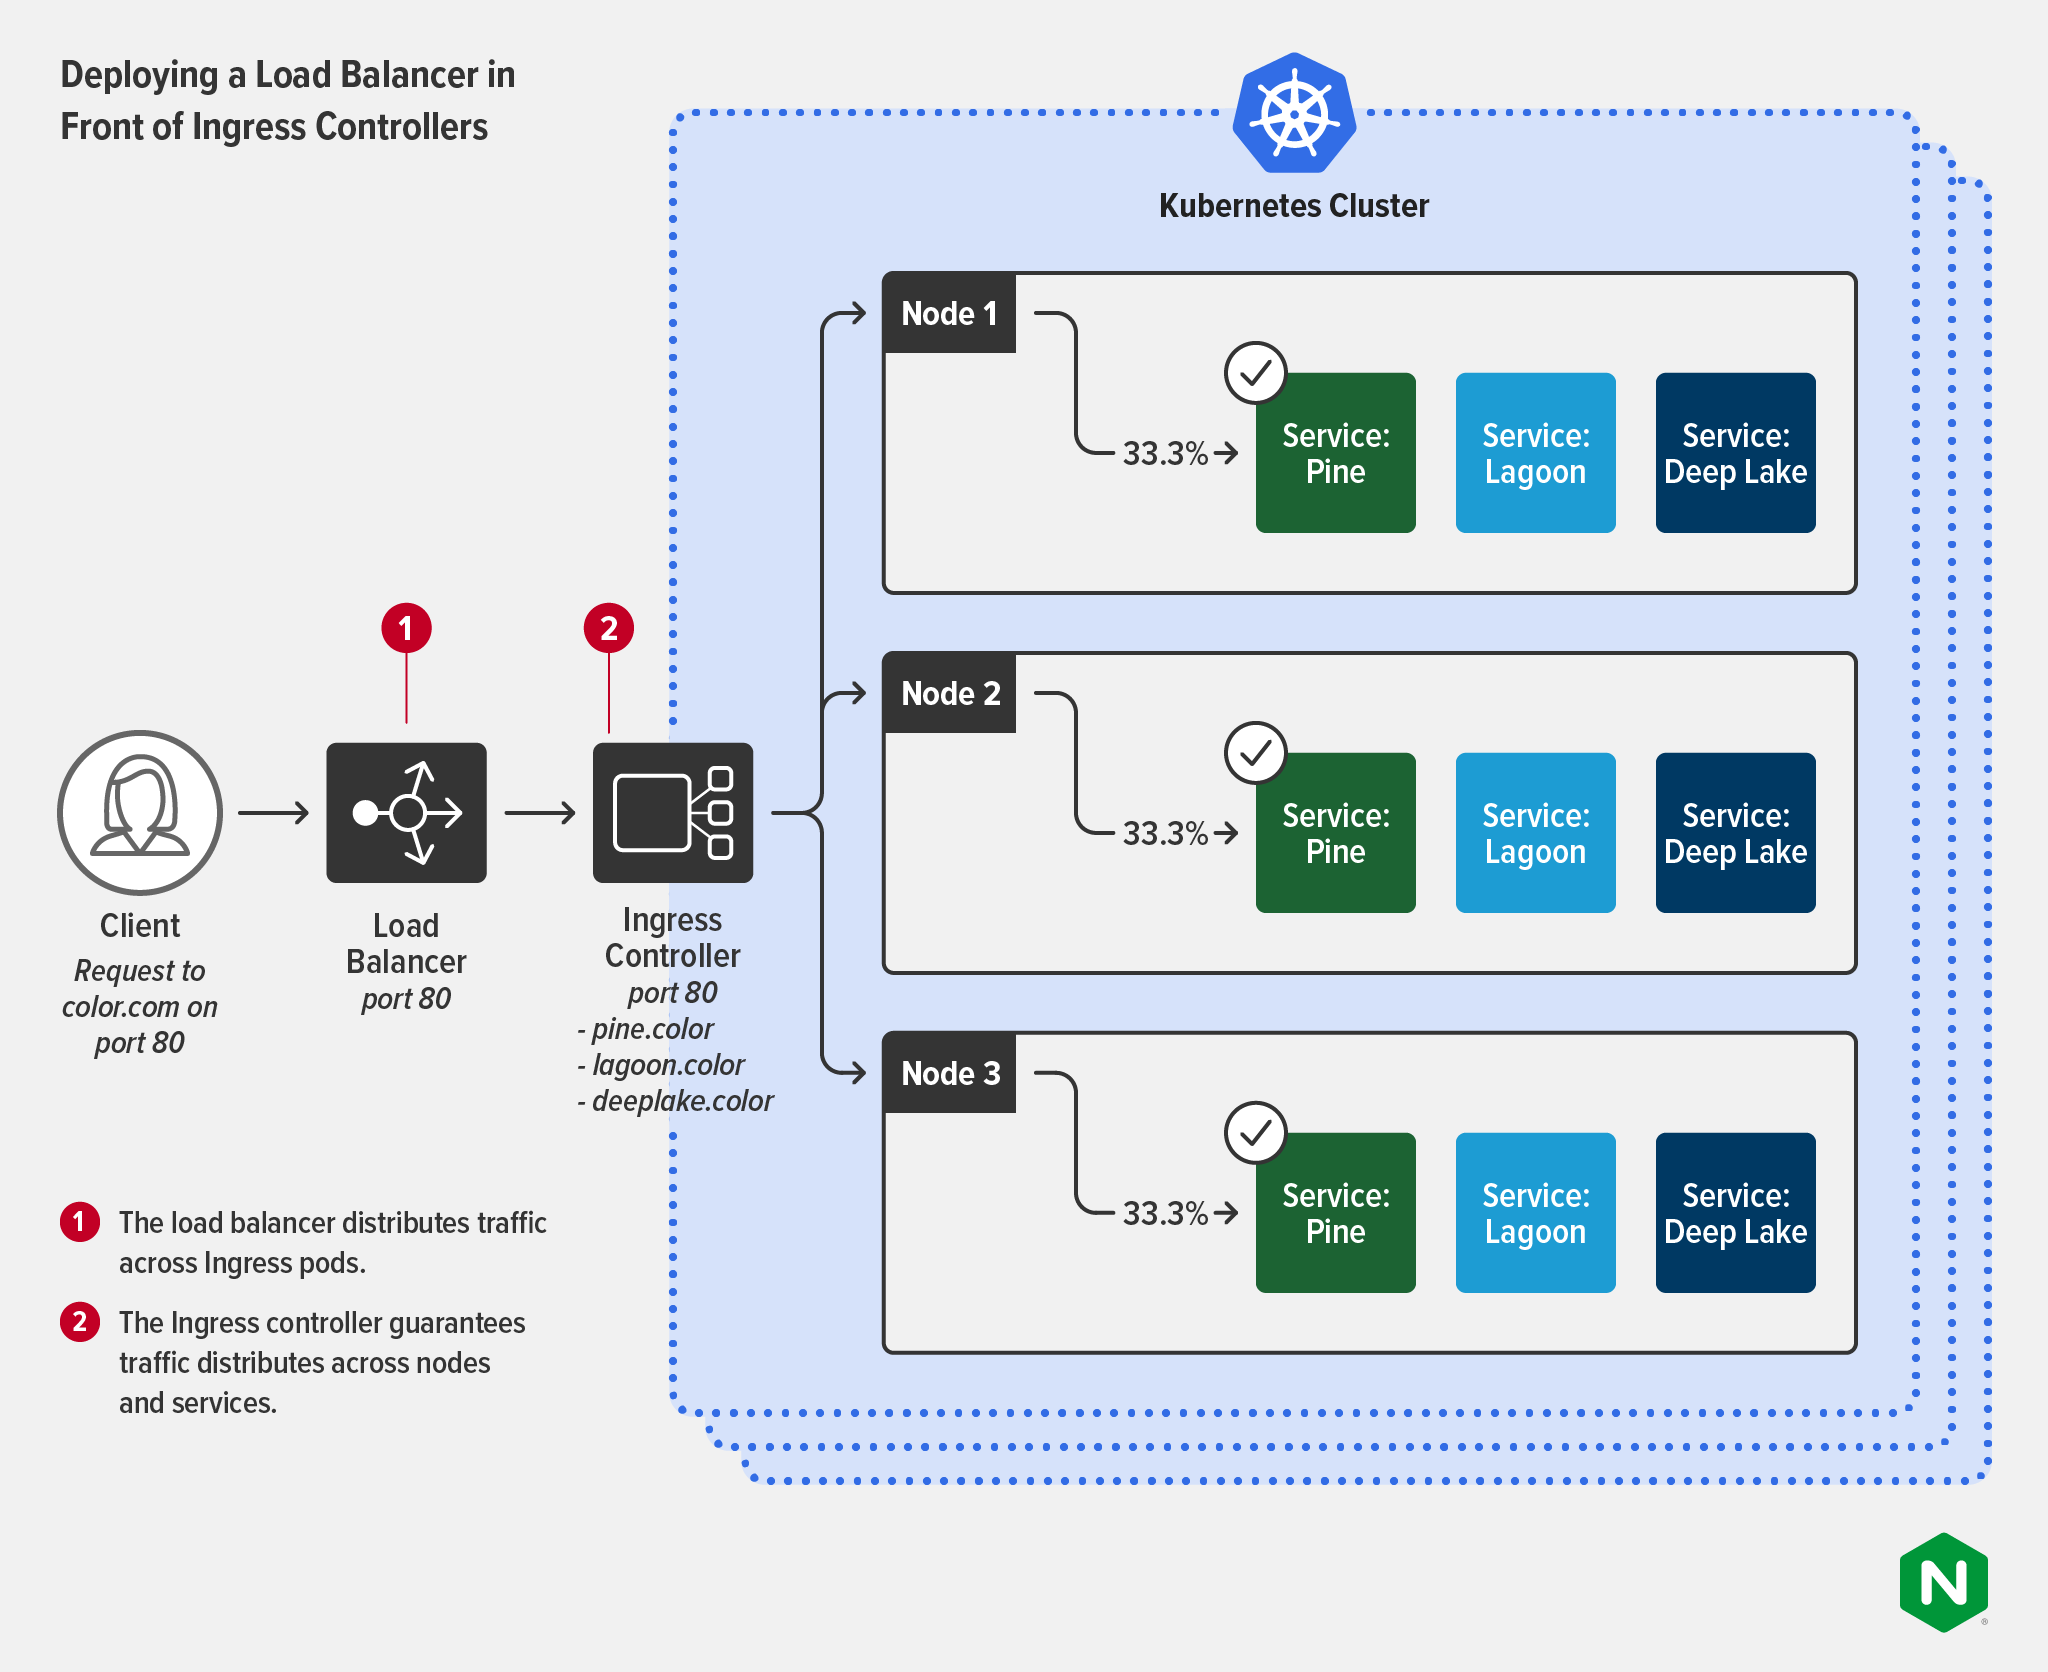
Dieses Diagramm zeigt, wie der Load Balancer den Datenverkehr auf mehrere Cluster verteilt, während die Cluster über Ingress-Controller verfügen, die eine gleichmäßige Verteilung auf die Services gewährleisten.
Nächste Schritte
Wenn Sie all dies gelesen haben und sich immer noch den Kopf zerbrechen, sehen Sie sich das Webinar der Linux Foundation Warum Sie einen Ingress-Controller benötigen und wie Sie den richtigen auswählen an. Darin geben Experten von NGINX eine Einführung in Kubernetes-Netzwerke, beleuchten Ingress-Controller im Detail und erörtern die aktuelle Ingress-Controller-Landschaft.
Weitere Informationen dazu, wie Sie einen Ingress-Controller einsetzen und den für Ihre Anforderungen am besten geeigneten auswählen können, finden Sie in unserem Blogbeitrag „Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen“.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.