Dieser Beitrag basiert auf einem Vortrag von Kevin Reedy von Belly Card auf der nginx.conf im Oktober 2014. Obwohl das bereits einige Jahre zurückliegt, sind die Inhalte auch heute noch äußerst relevant. Eine Aufzeichnung des Vortrags können Sie auf YouTube ansehen.
Inhaltsverzeichnis
0:00 Einführung Überblick Haftungsausschluss1:16 Was ist Belly? Belly-Technologie-Stack1:44 Version 0: Das dunkle Zeitalter2:04 Version 1: Eine neue Hoffnung2:35 Version 2: Separate Startseite und API Schlagwort des Tages: Serviceorientierte Architektur! SOA aktivieren NGINX ersetzt ELB Upstream- und virtuelle Serverkonfiguration Ergebnisse4:43 Konfiguration mit Chef Rezepte Dateien Vorlagen Cookbooks6:49 Beispiel: Chef für NGINX Installation, Konfiguration und Optimierung API-Datenverkehr weiterleiten9:46 Praxisbeispiel für Chef10:08 Version 2: Apps bereitstellen10:40 Version 3: SOA für alles Dann kam Heartbleed SSL für alles12:25 Version 4: Docker Vorteile Container bereitstellen15:45 Bereitstellungsstrategien17:43 Optionen für die Serviceerkennung18:33 Consul-Architektur19:30 Consul-Funktionen22:07 Consul Template Befehl zum Starten von Consul Template NGINX-Konfiguration mit Consul Template Konfigurationsmanagement mit Consul Template24:35 Consul mit Chef bereitstellen25:44 Profi-Tipps Partielle Suche in Chef DNS Veraltete Konfigurationen vermeiden30:35 Fragen36:31 Kontaktinformationen
0:00 Einführung
Guten Morgen allerseits. Mein Name ist Kevin Reedy und ich arbeite für ein Unternehmen namens Belly Card mit Sitz in Chicago. Wir haben etwa hundert Mitarbeiter und zwanzig Ingenieure. Heute werde ich Ihnen erläutern, wie wir unsere Lastverteilung umsetzen, insbesondere in einer sich ständig verändernden, dynamischen Infrastruktur.
0:21 Überblick
Zunächst werde ich Ihnen erläutern, wie sich unser Infrastruktur-Stack im Laufe der Zeit entwickelt hat. Dabei beginne ich mit Version 0, die ich das dunkle Zeitalter nenne. Anschließend sehen wir uns an, wie wir NGINX mit Chef konfigurieren. Danach sprechen wir darüber, wie wir von diesem Ansatz dazu übergegangen sind, NGINX mithilfe von Daten einer sogenannten Service-Discovery-Plattform namens Consul zu konfigurieren. Falls es die Zeit erlaubt, habe ich noch einige Profi-Tipps zur Konfiguration von NGINX, insbesondere im Hinblick auf das Konfigurationsmanagement.
0:49 Haftungsausschluss
Auch wenn ich hier über Chef und Consul sprechen werde, möchte ich vorweg klarstellen, dass nichts in diesem Vortrag speziell auf diese beiden Produkte zugeschnitten ist. Chef, Puppet, Ansible, Salt, CFEngine und all die anderen sind großartige Produkte, und Sie sollten eines davon verwenden. Wir arbeiten gerne mit Chef, und ich bin mir sicher, dass es vielen anderen genauso geht.
Dasselbe gilt für die Service-Erkennung. Consul, etcd und ZooKeeper sind allesamt großartig – verwenden Sie also das, was für Sie am besten funktioniert.
1:16 Was ist Belly?
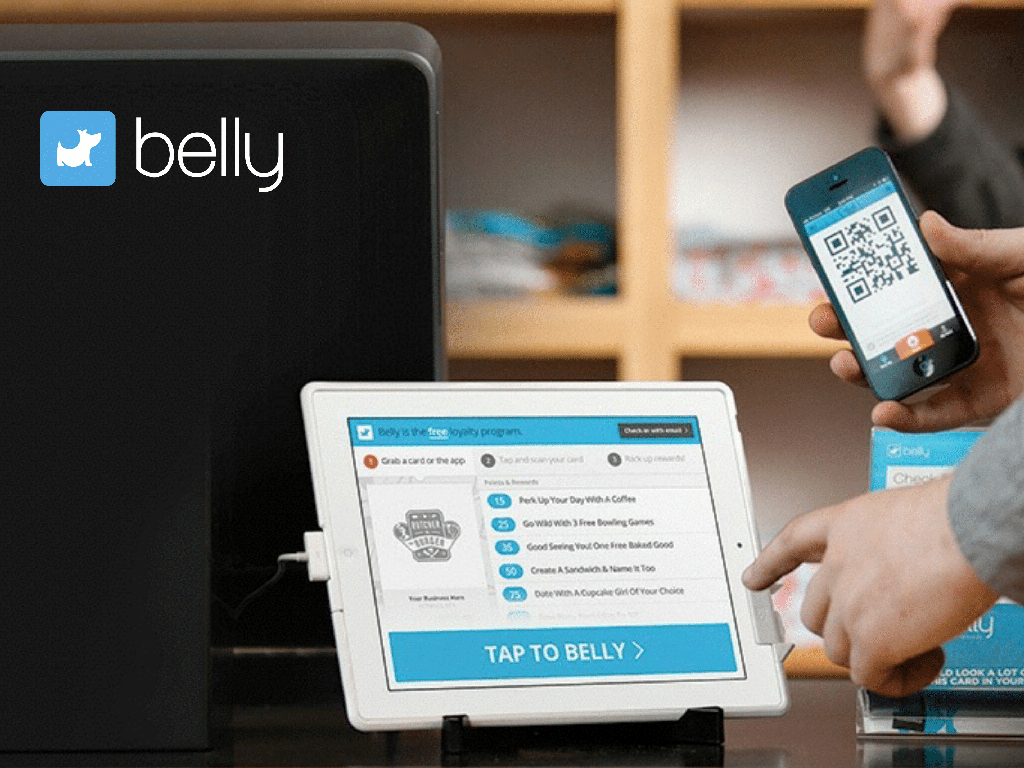
Was ist Belly? Im Grunde ist es der digitale Ersatz für eine Stempelkarte im Café, bei der man nach zehn gekauften Getränken eines gratis bekommt. Wir stellen ein iPad im Geschäft auf, die Kunden scannen mit ihrem Smartphone oder einer physischen Karte mit QR-Code, wir erfassen ihre Punkte, vergeben die Prämien und bauen darauf sogar Marketingtools auf.
1:36 Bellys Technologie-Stack
Aber ich bin nicht hier, um Ihnen etwas über belly als Unternehmen zu erzählen. Wenn Sie sich dafür interessieren, können Sie einfach unsere Website besuchen. Ich werde Ihnen etwas über unseren Infrastruktur-Stack erzählen.
1:44 Version 0: Das dunkle Zeitalter
Also, Version 0. Damals, als es drei Entwickler gab und bevor ich dort arbeitete, war Belly eine monolithische Ruby-on-Rails-Anwendung. Das bedeutete, dass jeder API-Aufruf und jeder Teil unserer Website über eine einzige Rails-App lief. Als Backend kamen MySQL, MongoDB und Memcached zum Einsatz, und wir stellten die Anwendung auf Heroku bereit – eine großartige Plattform für den Einstieg.
2:04 Version 1: Eine neue Hoffnung
Also, Version 1 – Eine neue Hoffnung. Wir kamen zu dem Schluss, dass Heroku unseren Anforderungen nicht mehr gerecht werden würde, und begannen daher mit dem Deployment mithilfe von Capistrano. Das ist im Grunde „besser als ein Shell-Skript“, wurde in Ruby geschrieben und unterstützt bei der Bereitstellung von Anwendungen.
Wir hatten etwa sechs Server auf Amazon Web Services EC2. Diese Anzahl war grundsätzlich fest, aber wenn wir wussten, dass etwas Größeres anstand, erhöhten wir sie und reduzierten sie bei Bedarf wieder. Davor war ein AWS Elastic Load Balancer geschaltet.
2:35 Version 2: Separate Startseite und API
Dann entstand ein Projekt, bei dem wir unsere Startseite vom Rest der API trennen wollten. Dadurch wollten wir die Startseite schneller weiterentwickeln und verschiedene Entwickler daran arbeiten lassen.
2:47 Schlagwort des Tages: Serviceorientierte Architektur!
Das große Schlagwort damals – und auch heute noch – lautet serviceorientierte Architektur.
2:50 SOA implementieren
Version 2 unseres Stacks sollte also eine serviceorientierte Architektur ermöglichen. Unser erster Plan war, die Startseite von der API zu trennen. Das scheint wirklich einfach zu sein – wir haben einfach www.bellycard.com und api.bellycard.com.
Es stellte sich jedoch heraus, dass dies wirklich komplex und alles andere als einfach war, da einige unserer mobilen Anwendungen fest darauf programmiert waren, www.bellycard.com/api und /api‑assets zu verwenden. Unsere E-Mail-Anbieter und alle unsere Klick-Links, die bereits per E-Mail versendet worden waren, verwendeten /eo für „E-Mail geöffnet“ und /ec für „E-Mail angeklickt“. Unsere Facebook-App war für /facebook/callback konfiguriert.
3:28 NGINX ersetzt ELB
Das bedeutete, dass AWS Elastic Load Balancer uns nicht mehr die nötige Flexibilität bot, um diesen Datenverkehr an verschiedene Anwendungen weiterzuleiten. Hier kam NGINX ins Spiel. Konkret konnten wir mehrere Upstreams und Rewrite-Regeln verwenden, um den Datenverkehr an unsere verschiedenen Anwendungen weiterzuleiten.
3:44 Konfiguration von Upstreams und virtuellen Servern
In diesem sehr einfachen Beispiel definieren wir einen upstream-Block mit sechs Servern für die API und einen Block mit zwei Servern für die Startseite.
Außerdem gibt es zwei server-Blöcke [zur Definition virtueller Server]. Auf einem lauschen wir auf api.bellycard.com und leiten den gesamten Datenverkehr an die API-Server weiter. Auf dem anderen lauschen wir auf www.bellycard.com und leiten den Datenverkehr entsprechend weiter.
Ergebnisse um 4:02 Uhr
Das funktionierte hervorragend. Dadurch konnten unsere Entwickler schnell vorankommen. Unser Frontend-Team arbeitete an einem Projekt, ohne von unserer API ausgebremst zu werden. Also stellten wir einen dritten Dienst bereit. Ich glaube, er diente der Integration mit Apples Passbook. Dann folgte ein vierter – wir lagerten unsere gesamte Facebook-Funktionalität aus. Unser fünfter Dienst war für die Verarbeitung von Benutzerereignissen auf unserer Website zuständig.
Dann hielt es jemand für eine großartige Idee, das in Node.js zu schreiben, sodass wir nun fünf verschiedene Services in zwei Sprachen hatten. Sie wurden alle unabhängig voneinander und weitgehend ohne Konfigurationsmanagement bereitgestellt, und wir bearbeiteten NGINX manuell – womit sicher viele Leute anfangen.
4:43 Konfiguration mit Chef
Wir brauchten eine bessere Möglichkeit, diesen Prozess zu skalieren, und setzten dafür Chef ein.
Chef ist eine Suite für das Konfigurationsmanagement. Sie ist in Ruby geschrieben, und Sie können auch Ihr eigentliches Konfigurationsmanagement in Ruby umsetzen, was sie ideal für Entwickler macht. learnchef.com ist eine hervorragende Ressource, um mehr über Chef zu erfahren. Dort können Sie in 45 Minuten viel mehr über Chef lernen, als ich Ihnen vermitteln könnte.
Ich werde dennoch einige der Grundlagen durchgehen, damit wir alle auf demselben Stand sind.
5:17 Rezepte
Die erste Art von Baustein in Chef ist ein Rezept. Chef verwendet viele einfallsreiche Bezeichnungen wie Messer für ein Werkzeug und Rezept, und alles befindet sich in einem Kochbuch. Das macht das Ganze recht unterhaltsam und leicht verständlich und bietet eine großartige Metapher, erschwert es aber auch erheblich, irgendetwas über Google zu finden.
Hier ist also das einfachste Rezept, das mir eingefallen ist. Installiere das Paket nginx und starte und aktiviere den Dienst nginx.
5:56 Dateien
Sie können auch Dateiressourcen verwenden. Beispielsweise möchte ich den Inhalt „Hello World!“ in die Datei /usr/share/NGINX/html/index.html schreiben.
6:08 Vorlagen
Sie können das auch in ein Vorlagensystem integrieren. Hier habe ich die beiden Variablen g und w für Hello und Kevin. Diese Variablen kann ich an eine Vorlagendatei im ERB-Format (einer Ruby-Vorlagensprache) übergeben.
Anstatt den Inhalt einfach manuell auszuschreiben, können wir also eine Vorlage dafür erstellen, was gelesen und wer begrüßt werden soll.
6:19 Kochbücher
Der letzte wichtige Baustein ist ein Cookbook, also eine Sammlung von Rezepten, Dateien und Vorlagen. Hinzu kommen Ressourcen, Provider und Bibliotheken, bei denen es sich um komplexere Ressourcen handelt. Unter https://supermarket.getchef.com finden Sie unzählige Open-Source- und andere Cookbooks, unter anderem für NGINX, MySQL, Java, apt und yum und sogar zur Verwaltung Ihrer ssh_known_hosts-Dateien. Für praktisch alle grundlegenden Aufgaben, die Sie im Konfigurationsmanagement erledigen möchten, gibt es bereits ein Cookbook.
6:49 Beispiel: Chef für NGINX
Wir sehen uns ein kurzes NGINX-Beispiel mit Chef an, in dem wir NGINX installieren und durch Ändern einiger Variablen konfigurieren. Mithilfe von Chef ermitteln wir, wo unsere Anwendung ausgeführt wird, und konfigurieren anschließend NGINX so, dass der Datenverkehr an unsere Anwendung weitergeleitet wird.
7:14 Installation, Konfiguration und Optimierung
In diesem Beispiel legen wir also zunächst einige Knotenattribute fest. Für jeden Knoten können Sie Attributwerte festlegen, indem Sie ein JSON-Dokument anhängen. Wir verwenden ein NGINX-Cookbook eines Drittanbieters, das die Einstellungen dieser Attribute ausliest. Wir setzen worker_connections auf einen bestimmten Wert, legen die Direktive worker_rlimit_nofile fest, bestimmen, welchen event-Typ wir in NGINX verwenden, und konfigurieren sogar client_max_body_size.
Danach binden wir zwei Rezepte aus dem NGINX-Cookbook ein. Das erste ist nginx::repo, das je nach Betriebssystem entweder ein apt- oder ein yum-Repository einrichtet. Anschließend installiert [das nginx-Rezept] NGINX. Sie können NGINX auch aus dem Quellcode installieren, aber die Verwendung von Paketen ist schneller.
Als Nächstes nutzen wir die Suchfunktionen von Chef. Wenn Sie Chef ausführen, können Sie es entweder als Agent auf dem Rechner oder im Solo-Modus ausführen, in dem es im Wesentlichen wie ein Skript abgearbeitet wird. Wenn auf einem Rechner ein Agent ausgeführt wird, können Sie den Chef-Server nach Knoten und anderen Attributen abfragen.
Hier weisen wir Chef an, uns eine Liste aller Knoten auszugeben, denen das Rezept belly‑api zugewiesen ist. Anschließend erstellen wir anhand einer Vorlage eine Site-Datei namens /sites‑enabled/api. Als Quelle dient die Vorlage [mit dem Namen api.erb, die] ich Ihnen als Nächstes zeige. Als Variablen übergeben wir die Knoten, nach denen wir unmittelbar zuvor gesucht haben.
Die letzte Neuerung hier ist eine notifies-Anweisung zum Neuladen des nginx-Dienstes. Sie besagt, dass dieser Dienst jedes Mal neu geladen werden soll, wenn sich diese Vorlage ändert.
8:54 API-Datenverkehr weiterleiten
Unsere Vorlagendatei hier ist also ziemlich einfach. Wir haben einen Upstream namens api und durchlaufen in ERB alle Server, die wir als Variable übergeben. Dabei geben wir den jeweiligen Server anhand seiner IP-Adresse und des Ports 8080 an. Wir fügen sogar einen Kommentar mit dem Servernamen hinzu. Wenn ein Administrator herausfinden möchte, was bei diesem Dienst vor sich geht, ist dieser Kommentar für ihn sehr hilfreich.
Außerdem definieren wir einen server-Block, der auf api.bellycard.com lauscht. Ich leite einfach den gesamten Datenverkehr an den Upstream api weiter.
9:46 Praxisbeispiel für Chef
Ich möchte außerdem ein Beispiel aus der Praxis zeigen. Es ist für Sie vielleicht etwas zu klein, um es lesen zu können, aber Sie bekommen so zumindest einen Eindruck davon, wie komplex Ihre Chef-Rezepte werden können. Dies sind die tatsächliche Vorlage und das Rezept, die heute auf einigen unserer Produktionsserver zum Einsatz kommen.
10:08 Version 2: Apps bereitstellen
Kommen wir nun zurück zu unserem Stack. Ich hatte Ihnen erzählt, dass wir etwa fünf Anwendungen bereitgestellt hatten und dass das hervorragend lief. Nun hatten wir eine Möglichkeit, den Datenverkehr an sie weiterzuleiten. Unsere Entwickler griffen das sofort auf, und heute sind es bereits rund 40 Ruby-Anwendungen, die mithilfe von Chef auf unseren Servern bereitgestellt werden. Der Datenverkehr wird mit NGINX vollständig dynamisch weitergeleitet.
Unsere Entwickler müssen eigentlich nichts weiter tun, als ein einziges Rezept zu bearbeiten und den Namen ihres neuen Dienstes hinzuzufügen. Der gesamte Datenverkehr wird von NGINX weitergeleitet und dynamisch mit Chef konfiguriert.
10:40 Version 3: Alles als SOA
Außerdem hatten wir etwa zehn JavaScript-Frontend-Anwendungen, die lediglich aus statischen Dateien bestanden und die wir auf S3 bereitstellten, mit dem CDN [Amazon] CloudFront davor. Wir stellten index.html aus dem S3-Bucket bereit, während die übrigen Assets über CloudFront ausgeliefert wurden. Darüber hinaus hatten wir noch etwa fünf weitere Apps, die Entwickler einfach auf Heroku bereitgestellt hatten, weil sie ursprünglich als einmalige Projekte gedacht waren, dann aber irgendwann produktiv eingesetzt wurden, ohne dass wirklich jemand darüber informiert worden war.
11:10 Dann kam Heartbleed
[Die fünf Apps auf Heroku] waren voneinander getrennt und befanden sich vollständig außerhalb unserer Infrastruktur – bis zu jenem schönen Tag im April, an dem die Heartbleed-Sicherheitslücke bekannt gegeben wurde. Viele Menschen gerieten in hektische Betriebsamkeit. Heartbleed war eine Sicherheitslücke in OpenSSL, die es Angreifern potenziell ermöglichte, Ihre privaten Schlüssel auszulesen.
Da wir Chef verwenden, konnten wir unsere OpenSSL-Infrastruktur auf all unseren Servern aktualisieren, sobald ein Patch verfügbar war. Ich glaube, er wurde innerhalb von etwa 20 Minuten in unserer gesamten Infrastruktur bereitgestellt. AWS (und damit auch Heroku) benötigte jedoch etwa 24 Stunden, um seine Elastic Load Balancer zu patchen.
Das veranlasste uns dazu, sowohl für S3 als auch für Heroku unser gesamtes Load-Balancing und die SSL-Terminierung zu NGINX zu verlagern, unabhängig davon, wo es bereitgestellt wurde. Das bringt zwar geringfügige Leistungseinbußen mit sich, aber zumindest an jenem Tag im April war es uns das wert.
11:57 SSL für alles
Mit Version 3 unseres Stacks wechselten wir also von „SOA für alles“ zu „SSL für alles“. Unser gesamter Datenverkehr zu bellycard.com und den zugehörigen Subdomains läuft über unsere Load Balancer. Aus Performancegründen werden unsere Assets jedoch weiterhin über CloudFront unter einer anderen Domain bereitgestellt. Wir möchten den zusätzlichen Aufwand durch SSL vermeiden, zumal wir nur ein einziges Rechenzentrum an der Ostküste betreiben.
12:25 Version 4: Docker
Version 4 – das Schlagwort, über das dieses Jahr alle sprechen, ist Docker. Schon als Docker, glaube ich, bei Version 0.5 war, konnten es unsere Entwickler kaum erwarten, damit zu arbeiten.
12:38 Vorteile
Die Gründe [für die Verwendung von Docker] sind einfach.
Es vereinfacht die Bereitstellung von Anwendungen erheblich. Es müssen keine Rezepte geschrieben werden. Sie müssen sich keine Gedanken darüber machen, wie Sie Ihre Assets kompilieren. Es spielt keine Rolle, ob Sie Ihre App in Ruby entwickeln, während jemand anderes seine App in Python schreibt.
Im Wesentlichen trennt es die Verantwortungsbereiche von Entwicklung und Betrieb. Ihre Entwickler können sich um den Code kümmern, darum, welche Bibliotheken verwendet und sogar welche Linux-Pakete installiert werden sollen. Der Betrieb kann sich dagegen mit Fragen befassen wie: Wo soll die Anwendung bereitgestellt werden? Wie erfasse ich ihre Protokolldaten? Wie überwache ich sie? Sobald Sie diese betrieblichen Fragen geklärt haben, funktioniert jede Anwendung – unabhängig davon, in welcher Sprache sie geschrieben wurde.
Ein weiterer Vorteil besteht darin, dass unsere Entwickler abhängige Dienste problemlos auf ihren eigenen Laptops starten können. Wie bereits erwähnt, sind es inzwischen etwa 55 verschiedene Anwendungen, von denen viele mittlerweile in Docker-Containern ausgeführt werden.
Angenommen, Sie arbeiten an einem neuen Dienst zum Versenden von E-Mail-Kampagnen. Dieser ist vom E-Mail-Dienst abhängig. Auf Ihrem Entwicklungsrechner würden Sie also normalerweise den Code herunterladen, bundle install ausführen, den Dienst im Hintergrund starten und dann feststellen: „Oh – aber eigentlich ist dieser wiederum von einem anderen Dienst abhängig, dem Benutzerdienst.“
Dieser Dienst ist wiederum von weiteren Diensten abhängig, die ihrerseits andere Abhängigkeiten haben. Der neue E-Mail-Kampagnendienst ist also tatsächlich von etwa fünf weiteren Diensten sowie von MySQL, Elasticsearch, Redis und vielem mehr abhängig.
Mit Docker können wir diese Container tatsächlich anhand derselben Chef-Rezepte erstellen, die wir auch in der Produktion verwenden, und unseren Entwicklern Container bereitstellen, die sie äußerst schnell herunterladen können.
Dadurch werden Bereitstellung und Entwicklung beschleunigt.
14:23 Container bereitstellen
Mit Version 4 sind wir also von der Bereitstellung unserer Anwendungen mit Chef zur Bereitstellung in Containern übergegangen. Dafür gibt es unzählige Lösungen, und ich bin mir sicher, dass noch viele weitere hinzukommen werden.
Die erste Lösung besteht aus CoreOS und Fleet. CoreOS ist ein schlankes Linux-Betriebssystem, auf dem eine Service-Discovery-Engine namens etcd läuft. Mit Fleet können Sie beispielsweise festlegen: „Ich möchte, dass ein Container fünfmal ausgeführt wird, aber nicht auf denselben Rechnern wie dieser andere Dienst.“
Ein weiteres System namens Deis ähnelt Heroku insofern, als es über eine Git-Push-Schnittstelle verfügt. Daneben gibt es Mesos von Apache und Kubernetes von Google; Flynn ist ein weiteres System, das erst vor Kurzem erschienen ist. Wir haben tatsächlich unser eigenes entwickelt, weil die meisten dieser Tools zu Beginn unserer Reise noch nicht so weit waren, dass wir sie hätten einsetzen können.
Unsere Lösung heißt Jockey und hat sich hervorragend bewährt, weil unser Deployment-Prozess sehr klare Vorgaben macht. Das Tolle an Docker ist, dass es im Wesentlichen eine Reihe einheitlicher APIs für die Containerisierung bereitstellt. Dadurch müssen wir uns um viele Dinge keine Gedanken machen, die uns beschäftigen würden, wenn wir lediglich die LXC-Container von Linux verwenden würden.
Wir planen, den Quellcode offenzulegen, aber wie bereits erwähnt, ist unser Deployment-Prozess sehr stark auf unsere Anforderungen zugeschnitten, und was für uns funktioniert, muss nicht unbedingt auch für Sie funktionieren.
15:45 Bereitstellungsstrategien
Auch unsere Deployment-Strategie änderte sich ein wenig, als wir zu Docker wechselten. Zuvor führten wir Deployments ohne Ausfallzeit durch, indem wir eine neue Version der Anwendung direkt am bestehenden Ort bereitstellten. Wenn dieser Benutzerfaxdienst beispielsweise auf vier Rechnern lief, luden wir die neue Version mit Chef herunter, installierten sie über [der alten Version] und sendeten anschließend ein Signal an den Webserver, damit er sie neu lud. Unicorn ist eine hervorragende Ruby-Engine dafür.
Container sind jedoch unveränderlich. Sobald ein Container ausgeführt wird, sollten Sie für einen neuen Build einen neuen Container erstellen. Sie können sich zwar gewissermaßen mit ihm verbinden, zusätzliche Befehle ausführen und ihn anschließend speichern – ähnlich wie bei Git. Wenn Sie Docker jedoch wirklich optimal nutzen möchten, sollte Ihr Container vollständig unveränderlich sein.
Das bedeutet, dass wir eine neue Bereitstellungsstrategie entwickeln mussten, weil wir nicht mehr direkt in der bestehenden Umgebung bereitstellen können. Dafür gibt es verschiedene Ansätze. Blue-Green-Deployment ist einer der interessanteren. Wenn eine Anwendung beispielsweise auf vier Rechnern läuft, stellt man sie auf vier neuen Rechnern bereit und lässt den Load Balancer den Datenverkehr an diese weiterleiten. Sobald man sich vergewissert hat, dass alles wie erwartet funktioniert, kann man die blaue Umgebung außer Betrieb nehmen, und die grüne wird zur neuen blauen Umgebung. Amazon bietet mit AWS einige wirklich hervorragende Tools dafür.
Außerdem gibt es sogenannte Canary-Deployments, bei denen ich eine Version der neuen Maschine bereitstelle und überwache. Wenn sie die Metrik- und Zustandsprüfungen besteht, kann ich mit dem Deployment fortfahren.
Der Unterschied bei Containern besteht darin, dass sie tatsächlich heruntergefahren und neue gestartet werden. Daher benötigen Sie ein System, das den Standort jeder in Ihrer Infrastruktur ausgeführten Anwendung erfasst.
Chef entwickelt sich tatsächlich zu einer sehr guten Lösung dafür. Derzeit wird ein Cookbook namens Chef Metal integriert, mit dem Sie Container wie jede andere Ressource in Ihrer Chef-Infrastruktur behandeln können.
17:43 Optionen für die Service-Erkennung
Außerdem gibt es die Diensterkennung. ZooKeeper ist ein sehr beliebtes Tool, das im gesamten Hadoop-Ökosystem eingesetzt wird. [Airbnb] bietet ein großartiges Produkt namens SmartStack an, mit dem Sie Bereitstellungen durchführen und diese in ZooKeeper nachverfolgen können.
Ich habe etcd erwähnt, im Wesentlichen einen verteilten Schlüssel-Wert-Speicher mit einer REST-Schnittstelle. Das ist ein großer Vorteil gegenüber ZooKeeper, das eher eine Java-Clientbibliothek ist, denn so können Sie nun aus jeder Ihrer Anwendungen mit etcd kommunizieren. Viele der zuvor erwähnten Open-Source-Platform-as-a-Service-Lösungen – etwa Deis, Flynn und sogar Kubernetes von Google – verwenden etcd. Wenn Sie CoreOS nutzen, ist etcd bereits integriert und sofort verfügbar.
Eine weitere, ebenfalls REST-basierte Lösung ist Consul. Sie wurde von den Leuten bei HashiCorp veröffentlicht, die Vagrant, Packer und jede Menge andere großartige Tools entwickeln. Wir haben uns letztlich für Consul entschieden.
18:33 Consul-Architektur
Hier sehen Sie ein Diagramm, das die grundlegende Funktionsweise von Consul veranschaulicht. Es gibt mehrere Rechenzentren mit jeweils drei Servern. In Rechenzentrum 1 befinden sich außerdem Clients. Interessant ist, dass unter den Server-Agenten ein primärer Agent gewählt wird und alle Clients nicht nur sämtliche Server, sondern auch alle anderen Clients kennen. Anschließend kommunizieren sie über ein Gossip-Protokoll mit allen anderen Agenten.
Das erinnert mich an einen alten Werbespot von AT&T, in dem man es zwei Freunden erzählt, die es wiederum zwei Freunden erzählen, die es dann ebenfalls zwei Freunden erzählen, sodass sich die Botschaft auf diese Weise über das gesamte Netzwerk von Knoten verbreitet. [Anmerkung der Redaktion – Fast: Es war ein Werbespot für Faberge-Organics-Shampoo.] Im Vergleich dazu gibt es bei etcd oder ZooKeeper im Wesentlichen nur Server-Agenten, mit denen sich die Clients verbinden.
Beim Consul-Ansatz würde man tatsächlich auf so gut wie jedem Server einen Consul-Client ausführen – überall dort, wo wir Docker bereitstellen, und überall dort, wo unsere Load Balancer laufen. So kann man diese API jederzeit über localhost auf Port 8500 ansprechen.
19:30 Consul-Funktionen
Genau wie etcd ist [Consul] ein verteilter Schlüssel-Wert-Speicher. Schlüssel können gesetzt und abgerufen werden, wobei die Linearisierbarkeit gewahrt bleibt, sodass sichergestellt ist, dass sie stets konsistent sind. Dabei gibt es einige Fallstricke, doch in der Dokumentation wird hervorragend beschrieben, wo diese Probleme liegen. Anders als etcd behandelt Consul die Diensterkennung jedoch als vollwertige Kernfunktion.
Neben einfachen Schlüssel-Wert-Paaren können Sie auch Dienste registrieren, beispielsweise eine API. Wenn Sie einen Dienst registrieren, teilen Sie Consul mit, auf welchem Knoten er ausgeführt wird. Das bedeutet, dass wir Consul beim Bereitstellen eines Containers auch anweisen, die API dieses Dienstes auf diesem Host zu registrieren.
Darüber hinaus verfügt Consul über verteilte Zustandsprüfungen, sodass Sie nun direkt in Ihrer Service-Discovery-Plattform Zustandsprüfungen nach dem Vorbild von Nagios definieren können. Wenn Sie Consul abfragen, können Sie eine Liste aller Standorte anfordern, an denen der API-Dienst ausgeführt wird. Dabei können Sie ein Flag für „alle“, „nur erfolgreiche“ oder „nur fehlerhafte“ übergeben.
Consul unterstützt außerdem mehrere Rechenzentren. Wie bereits erwähnt, sollten Sie diesen Consul-Client überall ausführen. Beim Start übergeben Sie einen Parameter, der das Rechenzentrum angibt. Wenn Sie beispielsweise ein Rechenzentrum Ost und ein Rechenzentrum West haben, können Sie Ihren lokalen Consul-Client nach einer Adresse oder Ähnlichem abfragen, ohne selbst berücksichtigen zu müssen, in welchem Rechenzentrum Sie sich befinden.
Wir verwenden das Rechenzentrum tatsächlich als Grenze zwischen unseren Staging- und Produktionsumgebungen. In unserer Konfiguration für eine Anwendung in der Staging-Umgebung könnte etwa stehen: „Frag mich, wo MySQL.services.consul zu finden ist.“ Unabhängig davon, ob der Dienst tatsächlich auf einem Staging- oder einem Produktionsknoten ausgeführt wird, erhalten Sie den richtigen Wert, ohne jemals das Rechenzentrum oder mehrere Umgebungen berücksichtigen zu müssen.
Ein weiterer großer Vorteil (auch bei etcd) ist das Long Polling über die HTTP-Schnittstelle. Das bedeutet, dass Sie eine Liste aller Server abfragen können, auf denen dieser Dienst ausgeführt wird, und die Verbindung gleichzeitig 60 Sekunden lang offen halten können, um sofort benachrichtigt zu werden, wenn sich etwas ändert. Die Polling-Dauer kann sogar bis zu 10 Minuten betragen. So können Sie unverzüglich über Änderungen an Ihrer Infrastruktur informiert werden.
Ein weiterer Punkt, den ich bereits erwähnt habe, ist, dass Sie Ihre Agents skalieren können, indem Sie überall Clients einsetzen. Das ist großartig, weil Sie so immer mit localhost kommunizieren können.
Die große Frage ist jedoch: Wie konfiguriere ich NGINX anhand dieser Daten, nachdem sie nun auf einer verteilten Service-Discovery-Plattform vorliegen?
22:07 Consul Template
Zum Glück gibt es ein Tool namens Consul Template. Es wurde tatsächlich erst gestern veröffentlicht, weshalb ich meine Folien für heute ab diesem Punkt ändern musste. Früher hieß es „Consul HAProxy“, was ein schrecklicher Name war, weil es gar nicht speziell auf HAProxy zugeschnitten war.
Consul Template bietet Ihnen eine sehr einfache Schnittstelle, mit der Sie Vorlagen erstellen können, die Änderungen an Diensten, den Zustandsprüfungen dieser Dienste und sogar einem Schlüssel-Wert-Speicher abonnieren. So können Sie Einstellungen wie [die Anzahl der] NGINX-Worker im Schlüssel-Wert-Speicher ablegen und Ihre Konfiguration neu generieren, wenn sich diese ändern.
Die wichtigste Funktion hierbei ist, Dateien aus Vorlagen zu generieren, was dem sehr ähnlich ist, was wir zuvor mit Chef gemacht haben. Der größte Unterschied besteht darin, dass hier die Vorlagensprache von Golang anstelle des auf Ruby basierenden ERB verwendet wird. Nach dem Ändern einer Datei kann optional ein Befehl ausgeführt werden, zum Beispiel service nginx reload.
22:59 Befehl zum Starten von Consul Template
Hier sehen Sie ein Beispiel dafür, wie Consul Template über die Befehlszeile ausgeführt wird. Dabei geben Sie Ihren tatsächlichen Consul-Host an, in diesem Fall consul‑prod.example.com. In einer echten Produktionsumgebung würde ich empfehlen, Consul überall auszuführen und eine Verbindung zu localhost herzustellen.
Dann geben Sie eine Vorlagendatei an, bei der es sich um eine Golang-Vorlage handelt. In unserem Fall geben wir /etc/consul‑templates/api an. Anschließend geben Sie die Datei an, in die die Ausgabe geschrieben werden soll, in unserem Fall also /etc/NGINX/sites‑enabled/api. Danach folgt der auszuführende Befehl: service nginx reload.
23:32 NGINX-Konfiguration mit Consul Template
Das Consul-Template sieht einer Folie, die ich zuvor gezeigt habe, sehr ähnlich, nur dass statt ERB Golang verwendet wird. Wir definieren hier also zwei Upstreams. Einer heißt api, der andere homepage. Für die Service-API verwenden wir eine range-Anweisung, und es gibt integrierte Variablen, mit denen sich die IP-Adresse und der Port abrufen lassen, unter denen der Service tatsächlich ausgeführt wird.
23:54 Konfigurationsmanagement mit Consul Template
Das Tolle an Consul Template und dieser Art der Nutzung ist, dass Änderungen an Diensten schnell übernommen werden. Bevor wir Docker für die Bereitstellung einsetzten, lief Chef je nach Rechner etwa alle 5 oder 10 Minuten. Das war für uns schnell genug, da wir direkt in der bestehenden Umgebung bereitstellten.
Da wir jetzt ein fortschrittlicheres Bereitstellungssystem entwickeln, müssen wir innerhalb von Sekunden statt Minuten über diese Änderungen benachrichtigt werden. Tatsächlich geschieht dies innerhalb von Millisekunden, im Durchschnitt wahrscheinlich nach etwa 200 Millisekunden.
Für die Erstellung von Vorlagen ist jedoch weiterhin ein Konfigurationsmanagement erforderlich. Wir können Chef nicht einfach durch Consul ersetzen. Wir müssen noch klären, wie wir Consul, Consul Template und alles Weitere bereitstellen werden.
24:35 Einsatz von Chef zur Bereitstellung von Consul
Wir verwenden also tatsächlich Chef-Vorlagen, um unsere Consul-Vorlagen bereitzustellen, was etwas umständlich erscheint. In unserem Chef-Rezept fragen wir zunächst unseren Consul-Host nach einer Liste aller Dienste ab. Anschließend erzeugen wir eine Consul-Vorlage [mit den Anweisungen template und source] und übergeben die Speicherorte unseres SSL-Zertifikats und -Schlüssels und laden consul‑template neu. [Redaktion – Herr Reedy bezog sich zunächst auf consul‑haproxy, das in der ersten notifies-Anweisung auf der Folie erscheint. Anschließend korrigierte er sich und stellte klar, dass die Folie aus der Zeit vor der Veröffentlichung von Consul Template stammt.]
Wir schreiben außerdem eine Konfigurationsdatei für Consul Template und übergeben darin [Variablen, die] den Consul-Host, die Quelle, das Ziel und den Befehl zum Neuladen [angeben]. Das ist im Grunde der Kern unseres Zusammenspiels von Chef und Consul, mit dem wir unsere NGINX-Konfigurationen sofort aktualisieren können.
25:44 Profi-Tipps
Als Nächstes habe ich einige Profi-Tipps zu Chef, Consul und zur allgemeinen Konfiguration von NGINX.
25:52 Partielle Suche in Chef
Der erste Tipp: Wenn Sie die Chef-Suche verwenden, um herauszufinden, wo Ihre Dienste ausgeführt werden, sollten Sie sich die partielle Suche von Chef ansehen. Das Problem bei der Chef-Suche ist, dass sie eine Kopie des gesamten Knotens einschließlich aller Attribute erstellt. Wenn Sie viele Daten in den Attributen Ihres Knotens speichern, müssen Sie diese bei der Kommunikation mit Ihrem Chef-Server über das Netzwerk übertragen und außerdem im Arbeitsspeicher vorhalten.
Wenn die Chef-Suche Hunderte oder Tausende von Servern zurückgibt, ist leicht nachvollziehbar, wie der Arbeitsspeicher für das eigentliche Rezept knapp werden kann. Mit der partiellen Suche können Sie nur die Schlüssel zurückgeben, die für Sie relevant sind.
Zum Beispiel hatten wir zunächst
nodes = search(:node, 'recipe:belly-api')Diese Suche gibt sämtliche Informationen zu jedem einzelnen Objekt zurück. Dazu gehören Informationen über dessen Festplattenspeicher, Arbeitsspeicher und CPU sowie über alle Anwendungen, die eigene Knotenattribute geschrieben haben.
Stattdessen können wir die Teilsuche verwenden. Dazu erstellen wir einen neuen Hash namens search_keys und übergeben ihm eine Liste der Schlüssel, die uns interessieren – in diesem Fall nur den Namen und die IP-Adresse. Anschließend rufen wir die sehr ähnliche API namens partial_search auf und übergeben zusätzlich den Parameter [keys].
26:53 DNS
Das zweite Problem, auf das wir bei der Umstellung auf Load-Balancing vor S3 und Heroku stießen, besteht darin, dass NGINX DNS verwendet, um die Hostnamen in den upstream-Blöcken nur beim Neuladen der Konfiguration aufzulösen. Das bedeutet: Wenn Sie einen Upstream-Server auf s3.amazonaws.com oder anything.herokuapp.com festlegen und sich dessen IP-Adresse ändert, erfährt Ihr Load-Balancer erst beim nächsten Neuladen von der neuen IP-Adresse.
Wir haben dieses Problem umgangen, indem wir die DNS-Auflösung in Chef durchführen und anschließend NGINX neu laden, sobald sich das Ergebnis ändert. Das führte zu einem weiteren Problem: [Die Reihenfolge der Adressen in einer DNS-Antwort] ist nicht immer gleich. Sortieren Sie daher die Antwort, bevor Sie sie in Ihre Vorlage schreiben.
27:36 Vermeidung veralteter Konfigurationen
Ein weiteres Problem, wenn man sehr viele Dienste bereitstellt, ist, dass man veraltete Konfigurationen vermeiden möchte. [Redaktion – Herr Reedy unterbricht die Präsentation kurz, um eine Frage aus dem Publikum zu beantworten.] Bei Apache, NGINX und anderen UNIX-Systemen besteht ein gängiges Konfigurationsmuster darin, einen Ordner namens conf.d anzulegen und dann alles daraus zu laden. Wenn ich also die Dienste A, B und C bereitstelle, erstelle ich service-a.conf, service-b.conf und service-c.conf.
Dann beschließe ich, Dienst B durch D zu ersetzen, und nun befinden sich vier Konfigurationen im NGINX-Konfigurationsordner, obwohl Dienst B nicht mehr existiert. Dadurch kann es zu Konflikten zwischen B und D kommen, weil sie einen ähnlichen Hostnamen haben.
In der Vergangenheit haben wir zwei Ansätze verfolgt, um dies zu erreichen [veraltete Konfigurationen zu entfernen]. Bei Vorlagen kann man eine :delete-Funktion hinzufügen, doch das wurde sehr schnell ziemlich unübersichtlich. Im Grunde hatten wir eine Liste alter Dienste, die wir immer zu löschen versuchten, sofern sie vorhanden waren. Das ließ sich nicht wirklich skalieren.
Eine weitere Möglichkeit besteht darin, alle Konfigurationen Ihrer Websites in einer einzigen Datei zusammenzuführen. Viele bezeichnen dies als „Idempotenz nach oben verlagern“. Anstatt also eine NGINX-Konfiguration zu verwenden, die aus mehreren Quellen lädt, packen Sie im Grunde alles in Ihre nginx.conf.
Das macht die Sache zwar etwas unübersichtlich, wenn man sich tatsächlich auf dem Server anmeldet, aber hoffentlich kommen wir allmählich an den Punkt, an dem man eine Konfigurationsdatei nicht mehr direkt im laufenden Produktivbetrieb debuggen muss. Falls es in den Chef-Rezepten immer noch etwas zu unübersichtlich ist, verwenden wir eine einzige nginx.conf-Datei, die eine Reihe verschiedener Site-Konfigurationen lädt. Eine unserer Site-Konfigurationsdateien führt beispielsweise etwa 30 Dienste auf. Daneben haben wir eine für Heroku, eine für alle S3-Dienste usw.
Wenn Sie also alle Ihre Site-Konfigurationen in eine einzige oder eine kleine Anzahl von Dateien schreiben, müssen Sie sich keine Gedanken über das anschließende Aufräumen machen. Wenn ein Dienst aus Sicht von Chef wegfällt, schreibt Chef ihn einfach nicht mehr in die eigentliche Datei.
30:35 Fragen
F: Wie hat sich Consul für Sie bisher bewährt?
A: Wir sind von Consul begeistert. Was mir daran im Vergleich zu Lösungen wie etcd besonders gefällt, ist, dass darauf kontinuierlich weitere Dienste aufgebaut werden. Um die Serviceerkennung muss ich mich nicht kümmern. Wenn Sie beispielsweise ältere Anwendungen haben und Ihre MySQL-Server mit Consul bereitstellen, bietet Consul sogar eine DNS-Schnittstelle.
Ihre Anwendung muss Consul nicht kennen; sie kann einfach abfragen: „Welche Adresse erhalte ich von mysqldb.services.consul?“. In diesem Fall ist Consul der DNS-Server. Sie richten Ihre DNS-Infrastruktur so ein, dass die Anfrage an Consul weitergeleitet wird, wenn die TLD [Top-Level-Domain] auf .consul endet.
Die Skalierung hat bei uns hervorragend funktioniert. In der Produktion betreiben wir etwa 3 Knoten für Server-Agents und rund 60 Clients. Dabei sind bislang keinerlei Probleme aufgetreten. Es kommen laufend neue Funktionen hinzu, ohne dass die Abwärtskompatibilität beeinträchtigt wird. Daher verliefen auch Upgrades bisher immer reibungslos.
F: Verwenden Sie NGINX Plus?
A: Nein. Wir haben uns genau zu diesem Zweck damit beschäftigt, als wir anfingen, mit Consul zu arbeiten. Wenn wir kein Vorlagensystem bräuchten, wäre das großartig, denn dann könnten wir einfach ein Skript verwenden, das auf dieses HTTP-Long-Polling wartet und dann in Ihrem Namen mit der NGINX-API kommuniziert. Das einzige Problem dabei ist, dass Sie wahrscheinlich auch ein Vorlagensystem benötigen, falls NGINX neu gestartet wird. Damit würden Ihre Upstream-Konfigurationen direkt neu geladen.
Andere haben außerdem bereits daran gearbeitet, Consul mithilfe von NGINX Lua direkt abzufragen. Bisher habe ich jedoch noch keine gute Implementierung gesehen, da die Ansätze meist in eine von zwei Kategorien fallen. Beim ersten Ansatz wird Consul bei jeder HTTP-Anfrage abgefragt, was langsam ist. Beim zweiten werden die Daten beim Laden der Konfiguration abgerufen, wodurch letztlich dasselbe Problem wie bei DNS entsteht. Daher ist die Vorlagenlösung vorerst die beste Option. Es würde mich aber nicht überraschen, wenn es künftig eine Möglichkeit gäbe, dies mit NGINX Lua umzusetzen.
F: Würden Sie sich jemals von Chef abwenden?
A: Consul bietet keine wirklich gute integrierte Möglichkeit, diese Vorlagen zu verwalten, und wir stellen NGINX bereits mit Chef bereit. Unsere entsprechenden Rezepte umfassen inzwischen Hunderte, wenn nicht Tausende Zeilen für all die anderen Dinge, die wir mit NGINX umsetzen, darunter Protokollierung, Tracing und einige OAuth-Funktionen. Ich kann mir nicht vorstellen, dass wir Chef aus unserer Infrastruktur entfernen und ersetzen werden, aber Consul ist eine großartige Ergänzung und eine gute Möglichkeit, schnell Benachrichtigungen zu erhalten.
F: Wie viel Overhead verursacht Chef?
A: Da die meisten unserer Maschinen nur eine einzige Aufgabe ausführen, ist der tatsächliche durch Chef verursachte Overhead ziemlich gering. Im Leerlauf ist der RAM-Verbrauch niedrig. Chef wartet in einem Timer und kann einen neuen Prozess abspalten. Andere führen Chef auch über einen cron-Job aus, wenn ihnen die Konvergenzgeschwindigkeit nicht so wichtig ist. Bei einigen unserer aufwendigeren Rezepte beobachten wir einen leichten Anstieg der CPU-Auslastung, aber nichts, was sich nicht durch die Bereitstellung eines weiteren Servers beheben ließe.
F: Wie viel haben Sie bereits mit CloudFormation gearbeitet?
A: Wir verwenden CloudFormation noch nicht. Wir haben es aber auf dem Schirm. Eine Änderung, die wir bereits vorgenommen haben, besteht darin, deutlich mehr Auto-Scaling-Gruppen zu nutzen. Wenn eine Instanz gestartet wird, verfügt sie über Benutzerdaten, die ihre Chef-Ausführungsliste enthalten.
Eine neue Maschine wird einem Cluster mit einem bereits in ihrem Image hinterlegten Schlüssel hinzugefügt. Dadurch kann sie mit unserem Chef-Server kommunizieren, sich registrieren und die benötigten Cookbooks herunterladen. Damit ist für uns der Großteil dessen abgedeckt, wofür CloudFormation zuständig wäre, da wir nicht viele andere AWS-Tools verwenden, die damit Hand in Hand gehen würden.
F: Wie gehen Sie damit um, wenn ein Server zerstört wird?
A: Wenn ein Server in einer Auto-Scaling-Gruppe ausfällt, können Sie sich über Amazon SNS [Simple Notification Service] darüber benachrichtigen lassen. Wir haben einen sehr einfachen Dienst, der auf diese Benachrichtigungen wartet und anschließend den Chef-Server bereinigt.
F: Haben Sie OpsWorks von AWS verwendet?
A: Nein, haben wir nicht. Wir nutzen von Anfang an die gehostete Version von Chef, und sie hat sich für uns hervorragend bewährt. Ich bin mir nicht ganz sicher, aber ich glaube, dass OpsWorks eher wie Chef Solo funktioniert und nur für die Bereitstellung verwendet wird. Wir führen Chef Agent weiterhin auf fast allen unseren Rechnern aus und verwenden dieselben Chef-Rezepte, um Docker-Container für die Entwicklung zu erstellen.
36:31 Kontaktinformationen
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.