NGINX Plus R9 bietet erstmals die Möglichkeit, UDP-Datenverkehr per Reverse-Proxy weiterzuleiten und per Lastenausgleich zu verteilen – eine bedeutende Erweiterung der Layer-4-Lastenausgleichsfunktionen von NGINX Plus.
Dieser Blogbeitrag beleuchtet die Herausforderungen beim Betrieb eines DNS-Servers in einer modernen Anwendungsinfrastruktur und zeigt, wie sowohl NGINX Open Source als auch NGINX Plus den UDP- und TCP-Datenverkehr effektiv und effizient per Load Balancing verteilen können. (Aktive Zustandsprüfungen von Anwendungen sind ausschließlich in NGINX Plus verfügbar, ansonsten gelten die Informationen in diesem Blog jedoch gleichermaßen für NGINX Open Source. Der Kürze halber verwenden wir im weiteren Verlauf des Beitrags nur noch die Bezeichnung NGINX Plus.)
[Redaktion – Einen Überblick über alle neuen Funktionen in NGINX Plus R9 finden Sie unter „Ankündigung von NGINX Plus R9“ in unserem Blog.]
Warum sollte UDP-Datenverkehr lastverteilt werden?
Im Gegensatz zu TCP garantiert UDP konzeptbedingt keine Ende-zu-Ende-Übertragung von Daten. Es ist vergleichbar mit dem Versenden einer Nachricht per Brieftaube: Man weiß zwar mit Sicherheit, dass die Nachricht abgeschickt wurde, kann aber nicht sicher sein, dass sie angekommen ist. Dieser „verbindungslose“ Ansatz bietet mehrere Vorteile – insbesondere eine geringere Latenz als TCP, da die kleineren Einzelnachrichten von UDP weniger Bandbreite beanspruchen und kein Handshake zum Aufbau einer Verbindung erforderlich ist. UDP überlässt es dem Anwendungsentwickler, Zeitüberschreitungen und andere Probleme auf Netzwerkebene zu erkennen. Doch was bedeutet das für DNS?
Wie verschiedene andere UDP-basierte Protokolle verwendet DNS einen Anfrage-Antwort-Datenfluss. Beispielsweise fragt ein DNS-Client die zu einem Hostnamen gehörende IP-Adresse ab und erhält eine Antwort. Trifft innerhalb eines bestimmten Zeitlimits keine Antwort ein, sendet der DNS-Client dieselbe Anfrage an einen „Backup“-DNS-Server. Das Warten bis zum Ablauf des Zeitlimits, bevor eine Anfrage erneut gesendet wird, kann jedoch einen normalerweise äußerst schnellen Vorgang (im Millisekundenbereich) in einen sehr langsamen Vorgang (im Sekundenbereich) verwandeln.
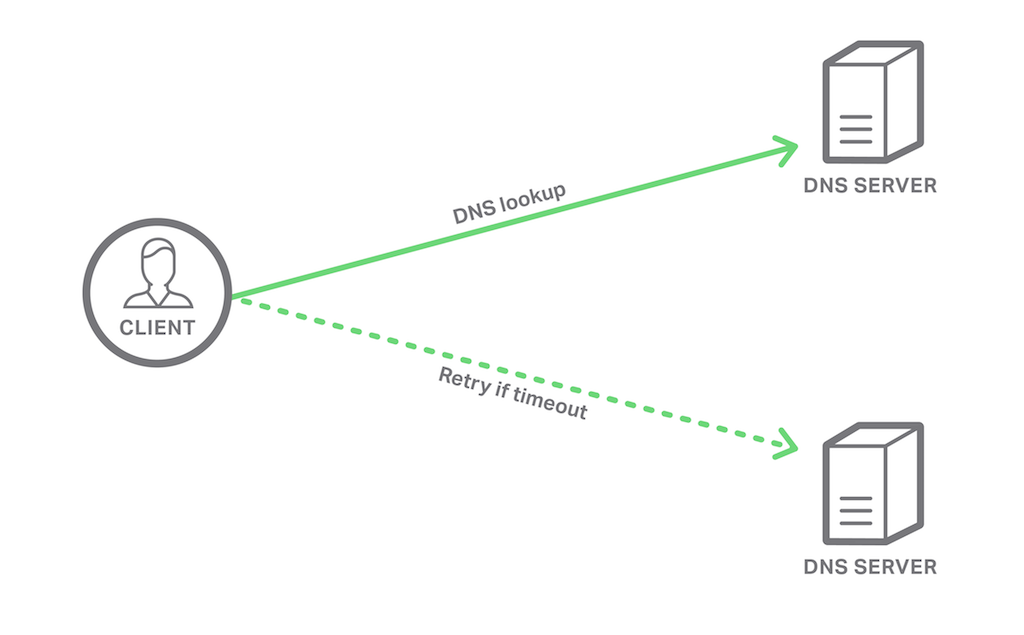
Durch den Einsatz von NGINX Plus als Proxy und zum Lastenausgleich für DNS-Datenverkehr treten bei Clients seltener Zeitüberschreitungen auf. Wenn sich mehrere DNS-Server hinter dem NGINX Plus-Load-Balancer befinden, kommt es für Clients nur dann zu einer Zeitüberschreitung, wenn zwischen dem Client und NGINX Plus eine Netzwerkpartition besteht. Probleme mit den DNS-Servern selbst bleiben für den Client unbemerkt, wenn NGINX Plus Anwendungsintegritätsprüfungen verwendet. Durch die Überwachung der Verfügbarkeit und Antwortzeit jedes Servers verhindert NGINX Plus, dass Clientanfragen an einen fehlerhaften Server gesendet werden.
DNS ist nicht nur ein UDP-Protokoll
Obwohl der überwiegende Teil des DNS-Datenverkehrs über UDP abgewickelt wird, gibt es gängige DNS-Vorgänge, die TCP verwenden. DNS nutzt UDP für kleine Nachrichten (bis zu 512 Byte), TCP hingegen für Vorgänge, die größere Nachrichten erfordern (oder voraussichtlich erfordern werden). In der Vergangenheit wurde TCP bei DNS nur für Zonenübertragungen von einem autoritativen primären Nameserver zu seinen sekundären Nameservern verwendet. Mit der zunehmenden Verbreitung von Containern und unveränderlicher Infrastruktur wird DNS jedoch durch die Verwendung von SRV-Einträgen immer häufiger als primärer Mechanismus zur Diensterkennung eingesetzt.
DNS-SRV-Einträge wurden ursprünglich für Voice-over-IP-Telefone (VoIP) eingeführt, die SIP verwenden, um ihre Server zu finden. Sie können jedoch für jede Art von Dienst verwendet werden. SRV-Einträge enthalten allerdings wesentlich mehr Informationen als die meisten anderen DNS-Eintragstypen. Daher passen nur etwa 10 SRV-Einträge in die standardmäßige UDP-Antwort mit 512 Byte, im Gegensatz zu etwa 30 A-Einträgen. Wenn eine DNS-Antwort die Grenze von 512 Byte überschreitet, werden die ersten 512 Byte zurückgegeben, die Antwort wird jedoch als „abgeschnitten“ gekennzeichnet. Ein DNS-Client kann dann entweder versuchen, die abgeschnittene Antwort bestmöglich zu verarbeiten, oder dieselbe Anfrage erneut über TCP senden.
Das bedeutet, dass NGINX Plus beim Lastenausgleich für DNS-Server in einer modernen Netzwerkinfrastruktur mit einer Mischung aus UDP- und TCP-Datenverkehr rechnen muss.
DNS in einer Microservices-Umgebung
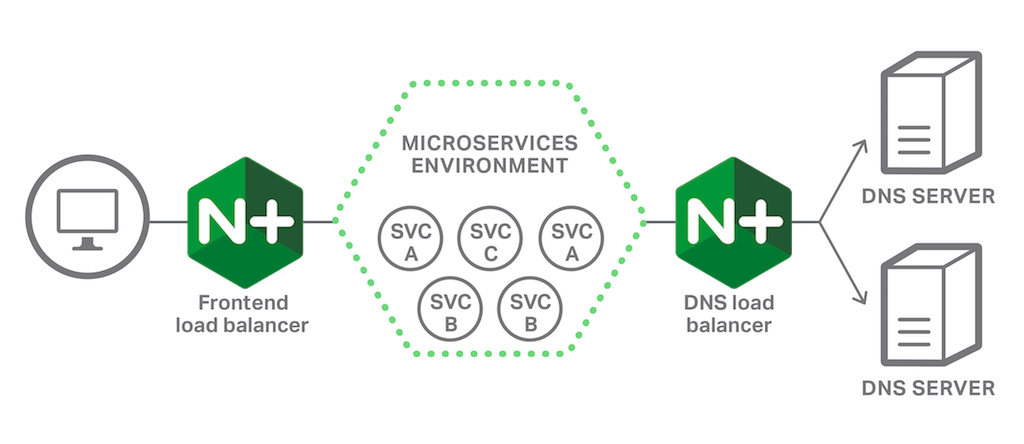
Die folgende Abbildung zeigt eine vereinfachte Darstellung einer Microservices-Umgebung mit zwei Load Balancern. Der Frontend-Load-Balancer leitet Anfragen von den öffentlichen Clients der Anwendung weiter, wählt dabei die am besten geeignete Microservice-Instanz aus und übernimmt viele weitere Funktionen, auf die wir hier nicht näher eingehen. Wir konzentrieren uns auf den DNS-Load-Balancer, der sich zwischen der Microservices-Umgebung und den DNS-Servern befindet, die den Microservices Informationen zur Serviceerkennung bereitstellen.
Grundlegenden DNS-Lastenausgleich konfigurieren
NGINX Plus implementiert den Layer-4-Lastenausgleich im Stream-Modul. Daher wird der UDP- und TCP-Lastenausgleich im stream-Block konfiguriert, wie im folgenden Ausschnitt dargestellt.
Warnung: Sie können dieses Konfigurationsfragment nicht einfach als neue Datei im Verzeichnis /etc/nginx/conf.d hinzufügen. Dies führt zu einem Validierungsfehler („Die stream-Direktive ist hier nicht zulässig“), da die standardmäßige NGINX Plus-Konfigurationsdatei nginx.conf den Inhalt der Dateien im Verzeichnis conf.d in den http-Block einbindet. Die einfachste Lösung besteht darin, den vollständigen stream-Block direkt in die Datei nginx.conf einzufügen.
stream {    upstream dns_servers {
        server 192.168.136.130:53;
        server 192.168.136.131:53;
    }

    server {
        listen 53  udp;
        listen 53; #tcp
        proxy_pass dns_servers;
        error_log  /var/log/nginx/dns.log info;
    }
}
Zunächst definieren wir die Upstream-Gruppe der DNS-Server. Die server-Direktiven geben die Portnummer an, auf der unsere Upstream-Server lauschen: 53 (der allgemein bekannte Port für DNS).
Der server{}-Block definiert, wie NGINX Plus eingehenden DNS-Datenverkehr verarbeitet. Die beiden listen-Direktiven weisen NGINX Plus an, Port 53 sowohl für UDP- als auch für TCP-Datenverkehr zu überwachen. TCP ist das standardmäßige Layer-4-Protokoll für das Stream-Modul. Daher geben wir es im Gegensatz zu UDP nicht explizit als Parameter an.
Die proxy_pass-Direktive weist NGINX Plus an, wie der eingehende Datenverkehr verarbeitet werden soll. Hier leiten wir diesen Datenverkehr per Proxy an die Upstream-Gruppe dns_servers weiter. NGINX Plus verwendet beim Weiterleiten von UDP-Clientanfragen an Upstream-Server automatisch UDP (und TCP bei TCP-Clientanfragen), sodass das Layer-4-Protokoll in der Upstream-Gruppe nicht explizit angegeben werden muss.
Im Stream-Modul gibt es keine access_log-Direktive, da NGINX Plus die Nutzdaten von TCP-Segmenten oder UDP-Datagrammen nicht untersucht (anders als bei HTTP-Paketen). Wir können jedoch den Parameter info der Direktive error_log verwenden, um die Verarbeitung von Verbindungen und Proxy-Ereignisse zu protokollieren.
[Redaktion – Die Zugriffsprotokollierung wurde im Stream-Modul nach der Veröffentlichung dieses Blogbeitrags aktiviert, und zwar in NGINX Open Source 1.11.4 und NGINX Plus R11.]
Optimierung für Hochverfügbarkeit
Um die Verfügbarkeit unserer DNS-Server zu verbessern, können wir einige weitere Direktiven hinzufügen und aktive Zustandsprüfungen auf Anwendungsebene konfigurieren.
Anzahl der Proxy-Antworten und Zeitüberschreitungsdauer konfigurieren
Die erste zusätzliche Direktive lautet „proxy_responses“. Sie gibt an, wie viele Antworten NGINX Plus für jede über den Proxy weitergeleitete UDP-Anfrage erwartet. In unserem Fall wartet NGINX Plus nach dem Empfang einer einzigen Antwort nicht mehr auf weitere Antworten. Dadurch werden der für diese Sitzung verwendete Arbeitsspeicher und Socket freigegeben.
Die zweite zusätzliche Direktive, proxy_timeout, legt fest, wie lange NGINX Plus auf eine Antwort vom Server wartet (hier reduzieren wir den Standardwert von 10 Minuten auf 1 Sekunde). Wenn NGINX Plus innerhalb dieses Zeitraums keine Antwort erhält, versucht es den nächsten Server in der Upstream-Gruppe und markiert den nicht antwortenden Upstream-Server für einen festgelegten Zeitraum (standardmäßig 10 Sekunden) als nicht verfügbar, damit bei anderen Clients während dieser Zeit keine durch eine Zeitüberschreitung verursachte Verzögerung auftritt.
server {    listen 53  udp;
    listen 53; #tcp
    proxy_pass      dns_servers;
    error_log       /var/log/nginx/dns.log info;
    proxy_responses 1;
    proxy_timeout 1s;
}
Wir können auch ändern, wie lange ein Server als nicht verfügbar markiert wird, indem wir die Option fail_timeout in die Direktive server der Upstream-Gruppe aufnehmen. Mit der folgenden Einstellung markiert NGINX Plus ausgefallene Upstream-Server 60 Sekunden lang als nicht verfügbar:
upstream dns_servers {    server 192.168.136.130:53 fail_timeout=60s;
    server 192.168.136.131:53 fail_timeout=60s;
}
Auf diese Weise können wir steuern, wie lange sich die Antwort für einen Client verzögert, wenn einer unserer DNS-Server ausfällt. Wird jedoch eine TCP-Anfrage an einen ausgefallenen DNS-Server gesendet, kann NGINX Plus diesen dank der in TCP integrierten Fehlerprüfung automatisch als nicht verfügbar markieren, sodass nachfolgende TCP- oder UDP-Anfragen nicht mehr an diesen Server gesendet werden.
Aktive Integritätsprüfungen konfigurieren
Die Funktion für aktive Zustandsprüfungen in NGINX Plus ist ein zusätzliches und äußerst wertvolles Werkzeug, um die Hochverfügbarkeit jedes Dienstes mit Lastverteilung sicherzustellen, einschließlich DNS. Anstatt darauf zu warten, dass eine tatsächliche TCP-Anfrage eines DNS-Clients fehlschlägt, bevor der DNS-Server als ausgefallen markiert wird, lassen wir NGINX Plus regelmäßig versuchen, eine TCP-Verbindung über Port 53 herzustellen. So wird geprüft, ob der DNS-Server erreichbar ist und ordnungsgemäß funktioniert. Dazu fügen wir die Direktive health_check mit ihrem Parameter port=53 in den Block server{} ein. (Standardmäßig sendet NGINX Plus Zustandsprüfungen an den Port, der durch die Direktive listen angegeben ist, in unserem Fall Port 53. Hier verwenden wir den Parameter also, um den Standardwert explizit festzulegen. Wir könnten jedoch auch einen anderen Port angeben, wenn wir unsere DNS-Server so konfigurieren würden, dass sie auch auf Datenverkehr an diesem Port reagieren.)
Mit UDP können wir noch einen Schritt weiter gehen und eine aktive Zustandsprüfung konfigurieren, die eine echte DNS-Abfrage nach einem bekannten Eintrag durchführt. Beispielsweise könnten wir den folgenden CNAME-Eintrag in der Zonendatei für dieselbe Subdomain anlegen, die auch für die Diensterkennung innerhalb der Microservices-Umgebung verwendet wird.
healthcheck IN CNAME healthy.svcs.example.com.Da UDP ein schlankes Protokoll ist, können wir den Netzwerkverkehr überwachen und die Bytefolge, die eine DNS-Abfrage darstellt, problemlos extrahieren. Anschließend erstellen wir einen match-Konfigurationsblock und übergeben diese Bytefolge als Parameter an die send-Direktive. Die expect-Direktive gibt die Antwort an, die der Server zurückgeben muss, damit er als fehlerfrei gilt.
match dns_lookup {
    send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...;
    expect ~* "healthy.svcs.example.com.";
}
Der Vorteil dieser umfassenden Zustandsprüfung auf Anwendungsebene besteht darin, dass eine echte DNS-Abfrage für Ihre Produktionsdomain Konfigurationsprobleme und beschädigte Daten aufdeckt, die andernfalls in nachgelagerten Systemen zu Problemen führen könnten – selbst wenn Ihr Nameserver ordnungsgemäß läuft.
Das NGINX Plus-Supportteam kann Sie bei der Einrichtung von UDP-Zustandsprüfungen für DNS-Abfragen und andere Protokolle unterstützen.
Der folgende Ausschnitt hebt die zusätzlichen Direktiven hervor, die für aktive Integritätsprüfungen erforderlich sind.
stream {    upstream dns_servers {
        zone dns_mem 64k;
        server 192.168.136.130:53 fail_timeout=60s;
        server 192.168.136.131:53 fail_timeout=60s;
    }

    match dns_lookup { send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...; expect ~* "healthy.svcs.example.com."; }

    server {
        listen 53  udp;
        listen 53; #tcp
        health_check match=dns_lookup interval=20 fails=2 passes=2 udp;
        health_check interval=20 fails=1 passes=2 port=53; #tcp
        proxy_pass      dns_servers;
        error_log       /var/log/nginx/dns.log debug;
        proxy_responses 1;
        proxy_timeout   1s;

    }
}
Die zone-Direktive definiert eine Shared-Memory-Zone namens dns_mem, die die Ergebnisse der Systemdiagnosen (und andere Statusinformationen) allen NGINX Plus-Worker-Prozessen zur Verfügung stellt.
Die match-Direktive wird direkt darüber erläutert.
Die health_check-Direktive verfügt über eine Reihe von Parametern, die Sie an Ihre Umgebung anpassen können. Hier definieren wir jeweils separate Integritätsprüfungen für UDP und TCP. Aufgrund der Unterschiede zwischen UDP und TCP müssen zwei aufeinanderfolgende UDP-Integritätsprüfungen fehlschlagen, bevor der DNS-Server als fehlerhaft eingestuft wird, bei TCP genügt hingegen ein einziger Fehlschlag. Bei beiden Protokollen sind zwei erfolgreiche Antworten erforderlich, bevor ein Server wieder als fehlerfrei eingestuft wird. So wird vermieden, dass Anfragen an einen instabilen Server gesendet werden, dessen Status ständig wechselt.
Ein Vorteil der Definition einer einzigen Upstream-Gruppe von DNS-Servern für UDP- und TCP-Datenverkehr besteht darin, dass der Server bei einer fehlgeschlagenen Integritätsprüfung für eines der beiden Protokolle als fehlerhaft markiert und aus dem Pool für den Lastenausgleich entfernt wird.
Optimierung für Skalierbarkeit
Obwohl bereits der Einsatz von nur zwei Backend-Servern eine effektive Hochverfügbarkeitslösung darstellen kann, ermöglichen Ihnen die Lastverteilungsfunktionen von NGINX Plus, Backend-Server horizontal zu skalieren, ohne dass der Client davon Kenntnis hat.
Die oben beschriebene Beispielumgebung mit Microservices erfordert wahrscheinlich keine Skalierung der Backend-DNS-Server. Ein Internetdienstanbieter, der all seinen Kunden DNS-Dienste bereitstellt, ist jedoch einer konstanten Last und potenziell enormen Lastspitzen ausgesetzt. Daher benötigt er eine große Anzahl von DNS-Servern sowie einen Frontend-Proxy, der den Datenverkehr per Lastverteilung auf diese Server verteilt.
Alle Lastverteilungsalgorithmen von NGINX und NGINX Plus sind sowohl für TCP und UDP als auch für HTTP verfügbar:
- Round Robin (Standardeinstellung)
- Generischer Hash und seine konsistente Variante (Ketama-Algorithmus)
- IP-Hash
- Wenigste Verbindungen
- Kürzeste Zeit (nur NGINX Plus)
(Sie können außerdem für alle Algorithmen Gewichtungen konfigurieren, um deren Effizienz noch weiter zu steigern. Weitere Informationen finden Sie im Abschnitt über Gewichtungen im Beitrag „Auswahl einer Lastverteilungsmethode für NGINX Plus“ in unserem Blog.)
Während HTTP-Anfragen hinsichtlich der Last und der Verarbeitungsanforderungen, die sie an die Backend-Server stellen, stark variieren können, erzeugen DNS-Anfragen in der Regel alle die gleiche Last. Aus diesem Grund bieten die Algorithmen Least Connections und Least Time gegenüber Round Robin wahrscheinlich keinen Vorteil. Insbesondere berücksichtigt Least Connections bei der Anzahl der Verbindungen alle UDP-Anfragen, für die NGINX Plus noch auf eine Antwort vom Upstream-Server wartet. Solange die Werte für proxy_responses und proxy_timeout noch nicht erreicht wurden, zählt NGINX Plus weiterhin Verbindungen für Upstream-Server, die ihre Arbeit möglicherweise bereits abgeschlossen haben.
Wenn Sie eine große Anzahl von Clients und ein Protokoll haben, bei dem viel „Dialog“ stattfindet – also mehrere Nachrichten zwischen Client und Server ausgetauscht werden, wie beim Challenge-Response-Ablauf von RADIUS –, ermöglicht die Verwendung eines Quell-IP-Hashs, dass dieser Dialog mit einem einzigen Backend-Server stattfindet. Mit anderen Worten: Dadurch wird Sitzungspersistenz hergestellt, sodass NGINX Plus alle Anfragen eines bestimmten Clients an denselben Server weiterleitet. Das folgende Beispiel konfiguriert den Hash-Load-Balancing-Algorithmus für zwei RADIUS-Authentifizierungsserver, wobei die Quell-IP-Adresse (Client-IP-Adresse), die von der Variable $remote_addr erfasst wird, als Schlüssel dient.
upstream radius_servers {    hash $remote_addr; # Source-IP hash
    server 192.168.136.201:1812;
    server 192.168.136.202:1812;
}
Weitere Informationen
Weitere Informationen zum UDP- und TCP-Load-Balancing finden Sie in den folgenden Ressourcen:
- TCP- und UDP-Lastverteilung im NGINX Plus-Administratorhandbuch
- NGINX-Stream-Modul und
upstream-Konfigurationskontext - Bereitstellungsleitfaden für den Lastenausgleich von Microsoft® Exchange™-Servern, die sowohl TCP- als auch HTTP-basierten Datenverkehr verarbeiten müssen
- MySQL-Hochverfügbarkeit mit NGINX Plus und Galera Cluster<.htmla> (Anwendungsfall für TCP-Lastverteilung)
Weitere Informationen zu den anderen großartigen Funktionen in NGINX Plus R9 finden Sie in unserem Blogbeitrag „Ankündigung von NGINX Plus R9“. Sehen Sie sich außerdem unser On-Demand-Webinar „Neuerungen in NGINX Plus R9“ an.
Wenn Sie NGINX Plus ausprobieren möchten, starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.