Anmerkung des Autors – Dieser Blogbeitrag ist der sechste in einer Reihe:
- Einführung in die Microservices-Referenzarchitektur von NGINX
- MRA, Teil 2: Das Proxy-Modell
- MRA, Teil 3: Das Router-Mesh-Modell
- MRA, Teil 4: Das Fabric-Modell
- MRA, Teil 5: Anpassung der Twelve-Factor App für Microservices
- MRA, Teil 6: Implementierung des Circuit-Breaker-Musters mit NGINX Plus (dieser Beitrag)
Alle sechs Blogbeiträge sowie ein Blogbeitrag über Web-Frontends für Microservices-Anwendungen<.htmla> wurden in einem kostenlosen E-Book zusammengefasst.
Sehen Sie sich auch diese weiteren NGINX-Ressourcen zum Thema Microservices an:
- Eine sehr hilfreiche und beliebte Artikelreihe von Chris Richardson über die Entwicklung von Microservices-Anwendungen
- Die Artikel von Chris Richardson, zusammengefasst in einem kostenlosen E-Book, mit zusätzlichen Tipps zur Implementierung von Microservices mit NGINX und NGINX Plus
- Weitere Blogbeiträge zu Microservices
- Microservices-Webinare
Das Anwendungsdesign mit Microservices hat die Funktionsweise von Anwendungen grundlegend verändert. In einer Microservices-Architektur ist eine „Anwendung“ heute eine Sammlung von Diensten, die bei der Ausführung von Aufgaben und der Bereitstellung von Funktionen voneinander abhängig sind. Bei komplexen Anwendungen kann der Dienstgraph sehr tief sein und zahlreiche wechselseitige Abhängigkeiten zwischen den verschiedenen Diensten aufweisen.
Beispielsweise kann ein Benutzerdienst für viele andere Dienste, die auf die von ihm bereitgestellten Daten angewiesen sind, von zentraler Bedeutung sein. In diesem Fall könnte ein Ausfall des Benutzerdienstes eine Kaskade von Ausfällen in der gesamten Anwendung auslösen.
Das Circuit-Breaker-Muster – ein von Martin Fowler geprägter Begriff – findet unter Microservices-Architekten als Anwendungsentwurfsmuster zur Vermeidung kaskadierender Dienstausfälle zunehmend Verbreitung. Die Idee des Circuit-Breaker-Musters besteht darin, Ihre Anwendungsdienste und den Datenverkehr zwischen ihnen zu überwachen, um Ausfälle zu verhindern und – falls es doch zu Ausfällen kommt – deren Auswirkungen auf Ihre Anwendungen zu minimieren.
Für Microservices ist das Circuit-Breaker-Muster besonders wertvoll, da es Resilienz von Grund auf ermöglicht. Bei korrekter Implementierung kann es dazu beitragen, kaskadierende Ausfälle zu vermeiden, indem es die Dienstkontinuität selbst dann gewährleistet, wenn Dienste nicht verfügbar sind. Das Circuit-Breaker-Muster wurde insbesondere von Netflix bekannt gemacht und ist ein zentraler Bestandteil der dortigen Philosophie für das Anwendungsdesign.
Vermeiden Sie Fehler nicht, sondern akzeptieren Sie sie
Ein zentraler Grundsatz des modernen Anwendungsdesigns lautet, dass Fehler unvermeidlich sind. Der vielschichtige Technologie-Stack, auf den moderne Anwendungen angewiesen sind – von in der Cloud gehosteten virtuellen Maschinen über Container und Anwendungsbibliotheken bis hin zu dynamischen Netzwerken – führt dazu, dass jede Anwendung aus unzähligen beweglichen Teilen besteht. Sie müssen davon ausgehen, dass eine oder mehrere Komponenten Ihrer Anwendung irgendwann auf irgendeine Weise ausfallen werden. Wenn Sie mit Fehlern rechnen und Mechanismen vorsehen, um deren Auswirkungen abzumildern, trägt dies wesentlich dazu bei, Ihre Anwendung widerstandsfähiger zu machen.
Eines der wichtigsten Ziele des Circuit-Breaker-Musters besteht darin, Ausfälle von vornherein zu verhindern. Bei bestimmten Fehlerzuständen, etwa wenn der Arbeitsspeicher knapp wird, lässt sich erkennen, dass ein Ausfall unmittelbar bevorsteht, sodass entsprechende Gegenmaßnahmen ergriffen werden können. In der Regel signalisiert der Dienst dazu, dass er nicht ordnungsgemäß funktioniert. Der Circuit Breaker gibt ihm daraufhin die Möglichkeit, sich zu erholen, indem er die Anzahl der Anfragen drosselt oder sie vollständig umleitet. Sobald sich der Dienst erholt hat, sollte der Circuit Breaker die Anzahl der an ihn gerichteten Anfragen außerdem schrittweise erhöhen, damit er nicht sofort überlastet wird und erneut in einen fehlerhaften Zustand gerät.
In der NGINX-Referenzarchitektur für Microservices gibt es einen Dienst namens Resizer. Wenn ein großes Foto in das System hochgeladen wird, dekomprimiert der Resizer es, korrigiert seine Ausrichtung, verkleinert es und verkleinert es anschließend erneut. Dabei speichert er das korrigierte Originalbild und die beiden verkleinerten Bilder in einem Objektspeicher. Aufgrund dieser Prozesse ist der Resizer der rechen- und speicherintensivste Teil der Anwendung.
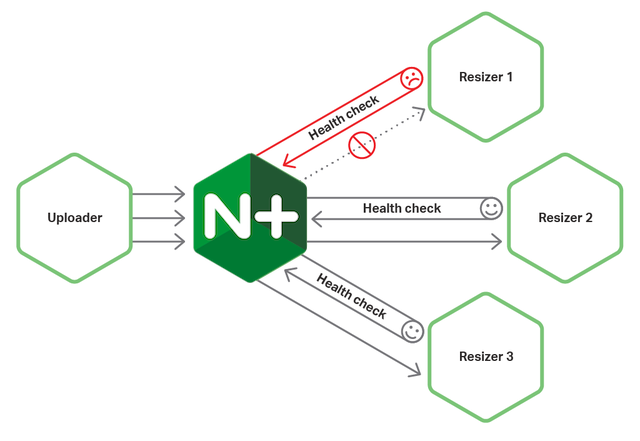
Wenn viele Bilder gleichzeitig skaliert werden, kann dem Resizer der Arbeitsspeicher ausgehen, sodass er unter Umständen vollständig ausfällt. Um Probleme zu vermeiden, schalten wir einen Circuit Breaker zwischen die Instanzen des Resizer-Dienstes und den Uploader-Dienst, der sie mit Bildern versorgt. Der Uploader fragt regelmäßig den Integritätsstatus der Resizer-Instanzen ab. Diese Abfrage veranlasst den Resizer unter anderem zu prüfen, ob er mehr als 80 % des verfügbaren Arbeitsspeichers belegt hat, und seinen Integritätsstatus an den Uploader zurückzumelden.
Wenn eine Instanz des Resizers meldet, dass sie nicht ordnungsgemäß funktioniert, leitet der Uploader Anfragen an andere Instanzen weiter – wie in Abbildung 1 dargestellt –, prüft jedoch weiterhin, ob sich die betreffende Resizer-Instanz wieder erholt hat. Sobald die Resizer-Instanz meldet, dass sie wieder ordnungsgemäß funktioniert, wird sie erneut in den Pool mit Lastenausgleich aufgenommen, und der Uploader erhöht den Datenverkehr zu dieser Instanz schrittweise bis zu ihrer vollen Kapazität. Dieses Design verhindert, dass Resizer-Instanzen vollständig ausfallen, dass Aufgaben begonnen, aber nicht abgeschlossen werden und dass Benutzer, deren Prozesse andernfalls fehlgeschlagen wären, übermäßig lange warten müssen. Außerdem hilft es dem System, den eingehenden Anfragestrom möglichst effizient zu verarbeiten.
Das Circuit-Breaker-Muster verbessert die Konsistenz
Einer der Vorteile der Implementierung des Circuit Breakers auf NGINX-Ebene besteht darin, dass dadurch eine universelle, einheitliche und äußerst flexible Schicht für die Verwaltung von Circuit Breakern in Ihrer gesamten Microservices-Anwendung entsteht. Dank dieser Universalität und Einheitlichkeit müssen Sie sich nicht mit den Besonderheiten und Inkonsistenzen der Circuit-Breaker-Bibliotheken für die einzelnen Sprachen auseinandersetzen und Ihre Anwendung nicht darauf abstimmen.
Es bietet viele Vorteile, den Großteil der Circuit-Breaker-Funktionalität aus dem Code der einzelnen Services herauszuhalten und stattdessen in NGINX Plus zu implementieren:
- Der Circuit Breaker für einen beispielsweise in Java geschriebenen Service ist derselbe wie für einen in PHP geschriebenen Service – und der Circuit Breaker selbst kann bei Bedarf in einer weiteren Sprache geschrieben werden.
- Sie vermeiden es, die Circuit-Breaker-Funktionalität für die verschiedenen Sprachen und unterstützenden Bibliotheken, die Ihre einzelnen Services verwenden, jeweils neu implementieren zu müssen.
- Jeder Dienst, der den Code für den Schutzschalter nicht enthalten muss, wird dadurch vereinfacht. Er läuft schneller und lässt sich leichter entwickeln, debuggen, ausführen und warten.
- Der unterstützende Code für jeden Dienst wird vereinfacht; die verwendeten Bibliotheken und Systeme können sich ausschließlich an der Kernfunktionalität des Dienstes orientieren.
- Der Code für den Leistungsschalter wird vereinfacht; da er nur an einer Stelle vorhanden ist, kann er auf das Wesentliche reduziert werden, ohne lokale Gegebenheiten berücksichtigen zu müssen
- Der Code des Leistungsschalters kann Funktionen von NGINX Plus wie Caching nutzen und wird dadurch wesentlich leistungsfähiger
- Sie können Ihren Circuit-Breaker-Code auf NGINX Plus-Ebene optimieren und ihn anschließend in anderen Anwendungen sowie plattformübergreifend wiederverwenden – beispielsweise lokal, auf verschiedenen Cloud-Plattformen und in hybriden Umgebungen.
Es ist jedoch wichtig zu beachten, dass Circuit Breaker nicht allein mit NGINX Plus implementiert werden können. Ein echter Circuit Breaker setzt voraus, dass der Dienst unter einem festgelegten URI (in der Regel /health) einen introspektiven, aktiven Health Check bereitstellt. Der Health Check muss auf die Anforderungen des jeweiligen Dienstes abgestimmt sein.
Bei der Entwicklung der Zustandsprüfung müssen Sie das Ausfallprofil des Dienstes und die Arten von Bedingungen verstehen, die zu einem Ausfall führen können, beispielsweise eine fehlgeschlagene Datenbankverbindung, unzureichender Arbeitsspeicher, unzureichender Festplattenspeicher oder eine überlastete CPU. Diese Bedingungen werden im Rahmen der Zustandsprüfung ausgewertet, die anschließend den binären Status „fehlerfrei“ oder „fehlerhaft“ zurückgibt.
Das Circuit-Breaker-Muster bietet Flexibilität
Wenn Sie das Circuit-Breaker-Muster wie hier beschrieben auf NGINX-Ebene implementieren, übernimmt NGINX Plus die Behandlung der Situation, wenn eine Serviceinstanz meldet, dass sie nicht ordnungsgemäß funktioniert. Dafür gibt es mehrere Möglichkeiten.
Die erste Möglichkeit besteht darin, Anfragen an andere, fehlerfrei funktionierende Instanzen weiterzuleiten und die fehlerhafte Instanz weiterhin abzufragen, um festzustellen, ob sie sich wieder erholt. Die zweite Möglichkeit besteht darin, Clients, die den Dienst anfordern, zwischengespeicherte Antworten bereitzustellen und so die Stabilität auch dann zu gewährleisten, wenn der Dienst nicht verfügbar ist. Diese Lösung eignet sich gut für leseorientierte Dienste, beispielsweise einen Inhaltsdienst.
Eine weitere Möglichkeit besteht darin, alternative Datenquellen bereitzustellen. Einer unserer Kunden betreibt beispielsweise einen personalisierten Ad-Server, der anhand von Profildaten zielgerichtete Werbung für seine Nutzer ausliefert. Fällt der personalisierte Ad-Server aus, wird die Nutzeranfrage an einen Backup-Server weitergeleitet, der eine allgemeine, für alle geeignete Auswahl an Werbeanzeigen bereitstellt. Dieser Ansatz mit alternativen Datenquellen kann äußerst wirkungsvoll sein.
Wenn Sie das Ausfallprofil eines Dienstes sehr genau kennen, können Sie schließlich Ausfälle abmildern, indem Sie den Circuit Breaker um eine Ratenbegrenzung ergänzen. Anfragen werden nur mit einer Rate an den Dienst weitergeleitet, die er bewältigen kann. Dadurch entsteht innerhalb des Circuit Breakers ein Puffer, der Lastspitzen abfangen kann.
Die Ratenbegrenzung kann in einem zentralisierten Lastverteilungsszenario wie dem Router-Mesh-Modell besonders wirkungsvoll sein, bei dem der Anwendungsdatenverkehr über eine begrenzte Anzahl von Load-Balancern geleitet wird, die einen guten Überblick über das gesamte Datenverkehrsaufkommen der Website haben.
Implementierung des Circuit-Breaker-Musters in NGINX Plus
Wie oben beschrieben, kann das Circuit-Breaker-Muster einen Ausfall verhindern, bevor er eintritt, indem der Datenverkehr zu einem fehlerhaften Dienst reduziert oder von diesem weggeleitet wird. Hierfür ist eine aktive Zustandsprüfung erforderlich, die mit einer introspektiven Zustandsüberwachung für jeden Dienst verbunden ist. Eine passive Zustandsprüfung reicht leider nicht aus, da sie lediglich prüft, ob bereits ein Ausfall vorliegt – und dann ist es für vorbeugende Maßnahmen bereits zu spät. Aus diesem Grund kann NGINX Open Source das Circuit-Breaker-Muster nicht implementieren – es unterstützt ausschließlich passive Zustandsprüfungen.
NGINX Plus verfügt hingegen über ein robustes System für aktive Zustandsprüfungen mit zahlreichen Optionen zur Erkennung von und Reaktion auf Zustandsprobleme. Die Implementierung einiger Diensttypen der Referenzarchitektur für Microservices veranschaulicht anschaulich die Optionen und Anwendungsfälle für die Umsetzung des Circuit Breakers.
Beginnen wir mit dem Uploader-Dienst, der eine Verbindung zum Resizer herstellt. Der Uploader legt Bilder in einem Objektspeicher ab und weist anschließend den Resizer an, ein Bild zu öffnen, zu korrigieren und seine Größe zu ändern. Dieser Vorgang ist rechen- und speicherintensiv. Der Uploader muss den Zustand des Resizers überwachen und eine Überlastung vermeiden, da der Resizer den Host, auf dem er ausgeführt wird, buchstäblich zum Absturz bringen kann.
Als Erstes muss ein location-Block speziell für die Zustandsprüfung des Resizers erstellt werden. Dieser Block ist eine internal-Location, was bedeutet, dass nicht über eine Anfrage an die Standard-URL des Servers (http://example.com/health-check-resizer) darauf zugegriffen werden kann. Stattdessen dient er als Platzhalter für die Informationen zur Zustandsprüfung. Die Direktive health_check sendet alle drei Sekunden eine Zustandsprüfung an den URI /health und verwendet die im match-Block namens conditions definierten Tests, um den Zustand der Dienstinstanz zu überprüfen. Eine Dienstinstanz wird als fehlerhaft markiert, sobald eine einzige Prüfung fehlschlägt. Die proxy_*-Direktiven senden die Zustandsprüfung an die Upstream-Gruppe resizer. Dabei wird TLS 1.2 über HTTP 1.1 verwendet, und die angegebenen HTTP-Header werden auf null gesetzt.
location /health-check-resizer {    internal;
    health_check uri=/health match=conditions fails=1 interval=3s;


    proxy_pass                        https://resizer;
    proxy_ssl_session_reuse           on;
    proxy_ssl_protocols               TLSv1.2;
    proxy_http_version                1.1;
    proxy_set_header Connection       "";
    proxy_set_header Accept-Encoding  "";
}
Im nächsten Schritt wird der conditions-match-Block erstellt, um die Antworten festzulegen, die einen fehlerfreien bzw. fehlerhaften Zustand darstellen. Zunächst wird der Statuscode der Antwort geprüft: Liegt er im Bereich von 200 bis 399, wird die Prüfung mit der nächsten Auswertungsanweisung fortgesetzt. Bei der zweiten Prüfung wird überprüft, ob der Content-Type application/json lautet. Abschließend wird bei der dritten Prüfung ein regulärer Ausdruck mit den Werten der Metriken deadlocks, Disk und Memory abgeglichen. Sind sie alle fehlerfrei, wird der Dienst als fehlerfrei eingestuft.
match conditions {    status 200-399;
    header Content-Type ~ "application/json";
    body ~ '{
        "deadlocks":{"healthy":true},
        "Disk":{"healthy":true},
        "Memory":{"healthy":true}
    }';
}
Das Circuit-Breaker-/System zur Zustandsprüfung von NGINX Plus verfügt außerdem über eine Slow-Start-Funktion. Der Parameter slow_start der Direktive server für den Resizer-Dienst im Block upstream weist NGINX Plus an, den Datenverkehr zu drosseln, wenn eine Resizer-Instanz erstmals aus einem fehlerhaften Zustand zurückkehrt. Anstatt den Dienst sofort mit derselben Anzahl von Anfragen zu überlasten, die an fehlerfreie Dienste gesendet werden, wird der Datenverkehr zum wiederhergestellten Dienst über den durch den Parameter slow_start angegebenen Zeitraum langsam auf die normale Rate erhöht – in diesem Fall über 30 Sekunden. Der langsame Start erhöht die Wahrscheinlichkeit, dass der Dienst wieder seine volle Leistungsfähigkeit erreicht, und verringert zugleich die Auswirkungen, falls dies nicht gelingt.
upstream resizer {    server        resizer slow_start=30s;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
Die Anforderungsbegrenzung steuert und reguliert den Fluss der Anforderungen an den Dienst. Wenn Sie das Ausfallprofil der Anwendung gut genug kennen, um zu wissen, wie viele Anforderungen sie zu einem bestimmten Zeitpunkt verarbeiten kann, kann die Implementierung einer Anforderungsbegrenzung für den Prozess äußerst hilfreich sein. Diese Funktion ist jedoch nur wirksam, wenn NGINX Plus die Gesamtzahl der an den Dienst weitergeleiteten Verbindungen vollständig kennt. Daher ist es am sinnvollsten, den Circuit Breaker zur Anforderungsbegrenzung auf einer NGINX Plus-Instanz zu implementieren, die wie beim Fabric-Modell zusammen mit dem Dienst selbst in einem Container ausgeführt wird, oder auf einem zentralen Load Balancer, der den gesamten Datenverkehr in einem Cluster verwaltet.
Der folgende Konfigurationscodeausschnitt definiert eine Ratenbegrenzung für Anfragen, die auf die Instanzen des Resizer-Dienstes in ihren Containern angewendet wird. Die Direktive limit_req_zone legt die Ratenbegrenzung auf 100 Anfragen pro Sekunde fest. Die Variable $server_addr wird als Schlüssel verwendet. Das bedeutet, dass alle beim Resizer-Container eingehenden Anfragen auf das Limit angerechnet werden. Der Name der Zone lautet moderateReqs, und der Zeitraum für die Speicherung der Anzahl der Anfragen beträgt 1 Minute. Die Direktive limit_req ermöglicht NGINX Plus, Lastspitzen von bis zu 150 Anfragen zu puffern. Wird diese Anzahl überschritten, erhalten Clients den 503-Fehlercode, wie durch die Direktive limit_req_status festgelegt. Dieser gibt an, dass der Dienst nicht verfügbar ist.
http {    # Moderated delivery
    limit_req_zone $server_addr zone=moderateReqs:1m rate=100r/s;
    # ...
    server {
        # ...
        limit_req zone=moderateReqs burst=150;
        limit_req_status 503;
        # ...
    }
}
Ein weiterer großer Vorteil der Ausführung des Circuit Breakers innerhalb von NGINX Plus besteht darin, Caching einzubinden und zwischengespeicherte Daten zentral für die systemweite Nutzung vorzuhalten. Dies ist besonders wertvoll für leseorientierte Dienste wie Content-Server, bei denen sich die aus dem Backend gelesenen Daten nicht häufig ändern.
proxy_cache_path /app/cache levels=1:2 keys_zone=oauth_cache:10m max_size=10m inactive=15s use_temp_path=off;
upstream user-manager {
    server        user-manager;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}

server {
    listen 443 ssl;
    location /v1/users {
        proxy_pass http://user-manager;
        proxy_cache            oauth_cache;
        proxy_cache_valid      200  30s;
        proxy_cache_use_stale  error timeout invalid_header updating
                               http_500 http_502 http_503 http_504;
    }
}
Wie in Abbildung 2 dargestellt, führt das Zwischenspeichern von Daten dazu, dass viele Anfragen nach Kundendaten die Microservice-Instanzen gar nicht erst erreichen. Dadurch werden Kapazitäten für Anfragen frei, die zuvor noch nicht eingegangen sind.
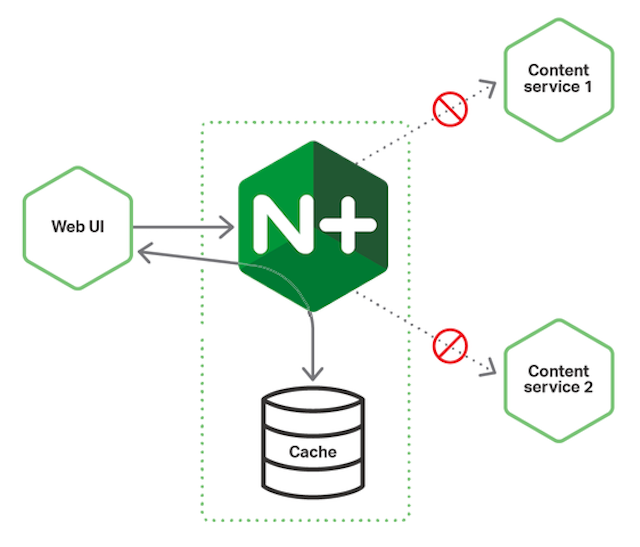
Bei einem Dienst, dessen Daten sich ändern können, beispielsweise einem Benutzerverwaltungsdienst, muss der Cache jedoch mit Bedacht verwaltet werden. Andernfalls kann es passieren, dass ein Benutzer sein Profil ändert, in manchen Kontexten aber weiterhin veraltete Daten sieht, weil diese zwischengespeichert sind. Ein angemessenes Zeitlimit und die Akzeptanz des Prinzips der hohen Verfügbarkeit mit letztendlicher Konsistenz können dieses Problem lösen.
Eine der praktischen Funktionen des NGINX-Caches besteht darin, dass er zwischengespeicherte Daten auch dann weiterhin bereitstellen kann, wenn der Dienst vollständig nicht verfügbar ist – im obigen Codeausschnitt also dann, wenn der Dienst mit einem der vier häufigsten Fehlercodes der 500er-Reihe antwortet.
Caching ist nicht die einzige Möglichkeit, Clients auch dann zu bedienen, wenn ein Server ausgefallen ist. Wie bereits unter „Das Circuit-Breaker-Muster sorgt für Flexibilität“ erwähnt, benötigte einer unserer Kunden eine ausfallsichere Lösung für den Fall, dass sein Server für personalisierte Werbung ausfiel, wobei zwischengespeicherte Antworten keine geeignete Lösung darstellten. Stattdessen sollte ein allgemeiner Anzeigenserver allgemeine Werbung ausliefern, bis der personalisierte Server wieder online war. Dies lässt sich ganz einfach mit dem Parameter backup der Direktive server umsetzen. Das folgende Snippet legt fest, dass bei Nichtverfügbarkeit aller für die Domain personal-ad-server definierten Server stattdessen die für die Domain generic-ad-server definierten Server verwendet werden.
upstream personal-ad-server {    server        personal-ad-server;
    server        generic-ad-server backup;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
Und schließlich kann NGINX die Antwortcodes auswerten eines Dienstes auswerten und diese einzeln behandeln. Wenn ein Dienst im folgenden Codeausschnitt einen 503-Fehler zurückgibt, leitet NGINX Plus die Anfrage an einen alternativen Dienst weiter. Verfügt beispielsweise der Resizer über diese Funktion und ist die lokale Instanz überlastet oder funktioniert nicht mehr, werden die Anfragen an eine andere Instanz des Resizers gesendet.
location / {    error_page 503 = @fallback;
}

location @fallback {
    proxy_pass http://alternative-backend;
}
Fazit
Das Circuit-Breaker-Muster ist ein leistungsstarkes Werkzeug, um die Ausfallsicherheit und Kontrolle in Ihrer Microservices-Anwendung zu verbessern. NGINX Plus bietet zahlreiche Funktionen und Optionen, um einen Circuit Breaker in Ihrer Umgebung zu implementieren. Entscheidend für die Implementierung des Circuit-Breaker-Musters ist, das Ausfallprofil des zu schützenden Dienstes zu verstehen und anschließend die Optionen auszuwählen, die Ausfälle nach Möglichkeit verhindern und deren Auswirkungen bestmöglich begrenzen, wenn sie dennoch auftreten.
Wenn Sie NGINX Plus ausprobieren möchten, starten Sie noch heute Ihre kostenlose 30-tägige Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.