Ausfallzeiten können schwerwiegende Folgen haben.
Für Unternehmen im Bereich der Medizintechnik treffen diese Worte mehr zu als für die meisten anderen Branchen – in ihrem Fall können die „schwerwiegenden Folgen“ buchstäblich den Tod bedeuten. Vor Kurzem hatten wir die Gelegenheit, den Technologie-Stack eines Unternehmens genauer unter die Lupe zu nehmen, das die medizinische Dokumentation von Papier und Stift auf sichere digitale Daten umstellen möchte, die jederzeit und überall auf der Welt zugänglich sind. Diese Daten reichen von Patienteninformationen über Behandlungsanweisungen, biologische Marker, medizinische Analysen und historische Aufzeichnungen bis hin zu allen weiteren Informationen, die zwischen medizinischen Teams ausgetauscht werden.
Von Anfang an wollte das Unternehmen eine scheinbar einfache Frage beantworten: „Wie können wir Pflegekräften dabei helfen, Daten unkompliziert und in Echtzeit zu erfassen?“ Mit dem Wachstum des Unternehmens wurde die Lösung dieser Herausforderung jedoch zunehmend komplex, da die Systeme skalierbar sein und die Daten jederzeit verfügbar bleiben müssen. Im Folgenden beschreiben wir, wie die technologische Entwicklung des Unternehmens zur Einführung von Kubernetes und dem NGINX Ingress Controller geführt hat.
Technologie-Stack auf einen Blick
- Betriebssystem – Linux
- Container-Orchestrierung – Microsoft Azure Kubernetes Service
- Netzwerk – Kubernetes, NGINX Ingress Controller auf Basis von NGINX Plus
- Softwareentwicklungssprache/-Framework – .Net
- Monitoring, Observability und Alarmierung – Prometheus
- Monitoring-Dashboard – Grafana
- Protokollierung – Grafana Loki
- Datenbank – Azure SQL Service
- Anwendungsserver – Azure App Service, .NET
- Messaging und Streaming – Azure Event Hubs
- Caching – Redis
- Sicherheit – NGINX App Protect
- Standort und Infrastruktur – Zwei Verfügbarkeitszonen, 2 Kubernetes-Cluster, 15–20 Knoten, 60–100 Pods
- DevOps – Azure DevOps Services
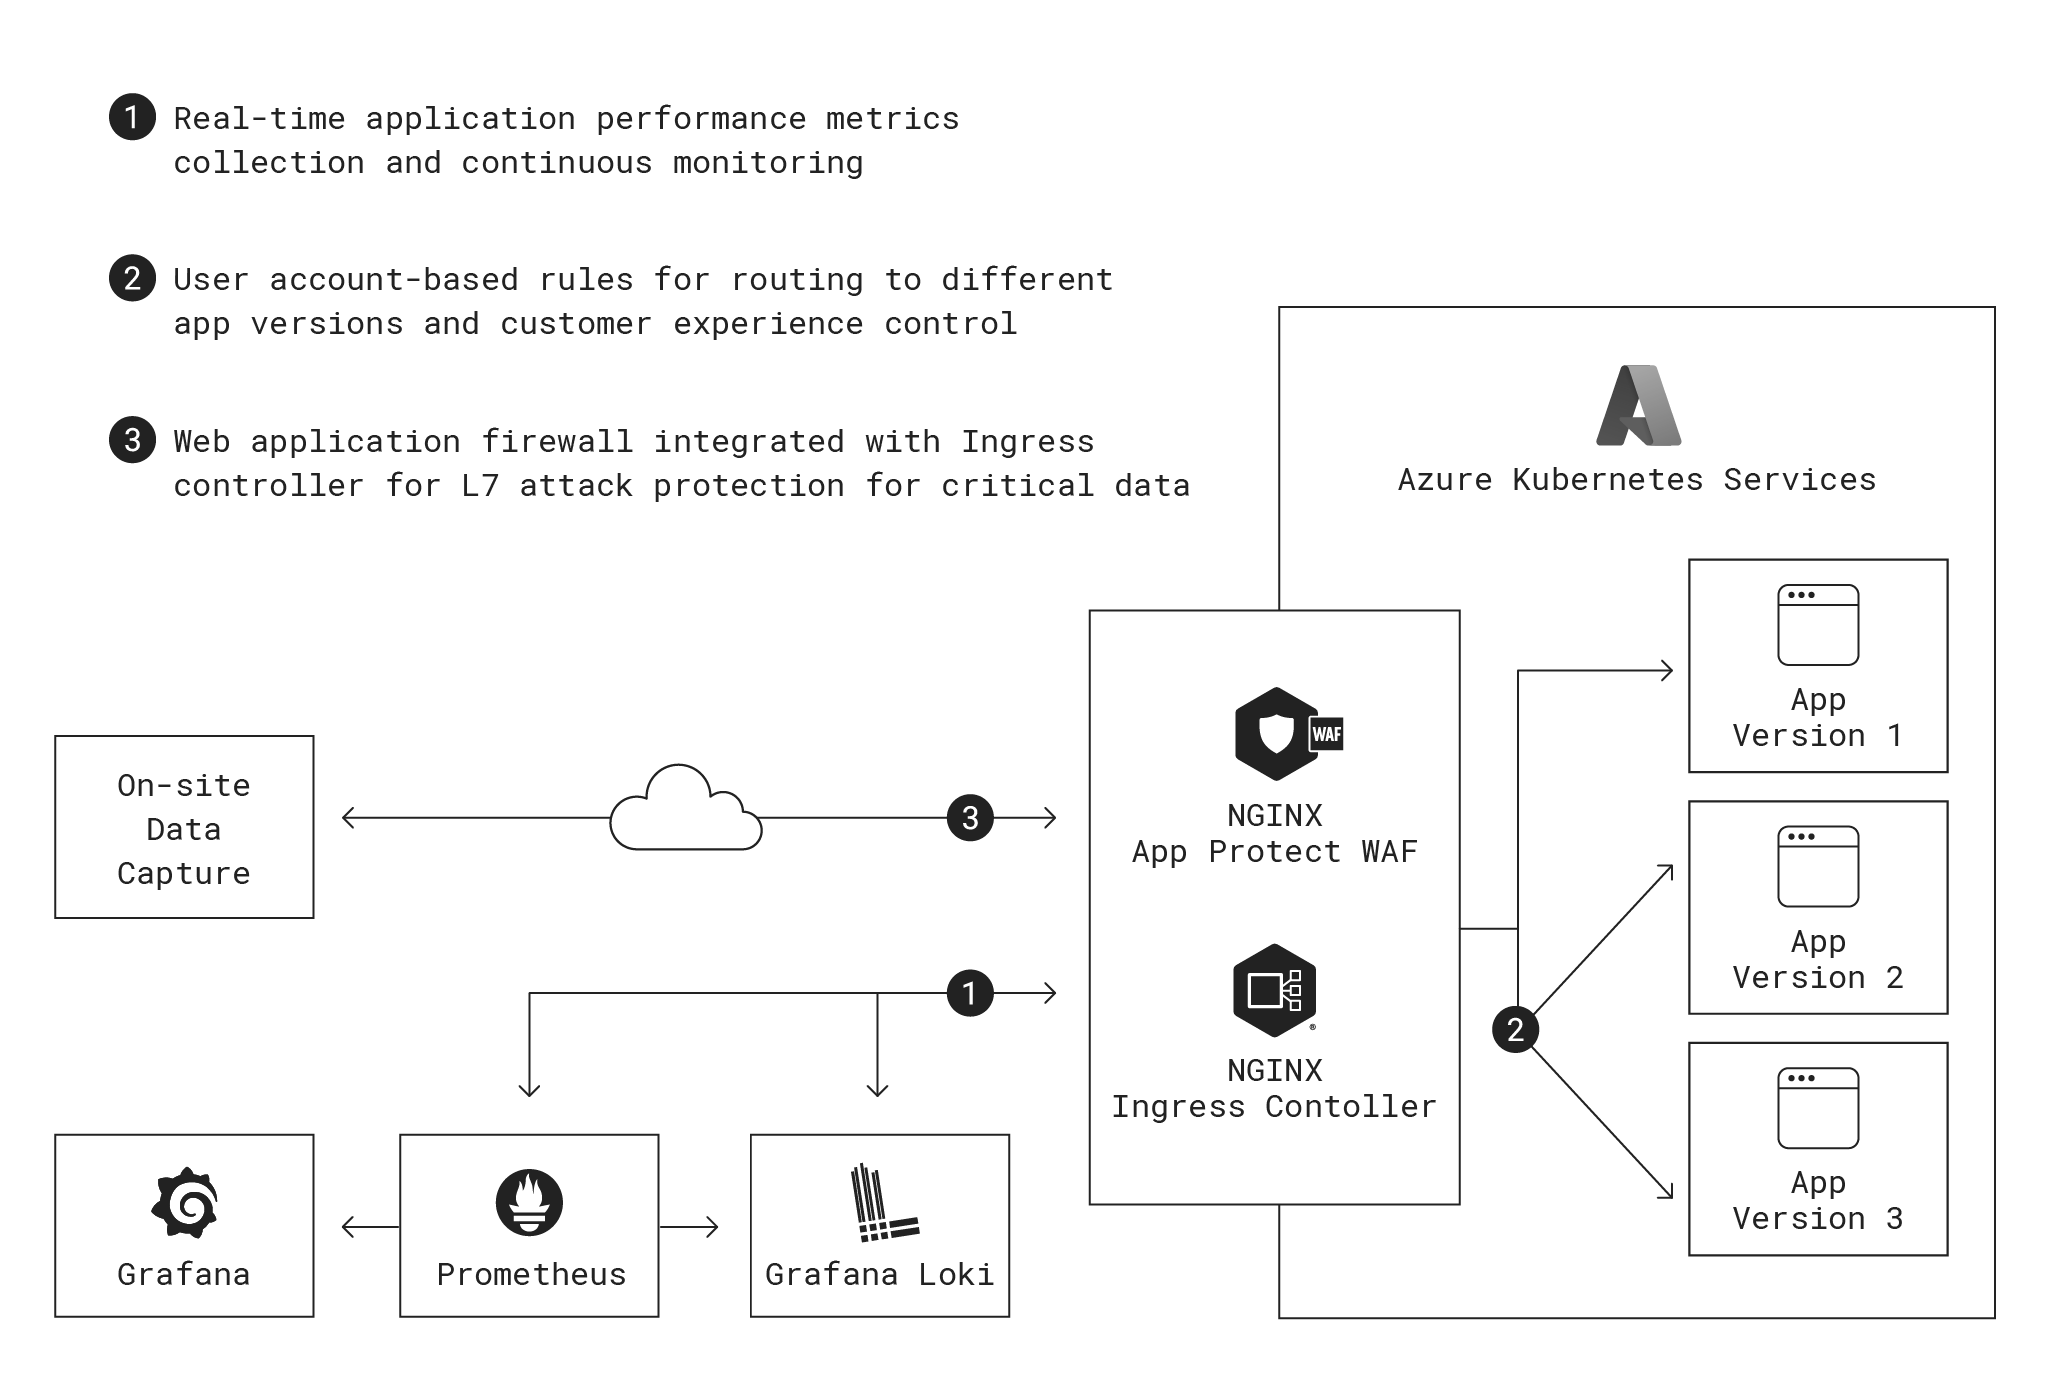
Sehen wir uns an, wo NGINX in ihrer Architektur zum Einsatz kommt:
Das Problem mit Papier
Die regelmäßige Erfassung des Patientenzustands und der Versorgungsdaten gehört zu den zentralen Aufgaben des medizinischen Personals. Traditionell wurden Patienteninformationen auf Papier dokumentiert, in jüngerer Zeit auch auf Laptops oder Tablets. Dies bringt einige gravierende Nachteile mit sich:
- Beschäftigte im Gesundheitswesen haben täglich möglicherweise mit Dutzenden von Patienten zu tun. Daher ist es in der Regel nicht praktikabel, während der Versorgung ausführliche Notizen zu machen. Infolgedessen verfassen sie ihre Notizen erst am Ende ihrer Schicht. Zu diesem Zeitpunkt verleiten geistige und körperliche Erschöpfung dazu, nur allgemeine Anmerkungen festzuhalten.
- Die Beschäftigten müssen sich außerdem auf ihre Erinnerung an Einzelheiten zum Verhalten der Patienten verlassen. Ungenauigkeiten könnten Muster verschleiern, die bei korrekter und konsequenter Dokumentation im Zeitverlauf die Diagnose umfassenderer gesundheitlicher Probleme erleichtern würden.
- Papierakten lassen sich nicht ohne Weiteres zwischen verschiedenen Abteilungen innerhalb einer Organisation austauschen, geschweige denn mit anderen Beteiligten wie Rettungskräften, Notaufnahmepersonal und Versicherungsunternehmen. Auch bei Laptops oder Tablets sieht es kaum besser aus, wenn sie nicht mit einem zentralen Datenspeicher oder der Cloud verbunden sind.
Um diese Herausforderungen zu bewältigen, entwickelte das Unternehmen ein vereinfachtes Datenerfassungssystem, das einen schnellen Zugriff auf Patienteninformationen und die Dokumentation häufiger Vorgänge wie der Medikamentenausgabe ermöglicht. Dank der einfachen Bedienung und des unkomplizierten Zugriffs können Interaktionen mit Patienten unmittelbar in Echtzeit dokumentiert werden.
Alle Daten werden in den vom Unternehmen verwalteten Cloud-Systemen gespeichert. Die App lässt sich zudem in andere Systeme für elektronische Patientenakten integrieren und ermöglicht so einen umfassenden Langzeitüberblick über das Verhalten der Bewohner. Dies unterstützt die Pflegekräfte dabei, eine bessere Versorgungskontinuität zu gewährleisten, schafft eine sichere Verlaufsdokumentation und ermöglicht den einfachen Datenaustausch mit anderen Softwaresystemen im Gesundheitswesen.
Auch Ärzte und andere Fachkräfte nutzen die Plattform bei der Aufnahme oder anderweitigen Betreuung von Patienten. Präferenzen und persönliche Bedürfnisse werden dokumentiert und begleiten den Patienten in jede Einrichtung. Diese Informationen können dazu beitragen, dass sich Patienten in einer neuen Umgebung wohlfühlen, was Behandlungsergebnisse wie die Genesungsdauer verbessert.
Es gelten strenge gesetzliche Vorgaben dafür, wie lange Unternehmen Patientendaten speichern müssen. Die Entwickler des Unternehmens haben die Software so konzipiert, dass sie eine extrem hohe Verfügbarkeit mit Uptime-SLAs bietet, die deutlich besser sind als die generischer Cloud-Anwendungen. Einen Krankenwagen warten zu lassen, weil die Patientenakte nicht geladen werden kann, kommt nicht infrage.
Die Reise von der Garage über die Cloud zu Kubernetes
Wie viele Start-ups sparte das Unternehmen anfangs Kosten, indem es die erste Proof-of-Concept-Anwendung auf einem Server im Haus eines Mitgründers betrieb. Als klar wurde, dass die Idee Potenzial hatte, verlagerte das Unternehmen seine Infrastruktur in die Cloud, anstatt Hardware in einem Rechenzentrum zu verwalten. Da das Unternehmen auf Microsoft-Technologien setzte, entschied es sich für Azure. In der ursprünglichen Architektur liefen die Anwendungen auf herkömmlichen virtuellen Maschinen (VMs) in Azure App Service, einem verwalteten Dienst zur Anwendungsbereitstellung, der den IIS-Webserver von Microsoft nutzt. Für die Speicherung und den Abruf von Daten entschied sich das Unternehmen für Microsoft SQL Server, der als verwaltete Anwendung in einer VM ausgeführt wurde.
Nachdem das Unternehmen mehrere Jahre lang in der Cloud gearbeitet hatte, wuchs es schnell und stieß bei der Skalierung an seine Grenzen. Es musste unbegrenzt und horizontal statt vertikal skalieren können, da Letzteres bei VMs langsam und teuer ist. Diese Anforderung führte fast zwangsläufig zu Containerisierung und Kubernetes als möglicher Lösung. Ein weiterer Vorteil der Containerisierung bestand darin, dass die Entwickler des Unternehmens häufig Updates für die Anwendung und Infrastruktur bereitstellen müssen, ohne dabei Ausfälle zu riskieren. Da über mehrere Zeitzonen hinweg ständig Patientennotizen hinzugefügt werden, gibt es kein natürliches Zeitfenster, in dem Änderungen in die Produktionsumgebung eingespielt werden können, ohne dass Kunden bei Störungen unmittelbar beeinträchtigt werden könnten.
Ein logischer Ausgangspunkt für das Unternehmen war das verwaltete Kubernetes-Angebot von Microsoft, Azure Kubernetes Service (AKS). Das Team informierte sich über Best Practices für Kubernetes und erkannte, dass es einen Ingress-Controller benötigte, der den Kubernetes-Clustern vorgeschaltet ist, um den Datenverkehr sowie die auf den Knoten und in den Pods von AKS ausgeführten Anwendungen effektiv zu verwalten.
Die Datenverkehrssteuerung muss flexibel und zugleich präzise sein
Das Team testete den standardmäßigen Ingress-Controller von AKS, stellte jedoch fest, dass dessen Funktionen zur Datenverkehrssteuerung schlicht nicht in der Lage waren, Updates auf die erforderliche Weise für die Kunden des Unternehmens bereitzustellen. Bei der Patientenversorgung darf es keine Unklarheiten oder widersprüchlichen Informationen geben – es ist beispielsweise nicht hinnehmbar, dass eine Pflegekraft für dasselbe Ereignis eine orangefarbene Markierung sieht und eine andere eine rote. Daher müssen alle Benutzer innerhalb einer Organisation dieselbe Version der App verwenden. Dies stellt bei Upgrades eine große Herausforderung dar. Es gibt keinen geeigneten Zeitpunkt, um einen Kunden auf eine neue Version umzustellen. Deshalb benötigte das Unternehmen eine Möglichkeit, verschiedene Kunden mithilfe von Regeln auf Server- und Netzwerkebene zu unterschiedlichen App-Versionen weiterzuleiten.
Um dies zu erreichen, betreibt das Unternehmen für alle Benutzer innerhalb einer Organisation dieselbe Backend-Plattform und bietet innerhalb der Organisation keine Mandantenfähigkeit mit Segmentierung auf Infrastrukturebene. Mit Kubernetes lässt sich der Datenverkehr mithilfe virtueller Netzwerkrouten und Browser-Cookies sowie detaillierter Datenverkehrsregeln aufteilen. Das Technikteam des Unternehmens stellte jedoch fest, dass der standardmäßige Ingress-Controller von AKS den Datenverkehr nur prozentual aufteilen kann und nicht wie erforderlich anhand von Regeln auf Ebene der Kundenorganisation oder einzelner Benutzer.
In seiner Basiskonfiguration weist der auf NGINX Open Source basierende NGINX Ingress Controller dieselbe Einschränkung auf. Daher entschied sich das Unternehmen für den fortschrittlicheren, auf NGINX Plus basierenden NGINX Ingress Controller – ein Produkt für den Unternehmenseinsatz, das eine granulare Datenverkehrssteuerung unterstützt. Empfehlungen von Microsoft und der Kubernetes-Community für den NGINX Ingress Controller aufgrund seiner hohen Flexibilität und umfassenden Steuerungsmöglichkeiten bestärkten das Unternehmen in seiner Entscheidung. Die Konfiguration erfüllt die Anforderungen des Unternehmens an die Pod-Verwaltung (im Gegensatz zur klassischen Datenverkehrsverwaltung) besser, indem sie sicherstellt, dass die Pods in den entsprechenden Zonen ausgeführt und Datenströme an die jeweiligen Dienste weitergeleitet werden. Manchmal wird der Datenverkehr intern weitergeleitet, in den meisten Anwendungsfällen wird er jedoch aus Gründen der Beobachtbarkeit wieder über den NGINX Ingress Controller nach außen geleitet.
Hier lauern Drachen: Monitoring, Observability und Anwendungsleistung
Mit dem NGINX Ingress Controller hat das technische Team die vollständige Kontrolle über die Benutzererfahrung von Entwicklern und Endanwendern. Sobald sich Benutzer anmelden und eine Sitzung aufbauen, können sie sofort zu einer neuen Version weitergeleitet oder auf eine ältere Version zurückgesetzt werden. Patches können gleichzeitig und nahezu unverzüglich für alle Benutzer in einer Organisation bereitgestellt werden. Die Software ist weder auf die DNS-Propagierung noch auf Aktualisierungen der Netzwerkkonfiguration innerhalb der Cloud-Plattform angewiesen.
NGINX Ingress Controller erfüllt außerdem die Anforderungen des Unternehmens an eine detaillierte und kontinuierliche Überwachung. Die Anwendungsleistung ist im Gesundheitswesen von entscheidender Bedeutung. Latenzen oder Ausfallzeiten können eine erfolgreiche klinische Versorgung beeinträchtigen, insbesondere in lebensbedrohlichen Situationen. Nach der Umstellung auf Kubernetes meldeten Kunden Ausfallzeiten, die das Unternehmen nicht bemerkt hatte. Schon bald fand das Unternehmen die Ursache des Problems: Azure App Service stützt sich auf Stichprobendaten. Stichproben eignen sich zwar für Durchschnittswerte und allgemeine Trends, erfassen jedoch beispielsweise abgelehnte Anfragen und fehlende Ressourcen überhaupt nicht. Auch die Nutzungsspitzen, die üblicherweise alle halbe Stunde auftreten, wenn sich Pflegekräfte anmelden und Patientendaten erfassen, werden nicht angezeigt. Das Unternehmen erhielt daher nur ein unvollständiges Bild von Latenzen, Fehlerquellen, fehlerhaften Anfragen und nicht verfügbaren Diensten.
Damit waren die Probleme jedoch noch nicht gelöst. Standardmäßig bewahrt Azure App Service gespeicherte Daten nur einen Monat lang auf – deutlich kürzer als die jahrzehntelangen Aufbewahrungsfristen, die in vielen Ländern gesetzlich vorgeschrieben sind. Die für eine längere Aufbewahrung erforderliche Erweiterung des Datenspeichers war unerschwinglich teuer. Darüber hinaus bietet die Azure-Lösung keinen Einblick in den Kubernetes-Netzwerk-Stack. NGINX Ingress Controller kann sowohl Infrastruktur- als auch Anwendungsparameter überwachen, während er den Datenverkehr auf Layer 4 und Layer 7 verarbeitet.
Für die Leistungsüberwachung und Observability entschied sich das Unternehmen für eine Prometheus-Zeitreihendatenbank, die mit einer Grafana-Visualisierungs-Engine und einem Dashboard verbunden ist. Die Integration mit Prometheus und Grafana ist bereits in die Daten- und Steuerungsebene von NGINX integriert. Das Technikteam musste lediglich eine kleine Konfigurationsänderung vornehmen, um den gesamten Datenverkehr über die Prometheus- und Grafana-Server zu leiten. Die Informationen wurden außerdem an eine Grafana-Loki-Protokolldatenbank weitergeleitet, um die Analyse von Protokollen zu vereinfachen und dem Softwareteam langfristig mehr Kontrolle über die Daten zu geben.
Diese Konfiguration ist zudem zukunftssicher für Vorfälle, bei denen zur Fehlerbehebung und Fehlerkorrektur extrem häufig große Datenmengen erfasst werden müssen. Die Bewältigung solcher Vorfälle kann mit den von den meisten großen Cloud-Anbietern bereitgestellten Systemen zur Anwendungsüberwachung kostspielig sein. Die Kosten und der Aufwand für Prometheus, Grafana und Loki sind in diesem Anwendungsfall hingegen minimal. Alle drei sind stabile Open-Source-Produkte, die nach der anfänglichen Feinabstimmung in der Regel kaum mehr als regelmäßige Patches erfordern.
Kurs halten: Fokus auf Hochverfügbarkeit und Sicherheit
Das Unternehmen hat seit jeher zwei Schwerpunkte: Sicherheit, um eine der sensibelsten Arten von Daten überhaupt zu schützen, und Hochverfügbarkeit, damit die App jederzeit verfügbar ist, wenn sie benötigt wird. Im Zuge der Umstellung auf Kubernetes nahm das Unternehmen einige Änderungen vor, um beide Bereiche weiter zu stärken.
Um höchste Verfügbarkeit zu gewährleisten, setzt das Technikteam auf eine aktiv-aktive, über mehrere Zonen und geografische Regionen verteilte Infrastrukturarchitektur. Sie bietet vollständige Redundanz ohne Single Point of Failure. Das Team betreibt eine aktiv-aktive N+2-Infrastruktur mit zwei Kubernetes-Clustern in zwei verschiedenen geografischen Regionen. Innerhalb jeder Region ist die Software auf mehrere Rechenzentren verteilt, um das Risiko von Ausfallzeiten zu minimieren und Ausfälle auf jeder Ebene der Infrastruktur abzufangen. Mithilfe von Affinitäts- und Anti-Affinitätsregeln lassen sich Benutzer und Datenverkehr sofort auf betriebsbereite Pods umleiten, um Dienstunterbrechungen zu vermeiden.
Zur Gewährleistung der Sicherheit setzt das Team eine Web Application Firewall (WAF) ein, die vor schädlichen Anfragen und böswilligen Akteuren schützt. Schutz vor den OWASP Top 10 gehört zur Grundausstattung der meisten WAFs. Bei der Entwicklung der App prüfte das Team verschiedene WAFs, darunter die native Azure WAF und ModSecurity. Letztendlich entschied sich das Team für NGINX App Protect mit integrierter WAF und Schutz vor Distributed Denial of Service (DDoS).
Ein großer Vorteil von NGINX App Protect ist die gemeinsame Bereitstellung mit dem NGINX Ingress Controller, wodurch sowohl ein redundanter Punkt entfällt als auch die Latenz reduziert wird. Andere WAFs müssen außerhalb der Kubernetes-Umgebung platziert werden, was zu höheren Latenzen und Kosten führt. Selbst minimale Verzögerungen (beispielsweise eine zusätzliche Millisekunde pro Anfrage) summieren sich im Laufe der Zeit schnell.
Unerwartete Nebenmission: Keine Ausfallzeiten für Entwickler
Nachdem das Unternehmen den Großteil seiner Anwendungs- und Netzwerkinfrastruktur auf AKS umgestellt hat, konnte es auch die Developer Experience (DevEx) deutlich verbessern. Entwickler erkennen Probleme nun fast immer, bevor Kunden selbst etwas davon bemerken. Seit der Umstellung ist die Zahl der Supportanfragen aufgrund von Fehlern um etwa 80 % zurückgegangen!
Die Sicherheits- und Anwendungsperformance-Teams des Unternehmens verfügen über ein detailliertes Grafana-Dashboard und ein einheitliches Warnsystem. Dadurch müssen sie nicht mehr mehrere Systeme überprüfen oder Auslöser für Warnmeldungen und Anrufe aus unterschiedlichen Prozessen implementieren. Die Entwicklungs- und DevOps-Teams können nun täglich oder sogar mehrmals am Tag Code- und Infrastruktur-Updates bereitstellen und dabei äußerst granulare Blue-Green-Deployment-Muster nutzen. Früher stellten sie ein- bis zweimal pro Woche Updates bereit und mussten dafür Zeitfenster mit geringer Auslastung abpassen, was mit erheblichem Stress verbunden war. Heute wird Code bereitgestellt, sobald er fertig ist, und die Entwickler können die Auswirkungen direkt anhand des Anwendungsverhaltens überwachen.
Die Ergebnisse sind durchweg positiv: Die Softwareentwicklung wird beschleunigt, die Motivation der Entwickler steigt und mehr Menschenleben werden gerettet.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.