NGINX Ingress Controller von F5 NGINX ermöglicht in Kombination mit der ServiceMonitor-CRD des Prometheus-Operators eine wesentlich einfachere und schnellere Erfassung von Metriken aus NGINX Ingress Controller-Bereitstellungen mithilfe von Helm. Das Helm-Chart für NGINX Ingress Controller unterstützt jetzt die direkte Nutzung Ihrer vorhandenen Prometheus- und Prometheus-Operator-Infrastruktur. So können Sie NIC bereitstellen und dank Prometheus ServiceMonitor sofort Metriken erfassen. In diesem Artikel erfahren Sie, was ServiceMonitor ist, wie Sie ihn installieren und wie Sie diese spezifischen Einstellungen mithilfe des Helm-Charts für NGINX Ingress Controller festlegen können.
Prometheus ServiceMonitor
Mit der benutzerdefinierten Ressourcendefinition (Custom Resource Definition, CRD) Prometheus ServiceMonitor können Sie deklarativ festlegen, wie eine dynamische Gruppe von Services überwacht werden soll. Die zu überwachenden Services werden mithilfe von Kubernetes-Label-Selektoren definiert. So kann eine Organisation Konventionen dafür einführen, wie Metriken bereitgestellt werden. Wenn diese Konventionen eingehalten werden, werden neue Services automatisch erkannt und Prometheus beginnt mit der Erfassung von Metriken, ohne dass das System neu konfiguriert werden muss. ServiceMonitor ist Teil des Prometheus Operators. Diese Ressourcen beschreiben und verwalten Überwachungsziele, die von Prometheus abgefragt werden sollen. Die Prometheus-Ressource stellt über ein ServiceMonitor-Selektorfeld eine Verbindung zu ServiceMonitor her. Prometheus kann problemlos erkennen, welche Ziele für die Abfrage markiert wurden. Dadurch erhalten Sie mehr Kontrolle und Flexibilität, um ServiceMonitor-Ressourcen in Ihrem Kubernetes-Cluster zur Überwachung von Lösungen wie dem NGINX Ingress Controller zu nutzen. Um die Einrichtung zu vereinfachen und sofort einsatzbereite Metriken für den NGINX Ingress Controller bereitzustellen, haben wir unserem Helm-Chart kürzlich die Möglichkeit hinzugefügt, Prometheus ServiceMonitor zu verwenden. Dadurch lassen sich Metriken für Prometheus ganz einfach aktivieren, sodass die Abfrage direkt nach der Bereitstellung des NGINX Ingress Controllers beginnen kann. Um diese Funktion zu nutzen, müssen wir einen zweiten, speziell für die Metrikerfassung erstellten Service hinzufügen, an den sich ServiceMonitor „anbindet“. Dadurch wird dem Prometheus Operator anhand der Labels in den Metadaten mitgeteilt, welchen Service er überwachen soll, sodass er weiß, was und wo er abfragen muss. So könnte beispielsweise ein Service für den NGINX Ingress Controller aussehen, wenn er Teil von Bereitstellungs- oder Helm-Dateien ist:
apiVersion: v1
kind: Service
metadata:
  name: nginx-ingress-servicemonitor
  labels:
    app: nginx-ingress-servicemonitor
spec:
  ports:
  - name: prometheus
    protocol: TCP
    port: 9113
    targetPort: 9113
  selector:
    app: nginx-ingress
Das oben Gezeigte wird Teil des Deployments sein. Das Label app: nginx-ingress-servicemonitor stellt die „Verbindung“ zum serviceMonitor für das Scraping von Prometheus-Metriken her. Nachfolgend sehen Sie ein Beispiel für einen serviceMonitor, der mit dem oben genannten Service namens nginx-ingress-servicemonitor verknüpft wird:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: nginx-ingress-servicemonitor
  labels:
    app: nginx-ingress-servicemonitor
spec:
  selector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  endpoints:
  - port: prometheus
Es muss eine Prometheus-Ressource erstellt werden, die so konfiguriert ist, dass sie nach serviceMonitor-Ressourcen sucht. Dadurch kann Prometheus schnell und einfach erkennen, welche Endpunkte zum Erfassen von Metriken abgefragt werden sollen. Im folgenden Beispiel teilt diese Ressource Prometheus mit, welche Elemente unter „spec“ überwacht werden sollen. Hier überwachen wir spec.serviceMonitorSelector.matchLabels:. Wir sehen, dass Prometheus in allen Namespaces nach matchLabels mit app.nginx-ingress-servicemonitor sucht. Dies entspricht der serviceMonitor-Ressource, die von den Helm-Charts des NGINX Ingress Controllers und Helm bereitgestellt wird.
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: prometheus
  labels:
    prometheus: prometheus
spec:
  replicas: 1
  serviceAccountName: prometheus
  serviceMonitorNamespaceSelector:  {}
  serviceMonitorSelector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  resources:
    requests:
      memory: 500Mi
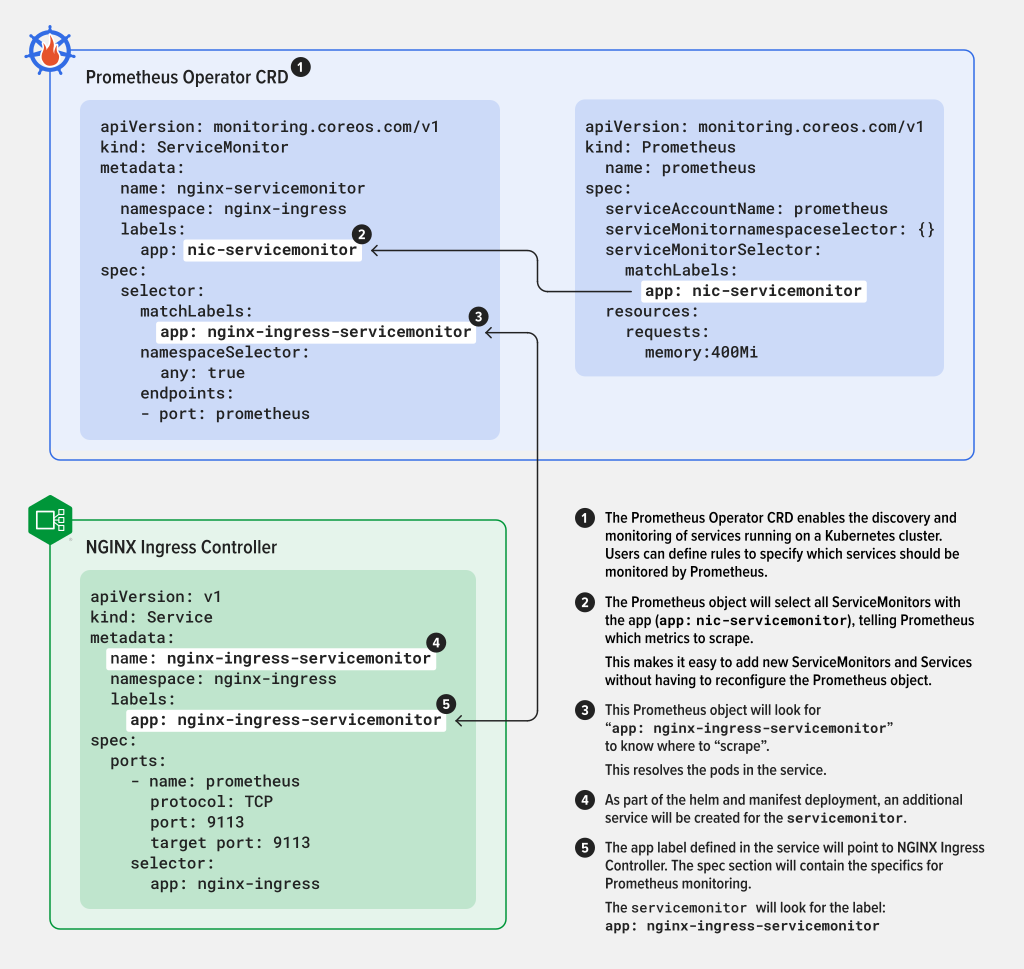
Hier ist ein Diagramm, das die verschiedenen Komponenten miteinander verbindet:
Installation von Prometheus, prometheus-operator und Grafana
Wir verwenden prometheus-community/kube-prometheus-stack zur Installation der vollständigen Bereitstellung. Dadurch werden Prometheus, prometheus-operator und Grafana installiert. Außerdem geben wir an, dass die Installation zur Isolation im Namespace „monitoring“ erfolgen soll. So können wir die Installation mit Helm durchführen: helm install metrics01 prometheus-community/kube-prometheus-stack -n monitoring --create-namespace
Prometheus-Ressource erstellen und installieren
Sobald Prometheus und die Prometheus-CRDs im Cluster installiert sind, können wir unsere Prometheus-Ressource erstellen. Indem wir diese vorab bereitstellen, können wir unsere Prometheus-Konfiguration mit den Labels vorbereiten, die wir im Helm-Chart verwenden werden. Auf diese Weise können wir Prometheus automatisch anweisen, nach dem NGINX Ingress Controller zu suchen und dessen Metriken zu erfassen. Unsere Prometheus-Ressource wird vor der Installation des NGINX Ingress Controllers bereitgestellt. Dadurch kann der prometheus-operator unseren NGINX Ingress Controller nach der Bereitstellung automatisch erkennen und dessen Metriken erfassen, sodass diese schnell verfügbar sind.
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: prometheus
  namespace: default
  labels:
    prometheus: monitoring
spec:
  replicas: 1
  serviceAccountName: prometheus
  serviceMonitorNamespaceSelector:  {}
  serviceMonitorSelector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  resources:
    requests:
      memory: 500Mi
Unser obiges Beispiel ist ein einfaches Beispiel. Entscheidend ist der von uns angegebene Wert spec.serviceMonitorSelector.matchLabels. Diesen Wert verwenden wir, wenn wir den NGINX Ingress Controller mit dem Helm-Chart bereitstellen. Wir möchten standardmäßig Prometheus-Metriken bereitstellen. Dazu verwenden wir das Helm-Chart des NGINX Ingress Controllers.
Änderungen an den Helm-values.yaml-Werten des NGINX Ingress Controllers
Wir können uns die Datei values.yaml für das Helm-Chart ansehen. Darin gibt es einen Prometheus-Abschnitt, auf den wir uns konzentrieren möchten, da er die erforderlichen Komponenten enthält, um Prometheus zu aktivieren, den benötigten Service zu erstellen und eine serviceMonitor-Ressource anzulegen. Im Prometheus-Abschnitt sollten mehrere Einstellungen zu sehen sein: prometheus.service prometheus.serviceMonitor Wir aktivieren die beiden oben genannten Einstellungen, damit bei der Verwendung des Helm-Charts der erforderliche Service und der serviceMonitor generiert werden. Im folgenden Abschnitt aktivieren wir den Service und serviceMonitor und definieren die Labels im Abschnitt serviceMonitor:
`servicemonitor` support was recently added to the NGINX Ingress controller helm chart.
prometheus:
  ## Expose NGINX or NGINX Plus metrics in the Prometheus format.
  create: true

  ## Configures the port to scrape the metrics.
  port: 9113

  secret: ""

  ## Configures the HTTP scheme used.
  scheme: http

  service:
    ## Requires prometheus.create=true
    create: true

  serviceMonitor:
    create: true
    labels: { app: nginx-ingress-servicemonitor }
Die obigen Werte im Einzelnen:
prometheus:
  ## Expose NGINX or NGINX Plus metrics in the Prometheus format.
  create: true
Teilt Helm mit, dass Sie den NIC-Prometheus-Endpunkt aktivieren möchten. Bei Bedarf können Sie zusätzlich einen Port, ein Schema und ein Secret definieren. Wenn Sie den Wert von prometheus.service.create auf „true“ setzen, erstellt Helm automatisch den NIC-ServiceMonitor-Dienst.
service:
    ## Creates a ClusterIP Service to expose Prometheus metrics internally
    ## Requires prometheus.create=true
    create: true
Abschließend müssen wir den serviceMonitor erstellen. Wenn wir diesen Wert auf „true“ setzen und die richtigen Labels hinzufügen, werden die Labels erstellt und hinzugefügt, die zu unserer Prometheus-Ressource passen.
serviceMonitor:
    ## Creates a serviceMonitor to expose statistics on the kubernetes pods.
    create: true
    ## Kubernetes object labels to attach to the serviceMonitor object.
    labels: { app: nginx-ingress-servicemonitor }
Das Label verweist auf den Namen der service.labels: { app: nginx-ingress-servicemointor } Zusammenfassend: Aktivieren Sie Prometheus. Dadurch wird die Prometheus-Exporter-Funktion von NIC bereitgestellt. Definieren Sie ein Service-Objekt. So erkennt der Prometheus ServiceMonitor die Prometheus-Exporter-Endpunkte von NIC. Definieren Sie ein serviceMonitor-Objekt. Dadurch wird der Prometheus ServiceMonitor angewiesen, diese Ressource zu überwachen.
Jetzt können wir den NGINX Ingress Controller mit helm installieren.
Nachdem wir unsere values.yaml angepasst haben, können wir mit der Installation des NGINX Ingress Controllers fortfahren. helm install nic01 -n nginx-ingress --create-namespace -f values.yaml . Nach der Bereitstellung des NGINX Ingress Controllers können wir das Prometheus-Dashboard öffnen und zum Statusmenü navigieren. Von dort aus können wir die Ansichten für Ziele und die Serviceerkennung aufrufen. Sobald Prometheus unsere neue ServiceMonitor-Ressource gefunden hat, beginnt es, den Endpunkt abzufragen und Metriken zu erfassen, die sofort im Prometheus-Dashboard angezeigt werden.
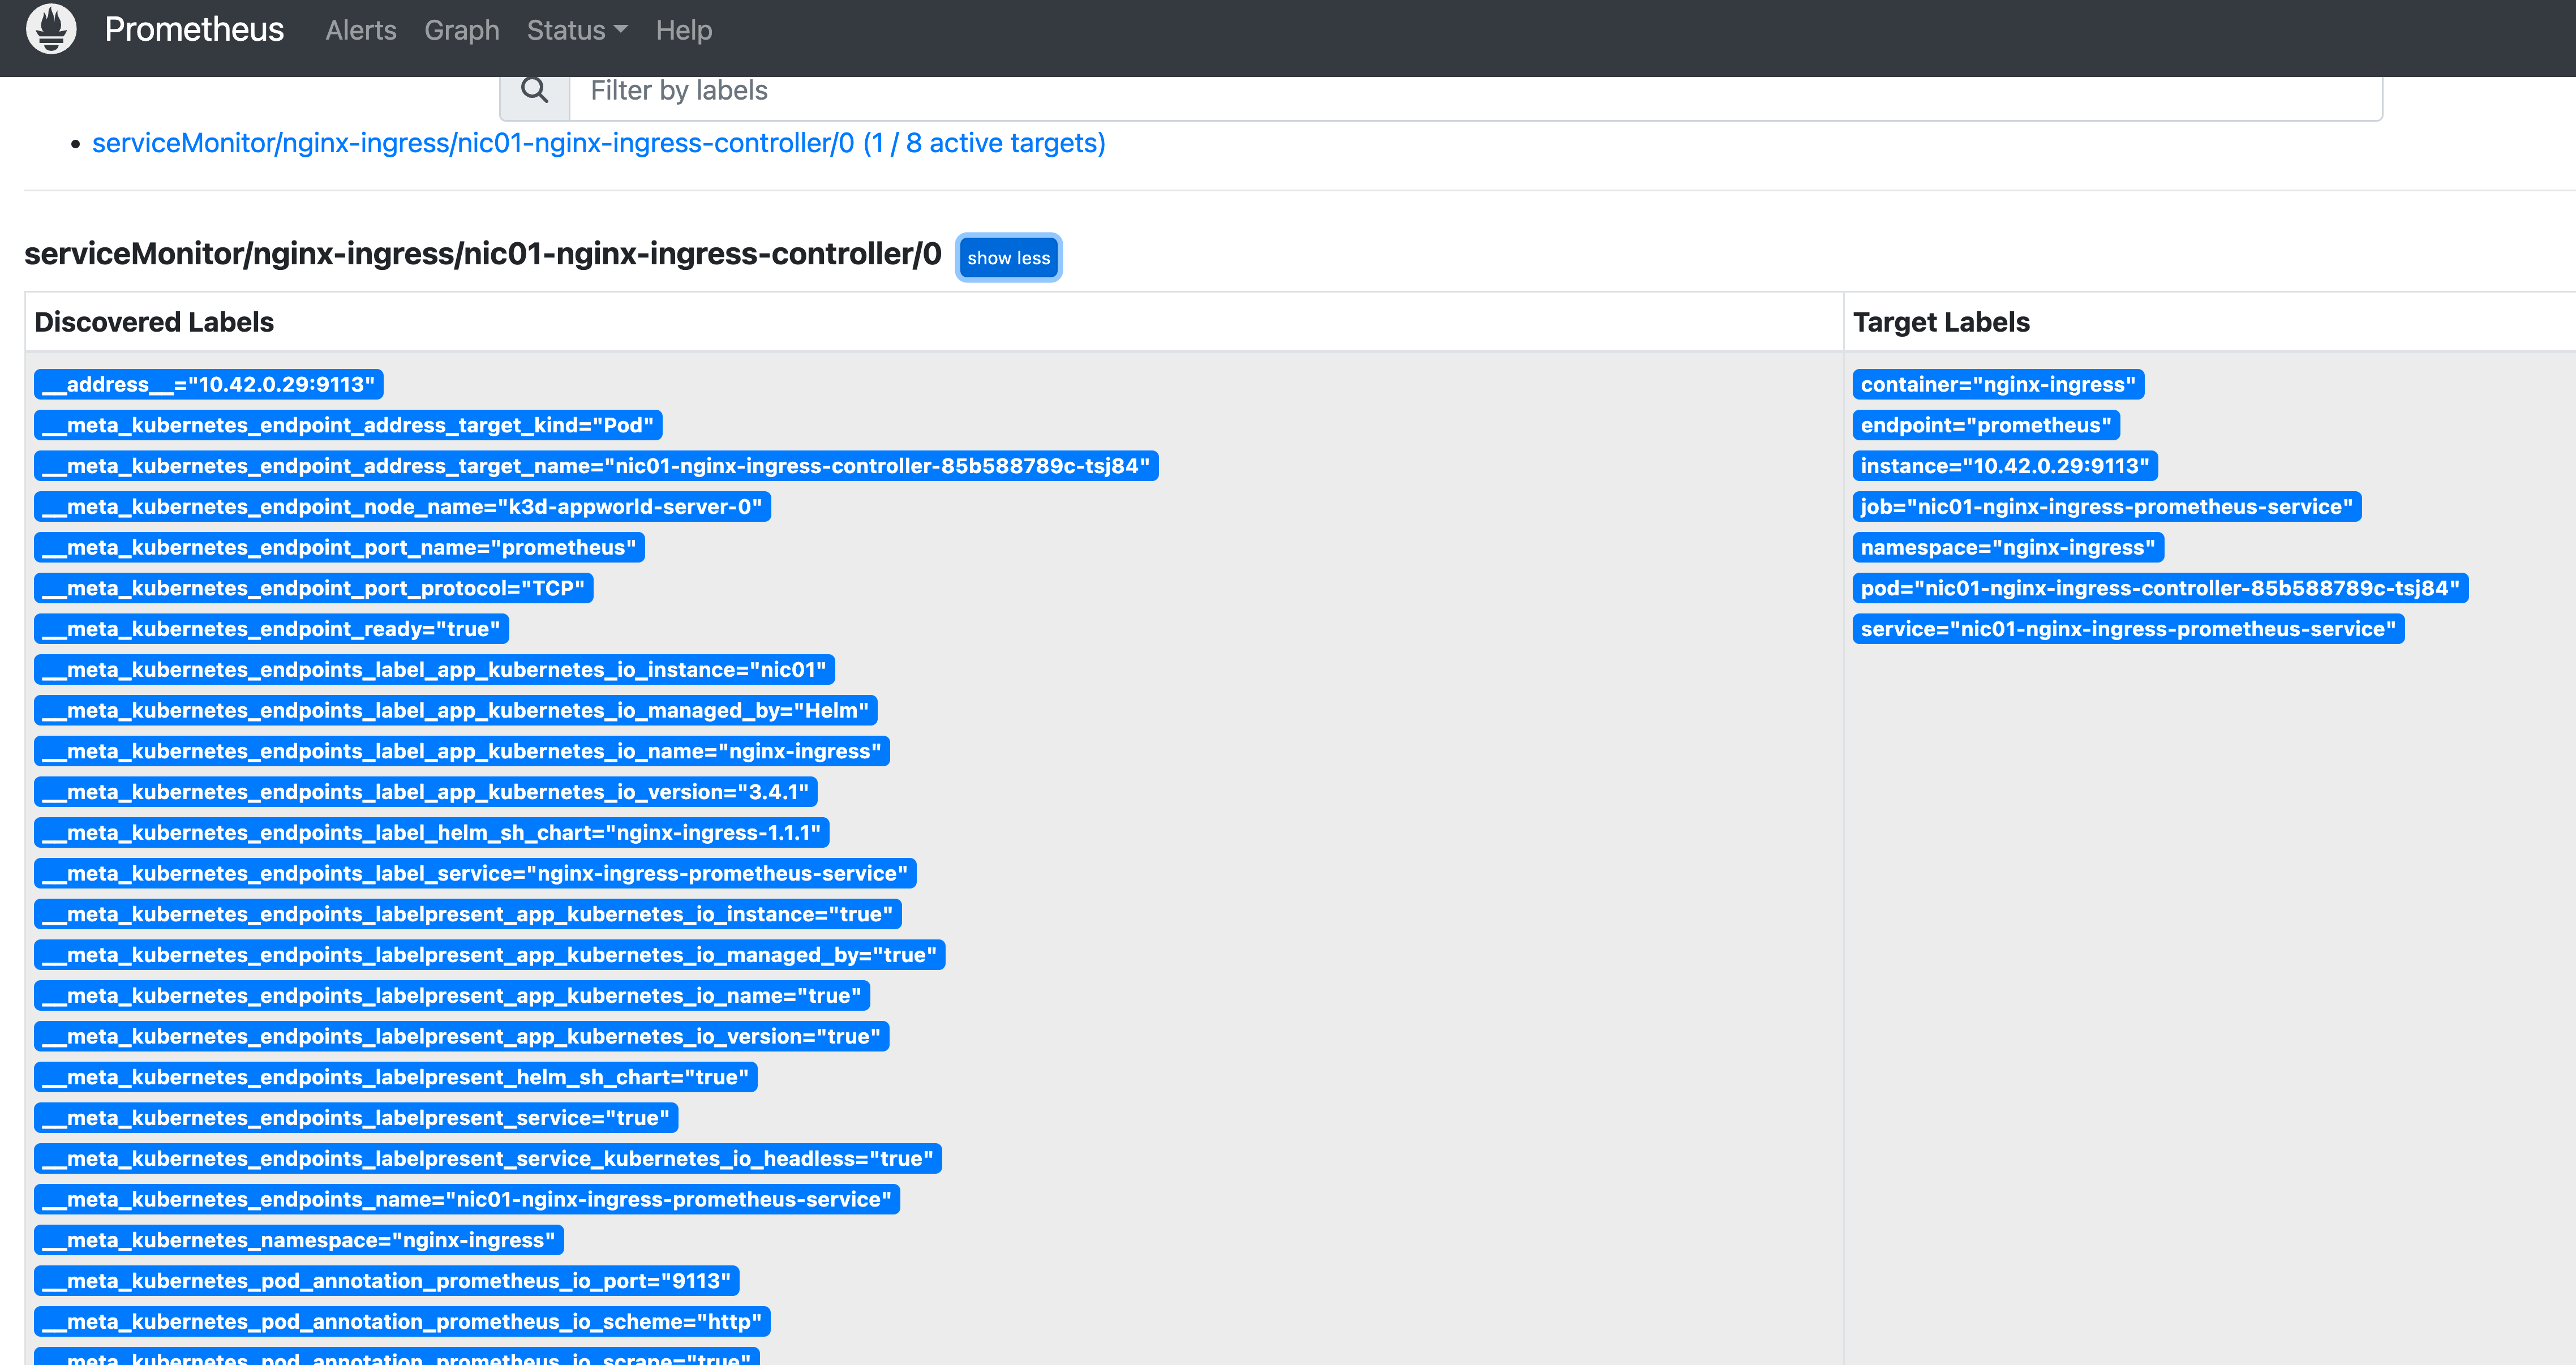
Abbildung 3: Prometheus-Ziel
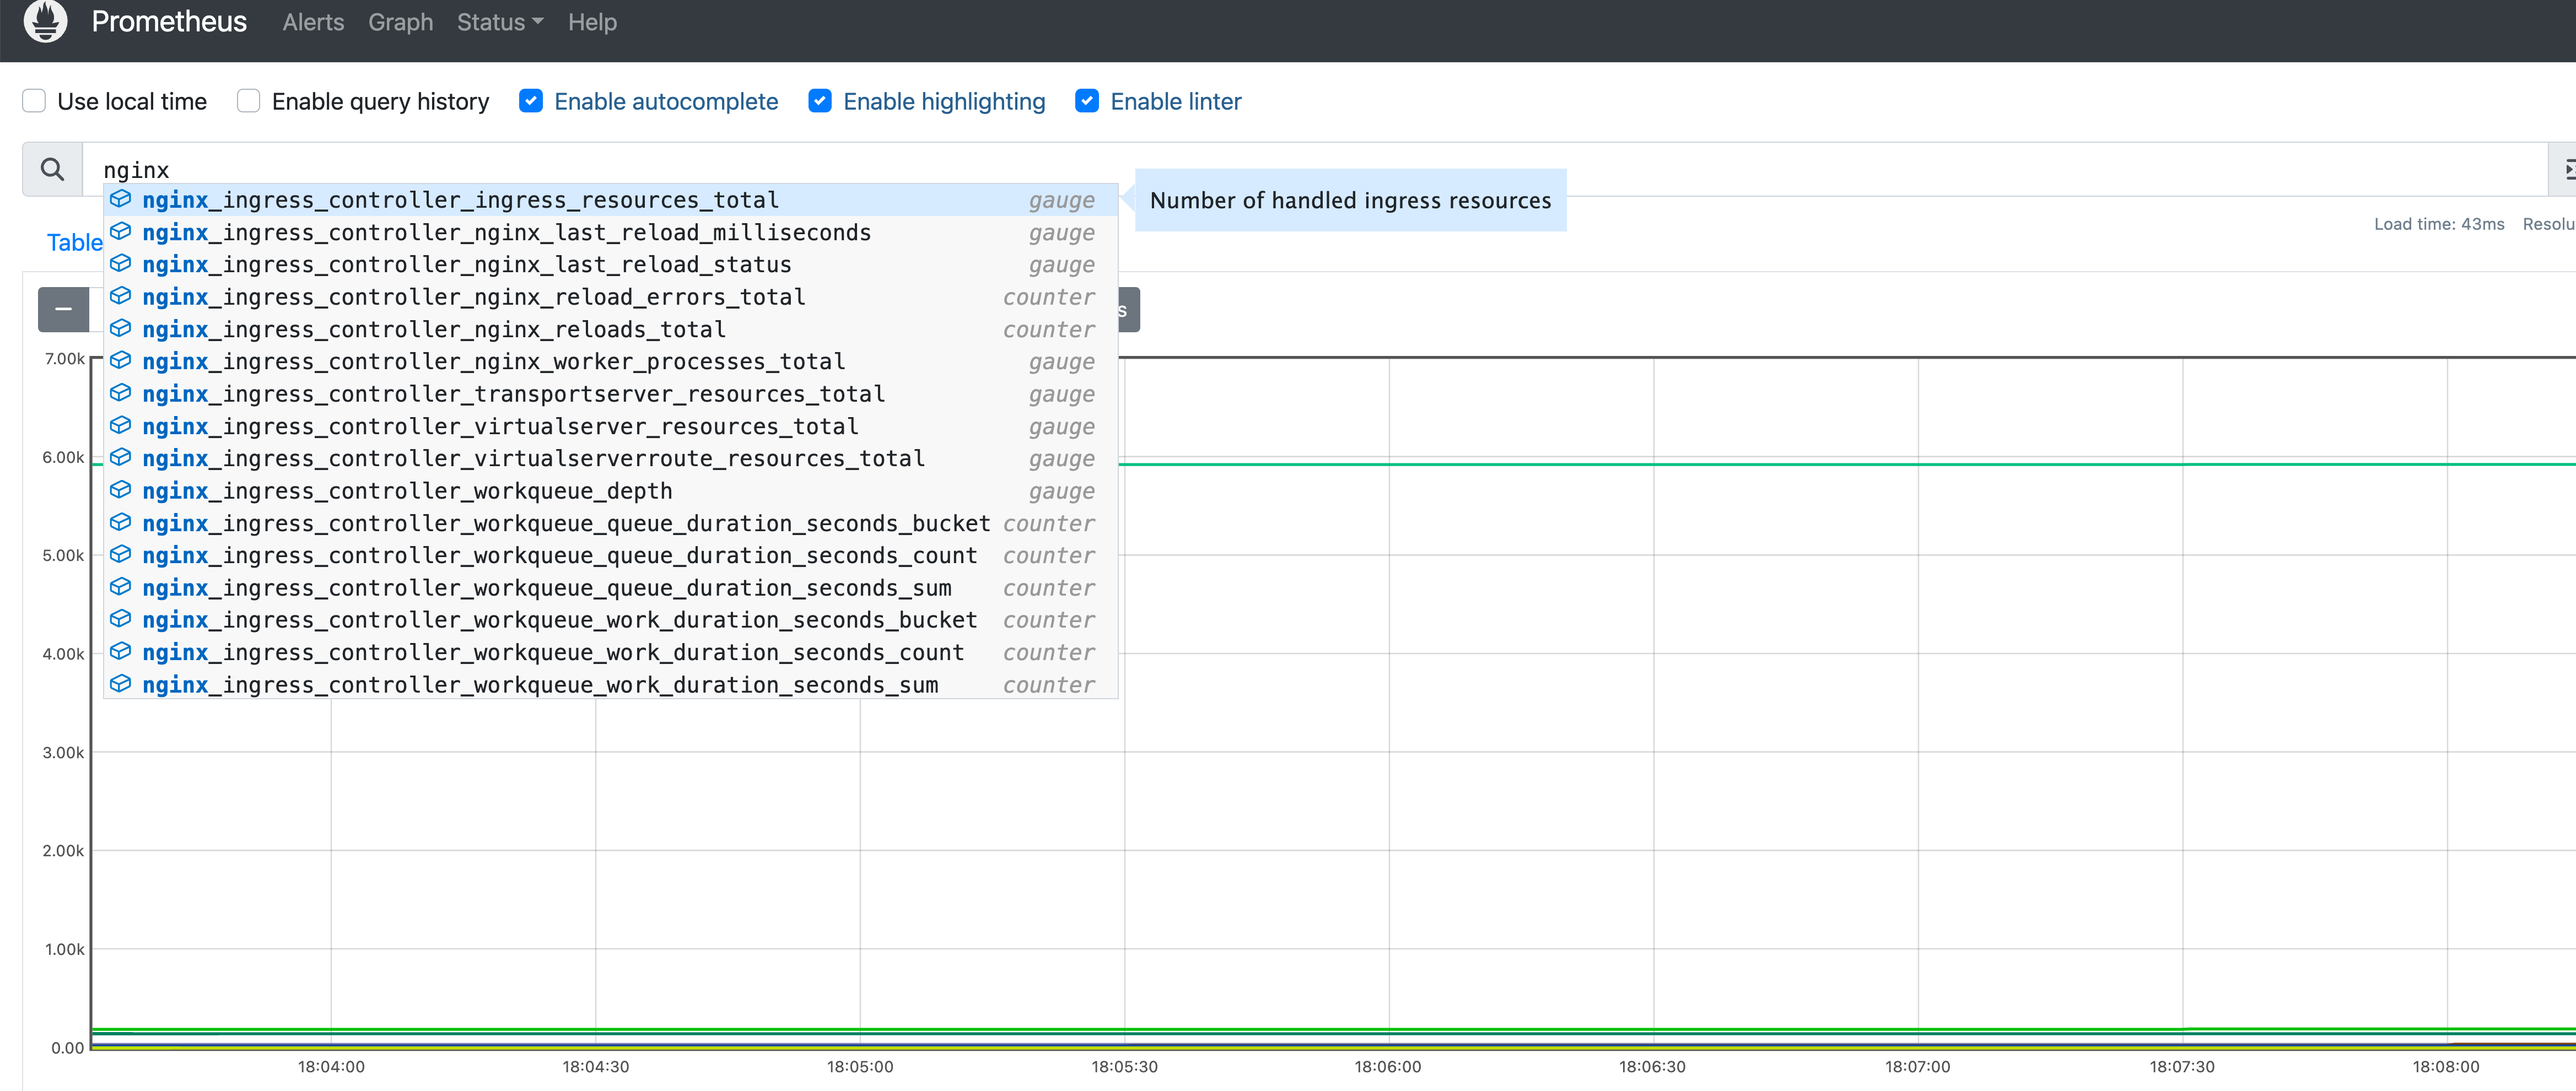
Wir sehen, dass der NGINX Ingress Controller mithilfe nativer Kubernetes-Tools wie Helm und Prometheus die Erfassung von Metriken gleich zu Beginn der Bereitstellung erheblich vereinfachen kann, da Metriken direkt einsatzbereit zur Verfügung stehen. Hier finden Sie Referenzdokumente zur Installation von prometheus-operator: https://prometheus-operator.dev/ https://github.com/prometheus-operator/prometheus-operator
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.