Red Hat OpenShift Container Platform (OCP) ist eine der beliebtesten verwalteten Kubernetes-Plattformen. Wie seine Mitbewerber bietet auch OCP standardmäßig Tools zur Datenverkehrsverwaltung, die Benutzern einen schnellen Einstieg ermöglichen. Der OCP Router – basierend auf HAProxy – ist der standardmäßige Einstiegspunkt für OCP-Cluster. Er kann HTTP- und WebSocket-Datenverkehr per Load Balancing verteilen, unterstützt TLS-Terminierung sowie TLS zwischen dem Router und den Anwendungsinstanzen und kann TLS-Verbindungen im Passthrough-Modus per Load Balancing verteilen.
Kunden fragen uns häufig: „Warum sollte ich den NGINX Ingress Controller in OpenShift verwenden, wenn der Router kostenlos verfügbar ist?“ In Warum Sie einen Ingress Controller der Enterprise-Klasse auf OpenShift benötigen erläutert Gastautor Max Mortillaro von GigaOm einige qualitative Gründe für den Einsatz des NGINX Ingress Controller: erweitertes Traffic-Management, Benutzerfreundlichkeit, JWT-Validierung und WAF-Integration. Es ist jedoch ebenso wichtig, diese Frage aus quantitativer Sicht zu beantworten. Deshalb haben wir die Performance des Routers und des auf NGINX Plus basierenden NGINX Ingress Controllers (nginxinc/kubernetes-ingress) in der OCP-Umgebung in einer dynamischen Bereitstellung getestet, bei der wir die Anzahl der Upstream-Server (Backend-Server) während des Tests hoch- und herunterskaliert haben.
Bei unseren Leistungstests betrachten wir zwei Faktoren, um die Leistungsfähigkeit der Tools zu bewerten:
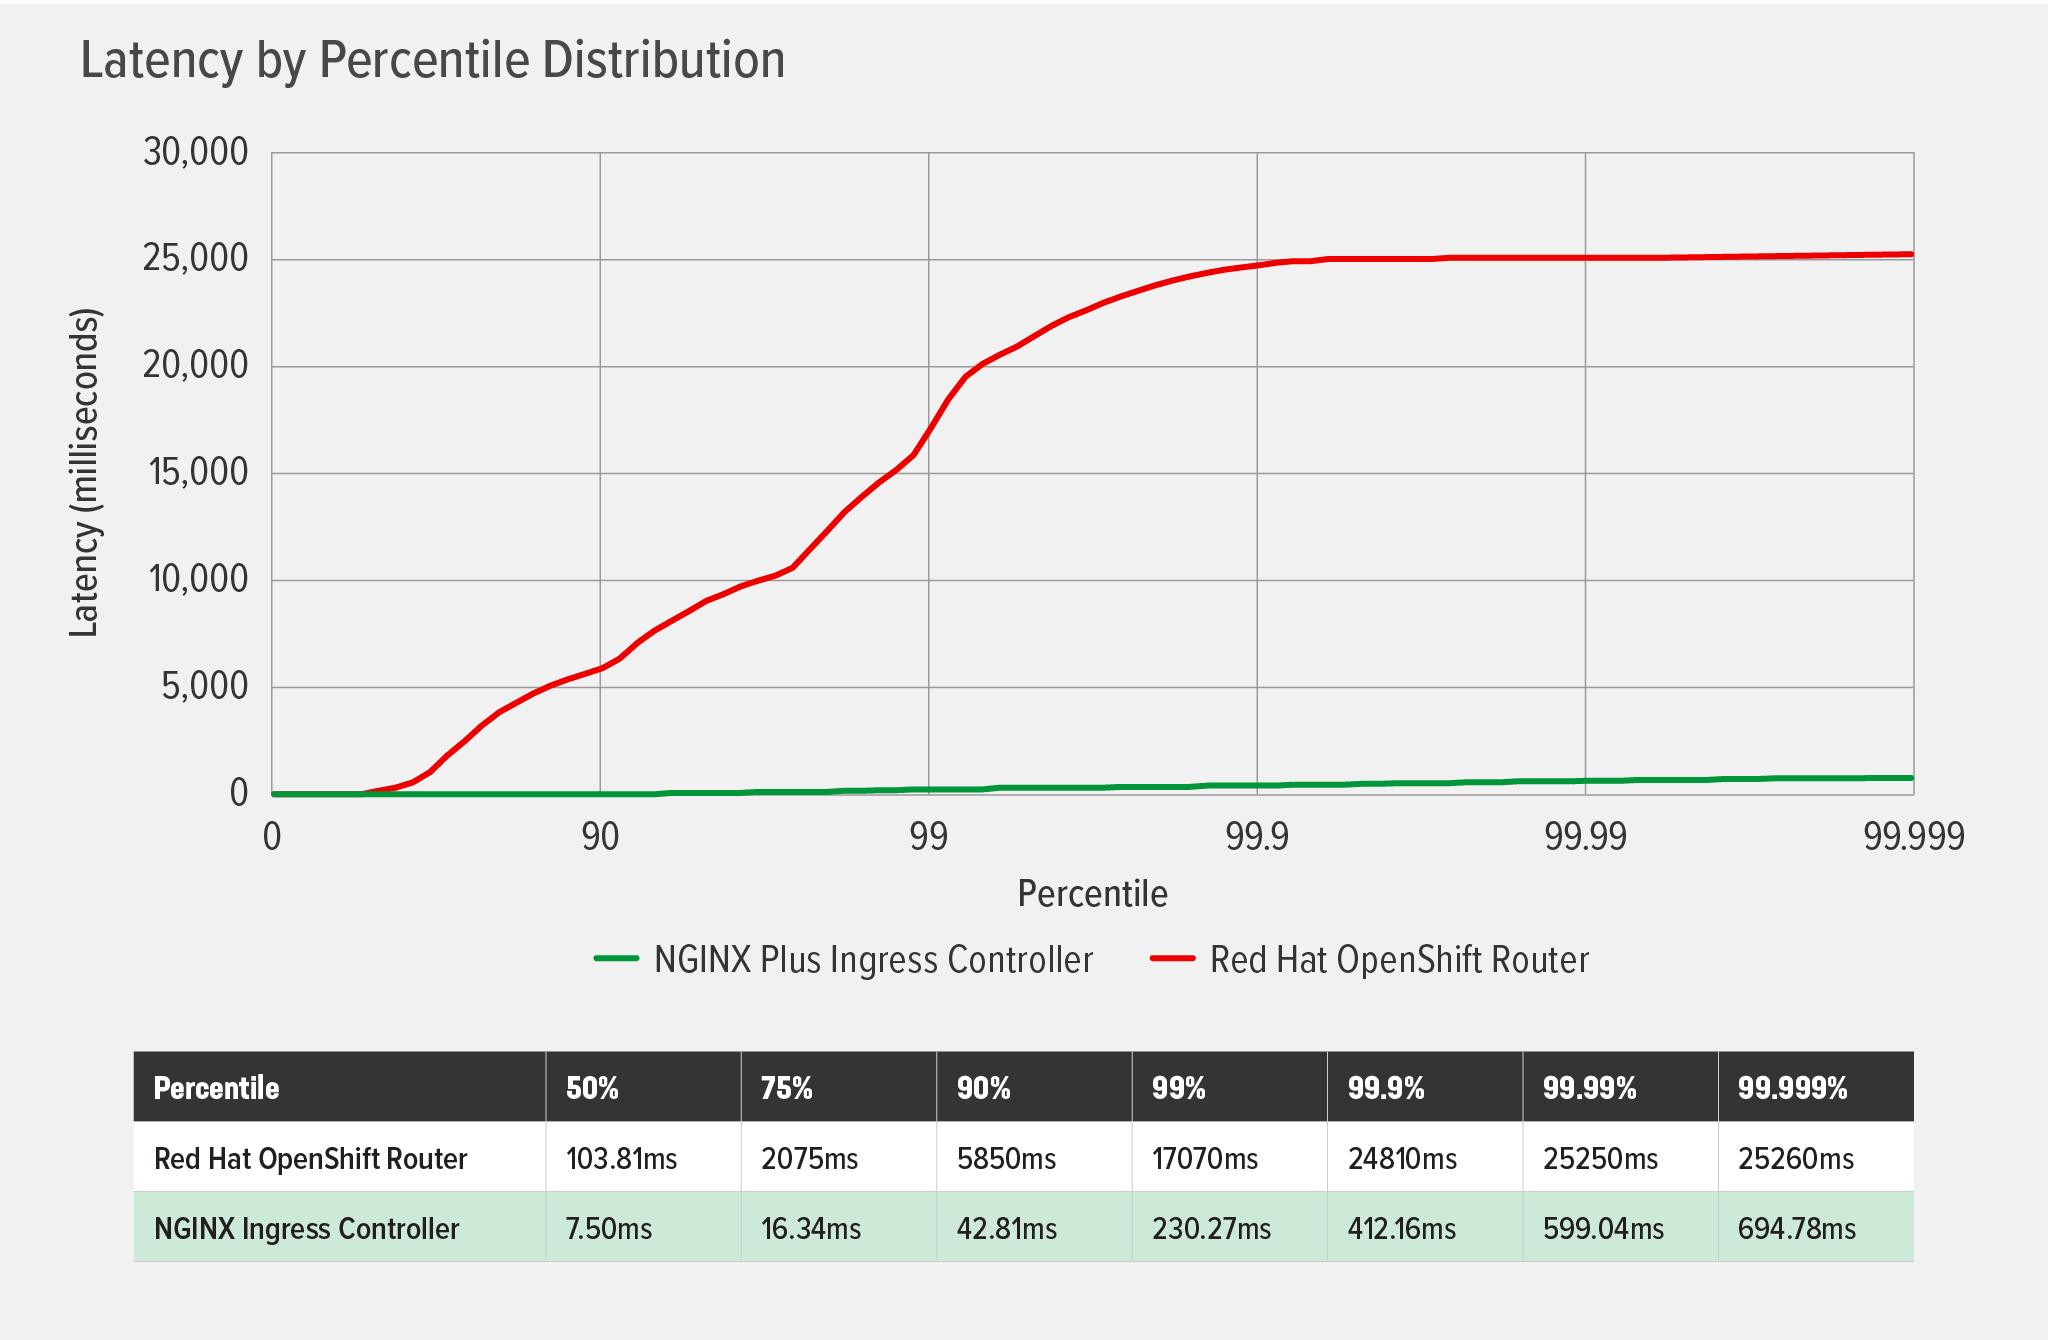
- Faktor 1: Latenzergebnisse für dynamische BereitstellungenWir haben festgestellt, dass die Verteilung der Latenzperzentile die aussagekräftigste Kennzahl zur Messung der Endbenutzererfahrung bei einer dynamischen Bereitstellung ist. Je mehr Latenz ein System verursacht, desto stärker wird die Benutzererfahrung beeinträchtigt. Außerdem müssen für ein realistisches Bild der Benutzererfahrung auch die Latenzwerte in den oberen Perzentilen der Verteilung berücksichtigt werden. Eine ausführliche Erläuterung finden Sie im Abschnitt Performance-Ergebnisse des Beitrags NGINX und HAProxy: Tests der Benutzererfahrung in der Cloud in unserem Blog.
- Faktor 2: Zeitüberschreitungen und FehlerWenn ein getestetes System bei einer dynamischen Bereitstellung Latenzen verursacht, liegt das in der Regel daran, dass das System Schwierigkeiten mit dynamischen Neuladungen hat und es zu Zeitüberschreitungen oder Fehlern kommt.
Ergebnisse der Leistungstests
Kommen wir gleich zum interessanten Teil und sehen uns die Ergebnisse an. Einzelheiten zum Testaufbau und zur Testmethode folgen.
Wie oben erläutert, berücksichtigen wir bei der Leistungsbewertung zwei Faktoren: Latenz sowie Zeitüberschreitungen/Fehler.
Faktor 1: Perzentilverteilung der Latenz
Wie das folgende Diagramm zeigt, verursachte der NGINX Ingress Controller während des gesamten Tests eine vernachlässigbare zusätzliche Latenz, die beim 99,999. Perzentil einen Höchstwert von weniger als 700 ms erreichte. Im Gegensatz dazu verursachte der OCP Router bereits bei relativ niedrigen Perzentilen zusätzliche Latenz. Diese stieg exponentiell an, bis sie beim 99,99. Perzentil ein Plateau von etwas mehr als 25.000 ms (25 Sekunden) erreichte. Dies zeigt, dass der Router bei hoher Last und häufigen Änderungen an der Clusterumgebung die Benutzererfahrung erheblich beeinträchtigen kann.
Faktor 2: Zeitüberschreitungen und Fehler
Die oben beobachtete Latenz lässt sich auf Zeitüberschreitungen und Fehler zurückführen: Beim OCP Router traten 260 Verbindungszeitüberschreitungen und 85 Lesesocket-Fehler auf, während beim NGINX Ingress Controller keine auftraten. Wie wir bereits bei anderen Leistungstests festgestellt haben (siehe Leistungstests für NGINX Ingress Controller in einer dynamischen Kubernetes-Cloud-Umgebung), werden die Zeitüberschreitungen und Fehler des Routers durch die Art und Weise verursacht, wie HAproxy dynamische Neuladungen verarbeitet. Der auf NGINX Plus basierende NGINX Ingress Controller verursacht keine Zeitüberschreitungen oder Fehler, da er die NGINX Plus API verwendet, um die NGINX-Konfiguration bei Änderungen an Endpunkten dynamisch zu aktualisieren.
Testaufbau und Methodik
Testtopologie
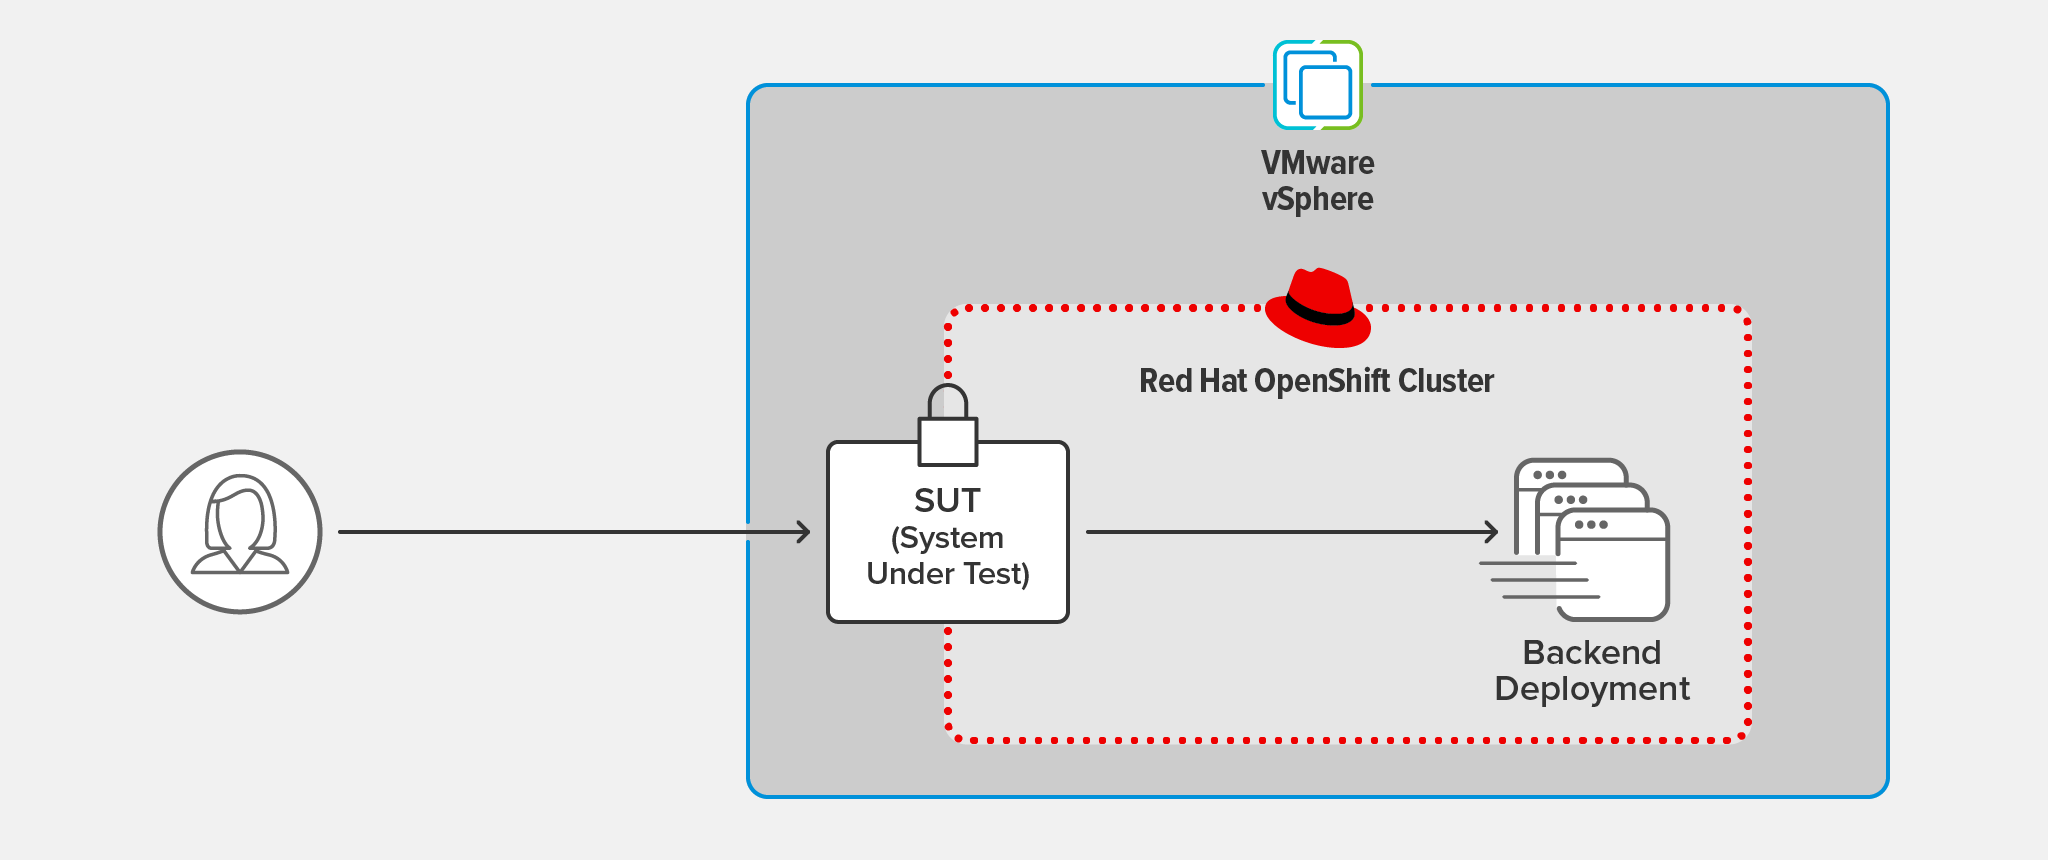
Wir führten dieselben Tests sowohl mit dem NGINX Ingress Controller als auch mit dem OpenShift Router als zu testendem System (System Under Test, SUT) durch. Das SUT terminierte die TLS-1.3-Verbindungen des Clients und leitete die Clientanfrage über eine separate Verbindung an die Backend-Bereitstellung weiter.
Der Client wurde auf einem separaten Rechner mit CentOS 7 ausgeführt, der sich im selben LAN wie der OpenShift-Cluster befand.
Das SUT und die Backend-Bereitstellung wurden in einem OCP-Cluster ausgeführt, der auf VMware vSphere 6.7.0.45100 gehostet wurde.
Für die TLS-Verschlüsselung verwendeten wir RSA mit einer Schlüssellänge von 2048 Bit und Perfect Forward Secrecy.
Jede Antwort der Backend-Anwendung bestand aus etwa 1 KB grundlegender Servermetadaten sowie dem HTTP-Statuscode 200 OK.
Testmethodik
Client-Bereitstellung
Mit wrk2 (Version 4.0.0) führten wir das folgende Skript auf dem Client-Rechner aus. Der Test lief 60 Sekunden lang (festgelegt mit der Option -d) bei einem konstanten Durchsatz von 1000 Anfragen pro Sekunde (RPS, festgelegt mit der Option -R):
./wrk -t 2 -c 50 -d 60s -R 1000 -L https://ingress-url:443/Verwendete SUT-Software
- OpenShift Platform Version 4.8, die standardmäßig den HAProxy-basierten Router enthält
- NGINX Ingress Controller Version 1.11.0 (NGINX Plus R22)
Backend-Bereitstellung
Wir führten Testläufe mit einer dynamischen Bereitstellung der Backend-Anwendung durch. Dabei verwendeten wir das folgende Skript, um die Anzahl der Backend-Replikate regelmäßig zu erhöhen und zu verringern. Dies simuliert eine dynamische OpenShift-Umgebung und misst, wie effektiv sich der NGINX Ingress Controller bzw. der OCP Router an Änderungen der Endpunkte anpasst.
while [ 1 -eq 1 ]
do
  oc scale deployment nginx-backend --replicas=4
  sleep 10
  oc scale deployment nginx-backend --replicas=2
  sleep 10
done
Fazit
Die meisten Unternehmen, die auf Microservices-Methoden setzen, schleusen neue Entwicklungen häufiger denn je durch ihre CI/CD-Pipelines. Daher ist es entscheidend, eine Datenebene zu nutzen, deren Funktionsumfang und Leistung mit diesen neuen Methoden wachsen, ohne die Benutzererfahrung zu beeinträchtigen. Eine optimale Benutzererfahrung setzt voraus, dass für alle Clientverbindungen unter allen Umständen durchgängig niedrige Latenzzeiten gewährleistet werden.
Den Leistungsergebnissen zufolge bietet der NGINX Ingress Controller eine optimale Endbenutzererfahrung in containerisierten Umgebungen, in denen ein hoher Bedarf an iterativer Weiterentwicklung und Verbesserung besteht.
Laden Sie zunächst eine kostenlose Testversion des NGINX Ingress Controllers herunter und erfahren Sie, wie Sie die Bereitstellung mit dem NGINX Ingress Operator durchführen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.