Die Skalierung von Containern erfordert mehr, als einfach einen Proxy vor einen Dienst zu schalten und es dabei zu belassen. Skalierung umfasst mehr als nur die Verteilung, und in der schnelllebigen Welt der Container sind fünf verschiedene Funktionen erforderlich, um Skalierbarkeit zu gewährleisten: Wiederholungsversuche, Circuit Breaker, Diensterkennung, Verteilung, und Monitoring.
In diesem Beitrag über die Kunst der Skalierung von Containern befassen wir uns eingehend mit dem Monitoring.
Monitoring
Überwachung. In einer Zeit, in der scheinbar alles mithört und/oder beobachtet – von unserer Fahrgeschwindigkeit bis hin zum Inhalt unseres Kühlschranks –, hinterlässt dieses Wort bei vielen einen bitteren Beigeschmack. Wir können – und tun dies häufig – stattdessen den Begriff „Transparenz“ verwenden, doch diese semantische Spitzfindigkeit ändert nichts an dem, was wir tun: Wir beobachten alles ganz genau.
Bei der Skalierung hängt alles vom Monitoring ab – davon, den Zustand der Ressourcen zu kennen, auf die Anfragen verteilt werden. Eine Anfrage an eine „tote Zone“ zu senden, weil die Ressource ausgefallen ist oder vor Kurzem heruntergefahren wurde, ist so, als würde man in eine Sackgasse ohne Ausfahrt einbiegen. Das ist reine Zeitverschwendung.
Monitoring gibt es in vielen Varianten. Da wäre die „Kann ich dich erreichen?“-Überwachung mittels Ping auf der Netzwerkebene. Dann gibt es die „Bist du zu Hause?“-Überwachung über eine TCP-Verbindung und die „Machst du die Tür auf?“-Überwachung mittels einer HTTP-Anfrage. Schließlich gibt es noch die „Hattest du schon deinen Kaffee?“-Überwachung, die feststellt, ob der Dienst korrekt antwortet.
Neben der reinen Überprüfung des Zustands und der Ausführung eines Dienstes spielt auch die Leistungsüberwachung eine Rolle. Wie schnell der Dienst geantwortet hat, ist entscheidend, wenn Anfragen anhand der Antwortzeiten verteilt werden. Plötzliche Leistungsänderungen können auf Probleme hindeuten. Daher handelt es sich um historisch relevante Daten, die ebenfalls überwacht werden müssen.
Es gibt aktives Monitoring (ich sende dir eine echte Anfrage!), synthetisches Monitoring (ich sende dir eine simulierte Anfrage) und passives Monitoring (ich sitze einfach hier und beobachte, was mit einer echten Anfrage passiert). Jede Methode hat Vor- und Nachteile, und alle sind valide Monitoring-Methoden. Entscheidend ist, dass der Proxy den Status ermitteln kann: Ist der Dienst verfügbar? Ist er ausgefallen? Oder hat er zusammen mit Elvis das Gebäude verlassen?
Erreichbarkeit, Verfügbarkeit und Leistung sind allesamt Aspekte des Monitorings und notwendig, um Skalierbarkeit zu gewährleisten. Das bedeutet, dass es nicht nur um das Monitoring geht, sondern auch darum, sicherzustellen, dass die Load-Balancing-Proxys über aktuelle Informationen zum Status jeder Ressource verfügen, an die sie eine Anfrage weiterleiten könnten.
Wenn man sich die Eigenschaften von Containern und die Tendenz vor Augen führt, sie mit einer auf Microservices basierenden Architektur zu kombinieren, wird schnell klar, dass das Monitoring zu einer wahren Herkulesaufgabe werden kann. Das liegt daran, dass Forward- und Sidecar-Proxys das gängigste Modell für den Lastausgleich in Containerumgebungen darstellen. Bei beiden muss jeder Knoten über den Zustand und die Verfügbarkeit jeder Ressource informiert sein, an die er möglicherweise eine Anfrage senden muss. Das bedeutet, dass praktisch jede Ressource überwacht werden muss.
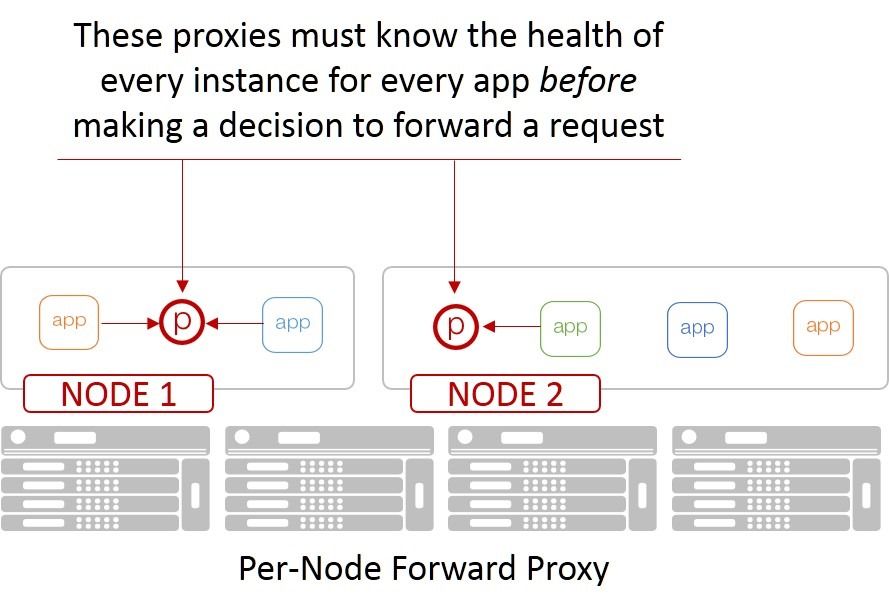
Sie können sich vorstellen, dass es für eine bestimmte Ressource nicht gerade effizient ist, ihre eigenen begrenzten Ressourcen dafür aufzuwenden, fünfzehn oder zwanzig Forward-Proxys über ihren Status zu informieren. Die Überwachung in einem solchen Modell wirkt sich deutlich negativ auf Leistung und Kapazität aus, was die Skalierung zusätzlich erschwert.
Noch nie hatte das Monitoring so erhebliche Auswirkungen auf die Skalierbarkeit, wie wir sie bei Containern beobachten.
Und dennoch ist dies von entscheidender Bedeutung – wie oben erwähnt –, denn wir wollen möglichst keine Zeit mit Ressourcen verschwenden, die sich als Sackgasse erweisen.
Die Herausforderungen der erforderlichen Überwachung sind einer der Gründe dafür, dass sich das Service Mesh als zukünftiges Skalierungsmodell in Container-Umgebungen zunehmender Beliebtheit erfreut (und immer mehr durchsetzt).
Denn Monitoring ist unverzichtbar, sollte aber auch keine Belastung darstellen.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...