Die Skalierung von Containern bedeutet mehr, als einfach einen Proxy vor einen Dienst zu schalten und die Sache damit als erledigt zu betrachten. Skalierung umfasst mehr als nur die Verteilung, und in der schnelllebigen Welt der Container sind fünf unterschiedliche Funktionen erforderlich, um Skalierbarkeit zu gewährleisten: Wiederholungsversuche, Leistungsschalter, Diensterkennung, Verteilung und Überwachung.
In diesem Beitrag über die Kunst der Containerskalierung befassen wir uns eingehender mit der Verteilung.
Verteilung
Das Erfolgsrezept für die Skalierung beliebiger Systeme hängt seit jeher unter anderem davon ab, wie Anfragen auf eine begrenzte Anzahl von Ressourcen verteilt werden. Daran ändern auch die Cloud und ihre scheinbar unbegrenzte Rechenleistung nichts. In dem Moment, in dem eine Anfrage eingeht, ist die Liste der verfügbaren Ressourcen, die diese Anfrage annehmen und verarbeiten können, endlich. Punkt.
Die Entscheidung, an welche Ressource eine Anfrage weitergeleitet werden soll, ist daher von großer Bedeutung. Wird sie an die falsche Ressource gesendet, kann die Leistung darunter leiden. Wird sie an die richtige Ressource gesendet, werden Kunden bzw. Mitarbeitende mit dem Ergebnis sehr zufrieden sein.
In den Anfangszeiten der Skalierung basierten diese Entscheidungen ausschließlich auf Algorithmen: Round Robin, geringste Anzahl an Verbindungen, schnellste Antwort. Diese bewährten Mechanismen gibt es auch heute noch, doch nach und nach sind sie von der alleinigen Entscheidungsgrundlage zu einem von mehreren Faktoren im Entscheidungsprozess geworden.
Das liegt daran, dass wir uns bei Entscheidungsprozessen nicht mehr ausschließlich auf Verbindungen stützen (auch bekannt als „klassischer Lastenausgleich“). Als es beim Lastenausgleich hauptsächlich um die Verwaltung von TCP-Verbindungen ging, waren verbindungsbasierte Verteilungsschemata sinnvoll. Doch Skalierbarkeit hängt heute ebenso sehr von der Architektur wie von Algorithmen ab, und die Verteilung von Anfragen kann eine komplexe Berechnung sein, die viele Variablen oberhalb (im wahrsten Sinne des Wortes) und jenseits von Schicht-4-Protokollen einbezieht.
Die Verteilung wird zusätzlich dadurch erschwert, dass heutige Architekturen selbst zunehmend verteilt sind – nicht nur über mehrere Clouds hinweg, sondern auch über mehrere Container. Mehrere Versionen derselben App (oder API) können gleichzeitig in Betrieb sein. Das für die Verteilung der Anfrage zuständige System muss dies berücksichtigen, zwischen ihnen unterscheiden und die Zustellung an den richtigen Endpunkt sicherstellen.
Heute werden Entscheidungen nicht mehr nur auf Grundlage der Verbindungskapazität getroffen, sondern zunehmend auch anhand von Parametern der Schicht 7 (HTTP): Hostnamen, API-Methoden (auch als URI bezeichnet), API-Schlüssel, benutzerdefinierte HTTP-Header mit eingebetteten Versionsnummern, Standort, Gerät und Benutzer. Anfragen werden in ihrem jeweiligen Kontext ausgewertet und Entscheidungen innerhalb von Mikrosekunden getroffen.
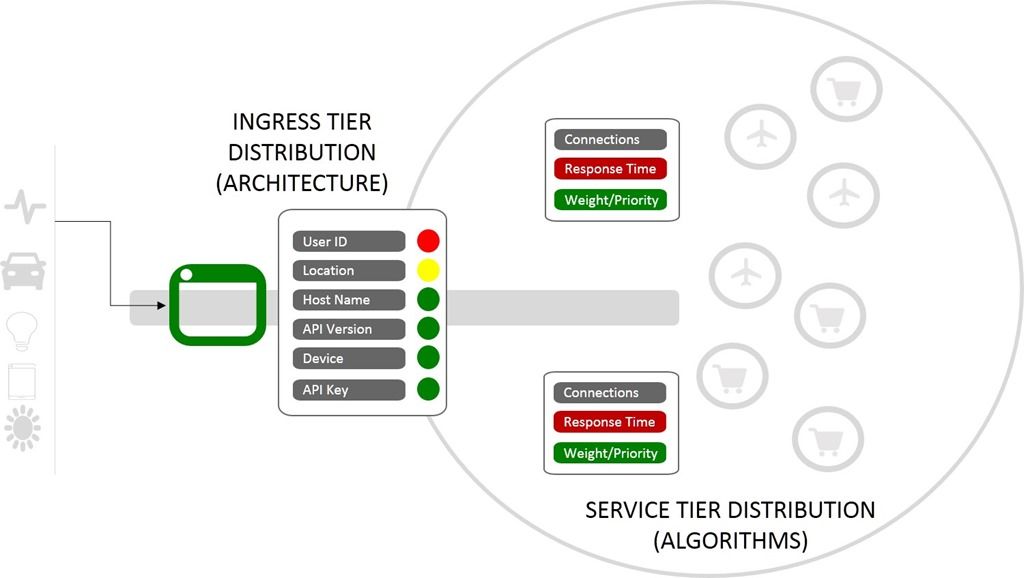
Die Verteilung erfordert heute einen mehrstufigen Architekturansatz. Je tiefer man in die Anwendungsarchitektur vordringt, desto geringer wird die Granularität. Wenn ein Proxy eine Entscheidung zur Lastverteilung zwischen X Klonen desselben Microservices trifft, verwendet er möglicherweise lediglich herkömmliche algorithmusbasierte Berechnungen. An den äußeren Rändern der Umgebung treffen Ingress-Controller hingegen mitunter komplexe Entscheidungen auf Grundlage von Variablen der HTTP-Schicht.
Nach außen hin wird die Verteilung durch Architektur bestimmt. Im Inneren durch Algorithmen.
Beides sind entscheidende Komponenten – vielleicht sogar die entscheidendsten – für die Skalierung von Containern.
Beide sind auf präzise Echtzeitinformationen über den Status (Zustand) der Ressourcen angewiesen, auf die sie Anfragen verteilen könnten. Mit dem Monitoring werden wir uns in den nächsten Beiträgen dieser Reihe befassen.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...