
Datenorchestrierung
Datenorchestrierung automatisiert die Übertragung, Transformation und Governance von Daten in komplexen Daten- und KI-Pipelines.
Datenorchestrierung bezeichnet die automatisierte Koordination, Transformation und Übertragung von Daten über verschiedene Systeme, Pipelines und Umgebungen hinweg. Sie stellt sicher, dass Daten zuverlässig erfasst, standardisiert, verwaltet und für Analysen, Anwendungen und KI-Workloads bereitgestellt werden.
Was ist Datenorchestrierung?
Die Datenorchestrierung steuert den gesamten Lebenszyklus von Daten – von der Aufnahme und Transformation bis hin zur Aktivierung und Bereitstellung in Data Lakes, Data Warehouses, operativen Systemen und KI-Pipelines. Sie automatisiert Workflows, die manuelle Übergaben und isolierte Skripte ersetzen, und stellt so sicher, dass Daten in verteilten Umgebungen korrekt, aktuell und einheitlich formatiert bleiben.
Datenorchestrierung vs. Datenintegration vs. ETL
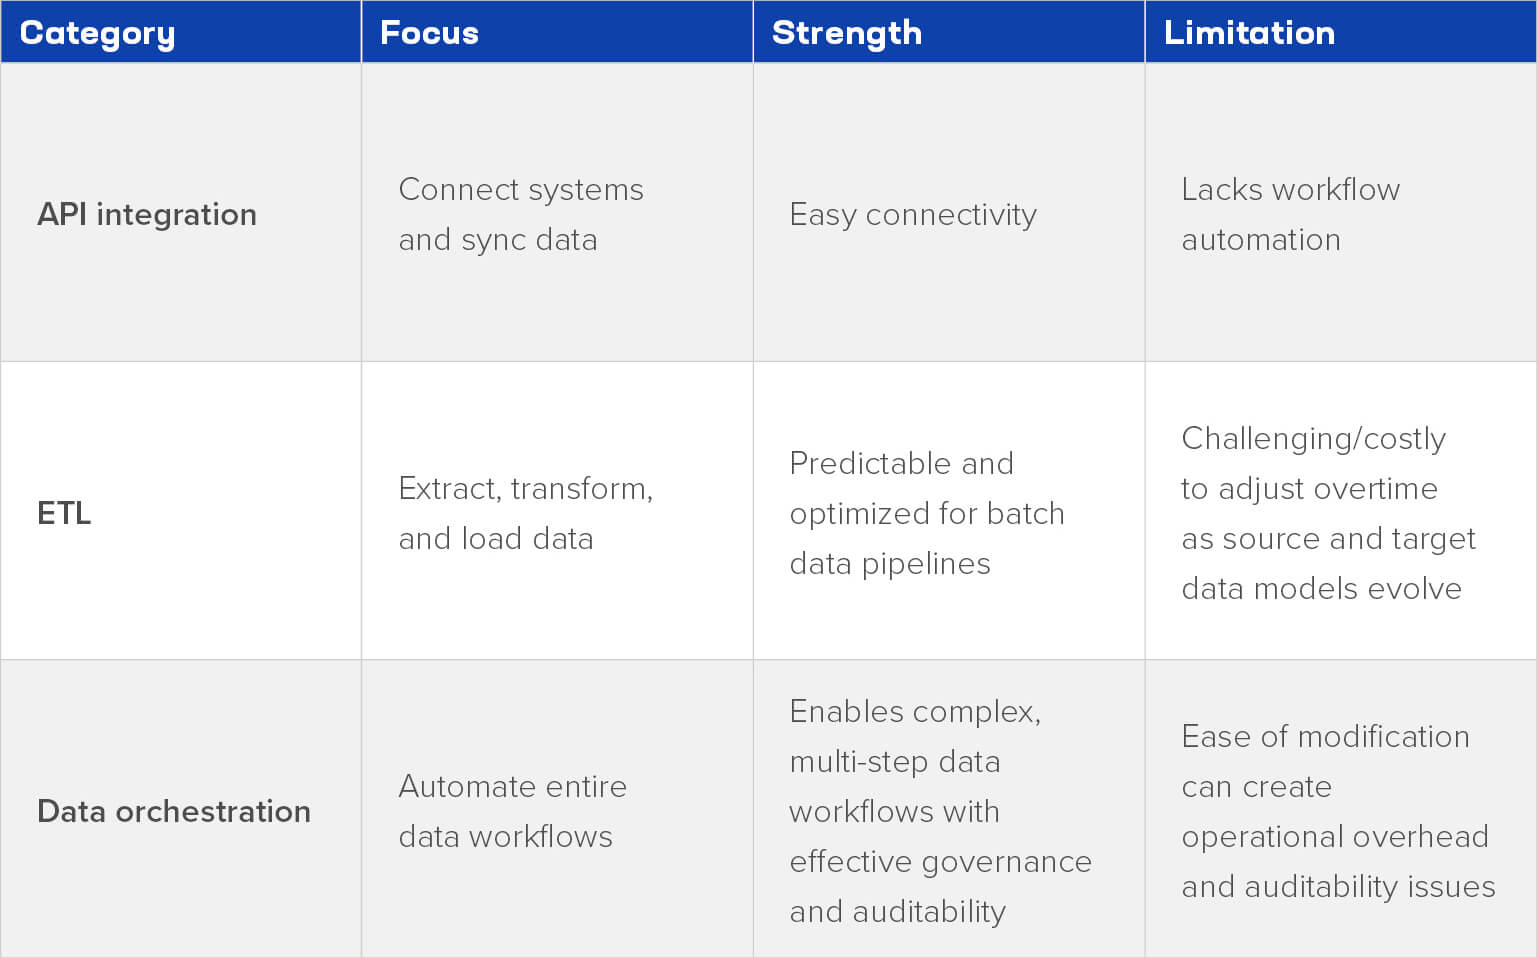
Datenintegration führt Daten aus mehreren Quellen zusammen, konzentriert sich jedoch in der Regel auf die Konnektivität. ETL-Tools extrahieren und transformieren Daten und laden sie in Zielsysteme, häufig im Batchbetrieb.
Die Datenorchestrierung koordiniert sämtliche Daten-Workflows – einschließlich Batchverarbeitung, Streaming, Multicloud, Analysen und KI – und stellt sicher, dass sie in der richtigen Reihenfolge sowie unter Einhaltung von Qualitäts- und Governance-Vorgaben und mit entsprechender Überwachung ausgeführt werden.
Moderne Daten-Stacks sind auf Datenorchestrierung angewiesen
Da Unternehmen zunehmend auf Multicloud-Bereitstellungen, Echtzeitanalysen und KI-gestützte Anwendungen setzen, übersteigen Datenvolumen und -geschwindigkeit die Kapazität manueller Prozesse. Datenorchestrierung stellt sicher, dass Pipelines kontinuierlich hochwertige, kontrollierte Daten zur Verarbeitung an nachgelagerte Systeme liefern.
KI-Orchestrierung baut auf Datenorchestrierung auf
Datenorchestrierung bildet die Grundlage des Datenmanagements und umfasst Daten-Workflows, Datenerfassung, Datenbereinigung und die Übertragung nutzbarer Daten. KI-Orchestrierung erweitert die Datenorchestrierung auf den gesamten Lebenszyklus des maschinellen Lernens (ML). Dazu gehören die Koordination von Feature-Pipelines (die speziell für Vorhersagen strukturiert sind), das Modelltraining (Ressourcenplanung und Datensatzverwaltung), die Modellbereitstellung, die Überwachung von Modelldrift und -genauigkeit sowie Feedbackschleifen für erneutes Training oder die Feinabstimmung.
Warum ist Datenorchestrierung wichtig?
Datenorchestrierung bietet Unternehmen mehrere Vorteile:
- Verbessert die Zuverlässigkeit und Qualität von Daten: Standardisiert Daten aus verschiedenen Quellen, setzt Governance-Richtlinien durch und gewährleistet eine konsistente Bereitstellung für Analyse- und KI-Systeme.
- Beschleunigt Daten- und KI-Pipelines: Automatisiert die Abfolge von Workflows und die Fehlerbehandlung und reduziert so den manuellen Entwicklungsaufwand.
- Unterstützt Echtzeiteinblicke: Unterstützt nativ Streaming- und ereignisbasierte Workflows und ermöglicht so schnelle Entscheidungen.
- Stärkt Governance und Compliance: Nutzt Metadaten zur Nachverfolgung (Quellen, Änderungen und Fortschritt), zur Datenherkunft (Audit-Trails) und für Zugriffskontrollen (Durchsetzung), damit Teams regulatorische Vorgaben und Sicherheitsanforderungen erfüllen können.
- Skaliert mit Multicloud- und Hybridumgebungen: Orchestriert Daten über verteilte Architekturen hinweg, ohne herkömmliche, störanfällige Punkt-zu-Punkt-Integrationen von Altsystemen.
Wie funktioniert die Datenorchestrierung?
Die Datenorchestrierung umfasst in der Regel vier Phasen:
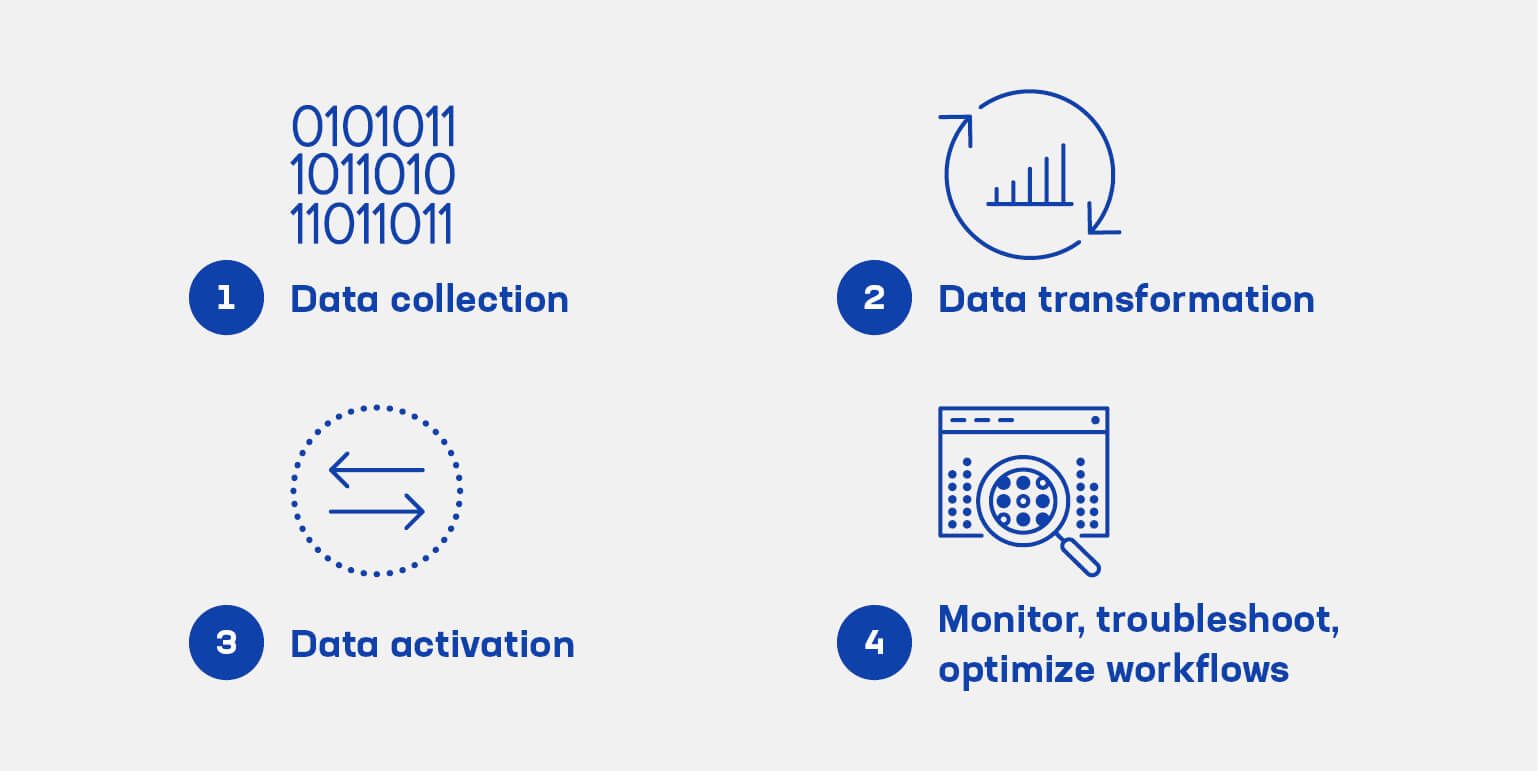
1. Daten aufnehmen und erfassen: Stellt Verbindungen zu Datenbanken, SaaS-Systemen, Protokollen, APIs, IoT-Geräten und Streaming-Plattformen her.
2. Daten transformieren und standardisieren: Führt Schemavalidierungen, Bereinigungen, Normalisierungen, Anreicherungen und Qualitätsprüfungen für Daten durch.
3. Daten aktivieren und bereitstellen: Leitet aufbereitete Daten an Data Lakes, Data Warehouses, BI-Tools, operative Systeme und KI-/ML-Pipelines weiter.
4. Workflows überwachen, Fehler beheben und optimieren: Überwacht Leistung, Datenherkunft, Datenaktualität und den Zustand der Pipelines.
Zu den wichtigsten Komponenten eines Datenorchestrierungssystems gehören:
- Workflow-Engine zur Sequenzierung von Pipelines
- Konnektoren und Integrationsframeworks
- Metadatenmanagement und Datenherkunft
- Qualitätsprüfungen und Durchsetzung von Richtlinien
- Beobachtbarkeit und Protokollierung
- Fehlerbehandlung und Wiederholungsversuche
Wie handhabt F5 die Datenorchestrierung?
F5 ermöglicht es Unternehmen, orchestrierte Daten- und KI-Pipelines sicher, zuverlässig und skalierbar zu betreiben, indem die zugrunde liegende Infrastruktur für Datenverkehr, APIs und Observability gestärkt wird, von der diese Pipelines abhängen.
Sichere und kontrollierte Datenbereitstellung: KI-Datenpipelines sind auf APIs, Dienste und verteilte Speichersysteme angewiesen. F5 schützt diese Pfade durch Inline-Inspektion, API-Governance, rollenbasierte Zugriffskontrolle (RBAC) und verschlüsseltes Traffic-Management. So wird gewährleistet, dass sensible Daten sicher und geschützt zwischen Hybrid- und Multi-Cloud-Umgebungen übertragen werden.
Optimierte, leistungsstarke Konnektivität: Die Datenorchestrierung erstreckt sich häufig über mehrere Netzwerke, Clouds und Anwendungen. Die F5 Application Delivery and Security Platform (ADSP) bietet Routing mit hoher Bandbreite, Lastverteilung und Leistungsoptimierung, um die Latenz zu minimieren und Engpässe in den Pipelines zu vermeiden.
KI-Governance und modellbezogener Schutz: F5 AI Guardrails setzt Richtlinienkontrollen in Echtzeit durch, indem Anfragen, Antworten und Datenflüsse zwischen Anwendungen und KI-Modellen überwacht werden. Die Lösung verhindert Datenlecks, blockiert unsicheren Datenverkehr und stellt sicher, dass nur regelkonforme Interaktionen zugelassen werden.
Einheitliche Transparenz für Daten- und KI-Pipelines: F5 AI Assistant ermöglicht eine umgebungsübergreifende Beobachtbarkeit und analysiert Protokolle, Datenherkunft, Telemetrie- und Richtliniendaten, um Engpässe und Leistungsprobleme in verteilten Pipelines zu identifizieren.
Vorteile der Implementierung von Datenorchestrierung
Datenorchestrierung bietet erhebliche operative und strategische Vorteile:
- Effizienz: Automatisiert wiederkehrende manuelle Aufgaben im Data Engineering, wie etwa Datenaufnahme, Transformation und Pipeline-Planung. Dadurch wird der Aufwand reduziert und Teams können sich auf andere Bereiche wie Analysen und Entwicklung konzentrieren.
- Geschwindigkeit: Sorgt für einen kontinuierlichen Datenfluss zwischen Systemen und unterstützt so Echtzeitanalysen, Hochgeschwindigkeits-Pipelines und einen schnelleren Zugriff auf wichtige Erkenntnisse für geschäftliche und KI-Workloads.
- Zuverlässigkeit: Erzwingt die Konsistenz von Schemas, führt Qualitätsprüfungen durch und nutzt eine automatisierte Wiederholungslogik. Dadurch werden Datenfehler, Pipeline-Probleme und nachgelagerte Störungen reduziert, die sich auf die Analyse- und Modellleistung auswirken.
- Skalierbarkeit: Bietet eine einheitliche Orchestrierungsebene, die Hunderte oder Tausende von Pipelines in Hybrid- und Multi-Cloud-Umgebungen koordinieren kann. Mit zunehmendem Datenvolumen und steigender Verarbeitungsgeschwindigkeit gewährleistet die Orchestrierung eine vorhersehbare Pipeline-Performance.
Anwendungsfälle für die Datenorchestrierung in Unternehmen
Unternehmen setzen Datenorchestrierung in einer Vielzahl operativer und analytischer Workflows ein:
- Echtzeitanalysen und Dashboards: Koordination von Streaming-Daten aus Anwendungen, IoT-Sensoren und Transaktionen, um sofortige Erkenntnisse zu liefern
- Kunden- und Personalisierungsplattformen: Daten aus CRM-Systemen, Webinteraktionen, Supportsystemen und Marketingtools werden zusammengeführt, um einheitliche Kundenprofildaten bereitzustellen.
- Betrugserkennung und Risikobewertung: Synchronisiert Ereignisprotokolle, Transaktionen, Nutzerverhalten und Daten von Drittanbietern in Erkennungsmodellen, die nahezu in Echtzeit arbeiten.
- Transparenz und Optimierung der Lieferkette: Orchestriert Daten aus Logistiksystemen, Bestandsdatenbanken und IoT-Geräten für Prognosen und die Routenoptimierung.
- KI/ML-Feature-Pipelines: Daten werden im Rahmen von ML-Workflows aufbereitet, validiert und in Trainings- und Inferenzumgebungen übertragen.
- Regulatorische Berichterstattung: Automatisiert die regelkonforme Datenaufbereitung für Audits, Finanzberichte und andere branchenspezifische regulatorische Meldungen.
Die Rolle der Datenorchestrierung in der Data Governance
Datenorchestrierung stärkt die Data Governance, indem Kontrollen direkt in den Datenlebenszyklus integriert werden:
- Datenherkunft: Verfolgt den vollständigen Weg der Daten vom Quellsystem durch alle Transformationsschritte und schafft so die für Audits, Fehlerbehebung und die Untersuchung von Modellergebnissen erforderliche Transparenz.
- Zugriffskontrolle: Setzt Berechtigungen, rollenbasierte Zugriffskontrollen (RBAC) und das Prinzip der geringsten Rechte über alle Pipelines hinweg durch und stellt sicher, dass Benutzer und Systeme nur mit den Daten interagieren, auf die sie zugreifen dürfen.
- Audit-Trails: Führt ausführliche Protokolle über Datenbewegungen, Transformationen, Genehmigungen und Richtlinien und ermöglicht so eine klare Nachvollziehbarkeit und Compliance-Zertifizierung.
- Unterstützung von Datenschutzvorschriften: Automatisiert Prüfungen wie Datenmaskierung, Tokenisierung, Anfragen zur Löschung personenbezogener Daten (z. B. gemäß DSGVO) und Aufbewahrungsrichtlinien. Die Orchestrierung stellt sicher, dass sensible Daten in allen Pipelines und Systemen einheitlich verarbeitet werden.
Definition und Umfang der KI-Orchestrierung
KI-Orchestrierung umfasst die Überwachung, Verwaltung und Automatisierung aller Komponenten, die bei der Entwicklung, Bereitstellung und Wartung von ML- und KI-Systemen zum Einsatz kommen. Sie erweitert die Datenorchestrierung auf den gesamten KI-Lebenszyklus und deckt dabei Feature-Pipelines, Trainingsprozesse, die Paketierung von Modellen, deren Bereitstellung und Überwachung sowie ihre kontinuierliche Verbesserung ab.
Die KI-Orchestrierung umfasst Workflows für Machine-Learning-Operationen (MLOps), Modell-Governance, betriebliche Observability, Infrastruktur-Bereitschaft und die Durchsetzung von Richtlinien in Hybrid- und Multicloud-Umgebungen.
Schlüsselkomponenten eines KI-Orchestrierungssystems
KI-Orchestrierungssysteme standardisieren und automatisieren jede Phase des ML-Lebenszyklus:
- Daten- und Feature-Pipelines: Daten-Features (hochwertige und aktuelle Daten) aufbereiten, validieren und für Trainings- und Inferenzumgebungen bereitstellen.
- Trainingsorchestrierung: Plant Trainingsaufträge, konfiguriert Rechenressourcen (GPU/CPU), verwaltet die Zeitplanung verteilter Trainingsumgebungen und überwacht das Modelltraining.
- Modellbereitstellung: Automatisiert die Paketierung und Versionierung von Modellen sowie Test-Rollouts, Bereitstellungen und das Routing zur Unterstützung von Echtzeit-Inferenz.
- Überwachung und Leistungsanalyse: Überwacht Modelldrift, Genauigkeit, Latenz, Ressourcennutzung und Änderungen an den Eingabedaten, um die Zuverlässigkeit im Produktivbetrieb sicherzustellen.
- Feedbackschleifen: Erfasst Vorhersagen, Ergebnisse, Benutzerinteraktionen und Modelltelemetriedaten, um erneutes Training, Feinabstimmung und kontinuierliches Lernen zu unterstützen.
Die wichtigsten Vorteile der Implementierung von KI-Orchestrierung
KI-Orchestrierung vereinfacht und stärkt den KI-Betrieb in Unternehmen:
- Wiederholbare KI-Bereitstellung: Standardisierte Workflows reduzieren Ad-hoc-Skripte und manuelle Prozesse. Dadurch werden die Entwicklung und Bereitstellung von KI konsistent und vorhersehbar und manuelle Fehler vermieden.
- Kontrollierter KI-Betrieb: Bietet Transparenz über die Herkunft von Modellen, Freigaben, Datennutzung und Versionierung, um einen verantwortungsvollen und regelkonformen Einsatz von KI sicherzustellen.
- Zuverlässige, produktionsreife Pipelines: Stellen Sie sicher, dass Modelle mit gleichbleibender Leistung und angemessener Latenz ausgeführt sowie automatisiert überwacht werden, um Ausfälle zu vermeiden.
- Schnellere Iterationszyklen: Optimiert erneutes Training, Validierung und Bereitstellung, beschleunigt so Innovationen und verkürzt die Zeit bis zur Wertschöpfung durch KI-Funktionen.
- Skalierbarer Multi-Modell-Betrieb: Koordiniert Workloads über verschiedene Clouds, Edge-Standorte und Computing-Umgebungen hinweg und unterstützt so KI-Portfolios.
KI-Orchestrierungsplattformen im Vergleich zu allgemeiner Workflow-Automatisierung
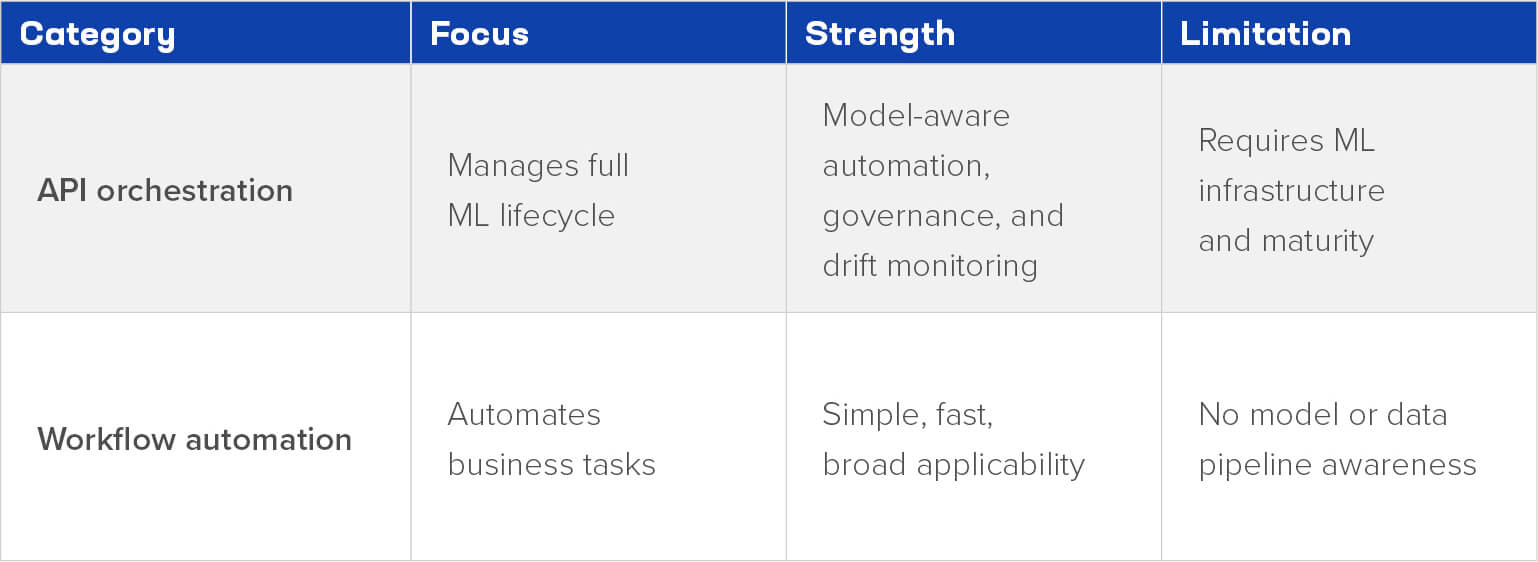
KI-Orchestrierungsplattformen wurden speziell für ML und generative KI entwickelt. Sie berücksichtigen die Anforderungen des Modelllebenszyklus, bieten eine modellspezifische Überwachung, unterstützen verteiltes Training und gewährleisten Sicherheit und Compliance für KI.
Zu den typischen Funktionen gehören:
- Integration von Feature Stores
- Modellherkunft und Versionierung
- GPU-/Beschleuniger-Scheduling
- Drifterkennung und automatisiertes erneutes Training
- Richtlinien- und Governance-Kontrollen
- Verwaltung des Inferenzdatenverkehrs
Die generische Workflow-Automatisierung hingegen umfasst herkömmliche Workflow-Engines (z. B. Business-Process-Management-Systeme, Scheduler usw.), die Geschäftsprozesse automatisieren, jedoch nicht über Funktionen für maschinelles Lernen verfügen. Sie erfassen keine Trainingsläufe, überwachen keine Modelldrift, verwalten keine GPU-Infrastruktur und setzen keine modellspezifischen Governance-Vorgaben durch.
Anwendungsfälle der KI-Orchestrierung in Unternehmen und ihre Auswirkungen auf die digitale Transformation
Unternehmen nutzen KI-Orchestrierung, um KI-Programme über die Proof-of-Concept-Phase hinaus zu skalieren:
- Automatisierte Modellbereitstellung in allen Geschäftsbereichen: Ermöglicht die einheitliche Einführung von Lösungen, die Modelle zur Betrugserkennung, Preisbildungs-Engines oder Modelle zur Bedarfsprognose nutzen.
- Personalisierung und Empfehlungen in Echtzeit: Verwaltet die Datenaufnahme, Trainingsaktualisierungen und Inferenz-Endpunkte, um personalisierte Erlebnisse in großem Maßstab bereitzustellen.
- Vorausschauende Wartung und IoT-Analysen: Verwaltet Streaming-Daten und Inferenz-Pipelines, die Anomalien erkennen, Ausfälle vorhersagen und die Leistung optimieren können.
- Konversations-KI und generative Anwendungen: Orchestriert Datenbanken, Retrieval-Pipelines, Prompt-Governance und Modelldienste zur Unterstützung des Kundenbetriebs.
- KI-Transformation im Unternehmen: Die KI-Orchestrierung schafft die Grundlage für wiederholbare, regelkonforme und kontrollierte KI-Workflows. So können Unternehmen KI in sämtlichen Geschäftsprozessen produktiv einsetzen – und nicht nur in isolierten Systemen.
Governance und Compliance bei der KI-Orchestrierung
KI-Orchestrierung integriert Governance direkt in den Modellbetrieb und stellt so sicher, dass KI in Unternehmen sicher, verantwortungsvoll und regelkonform bleibt.
- Datenverfolgung: Überwacht Datensätze, Merkmale, Transformationen und Datenquellen, um eine unbefugte Nutzung zu verhindern und die Nachverfolgbarkeit für Audits sicherzustellen.
- Nachverfolgung von Modellen: Erfasst Modellversionen, Trainingsdaten, Konfigurationen, Leistung, Freigaben und den Bereitstellungsverlauf und sorgt so für Transparenz und die Einhaltung gesetzlicher Vorschriften.
- Nachverfolgung von Entscheidungen: Protokolliert Inferenzergebnisse, Erklärungen und Entscheidungen und ermöglicht so eine umfassende Überprüfung der Auswirkungen des Modells, seiner Verzerrungen und seiner Fairness.
- Richtlinien und Zugriffskontrollen: Wenden Sie rollenbasierte Berechtigungen, Datenmaskierung und API-Governance an, um sicherzustellen, dass nur autorisierte Systeme und Benutzer mit Modellen oder sensiblen Daten interagieren können.
- Vorbereitung auf regulatorische Anforderungen: Unterstützt die Einhaltung KI-bezogener Vorschriften (z. B. der Verordnung der Europäischen Union über künstliche Intelligenz (EU AI Act), des Artificial Intelligence Risk Management Framework des National Institute of Standards and Technology (NIST AI RMF) oder branchenspezifischer Vorschriften), indem Prüfbarkeit und Rückverfolgbarkeit über den gesamten KI-Lebenszyklus hinweg gewährleistet werden.
Datenorchestrierung | FAQ
Was ist Datenorchestrierung und wie funktioniert sie Schritt für Schritt?
Datenorchestrierung automatisiert die Übertragung, Transformation und Bereitstellung von Daten über verteilte Systeme hinweg. Sie erfolgt in der Regel in vier Schritten:
- Daten aus Datenbanken, SaaS-Anwendungen, Protokollen, Streaming-Diensten und APIs erfassen und sammeln.
- Daten mithilfe von Validierungs-, Normalisierungs-, Anreicherungs- und Formatierungsregeln transformieren und standardisieren.
- Daten aktivieren und an Data Warehouses, Data Lakes, Anwendungen, Analyseplattformen und ML-Systeme übermitteln.
- Überwachen und optimieren Sie Pipelines, indem Sie Aktualität, Qualität, Datenherkunft und Betriebszustand nachverfolgen.
Wie unterscheidet sich die Datenorchestrierung von Datenintegrations- und ETL-Tools?
Datenintegration verbindet Systeme miteinander; ETL-Tools extrahieren, transformieren und laden Daten, häufig in Batches. Datenorchestrierung steuert diese Workflows über Batch-, Streaming-, Cloud- und KI-Umgebungen hinweg und gewährleistet zuverlässige Pipelines mit angemessener Governance, Qualitätsprüfungen und Überwachung.
Was sind die wichtigsten Komponenten eines Datenorchestrierungssystems?
Eine typische Orchestrierungsplattform umfasst:
- Workflow-Engine für die Zeitplanung und Verwaltung von Abhängigkeiten
- Konnektoren und Integrationsframeworks für die Datenaufnahme
- Metadaten- und Data-Lineage-Lösungen zur Nachverfolgung von Daten
- Qualitätsvalidierung und Durchsetzung von Richtlinien
- Beobachtbarkeit und Protokollierung der Pipeline-Performance
- Fehlerbehandlung und Wiederholungslogik
Was sind die wichtigsten Vorteile und Anwendungsfälle der Datenorchestrierung für Unternehmen?
Zu den Vorteilen zählen eine höhere Effizienz, schnellere Erkenntnisse, eine verbesserte Zuverlässigkeit und Skalierbarkeit in hybriden Umgebungen. Zu den Anwendungsfällen gehören Echtzeit-Dashboards, Kundensysteme, Betrugserkennung, Lieferkettenanalysen, regulatorische Berichterstattung sowie Trainingspipelines für KI und maschinelles Lernen.
Was ist KI-Orchestrierung und wie hängt sie mit Datenorchestrierung und MLOps zusammen?
Die KI-Orchestrierung steuert den gesamten Lebenszyklus des maschinellen Lernens – von der Datenaufbereitung über das Training und die Bereitstellung bis hin zur Überwachung und Optimierung. Dazu koordiniert sie Komponenten, die Daten in Modelle überführen und Modelle in den Produktivbetrieb bringen. Gemeinsam mit MLOps verbessert sie Governance, Automatisierung und die Nachverfolgung des Lebenszyklus.
Welche Tools und Plattformen werden häufig für die Orchestrierung von Daten und KI eingesetzt?
Zu den gängigen Tools für die Datenorchestrierung zählen Apache Airflow, Dagster, Prefect und cloudnative Scheduler. Zu den Plattformen für die KI-Orchestrierung gehören MLflow, Kubeflow, Vertex AI Pipelines, SageMaker Pipelines, Databricks Workflows und spezialisierte MLOps-Lösungen. Die meisten Unternehmen nutzen eine Kombination, die auf ihren Daten-Stack, ihren Cloud-Anbieter und/oder ihre Modellstrategie abgestimmt ist.
Was sind die größten Herausforderungen bei der Implementierung von KI-Orchestrierung, und wie können Teams sie bewältigen?
Zu den Herausforderungen zählen fragmentierte Daten, uneinheitliches Training, mangelnde Transparenz der Datenherkunft, manuelle Bereitstellung, Modelldrift und Verzerrungen sowie Compliance-Probleme. Teams können diesen begegnen, indem sie standardisierte Pipelines einführen, Tools zur Nachverfolgung der Datenherkunft und zur Beobachtbarkeit implementieren, die Bereitstellung automatisieren, Governance-Richtlinien durchsetzen und den gesamten Lebenszyklus überwachen.
Wie unterstützt die Orchestrierung von Daten und KI Governance und Compliance?
Sie integrieren Governance in Arbeitsabläufe, indem sie die Datenherkunft, Zugriffskontrollen, Datentransformationen und Audit-Trails nachverfolgen sowie die Datennutzung durch Modelle validieren. Bei der KI-Orchestrierung umfasst dies die Nachverfolgung von Modellversionen, Daten, Entscheidungen und Leistung, um Transparenz und Compliance zu gewährleisten.
Wo sollten Unternehmen anfangen, wenn Daten- und KI-Orchestrierung für sie Neuland sind?
Unternehmen sollten zunächst einige wenige Pipelines mit großer Wirkung einrichten, etwa für zentrale Features oder Analyse-Workflows, und diese anschließend ausbauen. Durch die frühzeitige Einführung zentralisierter Metadaten sowie von Datenherkunfts- und Qualitätskontrollen lässt sich die Komplexität reduzieren. Teams sollten außerdem Orchestrierungstools evaluieren, die zu ihrer Cloud-Strategie passen, und skalierbare Governance-Frameworks für Daten- und KI-Workloads einführen.
Wie F5 unterstützt
Die Orchestrierung von Daten und KI ist für moderne Strategien unverzichtbar. Sie gewährleistet zuverlässige, automatisierte Pipelines, wenn Unternehmen ihre Echtzeitanalysen ausbauen, größere Modelle bereitstellen und Multicloud-Umgebungen nutzen. Sie sorgt für einen reibungslosen Datenfluss, hochwertige Eingabedaten und ein konsistentes KI-Verhalten. Der Erfolg hängt von einer robusten Infrastruktur ab, einschließlich Datennetzwerken, Sicherheits- und Bereitstellungstechnologien. Ohne resilienten Datenverkehr, sichere Endpunkte und umfassende Transparenz geraten selbst fortschrittliche Plattformen unter hoher Last an ihre Grenzen.
Orchestrierung erfordert ein solides Fundament. Ein ausfallsicheres Traffic-Management ermöglicht skalierbare Daten- und Modelldienste. API-Sicherheit gewährleistet Governance und schützt sensible Daten. Eine einheitliche Observability bietet umgebungsübergreifende Einblicke in Performance, Abweichungen, Fehler und Verhalten und hilft Teams, Pipelines zuverlässig zu betreiben.
Unternehmen sollten sich fragen: Funktionieren die Pipelines auch unter Last zuverlässig? Ist die Governance einheitlich? Lassen sich Probleme über mehrere Clouds hinweg nachverfolgen? Sind die Netzwerk-, Sicherheits- und Bereitstellungsteams auf die Daten- und KI-Teams abgestimmt? Wenn die Antworten „Nein“ oder „Nicht sicher“ lauten, sollte die Orchestrierung gemeinsam mit der Infrastruktur als einheitliches System neu gedacht werden.
Weitere Informationen finden Sie unter f5.com.
