Anwendungsbereitstellungsmuster für die Skalierung von Apps und APIs
Bei der Skalierung von Anwendungen und APIs geht es heute nicht darum, den richtigen Lastausgleichsalgorithmus auszuwählen. In den mehr als zwei Jahrzehnten, in denen sich die Anwendungsbereitstellung weiterentwickelt hat, sind Lastausgleichsalgorithmen weitgehend unverändert geblieben. Ihr Hauptvorteil besteht darin, die Verfügbarkeit aufrechtzuerhalten. Ihre Auswirkungen auf die Leistung sind bestenfalls minimal.
Das soll nicht heißen, dass die Wahl eines Algorithmus irrelevant ist. Schließlich ist Round Robin für eine API oder Anwendung nur selten die beste Wahl. Ob man sich jedoch für Least Connections oder Fastest Response entscheidet, wirkt sich wahrscheinlich weniger auf die Gesamtleistung und Verfügbarkeit eines digitalen Dienstes aus als dessen Architektur.
Im Folgenden wird die Anwendungsbereitstellung aus architektonischer Sicht betrachtet, da sie zu einer der sechs zentralen Fähigkeiten aufgewertet wurde, die für die Konzeption und den Betrieb digitaler Dienste erforderlich sind.
Was ist ein Lastverteilungsalgorithmus?
Ein Load-Balancing-Algorithmus ist ein programmatischer Ansatz zur Verteilung der Last auf einen Ressourcenpool, um die Verfügbarkeit sicherzustellen und die Leistung zu verbessern.
Ein Lastverteilungsalgorithmus legt fest, wie bestimmte Ressourcen ausgewählt und welche Variablen berücksichtigt werden.
Round Robin ist der einfachste Algorithmus und durchläuft eine bekannte Menge von Ressourcen der Reihe nach. Wenn es drei Ressourcen gibt – A, B und C –, leitet Round Robin die erste Anfrage an A, die zweite an B und die dritte an C weiter. Anschließend beginnt der Auswahlprozess von vorn.
Least Connections ist ein Algorithmus, der auf dem zweiten Betriebsaxiom basiert, das besagt: „Mit zunehmender Last nimmt die Leistung ab.“ Daher wählt der Least-Connections-Algorithmus die Ressource mit den wenigsten Verbindungen (der geringsten Last). Es gibt verschiedene Varianten dieses Algorithmus, insbesondere Weighted Least Connections, womit Kapazitätsunterschiede zwischen den Ressourcen berücksichtigt werden können.
Schnellste Antwortzeit wird verwendet, wenn die Leistung höchste Priorität hat. Der Load Balancer ermittelt entweder passiv oder aktiv die Antwortzeit jeder Ressource und wählt für jede Anfrage die schnellste aus. Dieser Algorithmus garantiert nicht die Benutzerantwortzeit, da er weder die letzte Meile noch die Netzwerkbedingungen des Benutzers beeinflusst.
Quell-IP ist ein aus dem Netzwerk-Load-Balancing übernommener Algorithmus, der anhand eines einfachen Hashwerts der Quell-IP-Adresse (Client-IP) eine Ressource auswählt. Dieser Algorithmus wählt für eine bestimmte Quell-IP-Adresse immer dieselbe Ressource aus. Er wird kaum noch verwendet, da er für das sogenannte „Mega-Proxy“-Problem anfällig ist, bei dem alle Benutzer, die über einen einzigen Proxy bzw. eine einzige IP-Adresse zugreifen, an dieselbe Ressource weitergeleitet werden. Dadurch wird die Zielressource häufig überlastet, was zu Leistungseinbußen und letztlich zu einem Ausfall führt.
Algorithmen für den Lastenausgleich sind ein wichtiger Bestandteil einer Architektur für die Anwendungsbereitstellung, haben jedoch weniger Einfluss auf die Leistung und Skalierbarkeit einer App oder eines digitalen Dienstes als der übergeordnete Architekturansatz.
Was ist Anwendungsbereitstellung?
App-Bereitstellung bezeichnet die Entwicklung einer skalierbaren, leistungsstarken Architektur für Apps, APIs und digitale Dienste. Sie stützt sich maßgeblich auf Load Balancing als zentrale Komponente, umfasst jedoch auch moderne Funktionen wie Layer-7-Routing und nutzt gängige Architekturmuster, um die Leistung und die effiziente Ressourcennutzung zu optimieren.
Wir verwenden den Begriff „App-Bereitstellung“, um bewusst zwischen Load Balancing als Implementierungsdetail und Architektur als Designprozess zu unterscheiden.
Warum skalieren wir?
Skalierung ist die technische Antwort auf ein Geschäftsziel. Konkret geht es darum, die Verfügbarkeit und Leistung der Workloads, aus denen ein digitaler Dienst besteht aufrechtzuerhalten, um die Kundenzufriedenheit, die Konversionsraten und die Umsatzgenerierung zu verbessern. Der letzte Punkt ist besonders wichtig, denn unsere Untersuchungen zeigen, dass die Mehrheit (58 %) der Unternehmen heute mindestens die Hälfte ihres Umsatzes mit digitalen Diensten erzielt.
Betrachten Sie beispielsweise auch die Nutzung der Public Cloud für Business Continuity (BC). BC ist einer der wichtigsten primären Anwendungsfälle für die Public Cloud und basiert im Kern auf der Umsetzung globaler Skalierung, d. h. globalem Lastausgleich. Failover ist eine zentrale Funktion der Anwendungsbereitstellung, die bei Anwendung auf eine gesamte Website die schnelle Umleitung von Anfragen von einem Standort zu einem anderen ermöglicht. Die kontinuierliche Verfügbarkeit der digitalen Präsenz eines Unternehmens ist ein Geschäftsergebnis, das durch eine technische Lösung ermöglicht wird.
Wie skalieren wir?
Mit der Beantwortung dieser Frage beginnt unsere technische Reise in die Architektur der Anwendungsbereitstellung. Es gibt zwei Skalierungsmodelle: vertikal (nach oben) und horizontal (in die Breite).
Vertikale Skalierung basiert auf dem Prinzip, dass zusätzliche Rechenleistung die Kapazität eines Systems erhöht. Diese Skalierungsmethode kommt vor allem monolithischen Anwendungen und eigenständigen Systemen zugute. Abgesehen von der Infrastruktur setzen die meisten Unternehmen nicht mehr auf vertikale Skalierung, da dafür die physische Umgebung verändert werden muss – etwa durch das Hinzufügen von CPUs oder RAM oder die Erweiterung der Netzwerkkapazität. Durch Virtualisierung lässt sich die vertikale Skalierung zwar erheblich beschleunigen, insbesondere in öffentlichen Cloud-Umgebungen, doch die erforderliche Migration von Software und Systemen – selbst auf eine neue virtuelle Maschine – kann den Betrieb beeinträchtigen.
Horizontale Skalierung ist ein Architekturansatz, bei dem die Verarbeitungsleistung durch eine Erhöhung der insgesamt verfügbaren Ressourcen gesteigert wird. Dies wird erreicht, indem die Verarbeitungsleistung auf mehrere Instanzen einer Anwendung, eines Dienstes oder eines Systems verteilt wird. Dies ist heute die gängigste Skalierungsmethode, da sie auf der Vervielfältigung von Ressourcen statt auf deren Migration beruht. Darüber hinaus bietet die horizontale Skalierung eine größere Vielfalt an Architekturoptionen als die vertikale Skalierung und eignet sich daher besser für alle Anwendungen und APIs.
Daher sollte es nicht überraschen, dass moderne Muster für die Anwendungsbereitstellung auf dem Prinzip der horizontalen Skalierung beruhen.
Muster für die Anwendungsbereitstellung
Die bloße Entscheidung für eine horizontale Skalierung beendet die Diskussion noch nicht.
Sobald die Entscheidung getroffen ist (in der Regel ist dies die Standardentscheidung), sollten weitere Überlegungen in die Architekturentscheidung hinsichtlich der Implementierung einfließen. Am einfachsten lässt sich diese Entscheidung aus der Perspektive des Skalierungswürfels treffen, wie er im Buch „The Art of Scalability“ beschrieben wird.
Vereinfacht gesagt gibt es im Skalierungswürfel drei Achsen: x, y und z. Jede davon entspricht einem Architekturmuster für die Lastverteilung. Jedes dieser Muster eignet sich dazu, je nach Art der Anwendung oder API bestimmte Ziele hinsichtlich Leistung und Verfügbarkeit zu erreichen.
Ein digitaler Dienst verwendet wahrscheinlich eine Architektur, die mehrere Muster kombiniert, um gleichzeitig die Leistung und den Ressourcenverbrauch zu optimieren. Dieser Ansatz erfordert systemisches Denken, da alle Komponenten, ihr Zusammenspiel und der Weg der Anfragen vom Benutzer zur Anwendung und zurück berücksichtigt werden müssen.
Skalierung der X-Achse
Das X-Achsen-Muster ist das grundlegendste Muster. Es basiert auf horizontaler Vervielfältigung, wobei der Großteil der Arbeit von einem Lastverteilungsalgorithmus übernommen wird. Es ist das einfachste Muster und führt zu dem, was ich als „Plain Old Load Balancing“ (POLB) bezeichne.
Wir nennen es so, weil die Architektur sehr einfach ist und die erweiterten Funktionen moderner Load Balancer zur Interaktion mit Anfragen und Antworten auf der Anwendungsebene nicht nutzt.
Bei diesem Muster werden Anwendungen dupliziert und Anfragen entsprechend der Entscheidung des konfigurierten Lastverteilungsalgorithmus an eine Instanz weitergeleitet.
Da dieses Muster häufig in Verbindung mit TCP (Schicht 4) verwendet wird, bietet es Leistungsvorteile gegenüber anderen Mustern, die auf der Überprüfung von HTTP (Schicht 7) basieren. Insbesondere können Verbindungen direkt miteinander verknüpft werden, anstatt sie über einen Proxy zu leiten. Dadurch fungiert der Load Balancer nach dem initialen Verbindungsaufbau praktisch nur noch als Netzwerk-Hopp. Dies führt insgesamt zu einer höheren Leistung, verhindert jedoch, dass der Load Balancer Anfragen und Antworten nach dem initialen Verbindungsaufbau überprüfen oder darauf reagieren kann. Da X-Achsen-Architekturen eine hohe Verfügbarkeit gewährleisten und äußerst leistungsfähig sein können, werden sie häufig zur Skalierung von Infrastruktur- und Sicherheitsdiensten wie Firewalls und Anwendungs-Gateways eingesetzt.
Eine Vielzahl herkömmlicher Anwendungen (Monolithen, dreistufige Webanwendungen und Client-Server-Anwendungen) wird in der Regel nach diesem Muster skaliert, da diese Anwendungen nur selten in kleinere, eigenständige Komponenten zerlegt sind, die sich für moderne Architekturen zur Anwendungsbereitstellung nutzen lassen.
Skalierung entlang der Y-Achse
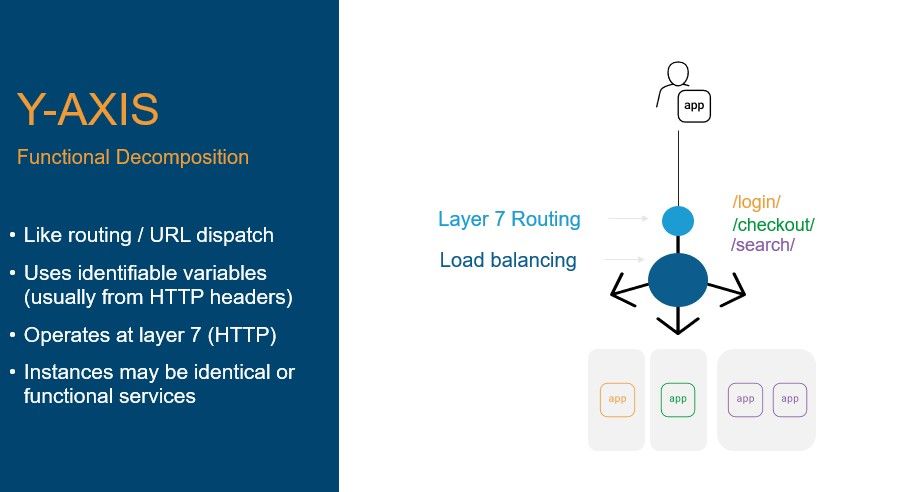
Dieses Muster basiert auf funktionaler Zerlegung und nutzt die Funktionen der Anwendungsschicht (Schicht 7) bei der Anwendungsbereitstellung, um anhand einzelner Funktionen statt ganzer Systeme zu skalieren. Das Y-Achsen-Muster ist das erste Muster, bei dem das Routing auf Schicht 7 zu einem zentralen Werkzeug im Instrumentarium der Architektur für die Anwendungsbereitstellung wird.
Im Allgemeinen nutzen Y- und Z-basierte Muster das Layer-7-Routing, um einen Pool auszuwählen. Anschließend wird mithilfe eines Lastverteilungsalgorithmus eine bestimmte Ressource ausgewählt. Dies unterscheidet sich vom grundlegenden X-Muster, bei dem kein Layer-7-Routing zum Einsatz kommt.
Dieses Muster setzt den Betrieb auf Schicht 7, üblicherweise HTTP, voraus und verwendet eine Variable, um den Datenverkehr auf bestimmte Instanzen einer Anwendung oder eines Dienstes zu verteilen. Wenn beispielsweise das Muster /login im URI gefunden wird, wählt der Load Balancer anhand des konfigurierten Lastverteilungsalgorithmus eine Instanz aus einem Pool von Anwendungsinstanzen aus, die ausschließlich Anmeldeanfragen verarbeiten. Bei der Variable kann es sich um einen beliebigen Wert im Anfrage-Header oder in den Nutzdaten der Anfrage handeln. Dies ermöglicht agentenbasiertes Routing, API-Routing und inhaltsbasiertes Routing (Bilder, Skripte usw.).
Anwendungsinstanzen können Klone sein. Dies ist häufig der Fall, wenn sich Unterschiede in der Nutzung einer App anhand einer Variablen in der Anfrage erkennen lassen. Beispielsweise können Anmelde- und Bezahlfunktionen in einer Anfrage anhand des URI, eines Werts im HTTP-Header oder eines Werts in der Nutzlast der Anfrage unterschieden werden. Durch die Anwendung eines Y-Achsen-Musters können herkömmliche Anwendungen nach Funktion skaliert werden. Dies führt zu einer effizienteren Ressourcennutzung, da Funktionen mit hohem Anfragevolumen mehr Ressourcen zugewiesen werden können, während die erwartete Leistung anderer Funktionen erhalten bleibt.
Die Verwendung des Y-Achsen-Musters zur funktionalen Skalierung herkömmlicher Anwendungen entstand bereits vor der Verbreitung von Microservices, die Anwendungen heute funktional zerlegen. Das Y-Achsen-Muster ist nach wie vor auf Microservices anwendbar und wird heute tatsächlich von Ingress-Controllern implementiert. Aufmerksame Leser werden feststellen, dass dieses Muster auch auf APIs anwendbar ist, da diese auf HTTP-Konstrukten (Schicht 7) basieren. Daher überrascht es nicht, dass API-Gateways dieses grundlegende Muster nutzen.
Dieses Muster wurde durch eBay bekannt gemacht und zwar in den Anfängen des Web 2.0. Die damalige Skalierbarkeitsarchitektur sah vor, Funktionen auf separate Anwendungspools aufzuteilen. Die Verkaufsfunktionen wurden von einer Gruppe von Anwendungsservern bereitgestellt, die Gebotsfunktionen von einer anderen und die Suchfunktionen wiederum von einer weiteren. Insgesamt wurden rund 16.000 Anwendungsserver in 220 verschiedenen Pools organisiert. Dadurch konnte jeder Pool unabhängig von den anderen entsprechend den Anforderungen und dem Ressourcenverbrauch seiner Funktion skaliert werden. Zudem ließen sich Ressourcenabhängigkeiten isolieren und optimieren – so musste beispielsweise der Verkaufspool nur mit einer relativ kleinen Teilmenge der Backend-Ressourcen kommunizieren.
Das Y-Achsen-Muster kann auch verwendet werden, um Anfragen für verschiedene Arten von Inhalten zu verteilen, beispielsweise Bilder auf einen Ressourcenpool und andere Inhaltstypen auf andere Pools.
Durch die Verteilung der Last entlang der Y-Achse können die Komponenten eines digitalen Dienstes unabhängig voneinander skaliert werden, was hinsichtlich der Ressourcennutzung wesentlich effizienter ist als ein X-Achsen-Muster. Dadurch lässt sich die Konfiguration auf Dienst- oder Anwendungsebene optimieren und die Leistung verbessern, indem bestimmte Variablen im Web- oder Anwendungsserver an den jeweiligen Inhaltstyp angepasst werden.
Skalierung entlang der Z-Achse
Das Z-Achsen-Muster gewann angesichts des explosionsartigen Wachstums der sozialen Medien und des Internets insgesamt aus reiner Notwendigkeit an Popularität. Im Kern handelt es sich dabei um ein Skalierungsmuster entlang der Y-Achse mit zusätzlicher Segmentierung, die üblicherweise auf einer bestimmten Variable wie dem Benutzernamen oder einer Gerätekennung basiert.
Dieses Muster ermöglicht eine architektonische Differenzierung mithilfe einer aus dem Daten-Sharding abgeleiteten Technik.
“Ein Datenbank-Shard, kurz Shard, ist eine horizontale Partition von Daten in einer Datenbank oder Suchmaschine. Jeder Shard wird auf einer separaten Datenbankserverinstanz gespeichert, um die Last zu verteilen. Einige Daten innerhalb einer Datenbank sind in allen Shards vorhanden, andere hingegen nur in einem einzigen Shard.”
Wikipedia1
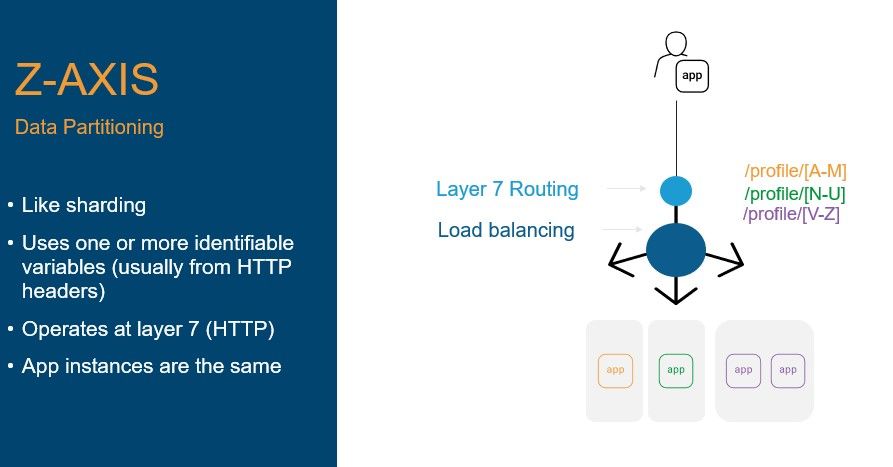
Dieses Muster wendet die aus Datenbanken bekannten Prinzipien an, um Anfragen anhand bestimmter darin enthaltener Daten zu verteilen. Es kann dazu beitragen, Engpässe in der Datenschicht zu beheben und die Einhaltung von Vorschriften zur Datensouveränität sicherzustellen. Dabei wird eine identifizierbare – und in der Regel eindeutige – Variable verwendet, um Anfragen an einen horizontal skalierten Ressourcenpool weiterzuleiten. Dieses Muster kommt üblicherweise zum Einsatz, wenn ein hoher Durchsatz erforderlich ist, etwa bei einem erheblichen Anfragevolumen für einen bestimmten Dienst oder eine bestimmte Anwendung.
Das Z-Achsen-Muster eignet sich besonders für die Verwaltung von Edge- und IoT-Geräten, deren Anzahl in die Millionen gehen kann. Indem Gerätekennungen als Grundlage für die Aufteilung von Anfragen verwendet werden, lässt sich die Geschwindigkeit der Datenübertragung erheblich steigern. Dies kann insbesondere bei Geräten hilfreich sein, die ihre Konfigurationen an einem entfernten Standort (in der Cloud oder einem Rechenzentrum) speichern, da diese Daten gerätespezifisch sind und sicher aufgeteilt werden können.
Dieses Muster führt in der Regel zu einer Leistungssteigerung, da Datenzugriffe bei hoher Last die Leistung erheblich beeinträchtigen können. Durch die Verteilung der Datenzugriffe auf mehr Instanzen sinkt die Last, wodurch sich die Leistung verbessert. Dies erfordert besondere Sorgfalt hinsichtlich der Datenintegrität und kann zu Konsistenzproblemen führen, wenn gemeinsam genutzte Daten durch Sharding aufgeteilt werden. Meta rückte das Thema Sharding in den Fokus, als das Unternehmen Service-Sharding als Teil seiner Gesamtarchitektur entwickelte. Die besondere Sorgfalt bei der Entwicklung einer hochleistungsfähigen und skalierbaren Architektur für die Anwendungsbereitstellung ist ein hervorragendes Beispiel dafür, welche erheblichen Vorteile es bringen kann, die Anwendungsbereitstellung als eigenständige Schicht innerhalb einer größeren Architektur zu betrachten.
Bei Diensten, die auf nicht primäre Datenquellen zugreifen, kann ein Z-Achsen-Muster den Durchsatz verbessern, ohne die Datenqualität im gesamten System wesentlich zu beeinträchtigen. Dieser Ansatz macht zusätzlichen Code überflüssig, der eine bestimmte Instanz einer Anwendung oder API an eine Datenquelle bindet. Stattdessen wird durch das Zusammenspiel der Konfiguration der Datenkonnektoren auf Instanzebene und des Routings für die Anwendungsbereitstellung sichergestellt, dass die richtige Datenquelle verwendet wird.
Das Geheimnis der Skalierbarkeit liegt in der Architektur der Anwendungsbereitstellung
In der heutigen Welt, in der digitale Dienste bereitgestellt werden, kommt es nur selten vor, dass für die Architektur eines leistungsstarken, zuverlässigen digitalen Dienstes lediglich ein einziges Muster für die Anwendungsbereitstellung verwendet wird. Dies liegt sowohl an der inhärenten Komplexität digitaler Dienste als auch an der zunehmenden Vielfalt der „Nutzer“ – darunter Geräte, Menschen und Software.
Daher berücksichtigt ein Architekturansatz den bestmöglichen Einsatz von Bereitstellungsmustern für Anwendungen innerhalb eines digitalen Dienstes, um den Nutzern ein optimales Erlebnis zu bieten.
Es gibt keine „richtige“ oder „falsche“ Architekturlösung, da diese stark von den Diensten und Anwendungen abhängt, aus denen sich ein digitaler Service zusammensetzt. Eine solche Lösung sollte jedoch nicht allein auf Lastverteilungsalgorithmen basieren.
Tatsächlich ist anzumerken, dass die Auswahl eines Algorithmus bislang nicht erwähnt wurde, da die Entscheidung darüber, wie die Last innerhalb eines Lastverteilungsmusters verteilt wird, weniger relevant ist als die Wahl der richtigen Architektur für eine bestimmte App oder API.
Dies ist einer der Faktoren, die dazu beitragen, dass sich die Anwendungsbereitstellung als eigenständige Disziplin etabliert. Die Art und Weise, wie Anwendungsbereitstellung und -sicherheit heute eingesetzt und umgesetzt werden, geht weit über die bloße Skalierung eines Webservers hinaus. Die Implementierung kann sich auf Leistung und Verfügbarkeit auswirken und letztlich über den Geschäftserfolg entscheiden. Daher ist es für Unternehmen wichtig, die Anwendungsbereitstellung als strategisches Architekturwerkzeug in ihrem Gestaltungsbaukasten zu betrachten.
Load Balancing bleibt die zentrale technische Voraussetzung für Skalierbarkeit. Ein Verständnis der Muster bei der Anwendungsbereitstellung und der Art und Weise, wie diese Load Balancing nutzen, ermöglicht eine fundiertere Planung der Skalierbarkeit und Performance digitaler Dienste – insbesondere, wenn diese Dienste voraussichtlich hybrid sind und eine Mischung aus APIs sowie modernen und traditionellen Anwendungen umfassen.
FUSSNOTE