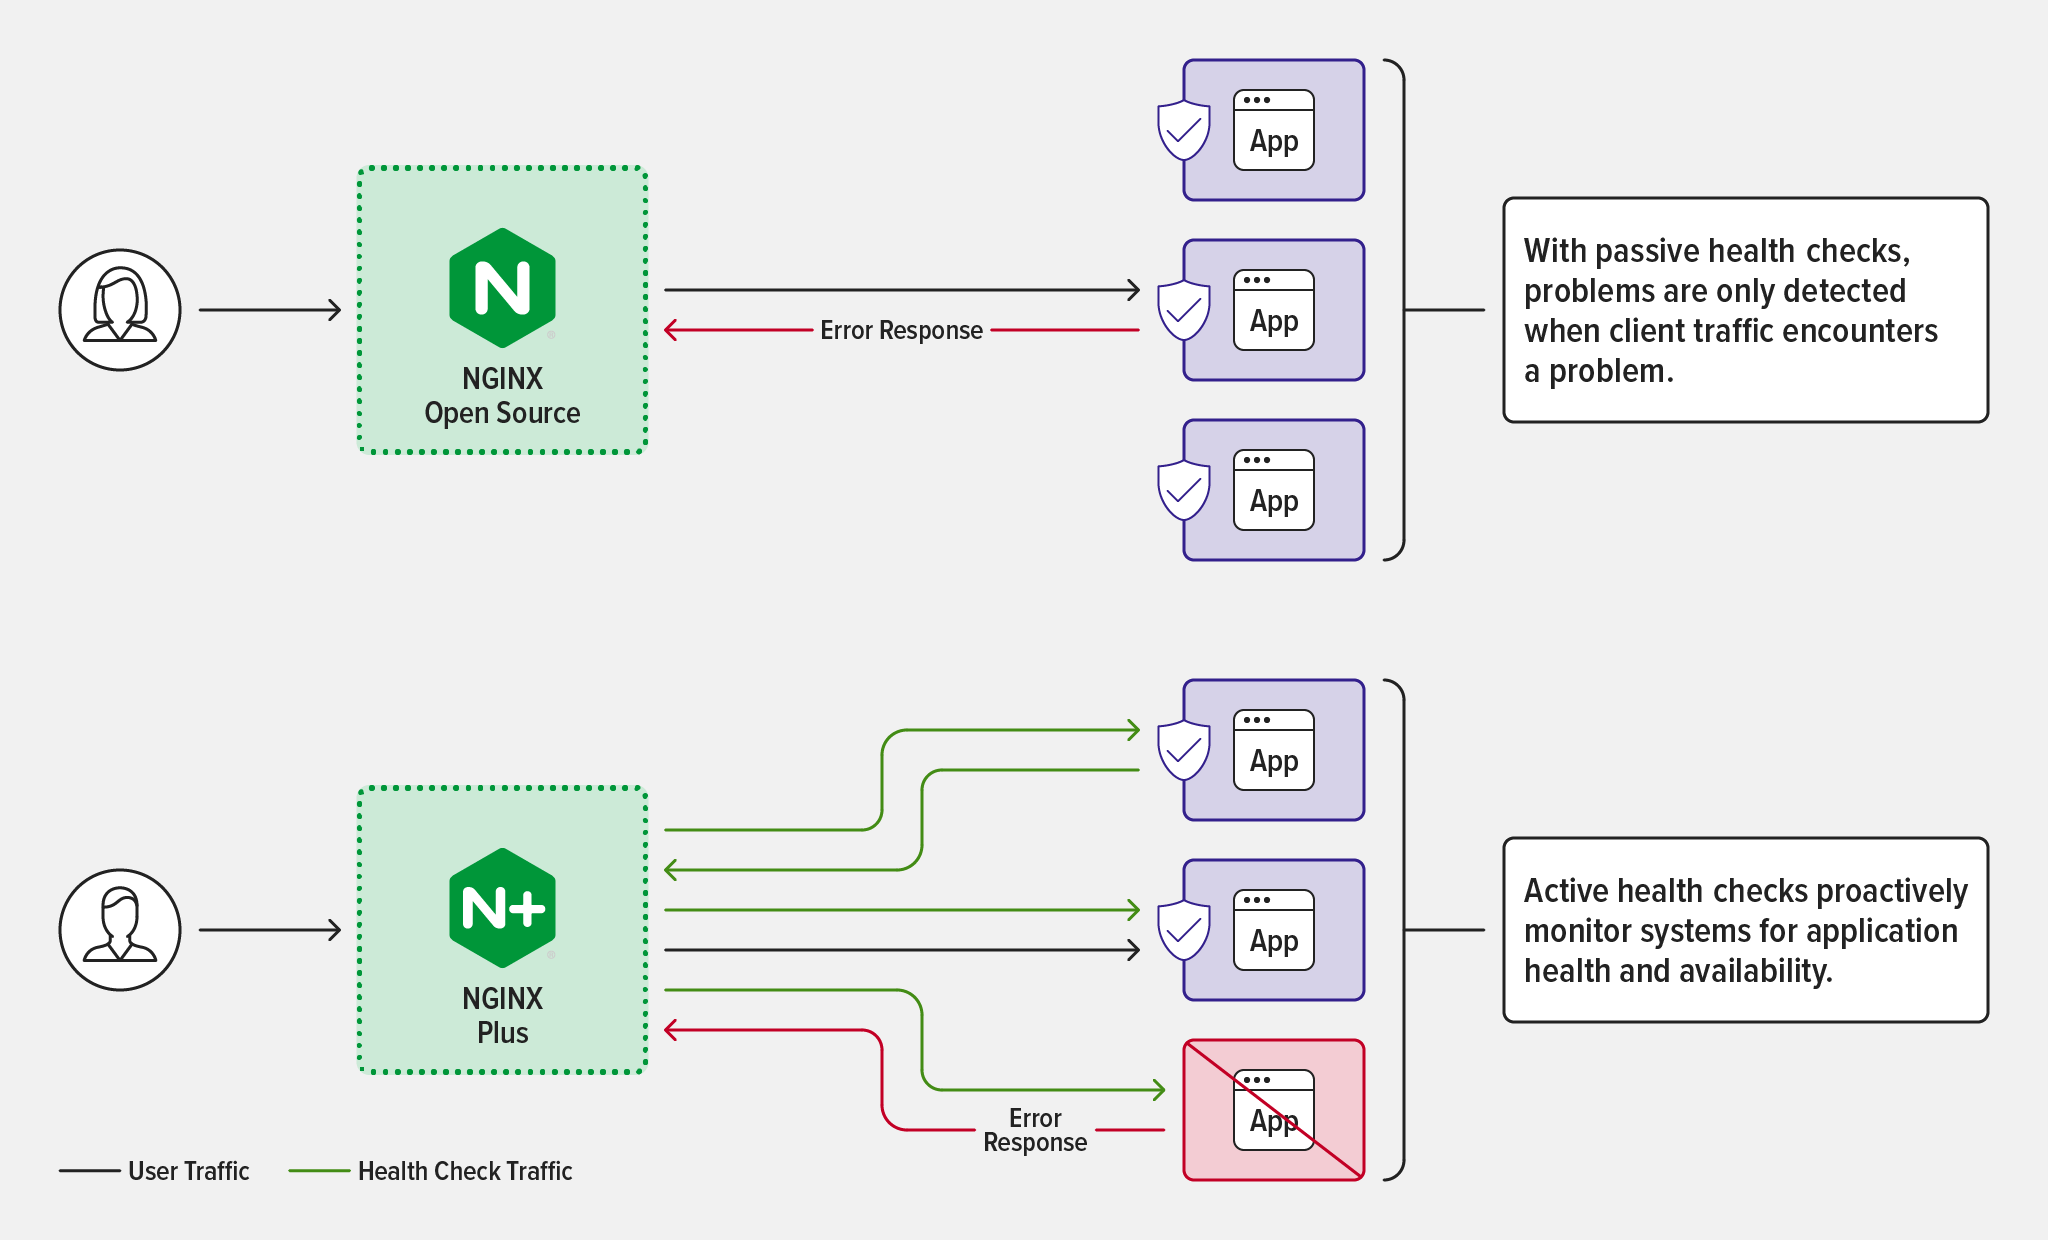
健康を維持するうえで医師による定期健診が重要であるのと同様に、アプリケーションの安定したパフォーマンスを確保するには、定期的なヘルスチェックが欠かせません。トラフィックのリバースプロキシと負荷分散を行う際、NGINXはパッシブヘルスチェックを使用し、リクエストに応答しないサーバーからトラフィックを自動的に迂回させることで、アプリケーションのユーザーをサービス停止の影響から保護します。NGINX Plusではさらに、アクティブヘルスチェックを利用できます。特別なプローブを送信し、サーバーがリクエストを処理できなくなる前でも、異常を検出できます。アプリケーションには、どちらのヘルスチェックが適しているのでしょうか。この記事では、その判断に必要な情報をご紹介します。
ヘルスチェックとは
最も基本的な意味では、ヘルスチェックとは、サーバーがトラフィックを処理できるかどうかを判定する方法です。NGINXはヘルスチェックを使用して、トラフィックのリバースプロキシまたは負荷分散の対象となるサーバー(NGINXでは「アップストリームサーバー」と呼びます)を監視します。
パッシブヘルスチェック
NGINX Open SourceとNGINX Plusの両方で利用できるパッシブヘルスチェックでは、接続とトラフィックを処理している間のサーバーの動作を監視します。NGINXは異常なサーバーを検出すると、リクエストを直ちに別のサーバーへ転送し、そのサーバーへのリクエスト送信を停止したうえで、以降のリクエストをアップストリームグループ内の残りの正常なサーバーに分散します。これにより、サーバーのタイムアウトによるサービス停止がユーザーに及ぶのを防ぐことができます。
パッシブヘルスチェックが有効に機能するのは、アップストリームグループに複数のメンバーが定義されている場合に限られます。アップストリームサーバーが1台しか定義されていない場合、そのサーバーが利用不可とマークされることはないため、異常が発生するとユーザーにサービス停止の影響が及びます。
パッシブヘルスチェックの仕組み
ここでは、パッシブヘルスチェックの仕組みを詳しく説明します。ご関心がない場合は、「アクティブヘルスチェック」まで読み飛ばしてください。
デフォルトでは、NGINXはTCP/UDP(ストリーム)サーバーを異常と判断します。これは、そのサーバーとの接続確立時にエラーまたはタイムアウトが1回でも発生した場合です。
NGINXは、HTTPサーバーを異常とみなします。これは、サーバーへの接続確立、リクエストの転送、またはレスポンスヘッダーの読み取り中に、エラーまたはタイムアウトが1回でも発生した場合です(レスポンスがまったくない場合も、この種のエラーに該当します)。proxy_next_upstreamディレクティブを使用すると、HTTPプロキシのこれらの条件をカスタマイズできます。また、FastCGI、gRPC、memcached、SCGI、TCP/UDP、およびuwsgiの各プロトコルにも同様のディレクティブがあります。
HTTPとTCP/UDPのいずれの場合も、NGINXは異常なサーバーへの接続とリクエスト送信を再試行するまで、デフォルトで10秒間待機します。この待機時間は、fail_timeoutパラメーターをserver[HTTP][Stream]ディレクティブで指定することで変更できます。
NGINXがサーバーを異常と判断するまでに必要なエラーまたはタイムアウトの回数を増やすには、max_failsパラメーターをserverディレクティブに指定します。この場合、fail_timeoutパラメーターでは、その回数のエラーまたはタイムアウトが発生するまでの期間と、サーバーを異常と判断してから再試行するまでの待機時間を設定します。
アクティブヘルスチェック
NGINX Plus独自の機能であるアクティブヘルスチェックは、アプリケーションエンドポイントが正常に応答していることを確認するため、定期的に送信される特別なリクエストです。パッシブヘルスチェックとは別に、追加で実行されます。たとえば、NGINX PlusはアプリケーションのWebサーバーにHTTPリクエストを定期的に送信し、有効なレスポンスコードと正しいコンテンツが返されることを確認できます。アクティブヘルスチェックにより、アプリケーションの特定のコンポーネントやプロセスの健全性を継続的に監視できます。これはアプリケーションの可用性を直接測定するものですが、その精度は、指定したヘルスチェックがアプリケーション全体の健全性をどの程度反映しているかによって異なります。
アクティブヘルスチェックのさまざまな項目をカスタマイズできます。詳しくは「アクティブヘルスチェックのユースケース」をご覧ください。
パッシブヘルスチェックのユースケース
パッシブヘルスチェックは、今や不可欠です。アプリケーション開発、DevOps、DevSecOps、Platform Opsの各チームでは、本番インフラストラクチャの監視プログラムの一環としてパッシブヘルスチェックを実行することがベストプラクティスです。NGINXは、HTTP、TCP、UDPの構成を含む負荷分散されたトラフィックに対して、デフォルトでパッシブヘルスチェックを実行します。
パッシブヘルスチェックには、次のような利点があります。
- NGINX Open Sourceで利用可能
- 次の設定ブロックに含まれるサーバーでは、デフォルトで有効です:
upstream{}configuration block - アップストリームサーバーに追加の負荷なし
- 「パッシブヘルスチェックの仕組み」で説明されているように、一定期間内の最小障害回数を設定可能
- 設定可能な「スロースタート」(NGINX Plus限定)— サーバーが正常な状態に戻ると、NGINX Plusはそのサーバーに転送するトラフィック量を徐々に増やし、「ウォームアップ」の時間を確保します
NGINX Open Sourceの利点は、コストがかからないこと、構成の柔軟性、そして豊富なサードパーティ製モジュールライブラリです。ソースコードが公開されているため、開発者は個々のニーズに合わせて機能を変更、拡張できます。
多くのアプリケーション(およびその開発者)にとっては、パッシブヘルスチェックで十分です。たとえば、顧客向けではなく、小規模なタスクを実行するマイクロサービスには、アクティブヘルスチェックは過剰かもしれません。同様に、キャッシュによってレイテンシーの問題が発生する可能性を低減できるアプリケーションや、コンテンツ配信ネットワーク(CDN)がアプリケーションのタスクの一部を代行できる場合には、アクティブヘルスチェックは不要なことがあります。要約すると、パッシブヘルスチェックのみが最適なのは、次のような場合です。
- HTTPトラフィックの監視
- アプリケーションとは別にインフラストラクチャを監視
- レイテンシーが許容されるアプリケーションの監視
- 高いパフォーマンスが重視されない社内アプリケーションの監視
アクティブヘルスチェックのユースケース
ミッションクリティカルなアプリケーションでは、問題が顧客や主要なプロセスに直接影響するため、アクティブヘルスチェックが不可欠となる場合が少なくありません。このようなアプリケーションでは、顧客や利用者と実質的に同じ方法でアプリケーションをテストすることが重要であり、そのためにはアクティブヘルスチェックが必要です。アクティブヘルスチェックは、帯域外チェックを使用してアプリケーションのレイテンシーと応答を測定するNew RelicやAppDynamicsなどのアプリケーションパフォーマンス監視ツールに似ています。アクティブヘルスチェック向けに、NGINX PlusにはNGINX Open Sourceにはないさまざまな機能が搭載されています。
- アプリケーションの可用性を確認するアウトオブバンドのヘルスチェック
- 設定済みのエンドポイントをテストし、特定のレスポンスを確認
- 実際のアプリケーショントラフィックを処理するポートとは異なるポートをテストする
- ヘルスチェックにHTTPキープアライブ接続を使用し、チェックごとに新しい接続を確立する必要をなくす
- 失敗条件と成功条件をより細かく制御
- 新たに追加したサーバーが実際のアプリケーショントラフィックを受信する前に、必要に応じてテストできます
アクティブヘルスチェックを使用すると、バックエンドサーバーの停止や問題をNGINX Plusが自動的に検出し、問題が解決するまで正常なサーバーにトラフィックをルーティングするよう設定できます。アクティブヘルスチェックは柔軟に設定できるため、より高度なヘルスチェックを実行し、実際のアプリケーションユーザーに影響が及ぶ前にアプリケーションの問題を検出できる可能性があります。これにより、ダウンタイムを最小限に抑え、ユーザーによるアプリケーションへのアクセスが中断されるのを防ぐことができます。
ヘルスチェックの設定方法
パッシブヘルスチェックはデフォルトで有効になっていますが、実行頻度や、サービスが異常と判定されるまでの失敗回数をカスタマイズできます。詳しくは「パッシブヘルスチェックの仕組み」をご覧ください。パッシブヘルスチェックとアクティブヘルスチェックの詳しい設定手順については、以下のドキュメントをご覧ください。
まとめ:アプリケーション要件に合ったヘルスチェックを選択
ヘルスチェックは、あらゆる本番環境のアプリケーションを円滑に稼働させ、優れた応答性を維持するうえで重要です。エンドユーザーに影響が及ぶ前に問題を検出し、増大しつつあるレイテンシーの原因を特定するための最善の方法です。多くのアプリケーションでは、パッシブヘルスチェックで十分です。
より重要度の高いアプリケーションで、ユーザーレベルのアプリケーション動作を直接把握する必要がある場合は、アクティブチェックの方が適しています。NGINX Open Sourceは無料で利用でき、設定可能なパッシブヘルスチェックを提供します。NGINX Plusは、高度なアクティブヘルスチェック機能に加え、商用サポートも提供します。
NGINX Plusのアクティブヘルスチェックをお試しになりませんか?今すぐ30日間の無料トライアルを開始するか、ユースケースについてお問い合わせください。
著者について

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります