「twelve‑factor app」として知られるガイドラインが初めて公開されたのは、10年以上前です。それ以来、そこで必須とされたプラクティスのほぼすべてが、Webアプリの開発とデプロイにおける事実上の標準となっています。アプリの構成方法やデプロイ方法が変化しても、これらのプラクティスは引き続き適用できますが、アプリの開発とデプロイに用いるマイクロサービスパターンにどのように適用されるかを理解するには、場合によってはさらに細かな考慮が必要です。
このブログでは、第3の要素である「設定を環境変数に格納する」に焦点を当てます。その内容は次のとおりです。
- 設定とは、デプロイ環境(Twelve-Factor Appでは「deploy」と呼びます)ごとに異なるすべての要素を指します。
- 設定はアプリのコードから厳密に分離する必要があります。そうでなければ、デプロイごとに設定を変えることはできません。
- 構成データは環境変数に保存されます。
マイクロサービスへ移行しても、これらのガイドラインに従うことはできます。ただし、必ずしも Twelve-Factor App を文字どおりに解釈した方法と完全に一致するとは限りません。構成データを環境変数として提供するなど、一部のガイドラインはそのまま適用できます。一方、一般的なマイクロサービスのプラクティスには、Twelve-Factor App の基本原則を尊重しつつ、その原則を拡張したものに近いものもあります。この記事では、Factor 3 の観点から、マイクロサービスの構成管理における3つの中核概念を取り上げます。
マイクロサービスの主要な用語と概念
Factor 3をマイクロサービスに適応させる方法について説明する前に、主要な用語と概念を理解しておくと役立ちます。
- モノリシックアプリケーションアーキテクチャ – アプリケーションの機能をコンポーネントモジュールに分割しながら、すべてのモジュールを単一のコードベースに含める従来型のアーキテクチャモデルです。
- マイクロサービスアプリケーションアーキテクチャ – 大規模で複雑なアプリケーションを、それぞれが明確に定義された一連の処理(認証、通知、決済処理など)を実行する複数の小さなコンポーネントから構築するアーキテクチャモデルです。「マイクロサービス」は、これらの小さなコンポーネント自体の名称でもあります。実際には、一部の「マイクロサービス」がかなり大規模な場合もあります。
- サービス – システム内の単一のアプリケーションまたはマイクロサービスを指す一般的な用語です。
- システム – このブログでは、組織が提供するすべての機能を実現するために連携する、マイクロサービスとそれを支えるインフラストラクチャの一式を指します。
- アーティファクト – テストおよびビルドパイプラインによって作成されるオブジェクトです。アプリのコードを含むDockerイメージなど、さまざまな形式があります。
- デプロイメント – ステージング、統合、本番などの環境で実行される、アーティファクトの稼働中の「インスタンス」。
マイクロサービスとモノリスの比較
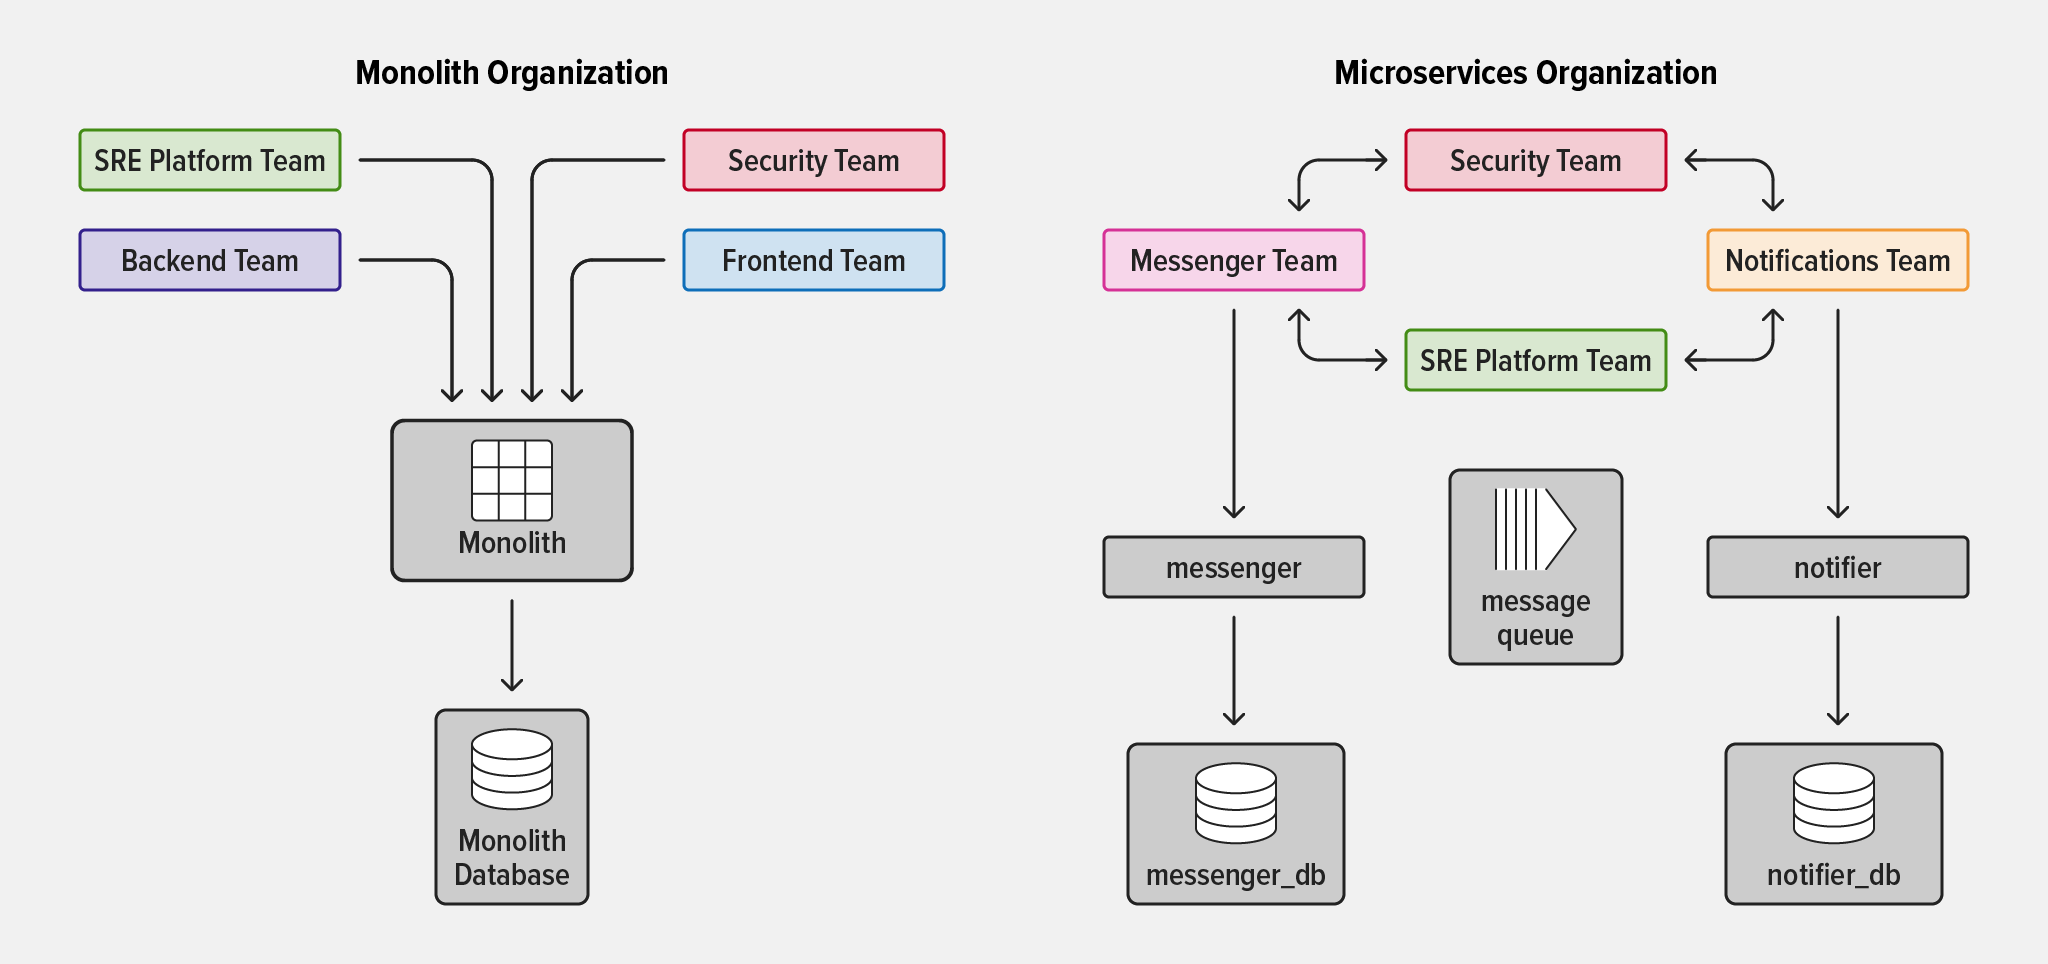
モノリシックアプリケーションでは、組織内のすべてのチームが同じアプリケーションとその周辺インフラストラクチャを扱います。一般に、モノリシックアプリケーションは一見するとマイクロサービスよりもシンプルに見えますが、組織がマイクロサービスへの移行を決定する背景には、いくつかの共通した理由があります。
- チームの自律性 – モノリシックアプリケーションでは、機能やサブシステムの所有権を明確にすることが難しい場合があります。組織が成長し成熟するにつれて、アプリケーション機能に対する責任は、より多くのチームに分散される傾向があります。その結果、特定の機能を所有するチームが、モノリス内の関連するすべてのサブシステムを所有しているとは限らないため、チーム間に依存関係が生じます。
- 「影響範囲」の縮小 – 大規模なアプリケーションを単一のユニットとして開発・デプロイすると、1つのサブシステムのエラーによってアプリケーション全体の機能が低下する可能性があります。
- 機能を個別にスケーリング – モノリシックアプリでは、1つのモジュールだけに高い負荷がかかっている場合でも、システム障害や性能低下を回避するには、アプリ全体のインスタンスを多数デプロイする必要があります。
もちろん、マイクロサービスには、複雑性の増大、可観測性の低下、新たなセキュリティモデルの必要性など、固有の課題もあります。しかし、多くの組織、特に大規模な組織や急成長中の組織は、顧客に提供するエクスペリエンスのための信頼性と安定性に優れた基盤を構築するうえで、チームの自律性と柔軟性を高められるなら、こうした課題に取り組む価値があると判断しています。
マイクロサービスアーキテクチャに必要な変更
モノリシックアプリをマイクロサービスにリファクタリングする場合、各サービスは以下の要件を満たす必要があります。
- 予測可能な方法で構成変更を受け入れる
- より広範なシステムに対し、予測可能な方法で自身の存在を通知する
- 十分に文書化されていること
モノリシックアプリでは、プロセスに多少の不整合があったり、共通の前提に依存していたりしても、重大な問題にはなりません。しかし、多数の独立したマイクロサービスでは、こうした不整合や前提が多くの問題や混乱を招く可能性があります。マイクロサービスの導入に伴って必要となる変更の多くは技術上不可欠なものですが、意外にも相当数は、チーム内の業務の進め方や他のチームとの連携方法に関係しています。
マイクロサービスアーキテクチャの導入に伴う主な組織上の変化は次のとおりです。
- 同じコードベースで共同作業するのではなく、チームを完全に分離し、各チームが1つ以上のサービスに全責任を負うようになります。最も一般的なマイクロサービスの実装では、チームを「クロスファンクショナル」な体制に再編します。つまり、他のチームへの依存を最小限に抑えながらチームの目標を達成するために必要な能力を備えたメンバーで構成します。
- プラットフォームチーム(システム全体の健全性を担うチーム)は、単一のアプリケーションを扱うのではなく、異なるチームが所有する複数のサービスを連携させる必要があります。
- ツール担当チームは、システムの安定性を維持しながら、各サービスオーナーチームが目標を迅速に達成できるよう、引き続きツールとガイダンスを提供できなければなりません。
サービス構成を明確に定義する
マイクロサービスアーキテクチャにおいてFactor 3を拡張する必要がある領域の1つは、構成を含むサービスに関する特定の重要情報を明確に定義し、他のサービスとの共有コンテキストを最小限に抑えることです。Factor 3ではこの点を直接扱っていませんが、多数の独立したマイクロサービスがアプリケーションの機能を構成する場合には、特に重要です。
マイクロサービスアーキテクチャにおけるサービスオーナーとして、チームはシステム全体の中で特定の役割を担うサービスを所有します。担当サービスと連携するサービスを所有する他のチームは、コードやドキュメントを参照し、変更に貢献するために、そのリポジトリへアクセスする必要があります。
さらに、ソフトウェア開発の現場では、開発者の入社や退職だけでなく、社内組織の再編によってもチームのメンバー構成が頻繁に変わるのが実情です。また、特定のサービスに対する責任がチーム間で移管されることも少なくありません。
こうした現実を踏まえ、コードベースとドキュメントは極めて明確かつ一貫したものにする必要があります。そのためには、以下を実践します。
- 各構成オプションの目的を明確に定義する
- 設定値の想定形式を明確に定義する
- アプリケーションが想定する設定値の指定方法を明確に定義する
- この情報を限られた数のファイルに記録する
多くのアプリケーションフレームワークには、必要な構成を定義するための仕組みが用意されています。たとえば、Node.jsアプリケーション向けのNPMパッケージである「convict」では、完全な構成「スキーマ」を1つのファイルに保存します。このファイルが、Node.jsアプリの実行に必要なすべての構成について、信頼できる唯一の情報源となります。
堅牢で見つけやすいスキーマがあれば、チーム内外のメンバーが安心してサービスを利用できます。
サービスに設定を提供する方法
アプリケーションに必要な構成値を明確に定義したら、デプロイ済みのマイクロサービスアプリケーションが構成を取得する2つの主要なソースについて、その重要な違いも考慮する必要があります。
- 構成設定を明示的に定義し、アプリケーションのソースコードに付随するデプロイスクリプト
- デプロイ時に照会される外部ソース
デプロイスクリプトは、マイクロサービスアーキテクチャで一般的に用いられるコード編成パターンです。Twelve-Factor Appが最初に公開された後に登場したため、必然的にその概念を拡張するものとなります。
パターン:アプリケーションと同じ場所に配置するデプロイおよびインフラストラクチャ構成
近年では、アプリケーションコードと同じリポジトリに、infrastructure(またはそれに類する名前)というフォルダーを置くことが一般的になっています。通常、このフォルダーには以下が含まれます。
- サービスが依存するデータベースなどのインフラストラクチャを記述するInfrastructure as Code(Terraformが一般的な例)
- コンテナオーケストレーションシステムの構成(例:Helm charts、Kubernetes manifests)
- アプリケーションのデプロイに関連するその他のファイル
一見すると、これは構成をコードから厳密に分離するというFactor 3の規定に反しているように思えるかもしれません。
実際、インフラストラクチャフォルダーをアプリケーションの隣に配置することで、このルールを遵守しながら、マイクロサービス環境で作業するチームに不可欠な、価値あるプロセス改善が可能になります。
このパターンには、次のようなメリットがあります。
- サービスを所有するチームは、そのサービスのデプロイと、データベースなどのサービス固有のインフラストラクチャのデプロイにも責任を持ちます。
- 担当チームは、これらの要素に対する変更がすべて自チームの開発プロセス(コードレビュー、CI)を経るよう徹底できます。
- チームは、外部チームに作業を依頼することなく、自らのサービスとそれを支えるインフラストラクチャのデプロイ方法を容易に変更できます。
このパターンによって得られるメリットは、各チームの自律性を高めると同時に、デプロイと構成のプロセスをより厳格に実施できるようにする点にあります。
どの種類の構成をどこに配置するか
実際には、インフラストラクチャフォルダーに保存されているデプロイスクリプトを使用して、スクリプト自体に明示的に定義された構成と、デプロイ時に外部ソースから取得する構成の両方を管理します。そのために、サービスのデプロイスクリプトで次の処理を行います。
- 特定の構成値を直接定義する
- デプロイメントスクリプトを実行するプロセスが、外部ソース内の目的の構成値を検索する場所を定義する
サービスの特定のデプロイに固有で、チームが完全に管理できる構成値は、infrastructureフォルダー内のファイルに直接指定できます。たとえば、アプリが開始したデータベースクエリの実行を許可する時間の上限などです。この値は、デプロイファイルを変更してアプリケーションを再デプロイすることで変更できます。
この方式の利点の1つは、このような構成への変更が必ずコードレビューと自動テストを経るため、誤った構成値によって障害が発生する可能性を低減できることです。コードレビューを経た値の変更内容と、任意の時点における構成キーの値は、ソース管理ツールの履歴から確認できます。
アプリケーションの実行に必要でありながら、チームで管理できない値は、アプリケーションのデプロイ先環境から提供する必要があります。たとえば、サービスが依存先の別のマイクロサービスに接続する際に使用するホスト名とポートが該当します。
そのサービスはチームの管理下にないため、ポート番号などの値を決めつけることはできません。このような値はいつでも変更される可能性があり、手動か自動プロセスかを問わず、変更時には一元管理される構成ストレージに登録する必要があります。これにより、その値に依存するアプリケーションから照会できるようになります。
これらのガイドラインは、マイクロサービス構成に関する2つのベストプラクティスにまとめられます。
マイクロサービス構成で避けるべきこと:ハードコードされた値や相互に取り決めた値に依存する
たとえば、サービスが連携する別のサービスの場所など、特定の値をデプロイスクリプトにハードコードするのが最も簡単に思えるかもしれません。しかし実際には、この種の構成をハードコードすることにはリスクがあります。サービスの場所が頻繁に変わることの多い最新の環境では、特に注意が必要です。また、連携先のサービスを自社で管理していない場合、リスクはさらに高まります。
スクリプト内のサービスの場所は、自分で注意深く管理すれば常に最新の状態に保てる、あるいはさらに悪いことに、場所が変更された際にはそのサービスを所有するチームが知らせてくれる、と考えるかもしれません。しかし、ストレスのかかる状況では注意が行き届かなくなることが多く、人の注意力に依存すると、システムが予告なく停止するリスクが生じます。
マイクロサービス構成で推奨される方法:サービス自身に「データベースはどこにあるか」を問い合わせさせる
位置情報がハードコードされているかどうかにかかわらず、アプリケーションが重要なインフラストラクチャの特定の場所に依存してはなりません。代わりに、新たにデプロイされたサービスは、システム内の共通の情報源に「データベースはどこにあるか」などと問い合わせ、その外部リソースの現在の場所について正確な回答を得る必要があります。各サービスがデプロイ時に自身をシステムへ登録するようにすれば、はるかにシンプルになります。
サービスを構成情報として利用可能にする
システムが「データベースはどこにあるのか」「依存している『サービス X』はどこにあるのか」という問いに答えられる必要があるのと同様に、サービスは、そのデプロイ方法を知らなくても他のサービスが容易に検出して通信できる形で、システムに公開する必要があります。
マイクロサービスアーキテクチャにおける重要な構成手法の1つが、サービスディスカバリです。これは、新しいサービス情報を登録し、他のサービスからアクセスされる際にその情報を動的に更新する仕組みです。まず、マイクロサービスにサービスディスカバリが必要な理由を説明し、次にNGINX Open SourceとConsulを使用した実装例を見ていきます。
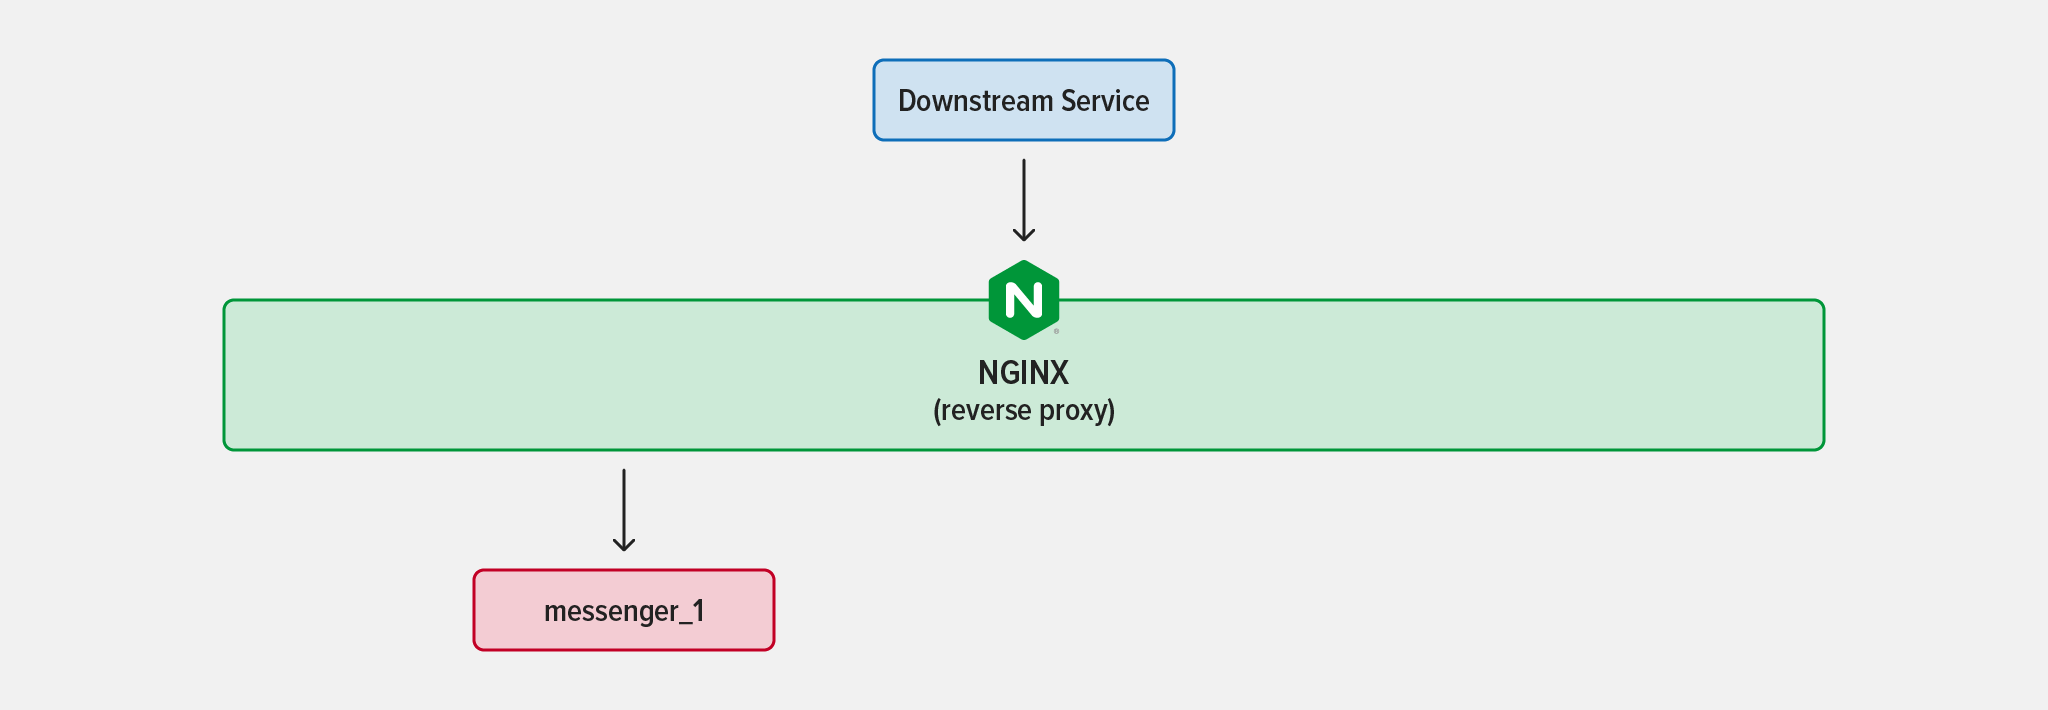
サービスの複数のインスタンス(デプロイメント)を同時に稼働させるのが一般的です。これにより、トラフィックの増加に対応できるだけでなく、新しいデプロイメントを起動して、ダウンタイムなしでサービスを更新できます。NGINXなどのツールは、リバースプロキシおよびロードバランサーとして受信トラフィックを処理し、最適なインスタンスにルーティングします。このパターンでは、対象のサービスに依存するサービスはNGINXにのみリクエストを送信すればよく、デプロイメントの詳細を把握する必要がありません。
例として、messengerというサービスのインスタンスが1つ、リバースプロキシとして機能するNGINXの背後で稼働しているとします。
では、アプリの人気が高まったらどうなるでしょうか。喜ばしいことですが、トラフィックの増加により、messengerインスタンスが大量のCPUを消費し、リクエストの処理に時間がかかるようになった一方で、データベースは問題なく動作していることに気付いたとします。この場合、messengerサービスのインスタンスをもう1つデプロイすることで、問題を解決できる可能性があります。
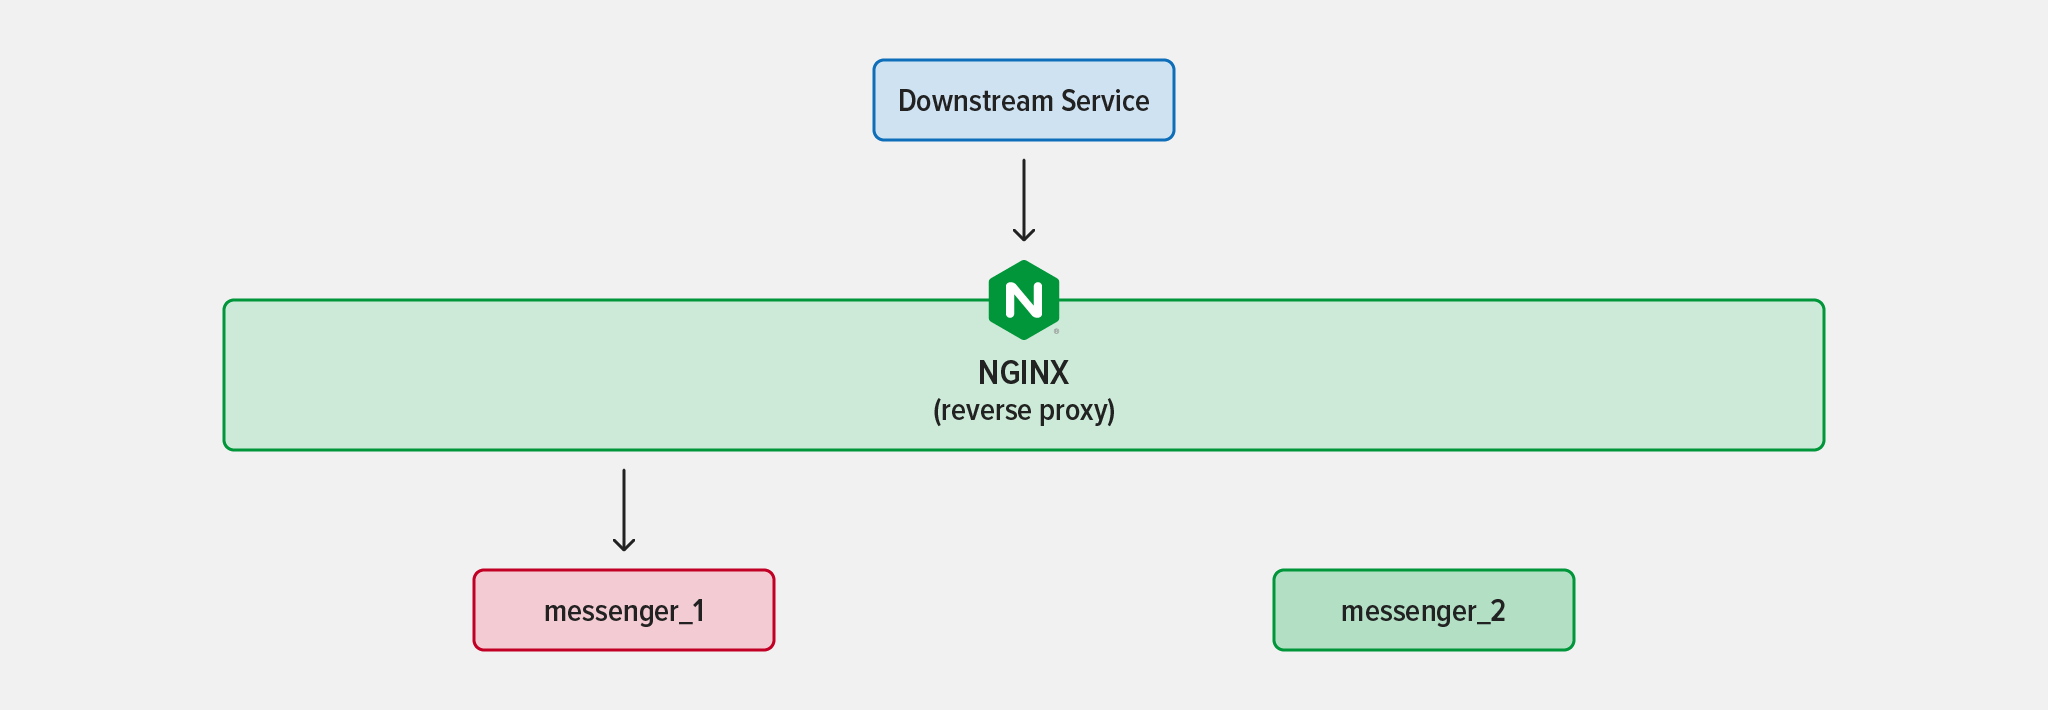
2つ目のmessengerサービスインスタンスをデプロイしたとき、NGINXはそのインスタンスが稼働していることをどのように認識し、トラフィックの送信を開始するのでしょうか。新しいインスタンスをNGINXの設定に手動で追加する方法もありますが、スケールアップやスケールダウンするサービスが増えると、すぐに管理が困難になります。
一般的な解決策は、高可用性のサービスレジストリ(Consulなど)を使用して、システム内のサービスを追跡することです。新しいサービスインスタンスは、デプロイ時にConsulへ登録されます。Consulは、インスタンスに定期的にヘルスチェックを送信して、そのステータスを監視します。ヘルスチェックに失敗したインスタンスは、利用可能なサービスのリストから削除されます。
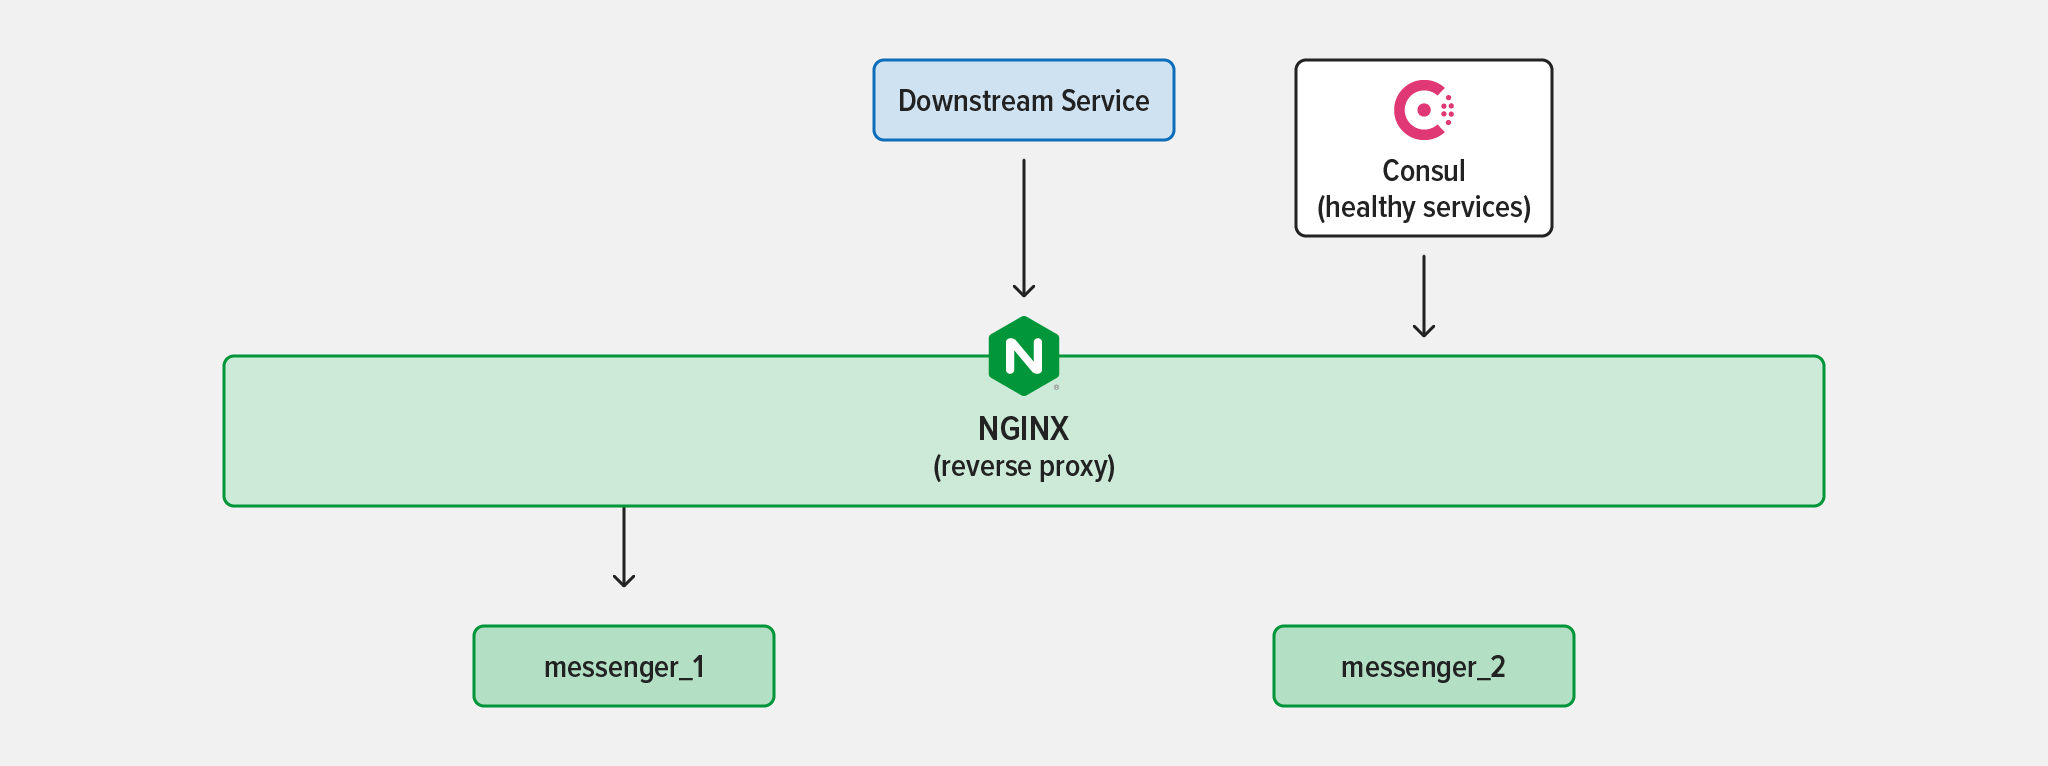
NGINXは、さまざまな方法でConsulなどのレジストリに問い合わせ、その結果に応じてルーティングを調整できます。NGINXは、リバースプロキシまたはロードバランサーとして動作する場合、トラフィックを「アップストリーム」サーバーにルーティングします。次のシンプルな設定を見てみましょう。
# Define an upstream group called "messenger_service"
upstream messenger_service {
    server 172.18.0.7:4000;
    server 172.18.0.8:4000;
}

server {
    listen 80;

    location /api {
        # Proxy HTTP traffic with paths starting with '/api' to the
        # 'upstream' block above. The default load-balancing algorithm,
        # Round-Robin, alternates requests between the two servers
        # in the block.
        proxy_pass http://messenger_service;
        proxy_set_header X-Forwarded-For $remote_addr;
    }
}
デフォルトでは、NGINXがトラフィックをルーティングするために、各messengerインスタンスの正確なIPアドレスとポートを把握している必要があります。この場合、172.18.0.7と172.18.0.8のいずれもポート4000です。
ここでConsulと「Consul template」が役立ちます。Consul templateはNGINXと同じコンテナで実行され、サービスレジストリを管理するConsulクライアントと通信します。
レジストリ情報が変更されると、Consul templateは正しいIPアドレスとポートを含む新しいバージョンのNGINX設定ファイルを生成し、NGINX設定ディレクトリに書き込んで、NGINXに設定の再読み込みを指示します。NGINXが設定を再読み込みする際にダウンタイムは発生せず、再読み込みが完了するとすぐに新しいインスタンスがトラフィックの受信を開始します。
このような状況でNGINXなどのリバースプロキシを使用すると、他のサービスからのアクセス先としてシステムに登録する接続ポイントを1つに集約できます。チームは、他のサービスからサービス全体にアクセスできなくなることを懸念せずに、個々のサービスインスタンスを柔軟に管理できます。
NGINXとMicroservices Marchを実際に体験
マイクロサービスによって、サービスの技術面だけでなく、他のチームとの関係という組織面でも複雑さが増すことは否めません。マイクロサービスアーキテクチャのメリットを得るには、モノリス向けに設計されたプラクティスを抜本的に見直し、大きく異なる環境に適用しても同じメリットが得られるかを確認することが重要です。このブログでは、Twelve-Factor Appの第3の要素がマイクロサービス環境でも引き続き価値をもたらす一方、具体的な適用方法を少し変更することで、さらに有効に活用できることを考察しました。
マイクロサービスアーキテクチャにおけるTwelve-Factor Appの適用について詳しくは、Microservices March 2023のUnit 1(近日ブログで公開予定)をご覧ください。無料で登録すると、このトピックに関するウェビナーとハンズオンラボをご利用いただけます。

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります