編集者 – 高容量・高可用性キャッシュに関するシリーズの第2回です:
- NGINX Plusキャッシュクラスターによる共有キャッシュ:第1部
- NGINX Plusキャッシュクラスターによる共有キャッシュ、パート2(本記事)
NGINXまたはNGINX Plusを使用して、大容量で高可用性のキャッシュクラスターを構築するにはどうすればよいでしょうか。この記事では、2台以上のNGINXまたはNGINX Plusキャッシュサーバーを使用して、高可用性キャッシュクラスターを構築する方法について説明します。(特に記載がない限り、ここで説明する方法はNGINX Open SourceとNGINX Plusの両方に同様に適用できますが、簡潔にするため、以降はNGINX Plusのみを使用します。)
振り返り:シャーディングされたキャッシュソリューション
このシリーズの第1回では、非常に大規模なシャーディング済みキャッシュクラスターを構築するためのパターンについて説明しました。
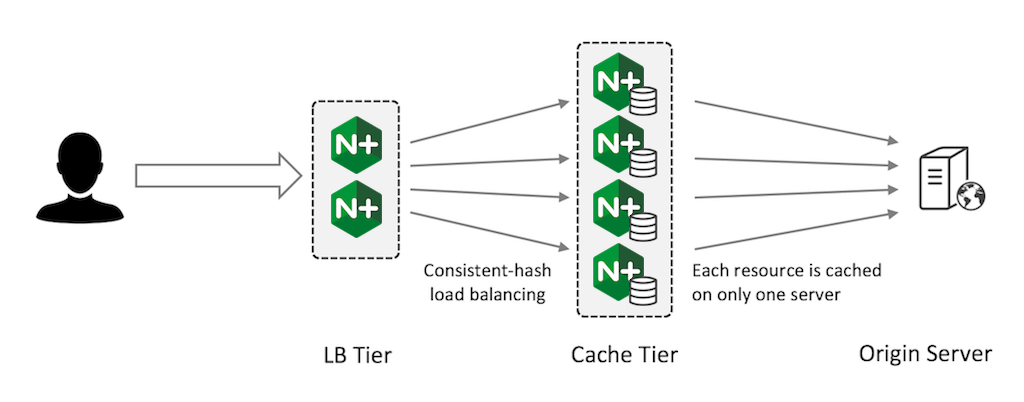
このパターンは、必要に応じて拡張できる非常に大容量のキャッシュを構築する場合に効果的です。各リソースは1台のサーバーにのみキャッシュされるため、完全なフォールトトレランスはありません。ただし、コンシステントハッシュによる負荷分散により、サーバーに障害が発生しても、無効になるのはそのサーバーが担当するキャッシュコンテンツだけです。
高可用性キャッシュクラスターの構築
オリジンサーバーへのリクエスト数を何よりも最小限に抑えることが最優先の目標である場合、キャッシュシャーディングは最適な選択肢ではありません。代わりに、プライマリとセカンダリのNGINX Plusインスタンスを慎重に構成することで、要件を満たすことができます。
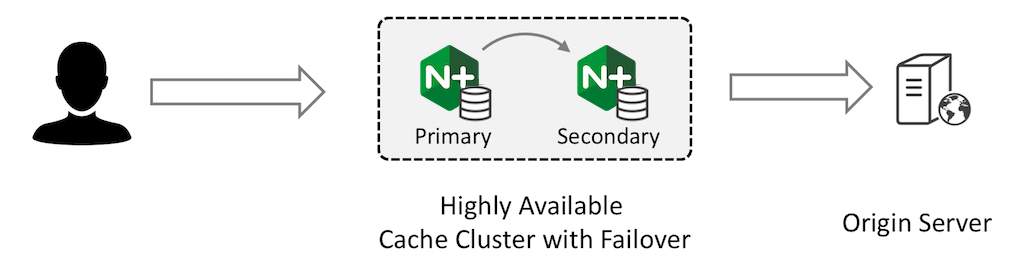
プライマリNGINX Plusインスタンスはすべてのトラフィックを受信し、リクエストをセカンダリインスタンスに転送します。セカンダリインスタンスはオリジンサーバーからコンテンツを取得してキャッシュします。プライマリインスタンスもセカンダリからのレスポンスをキャッシュし、クライアントに返します。
両方のデバイスにキャッシュが完全に格納され、設定したタイムアウトに従ってキャッシュが更新されます。
プライマリキャッシュサーバーの設定
プライマリキャッシュサーバーがすべてのリクエストをセカンダリサーバーに転送し、レスポンスをキャッシュするように設定します。アップストリームグループのbackupパラメーターをserverディレクティブに指定すると、セカンダリサーバーに障害が発生した場合、プライマリサーバーはリクエストをオリジンサーバーに直接転送します。
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://secondary;
    }
}

upstream secondary {
    zone secondary 128k;          # for NGINX Plus extended status

    server 192.168.56.11;         # secondary
    server 192.168.56.12 backup;  # origin
}
セカンダリキャッシュサーバーの設定
セカンダリキャッシュサーバーがリクエストをオリジンサーバーに転送し、レスポンスをキャッシュするように設定します。
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://origin;
    }
}

upstream origin {
    zone origin 128k;            # for NGINX Plus extended status

    server 192.168.56.12;        # origin
}
高可用性の設定
最後に、高可用性(HA)を構成する必要があります。これにより、プライマリサーバーに障害が発生した場合はセカンダリサーバーが受信トラフィックを引き継ぎ、その後プライマリサーバーが復旧すると、トラフィックはプライマリサーバーに戻ります。
この例では、NGINX Plus向けのアクティブ/パッシブHAソリューションを使用します。外部に公開される仮想IPアドレスは192.168.56.20で、プライマリキャッシュサーバーがクラスター内のHAプライマリノードとして機能します。NGINX Open Sourceを使用している場合は、keepalivedまたは別のHAソリューションを手動でインストールして構成できます。
フェイルオーバーのシナリオ
キャッシュサーバーに障害が発生しても稼働を継続できる、高可用性のキャッシュクラスターを構築することが目標です。また、キャッシュサーバーの障害発生時だけでなく、復旧後に古くなったコンテンツを更新する際にも、オリジンサーバーの負荷が増加しないようにする必要があります。
プライマリに障害が発生し、NGINX Plus HAソリューションが外部IPアドレスをセカンダリに移行したとします。
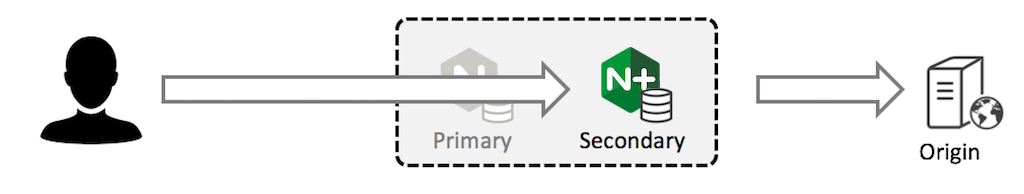
セカンダリには完全なキャッシュがあり、通常どおり動作を継続します。オリジンサーバーに追加の負荷はかかりません。
プライマリキャッシュサーバーが復旧してクライアントトラフィックの受信を開始すると、そのキャッシュは古い状態になっており、多くのエントリの有効期限が切れています。プライマリはセカンダリキャッシュサーバーからローカルキャッシュを更新します。セカンダリサーバーのキャッシュはすでに最新の状態であるため、オリジンサーバーへのトラフィックは増加しません。
ここで、セカンダリに障害が発生したとします。プライマリは、HAソリューションの一部として構成されたヘルスチェックを使用してこの障害を検出し、トラフィックをバックアップサーバー(オリジンサーバー)に直接転送します。
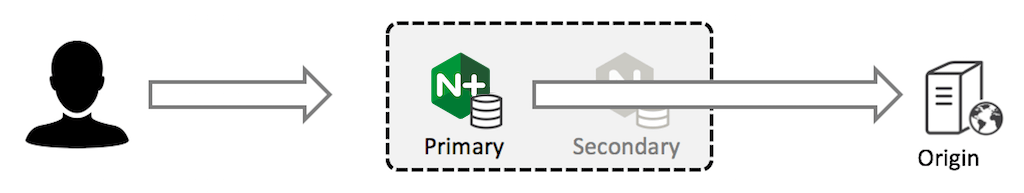
プライマリサーバーには完全なキャッシュがあり、通常どおり動作を継続します。この場合も、オリジンサーバーに追加の負荷はかかりません。
セカンダリサーバーが復旧した時点では、そのキャッシュは古くなっています。ただし、プライマリサーバーのキャッシュが期限切れになった場合にのみ、プライマリサーバーからリクエストを受信します。その時点では、セカンダリサーバー側のコピーも期限切れになっています。セカンダリサーバーはオリジンサーバーにコンテンツをリクエストする必要がありますが、オリジンサーバーへのリクエスト頻度が増えることはありません。オリジンサーバーへの悪影響もありません。
フェイルオーバー動作のテスト
HAソリューションをテストするため、オリジンサーバーでリクエストをログに記録し、各リクエストに対して現在時刻を返すように設定します。これにより、オリジンサーバーのレスポンスは1秒ごとに変わります。
access_log /var/log/nginx/access.log;
location / {
    return 200 "It's now $time_localn";
}プライマリおよびセカンダリのキャッシュサーバーは、ステータスコードが200のレスポンスを15 秒間キャッシュするように設定済みです。通常、キャッシュは15~16 秒ごとに更新されます。
proxy_cache_valid 200 15s;キャッシュ動作の確認
1秒に1回、キャッシュクラスターの高可用性仮想IPアドレスにHTTPリクエストを送信します。プライマリサーバーとセカンダリサーバーのキャッシュが期限切れになり、オリジンサーバーからのレスポンスで更新されるまで、レスポンスは変わりません。この処理は15秒または16秒ごとに発生します。
$ while sleep 1 ; do curl http://192.168.56.20/ ; done
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:19 -0800
It's now 9/Feb/2017:06:35:19 -0800
^C
オリジンサーバーのログを確認すると、リクエストを受信する間隔が15秒または16秒に1回だけであることも確認できます。
フェイルオーバーの確認
プライマリサーバーまたはセカンダリサーバーのいずれかを停止することで、フェイルオーバーが正常に機能していることを確認できます。たとえば、nginxプロセスを停止します。一定負荷テストは継続して実行され、レスポンスは一貫してキャッシュされます。
オリジンサーバーのアクセスログを確認すると、どちらのキャッシュサーバーで障害が発生または復旧しても、リクエストを受信するのは15~16秒ごとに1回だけであることが確認できます。
キャッシュ更新のタイミング
安定した状態では、キャッシュされたコンテンツは通常15~16秒ごとに更新されます。コンテンツは15秒後に期限切れとなり、次のリクエストを受信するまでに最大1秒の遅延があるため、その後キャッシュが更新されます。
キャッシュの更新が通常より遅く見えることがあります(コンテンツが変更されてから次に変更されるまで最大30秒)。これは、プライマリキャッシュサーバーのコンテンツが期限切れになった後、プライマリがセカンダリから有効期限が近いキャッシュコンテンツを取得した場合に発生します。問題となる場合は、セカンダリサーバーのキャッシュタイムアウトを短く設定できます。
まとめ
ここで説明した方法で2台以上のNGINXキャッシュサーバー間のキャッシュを階層化すると、可用性の高いキャッシュクラスターを効果的に構築できます。これにより、オリジンサーバーの負荷を最小限に抑え、いずれかのキャッシュサーバーで障害が発生した場合や復旧した場合に生じるトラフィックの急増からオリジンサーバーを保護できます。
キャッシュの総容量は、1台のキャッシュサーバーの容量に制限されます。本シリーズの第1回では、キャッシュサーバーのクラスター全体にキャッシュを分割する、別のシャーディングキャッシュパターンについて説明しています。この場合、総容量はすべてのキャッシュサーバーの容量の合計になりますが、コンテンツは複製されないため、キャッシュサーバーに障害が発生した際にオリジンサーバーへのトラフィックが急増するのを防ぐことはできません。
お客さまのサーバーで高可用性キャッシュをお試しください。今すぐ30日間の無料トライアルを開始するか、ユースケースについてご相談ください。
著者について

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります