NGINXが接続処理に非同期のイベント駆動型アプローチを採用していることは広く知られています。つまり、従来型アーキテクチャのサーバーのようにリクエストごとに専用のプロセスやスレッドを新たに作成するのではなく、1つのワーカープロセスで複数の接続とリクエストを処理します。これを実現するため、NGINXはソケットをノンブロッキングモードで動作させ、epollやkqueueなどの効率的な手法を使用します。
フルウェイトプロセスの数は少なく(通常はCPUコアごとに1つのみ)、一定であるため、メモリ消費量を大幅に抑えられ、タスク切り替えでCPUサイクルが無駄になることもありません。このアプローチの利点は、NGINX自体が実証しています。NGINXは数百万件の同時リクエストを適切に処理し、優れたスケーラビリティを発揮します。
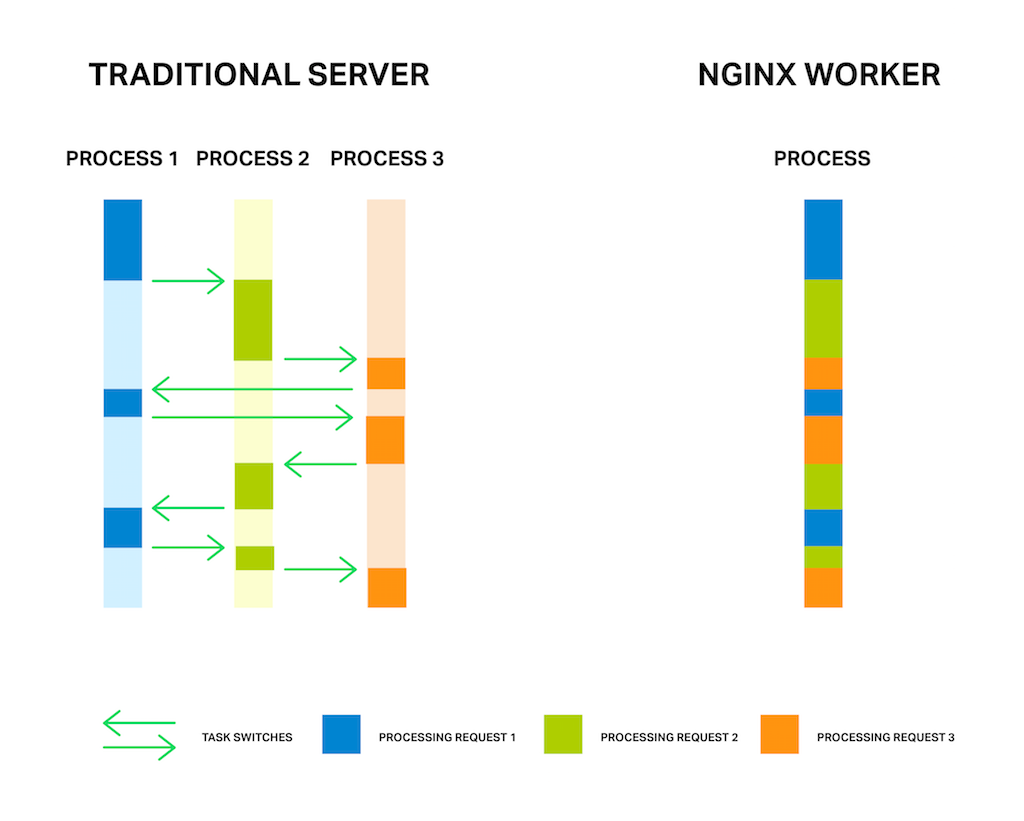
しかし、非同期のイベント駆動型アプローチにも、依然として問題があります。私の言い方では「敵」です。その敵の名は、ブロッキングです。残念ながら、多くのサードパーティ製モジュールがブロッキング呼び出しを使用しており、ユーザー(場合によってはモジュールの開発者でさえも)がその欠点を認識していません。ブロッキング処理はNGINXのパフォーマンスを損なう可能性があるため、必ず回避しなければなりません。
現在の公式NGINXコードでも、すべてのケースでブロッキング処理を回避できるわけではありません。この問題を解決するため、新しい「スレッドプール」メカニズムがNGINXバージョン1.7.11に実装され、NGINX Plus Release 7にも導入されました。その仕組みと使用方法については後ほど説明します。まずは、この敵と正面から向き合ってみましょう。
編集者注:NGINX Plus R7の概要については、ブログ記事「NGINX Plus R7の発表」をご覧ください。
NGINX Plus R7のその他の新機能について詳しくは、以下の関連記事をご覧ください。
- NGINX PlusがHTTP/2を完全サポート
- NGINXにおけるソケットシャーディング
- リリース7の新しいNGINX Plusダッシュボード<.htmla>
- NGINX Plus R7のTCPロードバランシング<.htmla>
課題
まず、この問題をより深く理解するために、NGINXの仕組みについて簡単に説明します。
一般に、NGINXはイベントハンドラーとして、接続上で発生するすべてのイベントに関する情報をカーネルから受け取り、実行すべき処理をオペレーティングシステムに指示するコントローラーです。実際には、NGINXがオペレーティングシステムを制御して複雑な処理を担い、オペレーティングシステムはバイトの読み取りや送信といった定型的な処理を行います。そのため、NGINXが迅速かつ適切なタイミングで応答することが非常に重要です。
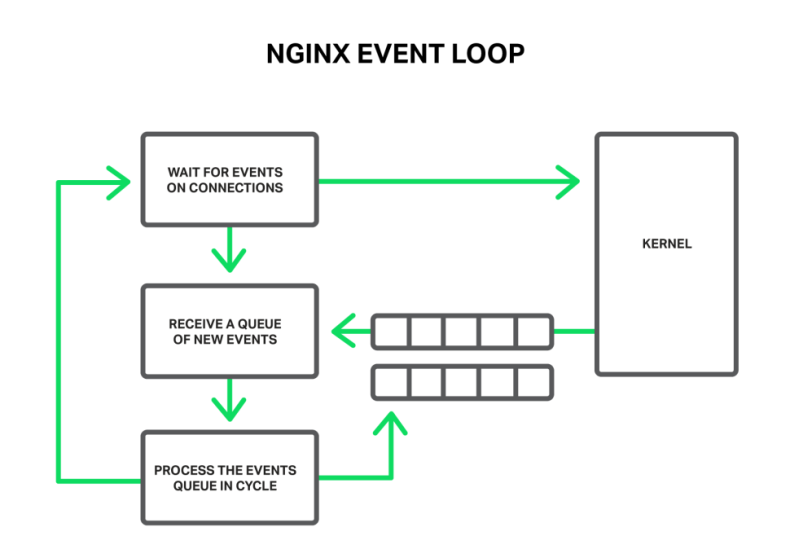
イベントには、タイムアウト、読み取りまたは書き込みの準備ができたソケットに関する通知、発生したエラーに関する通知などがあります。NGINXは複数のイベントを受信し、必要な処理を1つずつ実行します。つまり、すべての処理は1つのスレッドで、キューを順に処理する単純なループとして実行されます。NGINXはキューからイベントを取り出し、たとえばソケットへの書き込みやソケットからの読み取りを行います。ほとんどの場合、この処理は極めて高速であり(メモリ内のデータをコピーするために数CPUサイクルしか必要としない場合もあります)、NGINXはキュー内のすべてのイベントを瞬時に処理します。
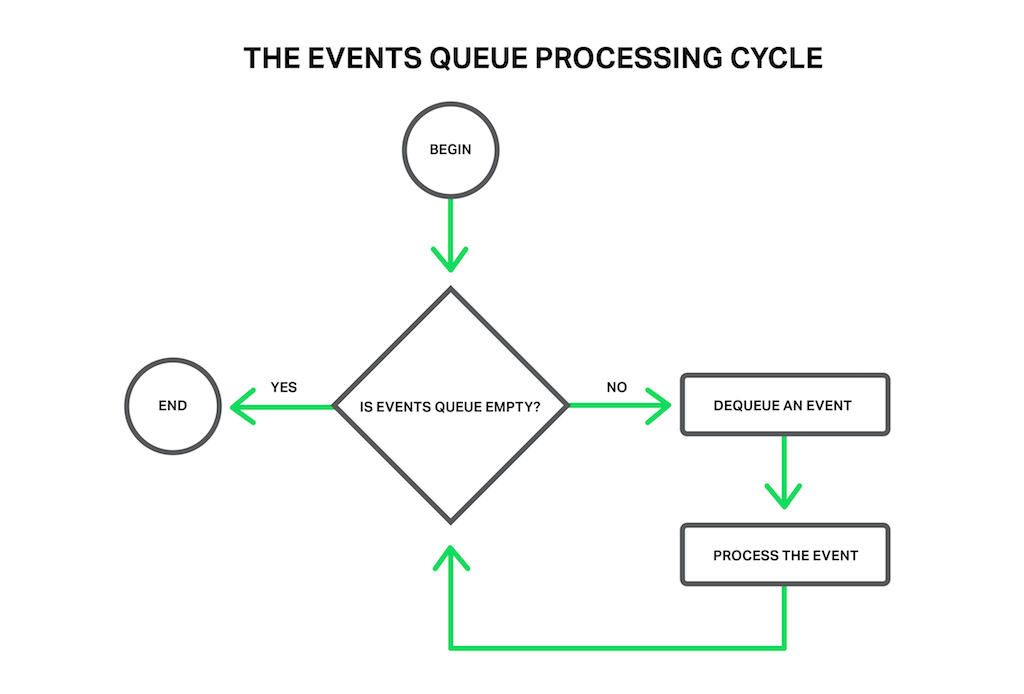
しかし、時間がかかり負荷の高い処理が発生した場合はどうなるでしょうか。イベント処理サイクル全体が、その処理の完了を待つ間、停止してしまいます。
したがって、「ブロッキング処理」とは、イベント処理のサイクルを長時間停止させる処理を指します。処理がブロッキングになる理由はさまざまです。たとえば、NGINXが時間のかかるCPU負荷の高い処理を実行している場合や、リソースへのアクセスを待機しなければならない場合があります。リソースには、ハードドライブ、ミューテックス、データベースから同期的に応答を取得するライブラリ関数の呼び出しなどが含まれます。重要なのは、このような処理の実行中、ワーカープロセスはほかの処理を行えず、ほかのイベントも処理できないという点です。利用可能なシステムリソースがほかにあり、キュー内の一部のイベントがそのリソースを利用できる場合でも同様です。
店員の前に長い行列ができている店を想像してください。列の先頭にいる客が、店頭にはなく倉庫にある商品を求めます。店員は商品を取りに倉庫へ向かいます。その結果、列に並ぶ全員が商品の到着まで数時間待たなければならず、不満を募らせます。人々がどのような反応を示すか、想像できるでしょうか。列に並ぶ全員の待ち時間が数時間も延びますが、その人たちが買おうとしている商品は、店内にあるかもしれないのです。
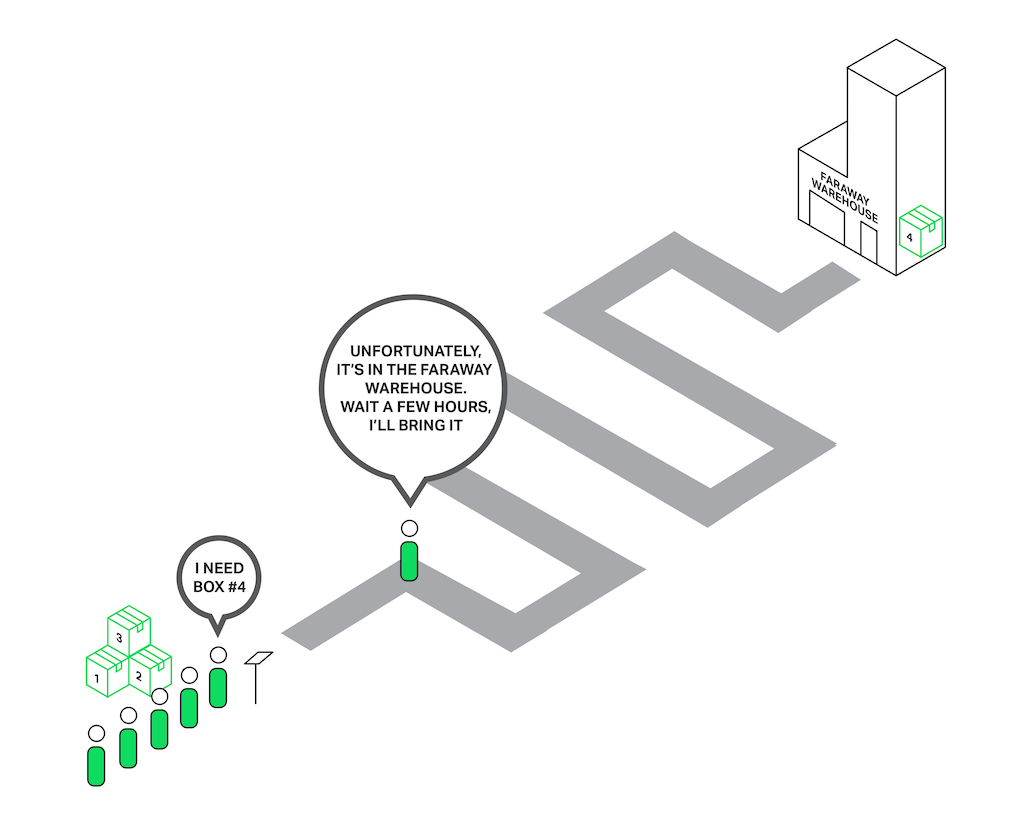
NGINXが、メモリにキャッシュされておらず、ディスクから読み込む必要があるファイルを読み取ろうとする場合にも、ほぼ同じ状況が発生します。ハードドライブは低速であり(特に回転式のもの)、キューで待機している他のリクエストはドライブにアクセスする必要がない場合でも、待たざるを得ません。その結果、レイテンシーが増加し、システムリソースを十分に活用できなくなります。
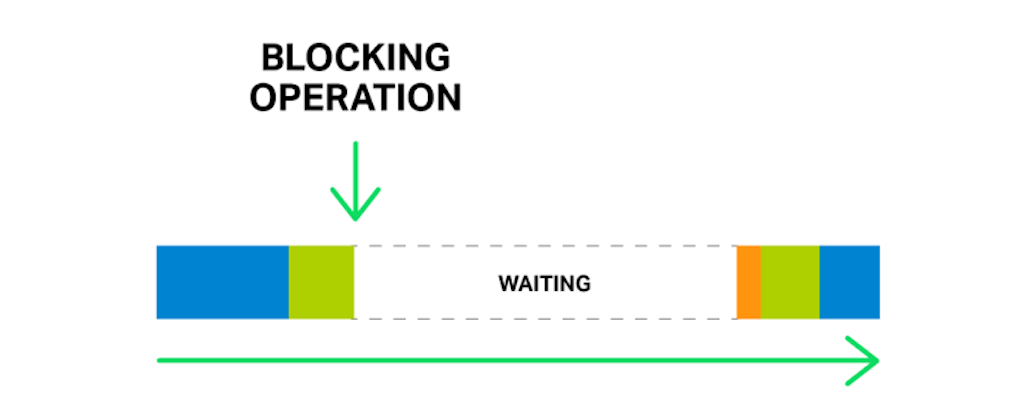
一部のオペレーティングシステムは、ファイルの読み取りと送信に使用できる非同期インターフェースを提供しており、NGINXはこのインターフェースを利用できます(aioディレクティブを参照)。その好例がFreeBSDです。残念ながら、Linuxについては同じことが言えません。Linuxにもファイル読み取り用の一種の非同期インターフェースがありますが、重大な欠点がいくつかあります。その1つは、ファイルアクセスとバッファーにアライメント要件があることですが、NGINXはこれに適切に対応します。しかし、もう1つの問題はさらに深刻です。この非同期インターフェースを使用するには、ファイルディスクリプターにO_DIRECTフラグを設定する必要があります。そのため、ファイルへのすべてのアクセスがメモリ内のキャッシュを迂回し、ハードディスクの負荷が増加します。したがって、多くのケースに最適とは言えません。
特にこの問題を解決するため、NGINX 1.7.11およびNGINX Plus Release 7でスレッドプールが導入されました。
それでは、スレッドプールとは何か、どのように機能するのかを詳しく見ていきましょう。
スレッドプール
遠くの倉庫から商品を運ぶ、気の毒な販売員の話に戻りましょう。しかし、彼も知恵をつけ(怒った顧客の群れに痛い目に遭わされて、賢くなったのかもしれません)、配送サービスを雇いました。今では、遠くの倉庫にある商品を求められても、自ら倉庫へ行く代わりに配送サービスへ依頼するだけです。配送サービスが注文に対応している間も、販売員はほかの顧客への対応を続けられます。そのため、配送を待つのは店頭に商品がない顧客だけで、それ以外の顧客にはすぐに対応できます。
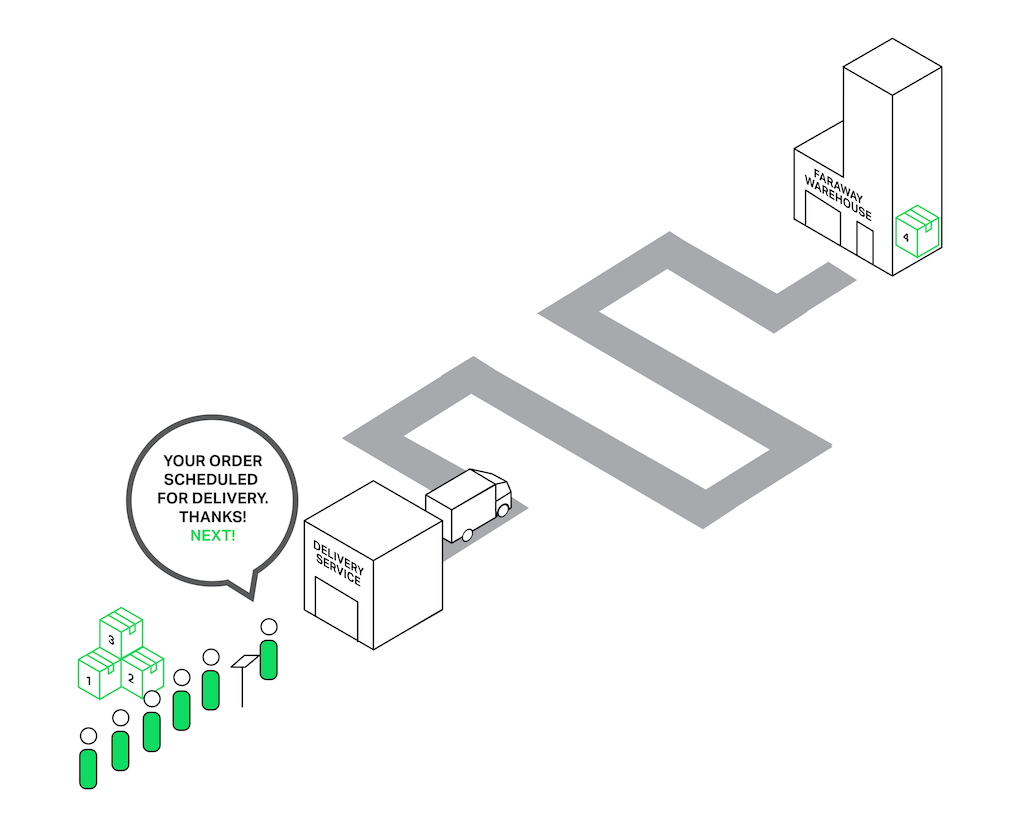
NGINXで言えば、スレッドプールが配送サービスの役割を果たします。スレッドプールは、タスクキューと、そのキューを処理する複数のスレッドで構成されます。ワーカープロセスが時間のかかる可能性のある処理を実行する必要がある場合、その処理を自ら行う代わりに、タスクをプールのキューに追加します。キューに追加されたタスクは、空いている任意のスレッドが取り出して処理できます。
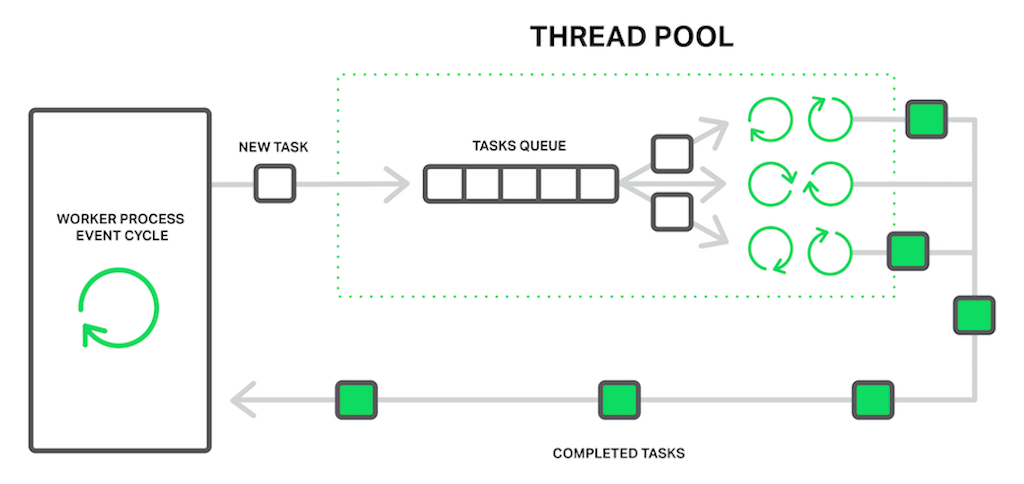
つまり、別のキューができるように見えます。そのとおりです。ただし、この場合、キューは特定のリソースによって制限されます。ドライブがデータを供給できる速度を超えて、ドライブから読み取ることはできません。少なくともこれで、ドライブが他のイベントの処理を遅らせることはなくなり、ファイルへのアクセスが必要なリクエストだけが待機するようになります。
「ディスクからの読み取り」操作は、ブロッキング操作の最も一般的な例としてよく挙げられますが、実際にはNGINXのスレッドプール実装は、メインの処理サイクルでの実行に適さないあらゆるタスクに使用できます。
現時点では、スレッドプールへのオフロードが実装されているのは、次の3つの主要な処理に限られます。ほとんどのオペレーティングシステムにおけるread()システムコール、Linuxにおけるsendfile()、およびキャッシュ用ファイルなど一部の一時ファイルへの書き込み時に使用されるLinuxのaio_write()です。今後もこの実装のテストとベンチマークを継続し、明確なメリットが得られる場合は、将来のリリースで他の処理もスレッドプールにオフロードする可能性があります。
編集者注: aio_write() システムコールのサポートは、NGINX 1.9.13およびNGINX Plus R9で追加されました。
ベンチマーク
理論から実践へ移りましょう。スレッドプールを使用した場合の効果を示すため、ブロッキング処理とノンブロッキング処理が最悪の形で混在する状況をシミュレートした合成ベンチマークを実施します。
このテストには、メモリに収まらないことが確実なデータセットが必要です。48 GBのRAMを搭載したマシン上で、4 MBのファイルに分割した256 GBのランダムデータを生成し、そのデータを配信するようにNGINX 1.9.0を設定しました。
設定は非常にシンプルです。
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}ご覧のとおり、パフォーマンスを向上させるために、いくつかのチューニングを行っています。loggingとaccept_mutexを無効にし、sendfileを有効にして、sendfile_max_chunkを設定しています。最後のディレクティブにより、ブロッキングsendfile()呼び出しに費やされる最大時間を短縮できます。これは、NGINXがファイル全体を一度に送信しようとせず、512 KBのチャンク単位で送信するためです。
このマシンには、Intel Xeon E5645プロセッサーを2基(合計12コア、24 HTスレッド)と、10 Gbpsのネットワークインターフェースを搭載しています。ディスクサブシステムは、RAID10アレイを構成する4台のWestern Digital WD1003FBYXハードドライブで構成されています。これらのハードウェアはすべて、Ubuntu Server 14.04.1 LTS上で稼働しています。
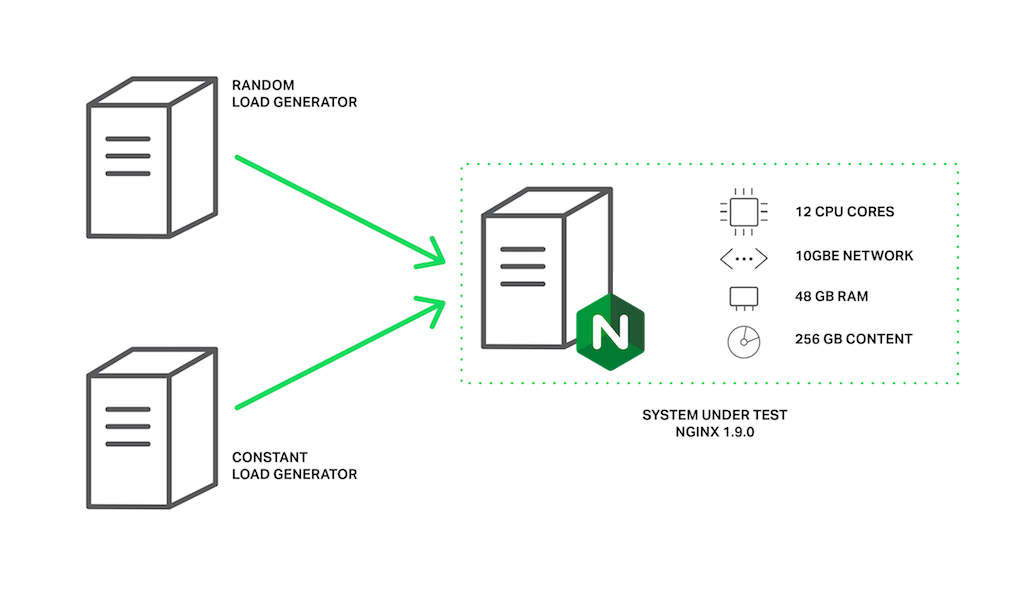
クライアントには、同じ仕様のマシンを2台使用します。そのうちの1台では、wrkがLuaスクリプトを使用して負荷を生成します。このスクリプトは、200の並列接続を使用してサーバー上のファイルをランダムな順序でリクエストします。各リクエストでは、キャッシュミスが発生し、ディスクからのブロッキング読み取りが行われる可能性があります。この負荷を「ランダム」負荷と呼びます。
2台目のクライアントマシンでは、別のwrkを実行し、50の並列接続を使用して同じファイルを繰り返しリクエストします。このファイルは頻繁にアクセスされるため、常にメモリ内に保持されます。通常であれば、NGINXはこれらのリクエストを非常に高速に処理しますが、ワーカープロセスが他のリクエストによってブロックされると、パフォーマンスが低下します。この負荷を「一定」負荷と呼ぶことにします。
パフォーマンスは、ifstatを使用してサーバーマシンのスループットを監視し、2台目のクライアントからwrkの結果を取得することで測定します。
まず、スレッドプールを使用しない最初の実行では、あまり芳しい結果は得られませんでした。
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
ご覧のとおり、この構成では、サーバー全体で約1 Gbpsのトラフィックを生成できます。topの出力を見ると、すべてのワーカープロセスがほとんどの時間をブロッキングI/Oに費やしていることがわかります(プロセスはD状態です)。
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart 20 0 40304 4160 2208 S 0.0 0.0 0:00.53 zshこの場合、スループットはディスクサブシステムによって制限されており、CPUはほとんどの時間アイドル状態です。wrkの結果も非常に低くなっています。
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
なお、これはメモリから配信されるはずのファイルに対する結果です。レイテンシーが極端に大きいのは、すべてのワーカープロセスが、最初のクライアントによる200件の接続で生成されたランダムな負荷を処理するためにドライブからファイルを読み込む作業に追われ、こちらのリクエストを適時に処理できないためです。
ここで、スレッドプールを活用します。そのためには、aio threadsディレクティブをlocationブロックに追加するだけです。
location / {    root /storage;
    aio threads;
}
その後、NGINXに設定を再読み込みさせます。
その後、テストを再度実行します。
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
これで、サーバーのスループットは、スレッドプールを使用しない場合の約1 Gbpsに対して9.5 Gbpsに達します。
さらに高い性能を発揮できる可能性はありますが、すでに実用上のネットワーク容量の上限に達しているため、このテストではネットワークインターフェースがNGINXのボトルネックになっています。ワーカープロセスは、ほとんどの時間をスリープして新しいイベントを待つことに費やしています(S状態であることをtopで確認できます):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
CPUリソースにはまだ十分な余裕があります。
The results of wrkの結果:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
4 MBのファイルを配信する平均時間は7.42秒から226.32ミリ秒へと短縮され(約33分の1)、1秒あたりのリクエスト数は31倍(8から250)に増加しました。
これは、ワーカープロセスが読み取り処理でブロックされている間も、リクエストがイベントキューで処理を待つことなく、空いているスレッドによって処理されるためです。ディスクサブシステムが、1台目のクライアントマシンからのランダム負荷に可能な限り対応している間、NGINXは残りのCPUリソースとネットワーク容量を使用し、2台目のクライアントからのリクエストをメモリから処理します。
それでも万能の解決策ではない
ブロッキング処理への懸念を踏まえ、さらに期待の持てる結果も得られたことから、多くの方がすでにサーバーでスレッドプールを設定しようとしているかもしれません。しかし、急がないでください。
実際のところ、幸いにも、ファイルの読み取りや送信処理の大半では、低速なハードドライブに直接アクセスすることはありません。データセットを格納できるだけの十分なRAMがあれば、オペレーティングシステムが頻繁に使用するファイルを、いわゆる「ページキャッシュ」にキャッシュします。
ページキャッシュは非常に効率よく機能するため、一般的なユースケースのほぼすべてでNGINXは優れたパフォーマンスを発揮できます。ページキャッシュからの読み取りは非常に高速であり、このような処理を「ブロッキング」と呼ぶことはできません。一方、スレッドプールへのオフロードには多少のオーバーヘッドが伴います。
したがって、十分な量のRAMがあり、処理対象のデータセットがそれほど大きくなければ、NGINXはスレッドプールを使用しなくても、すでに最適な方法で動作します。
読み取り処理をスレッドプールにオフロードする手法は、非常に限定的なタスクに適用できます。特に、頻繁にリクエストされるコンテンツの量がオペレーティングシステムのVMキャッシュに収まらない場合に有効です。たとえば、高負荷のNGINXベースのストリーミングメディアサーバーが該当する可能性があります。ベンチマークでは、この状況を再現しました。
読み取り処理のスレッドプールへのオフロードを改善できれば理想的です。そのために必要なのは、必要なファイルデータがメモリ上にあるかどうかを効率的に判定し、メモリ上にない場合にのみ、読み取り処理を別のスレッドにオフロードする方法です。
販売の例えに戻ると、現状では販売員は注文された商品が店舗にあるかどうかを把握できないため、すべての注文を常に配送サービスに回すか、常に自分で処理するかのどちらかを選ばなければなりません。
原因は、オペレーティングシステムにこの機能がないことです。2010年には、Linuxにfincore()システムコールとして追加する最初の試みが行われましたが、実現しませんでした。その後、preadv2()という新しいシステムコールにRWF_NONBLOCKフラグを指定する形で実装する試みが何度も行われました(詳細については、LWN.netの「ノンブロッキングのバッファードファイル読み取り処理」および「非同期のバッファード読み取り処理」を参照してください)。これらのパッチがどうなるかは、今も不透明です。残念なのは、これらのパッチがいまだにカーネルに採用されていない主な理由が、延々と続く些末な議論にあると思われることです。
一方、FreeBSDのユーザーはまったく心配する必要がありません。FreeBSDには、ファイル読み取り用として十分に優れた非同期インターフェースがすでに用意されているため、スレッドプールの代わりにこちらを使用してください。
スレッドプールの設定
ユースケースでスレッドプールを使用するメリットがあると確信できたら、次は設定について詳しく見ていきましょう。
設定は非常に簡単で柔軟です。まず、--with-threads引数を指定してconfigureコマンドでコンパイルしたNGINXバージョン1.7.11以降が必要です。NGINX Plusの場合はRelease 7以降が必要です。最も単純なケースでは、設定は非常にシンプルです。必要なのは、適切なコンテキストにaio threadsディレクティブを含めることだけです。
# in the 'http', 'server', or 'location' contextaio threads;これは、スレッドプールの最小構成です。実際には、次の構成を簡略化したものです。
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;これは、defaultという名前のスレッドプールを定義します。このプールには32個のワーカースレッドがあり、タスクキューの最大長は65,536タスクです。タスクキューが過負荷になると、NGINXはリクエストを拒否し、次のエラーをログに記録します。
thread pool "NAME" queue overflow: N tasks waitingこのエラーは、キューに処理が追加される速度にスレッドの処理が追いついていない可能性があることを示します。キューの最大サイズを増やしてみることはできますが、それでも解決しない場合は、システムがそれほど多くのリクエストを処理できないことを意味します。
すでにお気づきのとおり、thread_poolディレクティブでは、スレッド数、キューの最大長、特定のスレッドプールの名前を設定できます。スレッドプールに名前を付けることで、複数の独立したスレッドプールを設定し、設定ファイル内の異なる箇所で目的に応じて使い分けることができます。
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
If the max_queueパラメーターを指定しない場合、デフォルト値として65536が使用されます。上記のように、max_queueは0に設定できます。この場合、スレッドプールが処理できるタスク数は、設定されたスレッド数までとなり、キューで待機するタスクはありません。
ここで、3台のハードドライブを搭載したサーバーがあり、バックエンドからのすべてのレスポンスをキャッシュする「キャッシュプロキシ」として動作させる場合を考えてみましょう。想定されるキャッシュデータ量は、利用可能なRAM容量を大幅に上回ります。つまり、独自のCDN用キャッシュノードとして使用するケースです。この場合、最も重要なのは、ハードドライブのパフォーマンスを最大限に引き出すことです。
選択肢の1つは、RAIDアレイを構成することです。この方法にはメリットとデメリットがあります。NGINXでは、別の方法も選択できます。
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}この構成では、thread_poolディレクティブによりディスクごとに専用の独立したスレッドプールを定義し、proxy_cache_pathディレクティブによりディスクごとに専用の独立したキャッシュを定義します。
The split_clientsモジュールは、キャッシュ間(したがってディスク間)の負荷分散に使用され、このタスクに最適です。
The use_temp_path=off パラメーターを proxy_cache_path ディレクティブに指定すると、NGINXは一時ファイルを対応するキャッシュデータと同じディレクトリに保存します。これは、キャッシュの更新時にハードドライブ間でレスポンスデータがコピーされるのを防ぐために必要です。
これらを組み合わせることで、NGINXは個別のスレッドプールを介して各ドライブを並列かつ独立して処理し、現在のディスクサブシステムのパフォーマンスを最大限に引き出せます。各ドライブは、ファイルの読み取りと送信用の専用タスクキューを備えた16個の独立したスレッドによって処理されます。
このカスタム仕様のアプローチは、クライアントにもきっと好評でしょう。ハードドライブにとっても同様です。
この例は、使用するハードウェアに合わせてNGINXをいかに柔軟にチューニングできるかをよく示しています。これは、マシンやデータセットと最適な方法で連携するよう、NGINXに指示を与えるようなものです。さらに、ユーザー空間でNGINXを微調整することで、ソフトウェア、オペレーティングシステム、ハードウェアを最適なモードで連携させ、すべてのシステムリソースを可能な限り効率的に活用できます。
まとめ
まとめると、スレッドプールは、NGINXの長年にわたる既知の課題の1つであるブロッキングを解消し、特に非常に大量のコンテンツを扱う場合に、NGINXのパフォーマンスを新たなレベルへと引き上げる優れた機能です。
さらに多くの可能性が広がっています。前述のとおり、この新しいインターフェースを使用すれば、時間のかかるブロッキング処理を、パフォーマンスを損なうことなくオフロードできる可能性があります。これにより、多数の新しいモジュールや機能をNGINXに追加できるようになり、新たな展望が開けます。多くの一般的なライブラリは、現在も非同期ノンブロッキングインターフェースを提供していないため、これまではNGINXで使用できませんでした。ライブラリ独自のノンブロッキング版プロトタイプの開発には、多くの時間とリソースがかかる可能性がありますが、その労力が常に報われるとは限りません。スレッドプールを利用できるようになった今では、このようなライブラリを比較的容易に使用し、パフォーマンスに影響を与えることなくモジュールを作成できます。
今後の展開にご期待ください。
NGINX Plusのスレッドプールをぜひお試しください。今すぐ30日間の無料トライアルを開始するか、ユースケースについてご相談いただくため、F5までお問い合わせください。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります