
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開を、より俊敏に実現できます。
フードデリバリーアプリを6か月後に再検証……
以前の「記事」では、架空の料理注文・配達サービスを取り上げ、日常業務における主要なワークフローとして、顧客による注文プロセス、商品の受け取りと料理の配達、決済処理を紹介しました。また、これらのワークフローへの主要なデータ入力を考慮して意図的にデータ戦略を策定することで、ビジネスプロセスの堅牢性が高まり、俊敏に拡張できるようになる仕組みを検討しました。
この記事では、日々の業務効率化にとどまらず、データアーキテクチャを事前に設計しておくことで得られる、より長期的かつ戦略的なメリットをご紹介します。最初のシナリオから6か月後、アプリケーションが成功したと仮定すると、ビジネスリーダーは新たに生まれつつある機会をいくつか見いだしています。そして、そうした具体的な機会とそれに伴う課題に対して、基盤システムをどれだけ迅速かつ容易に調整し、適応させられるかを技術担当者に問いかけています。
- サービスの成長が加速しており、事業をさらに多くの都市へ展開したいと考えています。
- 事業拡大の一環として、このサービスは収益性の高いカリフォルニア市場への参入を目指していますが、それに伴い、追加のデータガバナンス要件への対応が必要になります。
- 配送時間が徐々に長くなっており、その多くは予期しない需要の急増が原因です。このテクノロジーは、この問題の解決に役立つでしょうか?
- 新興スタートアップとの競争が激化する中、一部のレストランは競合サービスへの移行を検討しています。サプライヤーであるレストランに付加価値を示し、継続利用を促すことはできるでしょうか?
ここに挙げた4つの課題例は、大きく2つのカテゴリーに分類できます。
1つ目は、日常的な主要業務プロセス(「戦術的」プロセス)を調整し、効率を向上させることです。
2つ目は、新たな知見を生み出し、企業に直接、または顧客を通じて間接的に、より長期的な(「戦略的」)価値をもたらすことです。
最初の2つの新たな課題である事業地域の拡大と、それに伴うコンプライアンス要件は、戦術的なビジネスプロセスに関するものであり、より業務運用的な性質を持ちます。残りの2つの課題は、より戦略的な性質を持ちます。
まず、戦術面と運用面の懸念事項を見ていきましょう。
運用効率の向上
対象地域を新たな都市へ拡大すると、いくつかの異なる問題が生じる可能性があります。配送ワークフローで想定される問題の1つは、住所を一意に特定できない場合があることです。同じ住所(例:「100 Main St.」)が複数の都市に存在する可能性があります。もう1つ考えられるのは、都市によってタイムゾーンが異なる場合があることです。この点を考慮しないと、MDTの午後6時に集荷した荷物が、隣接するPDTの都市では午後6時30分の配達予定時刻に1時間遅れる可能性があります。前回の記事で説明したデータアーキテクチャには、データ要素を「正規化」された、つまりグローバルに一意な形式で表現するという考え方が組み込まれています。これにより、これら2つの潜在的な問題に対処し、アプリケーションがこうした追加要件にも暗黙的に対応できるようになります。
2つ目の実務上の懸念事項は、カリフォルニア州の追加のデータガバナンス要件への準拠です。カリフォルニア州消費者プライバシー法(CCPA)に関する一連の懸念事項は、それだけで複数の記事を要するテーマですが、その一つに、顧客に関するすべてのデータを、収集日時とデータソースの情報を付加したうえで収集できるようにすることがあります。前述のとおり、主要なデータ取り込みパイプラインでタイムスタンプなどのメタデータ注釈を追加できるデータアーキテクチャフレームワークを構築することで、追加のデータガバナンス要件にも、最小限の追加作業で容易に対応できます。
戦略的価値
企業の日常的かつ戦術的なワークフローやプロセスの改善によって生まれるビジネス価値に加え、もう1つのメリットがあります。それは、既存の競争環境を自社に有利な方向へ変えるとともに、新たに参入できる市場を切り開くという戦略的価値であり、こちらの方がより重要だとも言えます。
アダプティブアプリケーションに向けた運用ワークフローの再構築
戦略的メリットの1つは、主要な運用ワークフローの設計を変更することで、「競争条件を有利に変える」ことができる点です。これは単なる最適化にとどまらず、ワークフローそのものを再構想することを意味します。堅牢で将来を見据えたデータアーキテクチャにより、動的価格設定を活用して、需要変動に起因する前述の配送時間の悪化という課題に対処するために必要な主要機能(集約とデータ分析)を、俊敏かつ効率的に活用できます。
より具体的には、データアーキテクチャを先を見据えて設計したことで、次のことが可能になります。
- 複数のデータベーステーブルにまたがる場合でも、一貫した構文とセマンティクスを使用して、各注文と配送のタイムスタンプを永続化します
- 集荷場所と配送先の両方について、ここでも一貫した構文とセマンティクスを使用して履歴を保持します
その結果、注文と配達という2つの異なるワークフローのデータを関連付け、分類し、集約できます。また、柔軟なメタデータアーキテクチャを活用し、照合したデータに分析用の詳細なコンテキスト情報を付加できます。ここで、注文を受けてから料理を届けるまでの時間である、配達全体のレイテンシーについて考えてみます。このレイテンシーは、注文と配達のワークフローを横断してデータを関連付けることで算出できます。さらに、2つのワークフローで位置情報データの表現にも一貫した構文とセマンティクスが使用されているため、配達レイテンシーの算出結果と相関関係を、郵便番号などの地域別に分けることができます。このように、データ戦略を事前に十分検討しておくことで、配達全体のレイテンシーを1時間単位かつ郵便番号単位で示すデータセットを、より容易に作成できます。さらに、柔軟なメタデータのアプローチを活用することで、時間単位の統計情報に、交通状況や総降水量などのコンテキスト情報を追加できます。
この時点で、分析パイプラインに投入できる豊富な情報が揃います。分析パイプラインでは、予測AIの手法を用いて、全体的な配達時間の増加と相関するパターンを認識し、将来そのような状況が発生することを予測することも可能です。
このストーリーの最後のステップとして、企業が配送ワークフローを需給の問題として捉え直し、価格設定によって需要と供給のバランスを取る姿を想像できます。具体的には、固定スケジュールに従うか、リアルタイムの状況に基づいて動的に、時間帯や場所に応じて配送ドライバーの報酬を調整できるようにします。これにより、データを活用してビジネス上の課題(配送全体の所要時間の管理)に対処するための具体的な措置(価格調整)を講じ、クローズドループのフィードバック(観測された所要時間に応じた動的な価格調整)を用いてワークフローを「適応型」にすることで、データサイクルの「ループを閉じる」ことができます。
データから直接収益化できるビジネス価値を創出
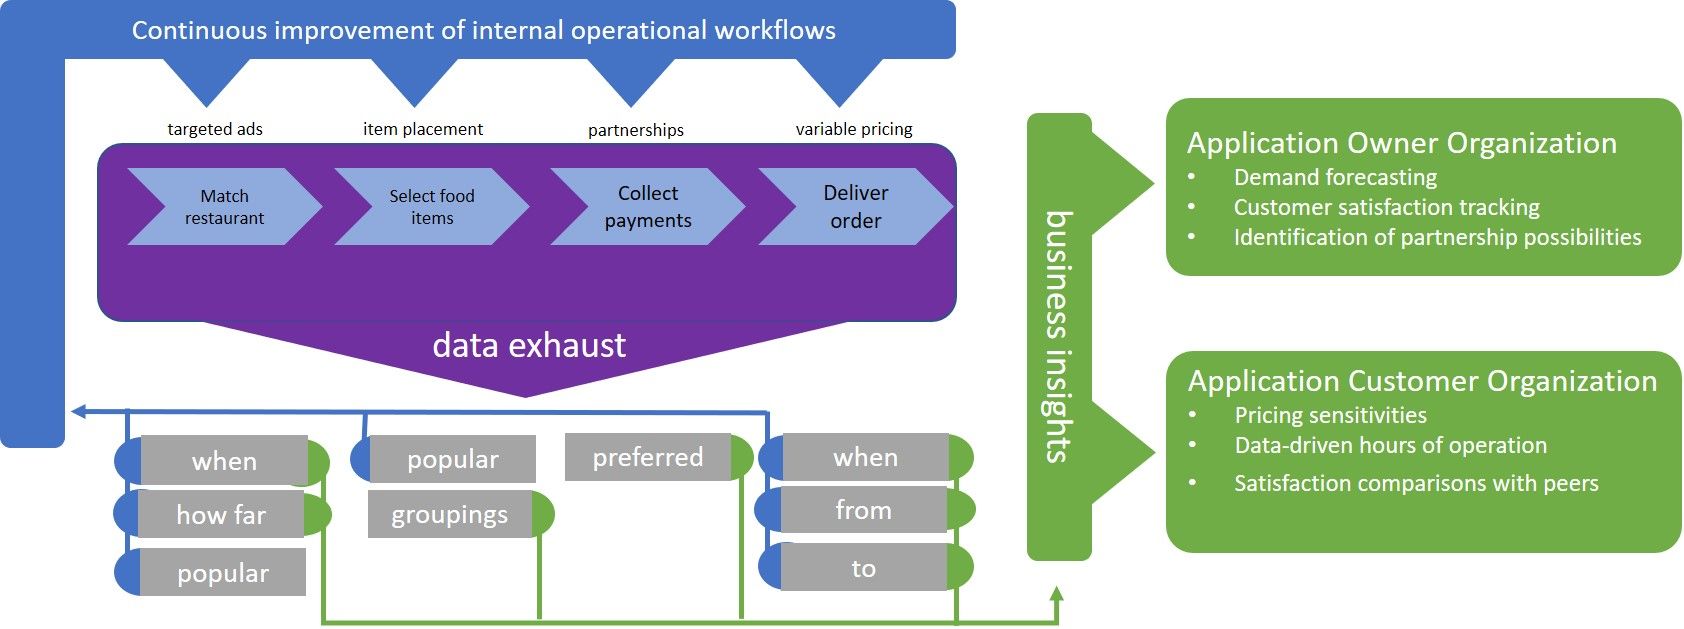
データから別の種類の価値を生み出す方法として、データを活用して「新たな事業領域を切り拓き」、顧客への直接的なメリットを通じて収益化できるビジネス価値を創出することが挙げられます。その一例が、6か月後のシナリオで触れた、供給側のパートナーであるレストランへの価値提供です。アプリケーションの顧客にインサイトを提供するというビジネスニーズに応えるには、アプリケーションの運用ワークフローで収集したデータを再び活用します。今回は、そのデータを、顧客やパートナー向けのビジネスインサイトを抽出するための原材料として使用します。こうしたビジネスインサイトにはさまざまな形があり、たとえば次のようなものがあります。
- 通常より需要が高まることを早期に予測し、パートナーがそれに応じて準備できるようにする。
- 特定のメニュー項目の価格設定に関するインサイトを提供し、需要の価格感応度を把握するとともに、同業他店の価格データと比較できるようにします。
- 営業時間を延長または短縮した場合に予測される収益への影響など、レストランのより戦略的な計画策定に役立つ定量的な情報。
こうしたビジネスインサイトを見いだせるのは、大規模なデータストアが存在するからだけではありません。一貫したメタデータ語彙を用いて、収集したデータに構造化された注釈を付与するデータ戦略があるからです。
具体的なビジネスインサイトの事例として、メニュー価格に関するインサイトをどのように導き出せるかを詳しく見てみましょう。まず、素材となるのは注文ワークフローから運用上収集されたデータです。ここで、メタデータを付与するデータ戦略の価値が明確になります。具体的には、特定のレストランにおける商品の価格だけでなく、関連するメタデータも記録します。たとえば、分量、食品の「種類」(「ソフトドリンク」や「ハンバーガー」など)、特別な「付加要素」(「サイドディッシュ付き」や「スパイシー」など)といった、食品を詳しく説明する追加属性です。データアーキテクチャにより、一貫したメタデータタグの語彙(「分量(オンス)」「食品分類」「付加要素」など)と正規化されたメタデータ値のセットを使用して、これらの属性に関するメタデータを食品データに付与すれば、レストラン間で食品情報を比較できます。たとえば、コードデータベースから分かることが、「Burger Basement」には「Man Cave Burger」があり、「Heart Attack Grill」には「Double Bypass Burger」があるということだけでは、有意義な比較を行う根拠がありません。しかし、メタデータ注釈の語彙を追加すれば、比較や分析が可能になります。両方とも「食品分類」が「ハンバーガー」であるため、システムはこの2つの商品が比較可能だと認識します。さらに、分析では他のメタデータフィールドも使用して分量を正規化できます(たとえば、「Man Cave」は8オンス、「Double Bypass」は12オンスの場合があります)。最後に、「チーズ入り」などの標準化された「付加要素」の値を使用すれば、二次的な類似点や相違点に基づいて追加の調整も行えます。ここでも、データアーキテクチャについて事前に十分検討し、今回はメタデータ戦略を整備したことで、既存のワークフローから副次的に生じるデータを活用するだけで、新たなビジネス機会に迅速に対応できるようになりました。
まとめ
多くのビジネスリーダーは、重要な業務ワークフローを計画し、その実行状況を可視化することが、成功を左右すると強く認識しています。また、優れたビジネスリーダーは、そこから迅速かつ効率的にインサイトを得て、それに基づき社内外に向けた施策を講じる能力が、継続的な成功の鍵であることも理解しています。
テクノロジーに携わる私たちには、業務効率の継続的な向上とビジネスの俊敏性という目標を実現するソリューションの構築が求められています。しかし、エンジニアはソリューションのデータ処理ソフトウェア要素に偏重し、データアーキテクチャ自体には十分な注意を払わない傾向があります。その結果、社内ワークフローの改善や、そこから派生する新たな顧客向けサービスの展開に多大な労力を要し、導入までの期間が長引くことが少なくありません。本記事で示すように、データボキャブラリ、データ表現、メタデータ戦略を含むデータアーキテクチャを事前に十分検討することが、俊敏かつ堅牢なデータドリブンビジネスを支える技術基盤となります。
関連するブログ記事
SOAS 2025:足並みの乱れが凡庸さを招く
AI導入における方針の不一致は、非効率を招きます。セキュリティ、自動化、導入の各戦略を整合させ、AIの可能性を最大限に引き出す方法をご紹介します。
WebAssemblyが重要な理由
WebAssembly(Wasm)は、あらゆるプラットフォームで高性能なアプリケーションを実現する、ポータブルで高速かつセキュアなバイナリ命令セットです。

インフラストラクチャは依然として格好の攻撃経路
クラウドコンピューティングでは、APIやドラッグ&ドロップ式の設定ツールを活用し、ネットワークやインフラストラクチャを敬遠する人がそれらを直接扱わずに済むようにすることで、インフラストラクチャへの対応を不要にすることが長年追求されてきました。しかし、インフラストラクチャを無視することも、攻撃の主要な標的であるという事実を見過ごすこともできません。
堅牢なデータアーキテクチャがもたらす戦略的メリット
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開にもつながり、これらすべてをより俊敏に実行できるようになります。
デジタルワークフローにおける不正検知には、データだけでは不十分
2019年には、業界全体でクレジットカード詐欺の試みが約25万件確認されました。これは約2分に1件の割合です。今日、不正を検知するには、デジタルワークフロー上のできるだけ多くのポイントから収集したデータを相互に関連付け、手作業によるデータ処理をはるかに上回る速度で分析する能力が求められます。