Im Jahr 2022 schlugen wir einen Wandel der Unternehmensarchitektur vor, der damals etwas zukunftsweisend erschien. Das Argument war einfach: Wenn Unternehmen KI-gestützte digitale Geschäftsmodelle betreiben wollten, musste sich ihre Architektur weiterentwickeln. Anwendungen würden weiterhin im Zentrum der Wertschöpfung stehen, doch die sie umgebenden Ebenen mussten sich verändern. Anwendungsverteilung und -bereitstellung, Datenarchitektur und Governance sowie die Infrastruktur würden den operativen Kern bilden. Um diese Ebenen herum wären die Funktionen angesiedelt, die für den Betrieb hochautomatisierter, datengesteuerter Systeme erforderlich sind: Observability und Automatisierung. Sicherheitsarchitektur, Betrieb und Governance würden sich über den gesamten Stack erstrecken, wobei SRE-Praktiken den operativen Kreislauf schließen würden.
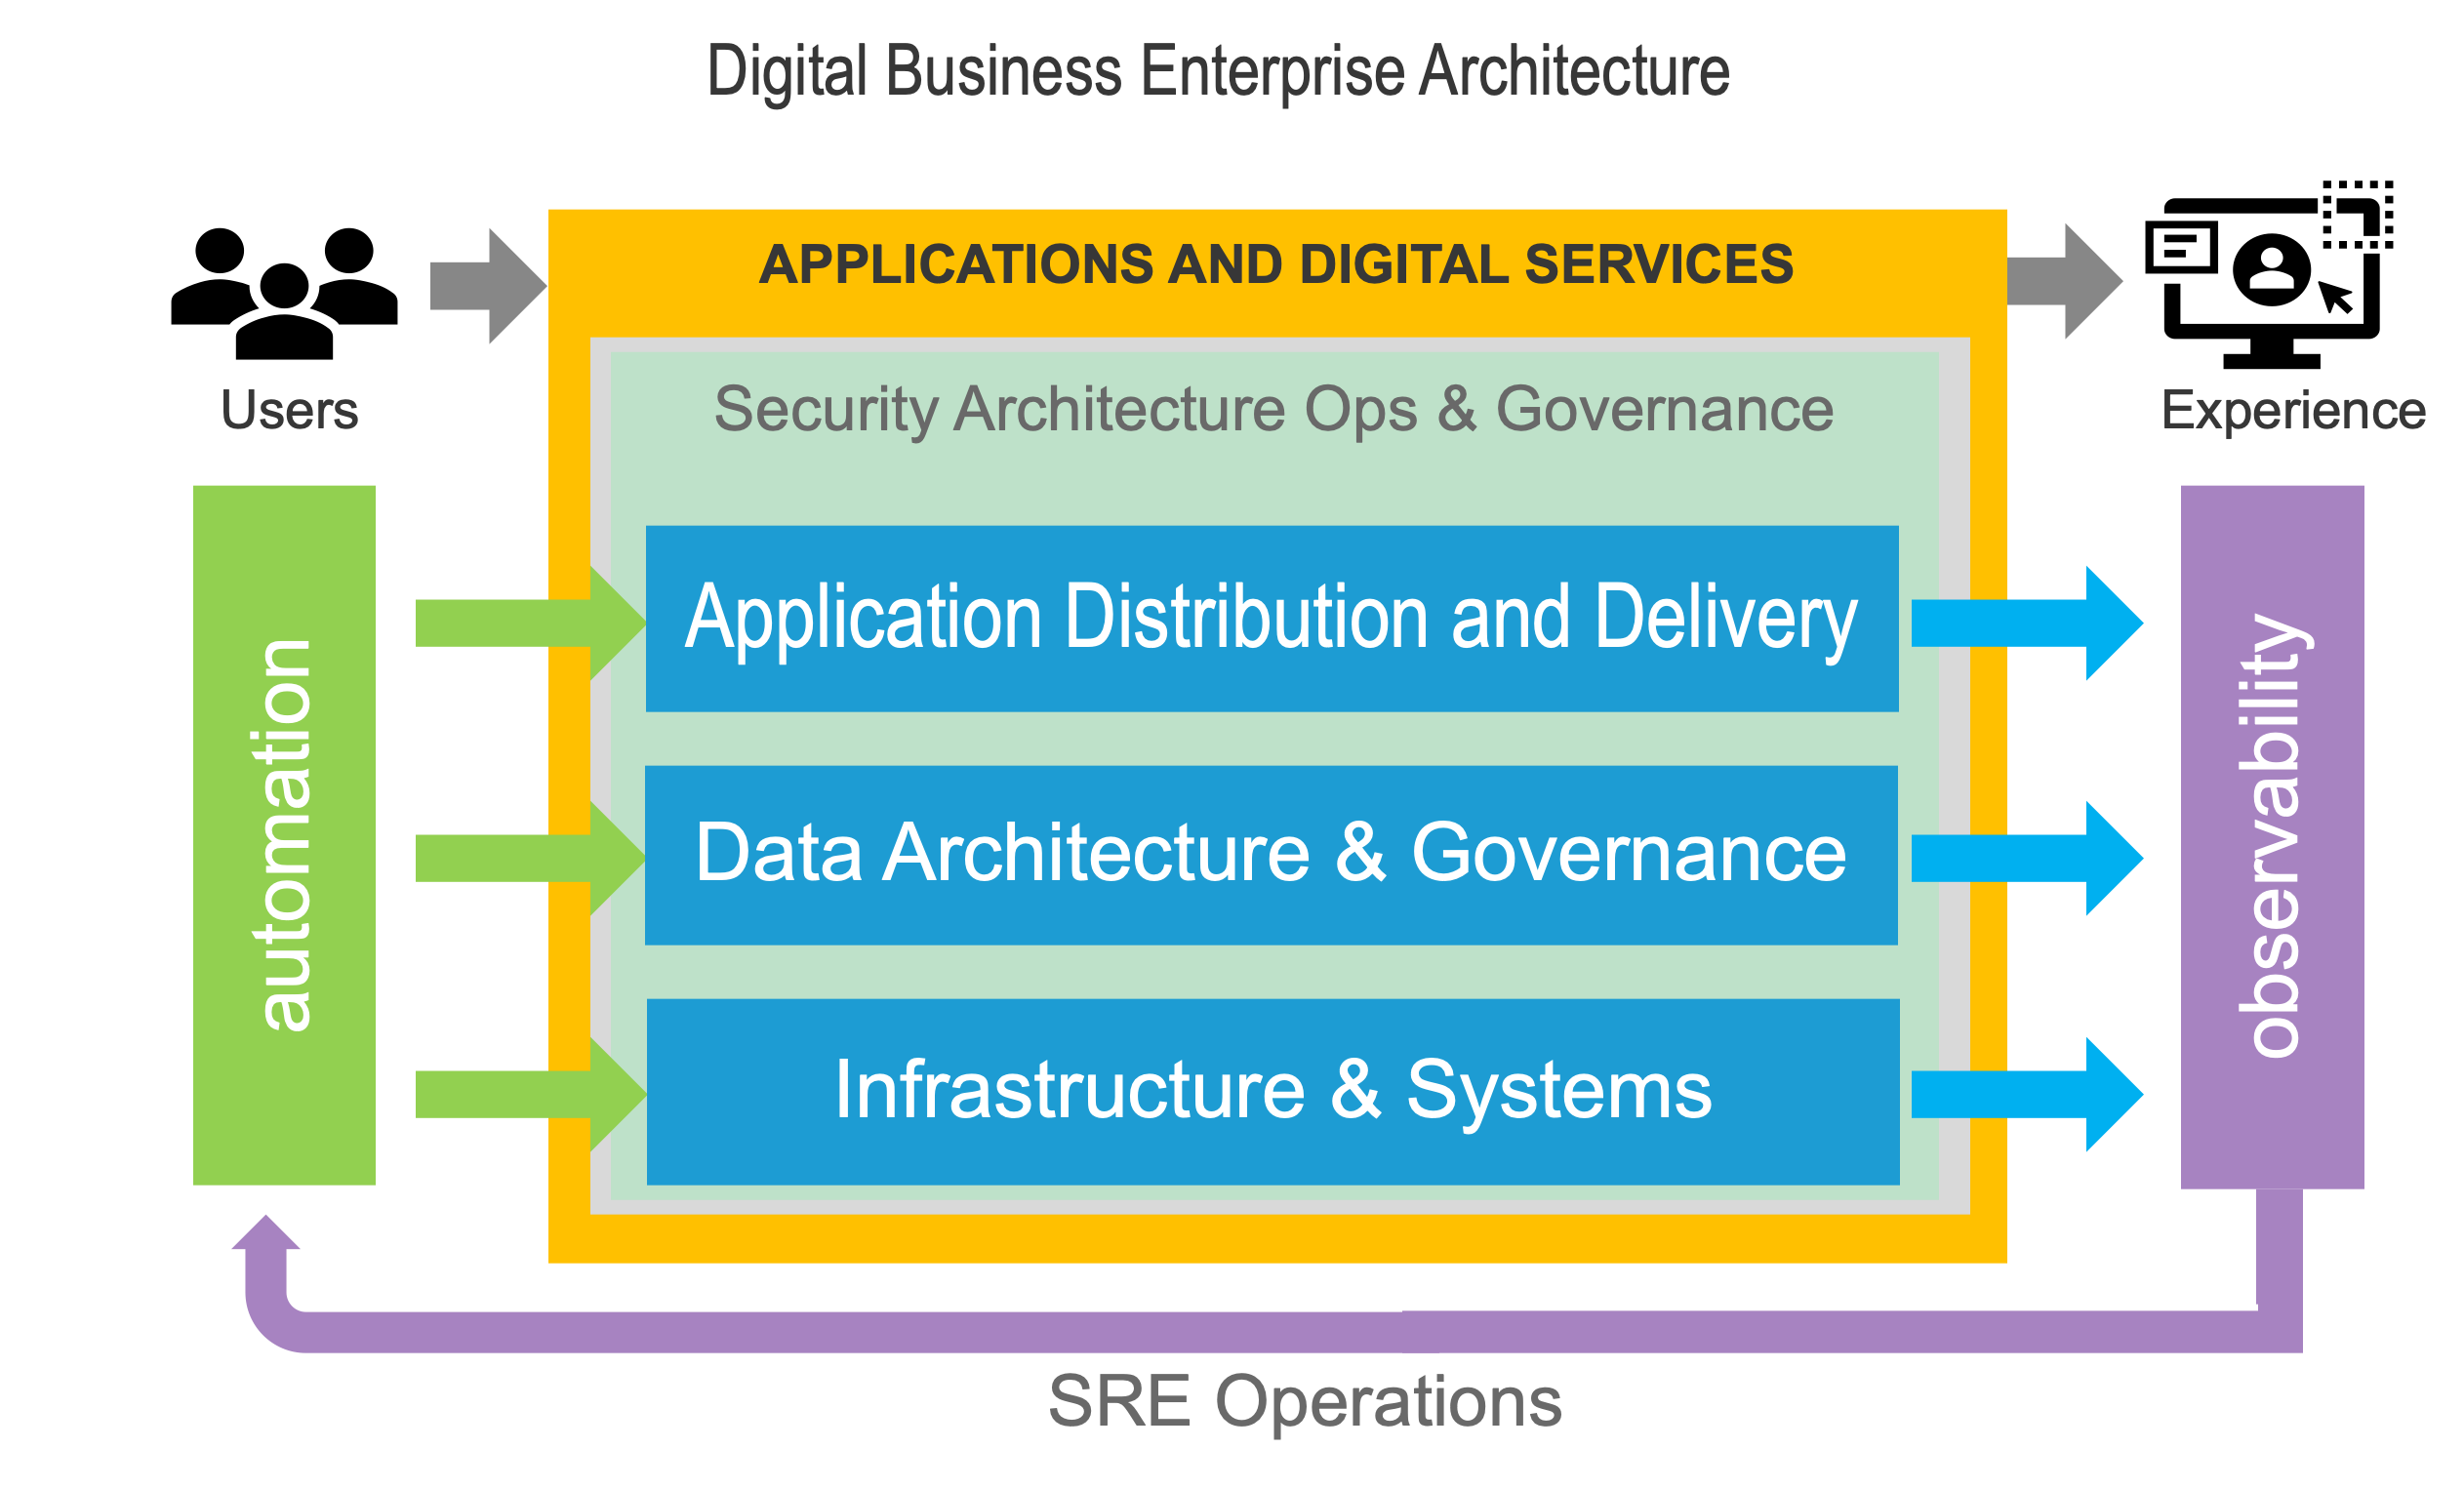
Die diesem Modell zugrunde liegende Annahme war nicht, dass KI wie von Zauberhand überall auftauchen würde. Vielmehr ging man davon aus, dass KI die Veränderungsgeschwindigkeit digitaler Systeme und das Ausmaß der maschinengesteuerten Interaktionen zwischen ihnen erhöhen würde. Observability wäre erforderlich, um zu verstehen, was innerhalb dieser Systeme geschieht, und Automatisierung, um schnell genug reagieren und ihre Stabilität gewährleisten zu können.
Heute wirkt diese Architektur längst nicht mehr so hypothetisch.
Der aktuelle Stand der Unternehmensarchitektur
Unsere neuesten Forschungsergebnisse zeigen, dass etwa drei Viertel der Unternehmen bereits KI-gestützte Anwendungen einsetzen und mehr als 80 % davon ausgehen, dass KI-Funktionen in naher Zukunft in ihr gesamtes Anwendungsportfolio integriert sein werden. KI ist damit faktisch zu einer weiteren Anwendungsabhängigkeit geworden. Modelle werden über APIs aufgerufen, Inferenz-Endpunkte verhalten sich wie Dienste, und Prompts sowie Antworten werden wie Anwendungsdatenverkehr zwischen Komponenten übertragen.
Sobald KI in die Anwendungsebene Einzug hält, wird die Bedeutung der Anwendungsverteilung und -bereitstellung unmittelbar deutlich. Inferenzanfragen müssen weitergeleitet werden. Die Latenz wird zu einem entscheidenden Faktor für die Benutzererfahrung. Modellendpunkte müssen entsprechend der Nachfrage skalierbar sein. Interaktionen zwischen Anwendungen und Modellen müssen überprüft und kontrolliert werden.
Doch der Inferenzdatenverkehr ist nur ein Teil des Gesamtbildes.
Die eigentlichen architektonischen Auswirkungen der KI-Einführung zeigen sich in den operativen Ebenen, die wir bereits vor Jahren hervorgehoben haben: Automatisierung und Observability.
Diese Ebenen führen unweigerlich zu neuen Kategorien des Systemdatenverkehrs.
Zwei neue Kategorien von Systemdatenverkehr
Automatisierungsdatenverkehr besteht aus maschinell erzeugten Aktionen, die mit der Infrastruktur interagieren. Agenten rufen APIs auf. Automatisierungsplattformen aktualisieren Konfigurationen. Entscheidungssysteme lösen Workflows aus. Diese Anfragen werden nicht mehr primär von Menschen initiiert. Sie werden von Systemen erzeugt, die auf Signale und Kontext reagieren.
Unsere Untersuchungen zeigen, dass dieser Wandel bereits im Gange ist. Fast zwei Drittel der Unternehmen geben an, KI zur Beschleunigung der Automatisierung einzusetzen, und mehr als die Hälfte erlaubt KI-Systemen, Richtlinien oder Konfigurationen automatisch anzupassen.
In der Praxis bedeutet dies, dass die Infrastruktur zunehmend durch maschinell getroffene Entscheidungen verändert wird. API-Aufrufe, Konfigurationsänderungen und betriebliche Workflows werden nicht mehr von Bedienern, sondern von Software ausgelöst.
Diese Aktivität ist automatisierter Datenverkehr.
Automatisierungsdatenverkehr verhält sich anders als herkömmliche betriebliche Interaktionen. Er kann mit Maschinengeschwindigkeit und in einem weitaus größeren Umfang als menschliche Aktivitäten auftreten. Daher muss er mit derselben Sorgfalt bereitgestellt und gesteuert werden wie Anwendungsdatenverkehr. Systeme müssen skalierbar sein, um Spitzen automatisierter Aktivitäten bewältigen zu können. Ratenbegrenzungen und Kontingente können erforderlich sein, um eine außer Kontrolle geratene Automatisierung zu verhindern. Identitäts- und Autorisierungskontrollen müssen sicherstellen, dass Agenten ausschließlich innerhalb ihres vorgesehenen Aufgabenbereichs agieren.
Die zweite neu entstehende Datenverkehrsklasse ist der Telemetriedatenverkehr.
Telemetriedatenverkehr umfasst Metriken, Protokolle, Traces und Ereignisse, die durch Observability-Systeme fließen. Im traditionellen IT-Betrieb diente die Telemetrie in erster Linie als Grundlage für menschliche Entscheidungen. Das Betriebspersonal beobachtete das Systemverhalten und entschied, wie darauf zu reagieren war.
KI verändert diesen Kreislauf.
Observability-Signale fließen zunehmend in automatisierte Entscheidungssysteme ein. Telemetriedaten dienen als Grundlage für Modelle, die Anomalien erkennen, Maßnahmen empfehlen oder Workflows zur Fehlerbehebung auslösen. Anstatt das System lediglich zu beschreiben, werden Telemetriedaten zu einer Eingabe für die Systeme, die es steuern.
Dadurch gewinnt der Telemetriedatenverkehr erheblich an Bedeutung. Diese Signale müssen skalierbar sein, um den wachsenden Anforderungen KI-gestützter Analysen gerecht zu werden. Noch wichtiger ist jedoch, dass sie vertrauenswürdig sein müssen. Sind Telemetriedatenströme ungenau oder manipuliert, können die von ihnen abhängigen Automatisierungssysteme falsche oder schädliche Entscheidungen treffen.
Telemetrie-Pipelines benötigen daher eigene Mechanismen zur Gewährleistung einer zuverlässigen Übertragung und Sicherheit. Quellen müssen authentifiziert werden, um die Legitimität der Signale sicherzustellen. Die Pipelines müssen skalierbar sein, um das zunehmende Telemetrievolumen zu bewältigen. Observability-Systeme müssen die Telemetrieinfrastruktur selbst überwachen.
Automatisierungs- und Telemetriedatenverkehr bilden einen Rückkopplungskreislauf. Dieser Kreislauf ist der operative Herzschlag KI-gestützter Umgebungen.
Was das alles bedeutet
Die von uns vor Jahren vorgeschlagene Architektur nahm den Bedarf an Automatisierung und Beobachtbarkeit vorweg, da hochdynamische Systeme beides erfordern. KI hat die Entwicklung hin zu den Bedingungen beschleunigt, die diese Ebenen unverzichtbar machen.
Automatisierung erzeugt Automatisierungsdatenverkehr. Observability erzeugt Telemetriedatenverkehr.
Beide entstehen als natürliche Folge des Betriebs KI-gestützter Systeme in großem Maßstab. Und wie jede andere Form der Systeminteraktion vor ihnen müssen auch diese Datenverkehrsklassen in der Unternehmensarchitektur als vollwertige Bestandteile behandelt werden. Sie müssen zuverlässig übertragen, durch Richtlinien gesteuert, anhand von Identitäten authentifiziert und ebenso abgesichert werden wie jeder andere Anwendungs- oder Systemdatenverkehr innerhalb der Umgebung.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

KI-App-Bereitstellung – Top 10: Nicht optimierte Datenverkehrssteuerung
KI stellt herkömmliche Annahmen zur Datenverkehrssteuerung infrage: Backends sind nicht austauschbar, die Kosten variieren und Agenten verzweigen sich unvorhersehbar – daher muss das Routing Modell, GPU-Zustand und Datenlokalität berücksichtigen.
Top 10 der KI-Anwendungsbereitstellung: Fehlende Fehlertoleranz und Ausfallsicherheit
KI macht klassische Resilienzdefizite deutlich kostspieliger: Der Ausfall einer einzelnen GPU oder Abhängigkeit kann sich durch synchrone Inferenzketten fortpflanzen, wodurch sich Latenzen summieren und die Qualität der Ausgaben sinkt.
Die neue Herausforderung der hybriden Multicloud: Betrieb ohne Plattform für Anwendungsbereitstellung und Sicherheit
Unternehmen kehren On-Premises-Umgebungen nicht den Rücken – sie modernisieren sie. Da ihre Portfolios weiterhin gemischt bleiben, müssen Anwendungsbereitstellung und Sicherheit von umgebungsspezifischen Funktionen auf eine einheitliche Plattform umgestellt werden.
Programmierbarkeit ist der einzige Weg, wie Kontrolle im KI-Maßstab bestehen kann
Erfahren Sie, warum die Programmierbarkeit der Daten- und Steuerungsebene entscheidend ist, um KI-gestützte Systeme zu skalieren und abzusichern und in einer sich schnell verändernden Umgebung die Kontrolle in Echtzeit zu gewährleisten.
Die fünf wichtigsten Technologietrends, die Sie 2026 im Blick behalten sollten
Entdecken Sie die wichtigsten Technologietrends des Jahres 2026, in dem Inferenz die KI dominiert – von Kostenstellen und Edge-Bereitstellung bis hin zu Governance, IaaS und Interaktionsschleifen agentischer KI.

Der Einfluss von Inferenz: APIs, DPUs und Kontextchaos
KI-Inferenz verändert die Infrastruktur grundlegend: Sie vervielfacht APIs, belastet Rechenressourcen und erschwert die Kontextverwaltung. Erfahren Sie, warum eine intelligentere Architektur und Laufzeitrichtlinien unverzichtbar sind.