Bereits 2022 bemerkte ich einen subtilen Wandel in der Anwendungsarchitektur, der sich am Markt in Diskussionen über neue Protokolle und Daten bemerkbar machte. Das war nicht allzu überraschend, denn wie ich damals erwähnte, entstehen historisch gesehen etwa alle fünf Jahre neue Anwendungsarchitekturen, die zunehmend die Märkte für Anwendungsbereitstellung und -sicherheit prägen und etwa fünf Jahre später eine dominierende Stellung einnehmen.
Im Jahr 2023 ging ich davon aus, dass sich dieser Wandel etwa 2025 bemerkbar machen würde. Doch ich konnte weder das Aufkommen generativer KI noch deren rasanten Einfluss auf die Weiterentwicklung dieser Architekturen vorhersehen.
Kurz gesagt: Dieser Wandel vollzieht sich schneller und wird sich drastisch auf – nun ja – alles auswirken.
Doch bevor wir uns ganz in der architektonischen Entwicklung verlieren, sollten wir verstehen, was sie wirklich vorantreibt: Daten.
Verschiedene Arten von Daten
Wenn von „Daten“ die Rede ist, denken viele sofort an Zeilen mit Kunden- und Produktdaten, die irgendwo in einem riesigen relationalen Datenbankmanagementsystem (RDBMS) gespeichert sind. Nun gut, vielleicht nicht alle, aber doch sehr viele. Das liegt daran, dass bei der Datenspeicherung überwiegend auf strukturierte, tabellarische Daten gesetzt wird. Öffnen Sie eine Tabellenkalkulation, dann sehen Sie, was ich meine. Sie basiert auf Zeilen und Spalten, und ein RDBMS unterscheidet sich davon eigentlich gar nicht so sehr.
Man könnte argumentieren, dass es NoSQL- und Schlüssel-Wert-Datenspeicher, Objektspeicher und ähnliche Datenstrukturen gibt und daher Anwendungsarchitekturen nicht auf tabellarischen Daten basieren. Aber seien wir ehrlich: Das tun sie sehr wohl. All diese anderen Arten von Datenspeichern werden genutzt, und zwar aus guten Gründen. Die meisten dieser Gründe waren jedoch für die Anwendung nur von untergeordneter Bedeutung und haben daher die übergeordneten Architekturprinzipien, die den Aufbau von Anwendungen jahrzehntelang bestimmten, nicht wesentlich verändert.
Doch die zunehmende Verteilung von Anwendungen – und hybride Modelle – bringt zahlreiche Anforderungen mit sich. Dazu gehören Observability und Sicherheit, die die Erzeugung von Telemetriedaten erfordern. Die Verteilung macht es notwendig, die Beziehungen zwischen verteilten Datenspeichern nachvollziehen zu können, was zu Wissensgraphen führt. Und generative KI erfordert Möglichkeiten, Modelle zu erweitern und zu trainieren, was zum Einsatz von Embeddings führt, die in Vektordatenbanken gespeichert werden.
Dabei handelt es sich um vier sehr unterschiedliche Arten von Daten, die neue Methoden für ihre Speicherung und ihren Zugriff erfordern. Alle vier entwickeln sich rasch zu „Standardkomponenten“ moderner Anwendungen, insbesondere solcher, die den Einsatz generativer KI erleichtern sollen.
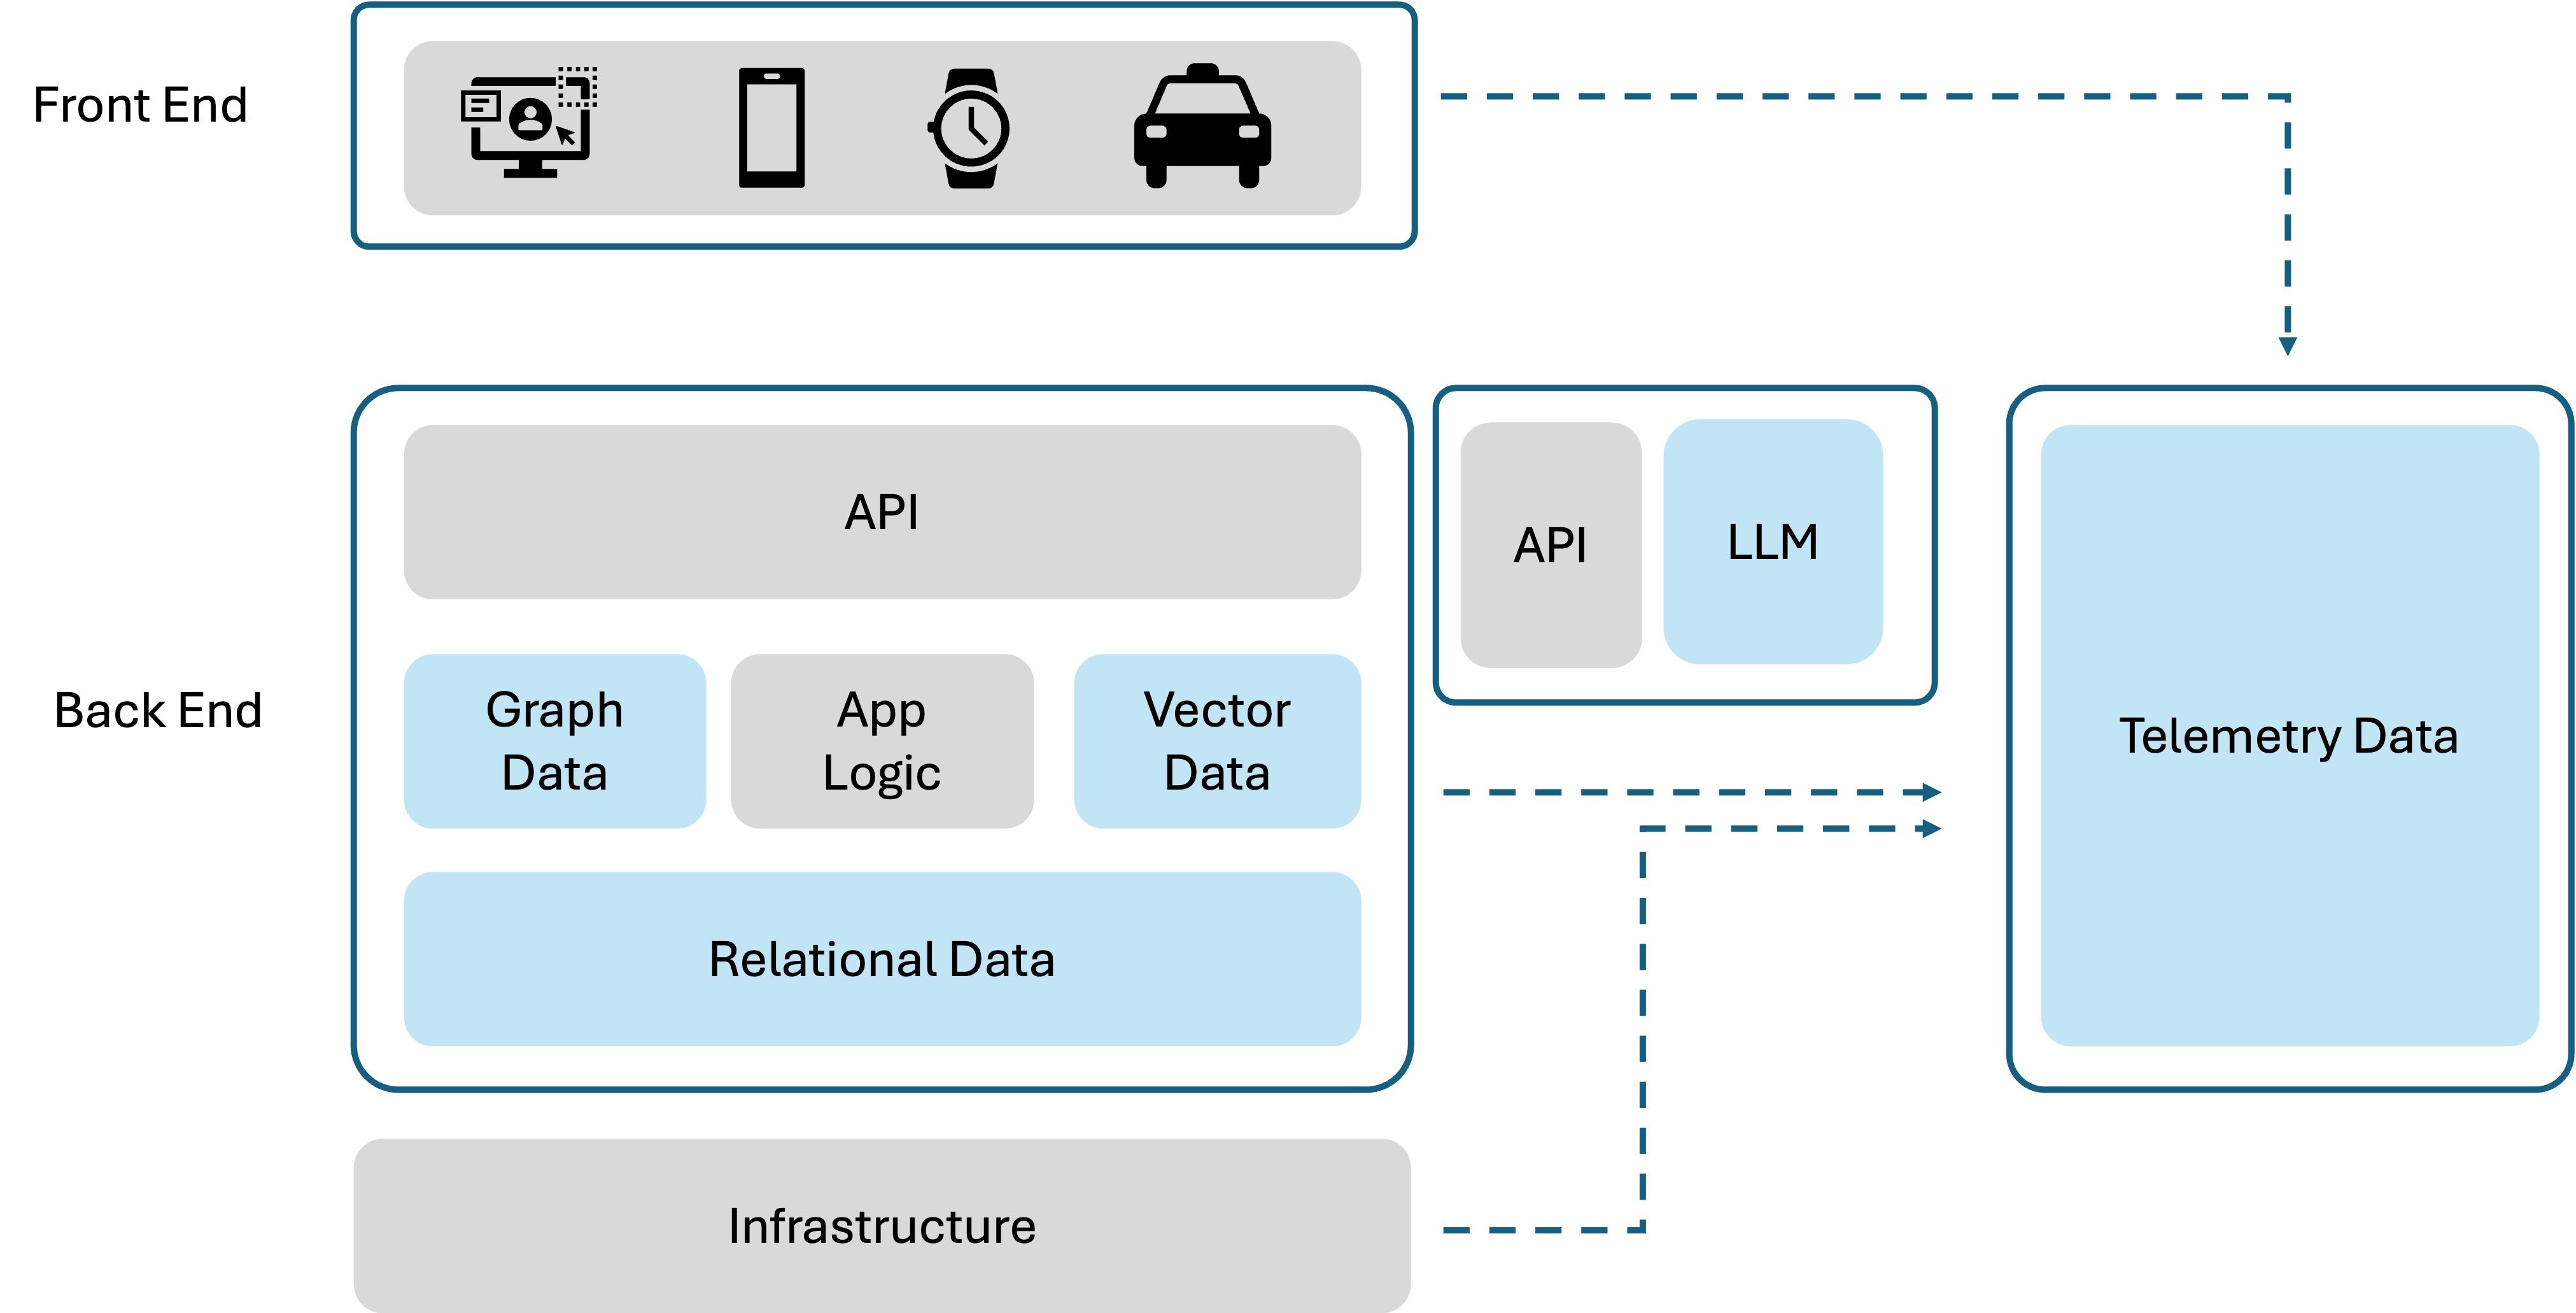
- Telemetrie treibt einen erheblichen Wandel voran im operativen Bereich, da wir zunehmend erkennen, dass spaltenorientierte Formate besser geeignet sind für die Übertragung und Verarbeitung von Echtzeit-Streaming-Daten – und genau darum handelt es sich bei Telemetriedaten.
- Wissensgraphen und Graphtechnologien gewinnen zunehmend an Bedeutung, um verteilte Daten zusammenzuführen und komplexe Beziehungen zwischen verschiedenen Datenquellen zu verstehen. Diese Technologie ermöglicht Protokolle wie GraphQL, die grundlegend verändern, wie wir APIs nutzen, um Daten im gesamten verteilten Unternehmen zu finden und zu verwalten.
- Die zunehmende Verbreitung von Techniken zur abrufgestützten Generierung (Retrieval-Augmented Generation, RAG) für generative KI führt dazu, dass Vektordatenbanken direkt in die Anwendung integriert werden, anstatt als Datenspeicher tiefer in der Architektur angesiedelt zu sein.
- Und schließlich dürfen wir die Daten generativer KI nicht vergessen. Ein LLM erzeugt bei jeder Anfrage neue Daten. Das stellt Sicherheitsexperten vor erhebliche Herausforderungen, denn sie müssen herausfinden, wie sich potenzielle Bedrohungen und Probleme in dynamisch generierten unstrukturierten Daten erkennen lassen.
Es sind die Daten – mit ihren unterschiedlichen Formaten, Protokollen, Verwendungszwecken und Anwendungen –, die diesen Wandel vorantreiben. Das Ergebnis ist ein Headless-Ansatz, der APIs auf eine Weise nutzt, die viele bisher nicht in Betracht gezogen haben. Das heißt, Geschäftsfunktionen und -fähigkeiten werden unabhängig von der herkömmlichen Präsentationsschicht als APIs bereitgestellt. Dadurch lässt sich eine größere Bandbreite an Schnittstellen für eine vielfältigere Auswahl an Endgeräten entwickeln. APIs machen Daten und Funktionen zugänglich, weshalb sie für die digitale Transformation so wichtig sind.
Dieser Ansatz findet sich in vielen modernen Apps, die Microservices nutzen. Das ist der Grund, warum UI-Frameworks so weit verbreitet sind (und im Internet für Diskussionen sorgen). Mit diesen Frameworks werden eigenständige Apps entwickelt, die über APIs auf Funktionen und Daten zugreifen. Sie sind von den Backend-„Anwendungen“, mit denen sie Workflows steuern und einen Mehrwert für den Markt schaffen, getrennte Einheiten.
All dies treibt die Entwicklung hin zu Headless-Architekturen voran. Dieser Wandel war bereits im Gange, doch das Aufkommen generativer KI hat die entscheidende Bedeutung von Daten verdeutlicht und den Wandel beschleunigt.
Dies wiederum wird tiefgreifende Auswirkungen auf die Bereitstellung und Sicherheit von Anwendungen haben, da neue Bedrohungen und Herausforderungen entstehen, die bewältigt werden müssen, um den Anforderungen von Unternehmen und Nutzern gerecht zu werden.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.