Als wir die NGINX Referenzarchitektur für moderne Anwendungen (MARA) auf der Sprint 2.0 im August 2021 vorstellten, kommunizierten wir unsere Designziele von Anfang an klar. Wir wollten ein Beispiel für eine moderne Anwendungsarchitektur schaffen, die in Kubernetes ausgeführt wird und Sicherheit, Skalierbarkeit, Zuverlässigkeit, Monitoring und Introspektion unterstützt. Dieses Projekt sollte sich in verschiedenen Infrastrukturen bereitstellen lassen und einen „Plug-and-Play“-Ansatz für die Kombination funktionaler Komponenten bieten, ohne dass zeitaufwendige Integrationsarbeiten erforderlich sind.
In den Monaten seit der Sprint haben wir unsere Roadmap weiter vorangetrieben. Wie bei jedem Projekt gab es auch bei uns Erfolge und Misserfolge. Unsere Erfolge haben wir in MARA einfließen lassen und zugleich eine stetig wachsende Liste gewonnener Erkenntnisse geführt. Wir hoffen, andere vor denselben Problemen bewahren zu können, indem wir diese dokumentieren und die gewonnenen Erkenntnisse bei der Entwicklung berücksichtigen.
Mit MARA Version 1.0.0 haben wir kürzlich einen Meilenstein erreicht. Diese Version strukturiert das Projektverzeichnis neu und ändert den Prozess zum Erstellen und Entfernen der Umgebung. Wir haben doppelten Code beseitigt, eine Verzeichnisstruktur geschaffen, die sich problemlos um künftige Ergänzungen erweitern lässt, und die Verwaltungsskripte standardisiert. Da diese Version einen wichtigen Punkt in der Geschichte von MARA markiert, möchten wir innehalten, die Community über unsere Fortschritte informieren, einige der aus unserer Sicht wichtigsten Erkenntnisse festhalten und einen Ausblick auf unsere weitere Roadmap geben.
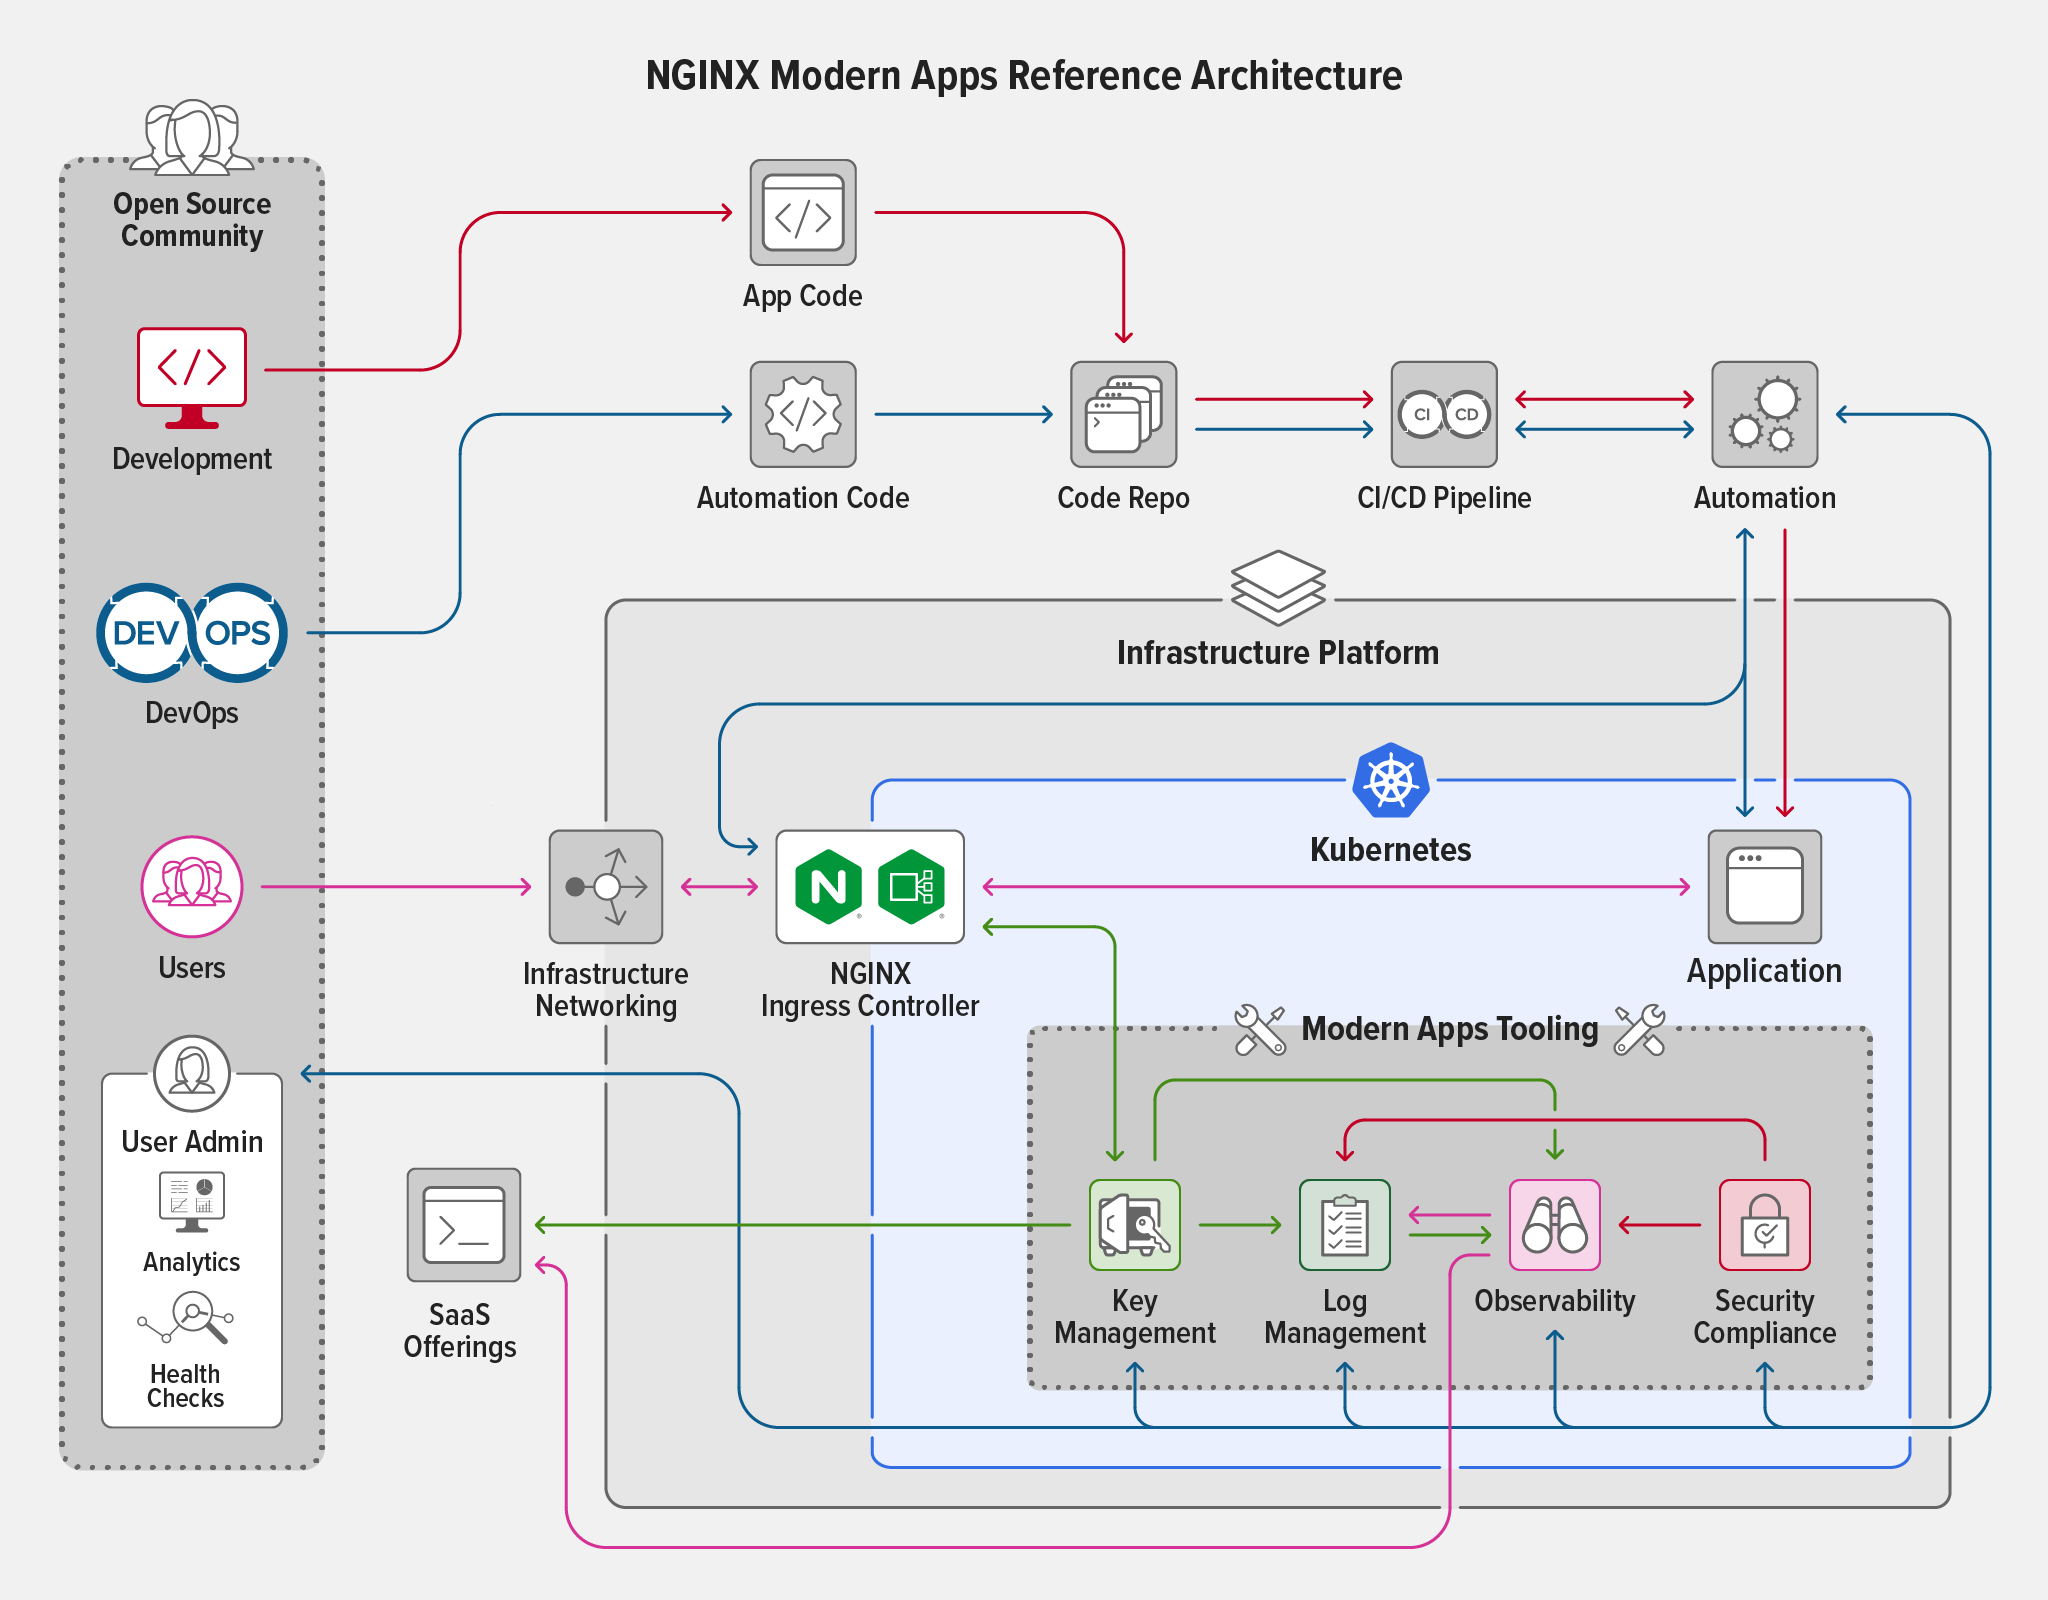
Telemetrie – Metriken, Protokollierung und Tracing
Die Hauptentwickler von MARA verfügen über Erfahrung im Betrieb von Software in großem Maßstab und wissen, worauf es bei der Bereitstellung von Diensten aus betrieblicher, technischer und organisatorischer Sicht ankommt. Sie kennen das mulmige Gefühl, wenn sich eine Anwendung nicht wie erwartet verhält und es keine einfache Möglichkeit gibt, die genaue Ursache des Problems zu ermitteln. Ein in der DevOps-Welt kursierendes Zitat bringt das Problem treffend auf den Punkt: „Das Debuggen von Microservices ist wie das Lösen einer Reihe von Mordfällen.“
Vor diesem Hintergrund haben wir die Einführung von Observability zu einer der obersten Prioritäten auf unserer kurzfristigen Roadmap gemacht. Observability umfasst in diesem Zusammenhang Log-Management, Metriken und Tracing-Daten. Das bloße Erfassen von Daten reicht jedoch nicht aus – Sie müssen die Daten eingehend analysieren und fundierte Entscheidungen darüber treffen können, was in der Umgebung geschieht.
Bei der Prüfung verschiedener Optionen für das Tracing stießen wir auf OpenTelemetry (OTEL), da es das gesamte Spektrum an Telemetriedaten unterstützt, darunter Protokolle, Metriken und Traces. Wir stellten uns eine Implementierung vor, bei der der OTEL-Agent sämtliche Tracing-Daten erfasst, verarbeitet und dedupliziert, bevor er sie zur Aggregation und zum Export an den OTEL-Collector weiterleitet. Am Ende des Workflows sorgt ein Visualisierungssystem dafür, dass die Daten nutzbar werden. Dieser Ansatz bietet Benutzern die größtmögliche Auswahl an Möglichkeiten zur Darstellung und Analyse von Daten und nutzt zugleich den OTEL-Standard, um die vorgelagerten Schritte wie Erfassung und Aggregation zu vereinfachen.
Wir haben die Implementierung in zwei Phasen umgesetzt:
- Stellen Sie den OpenTelemetry Operator for Kubernetes bereit, um einen OTEL-Collector in der Umgebung zu verwalten
- Instrumentieren Sie die Bank of Sirius-Anwendung, damit sie Traces und Metriken ausgibt
Die ursprüngliche Version von MARA verwendete Elasticsearch zusammen mit Filebeat für die Protokollierung. Obwohl wir erwogen, beide durch Grafana Loki zu ersetzen, entschieden wir uns, vorerst bei der ursprünglichen Lösung zu bleiben. Im Hinblick auf die Metriken erkannten wir, dass wir die ursprüngliche, auf Prometheus und Grafana basierende Bereitstellung überarbeiten mussten. Dazu ersetzten wir die anfangs verwendete, eigens erstellte Prometheus-Konfiguration durch das von der Community gepflegte Helm-Chart kube-prometheus-stack, das eine vollständige Prometheus-Umgebung einschließlich Grafana, Node-Exportern sowie einer Reihe vorkonfigurierter Dashboards und Scrape-Ziele bereitstellt, die sich für die Verwaltung einer Kubernetes-Umgebung eignen. Ergänzend fügten wir einige weitere Dashboards für den F5 NGINX Ingress Controller und die Anwendung Bank of Sirius hinzu.
Dies ist nur eine kurze Zusammenfassung des immensen Arbeitsaufwands, der für die Implementierung von OTEL erforderlich war. Um anderen den mühsamen Weg durch dieselbe steile Lernkurve zu ersparen, haben wir den gesamten Prozess in unserem Blogbeitrag „Integration von OpenTelemetry in die Referenzarchitektur für moderne Anwendungen – ein Zwischenbericht“ dokumentiert.
Bereitstellungsoptionen – Kubeconfig
In der ersten Version von MARA entschieden wir uns für Amazon Elastic Kubernetes Service (EKS) als Bereitstellungsumgebung. Seitdem haben uns viele Benutzer mitgeteilt, dass sie MARA aus Kostengründen in „lokalen“ Umgebungen mit geringerem Ressourcenbedarf ausführen möchten, beispielsweise in einem Labor oder auf einer Workstation. Portabilität war ein zentrales Ziel des ursprünglichen Projekts (und ist es nach wie vor). Dies war also unsere Chance zu beweisen, dass wir dieses Ziel erreichen können. Um die Aufgabe zu vereinfachen, beschlossen wir, ein Bereitstellungsverfahren zu entwickeln, das auf jedem Kubernetes-Cluster ausgeführt werden kann, der bestimmte Mindestanforderungen erfüllt.
Als ersten Schritt haben wir MARA um ein neues Pulumi-Projekt erweitert, das eine kubeconfig-Datei einliest, um mit dem Kubernetes-Cluster zu kommunizieren. Dieses Projekt ist zwischen Pulumi-Kubernetes-Projekten und Infrastrukturprojekten angesiedelt (zu Letzteren zählen beispielsweise Projekte für AWS und Digital Ocean). In der Praxis erleichtert die Erstellung des kubeconfig-Projekts die Integration eines neuen Infrastrukturprojekts. Wenn ein Infrastrukturprojekt eine kubeconfig-Datei, einen Clusternamen und einen Clusterkontext an das kubeconfig-Projekt übergeben kann, funktioniert der restliche MARA-Bereitstellungsprozess reibungslos.
Für unsere Tests verwendeten wir mehrere einfach zu installierende Kubernetes-Distributionen mit geringen CPU- und Arbeitsspeicheranforderungen, darunter K3s, Canonical MicroK8s und minikube. Alle Distributionen wurden auf einer virtuellen Maschine (VM) mit Ubuntu 21.10, 2 CPUs und 16 GB RAM bereitgestellt. Darüber hinaus wurden alle Distributionen so konfiguriert, dass sie persistente Volumes und Kubernetes-LoadBalancer unterstützen.
Der schwierigste Teil dieses Prozesses war die Arbeit mit der privaten Registry, die für den eigens entwickelten NGINX Ingress Controller verwendet wird, der Teil des Projekts ist. (Beachten Sie, dass Sie bei der Bereitstellung von MARA neben diesem eigens entwickelten NGINX Ingress Controller auch den standardmäßigen NGINX Ingress Controller auf Basis von NGINX Open Source oder NGINX Plus verwenden können.) Wir stellten fest, dass wir unsere Registry-Logik von Amazon Elastic Container Registry (ECR) entkoppeln und stattdessen einen plattformunabhängigeren Ansatz verfolgen mussten. Diese Aufgabe ist derzeit noch in Arbeit. Außerdem erkannten wir, dass unsere Logik zum Abrufen des Hostnamens der Egress-Adresse sehr spezifisch auf AWS Elastic Load Balancing (ELB) zugeschnitten war und neu geschrieben werden musste, damit sie auch für andere Anwendungsfälle geeignet ist.
Die MARA-Verwaltungsskripte und die Pulumi-Projekte verwenden derzeit eine spezielle Logik, um die oben beschriebenen Probleme zu umgehen. Vorerst müssen Bereitstellungen auf Basis der Kubernetes-Konfiguration den NGINX Ingress Controller (basierend auf NGINX Open Source oder NGINX Plus) aus den offiziellen NGINX-Registrys verwenden.
Wir haben den MARA-Konfigurationsdateien mehrere Optimierungsparameter hinzugefügt, um lokale Bereitstellungen zu unterstützen, die nicht über die für cloudbasierte Bereitstellungen erforderlichen Ressourcen verfügen. Die meisten Parameter beziehen sich auf die Anzahl der angeforderten Replikate für die verschiedenen Komponenten des Elastic Stack. Im weiteren Verlauf der Tests werden zusätzliche Parameter zur Feinabstimmung von MARA auf Grundlage der Ressourcenbeschränkungen der Bereitstellungsumgebung hinzukommen.
Mit diesen Änderungen können wir Bereitstellungen erfolgreich auf K3s, MicroK8s und Minikube durchführen. Außerdem haben wir die Logik erfolgreich auf Azure Kubernetes Service (AKS), Digital Ocean, Google Kubernetes Engine, Linode und Harvester von Rancher getestet. Weitere Informationen finden Sie auf der Seite MARA-Anbieterstatus sowie im Beitrag MARA: Jetzt auch auf Ihrem Arbeitsplatzrechner in unserem Blog.
Zusammenarbeit mit Partnern
Unsere Partner haben unsere Arbeit mit MARA sehr positiv aufgenommen und unterstützt. Viele von ihnen haben sich an uns gewandt, um mehr über das Projekt zu erfahren und zu fragen, wie sie es für ihre Produkte nutzen oder sogar um Funktionen erweitern können.
Wir haben uns für Pulumi als zentralen Bestandteil von MARA entschieden, weil es benutzerfreundlich ist und Python unterstützt. Da Python eine so weitverbreitete Sprache ist, kann der MARA-Code von einer großen Community leicht verstanden werden. Darüber hinaus dienten uns die lebendige Community von Pulumi und ihr Engagement für das Projekt als Vorbild für die Beteiligung der Community, die wir mit MARA erreichen möchten.
Ende 2021 arbeiteten wir mit Sumo Logic zusammen, um MARA in dessen Cloud-Monitoring-Lösung mit dem NGINX Ingress Controller zu integrieren. Dies bot uns die Gelegenheit, unsere Behauptung, MARA sei modular erweiterbar, auf die Probe zu stellen. Die Herausforderung bestand darin, Grafana, Prometheus und Elastic in MARA durch die Lösung von Sumo Logic zu ersetzen. Erfreulicherweise konnten wir die Lösung mit derselben Logik, die wir auch für andere Bereitstellungen verwenden, erfolgreich einrichten und so konfigurieren, dass sie nicht nur eine Verbindung zum SaaS-Angebot von Sumo Logic herstellt, sondern auch Metriken aus unserer Umgebung abruft.
Im Rahmen unserer Arbeit mit OpenTelemetry haben wir mit Lightstep zusammengearbeitet und unseren OTEL-Collector problemlos so umkonfiguriert, dass er Traces und Metriken an das SaaS-Angebot von Lightstep exportiert. Diesen Bereich möchten wir gerne weiter untersuchen, da wir fest davon überzeugt sind, dass OTEL die Zukunft der Observability ist.
Bisher gewonnene Erkenntnisse
Die wichtigste Erkenntnis, die wir bisher gewonnen haben, ist, dass ein modularer Ansatz sinnvoll ist. Die Arbeit mit Sumo Logic zeigt, dass wir MARA-Komponenten erfolgreich flexibel kombinieren können. Wir erwarten eine weitere Bestätigung dafür, wenn wir OTEL umfassender in die Umgebung integrieren. Wie bereits erwähnt, erwägen wir, Elasticsearch als Protokollverwaltungsumgebung durch Grafana Loki zu ersetzen, da sich dadurch der Ressourcenbedarf des Stacks verringert. Dennoch plädieren wir für eine „pragmatische Modularität“, statt ins Extrem zu gehen und alles als Microservice umzusetzen. So ist es beispielsweise sinnvoll, einen spezialisierten Dienst einzusetzen, der Protokolle für viele Anwendungen verarbeiten kann. Weniger einleuchtend ist hingegen, warum für die Erfassung, Speicherung und Visualisierung von Protokollen jeweils separate Microservices erforderlich sein sollten.
Wir haben außerdem festgestellt, dass es hilfreich ist, Standardwerte explizit in der Konfiguration anzugeben, anstatt den entsprechenden Parameter einfach wegzulassen. Dies erleichtert Administratoren die Arbeit in zweierlei Hinsicht: Sie müssen sich die Standardwerte nicht merken und können sie problemlos ändern, indem sie einfach einen Parameter anpassen, der bereits mit der richtigen Syntax an der richtigen Stelle in der Konfiguration steht.
Eine weitere schmerzhafte Lektion, die wir gelernt haben, ist, dass manche Lösungen nicht deshalb beliebt sind, weil sie die besten sind, sondern weil sie sich am einfachsten installieren lassen oder die beste Anleitung bieten. Deshalb ist es so wichtig, die eigenen Annahmen zu hinterfragen und sich während des Entwicklungsprozesses mit Kolleginnen und Kollegen auszutauschen – eine Kultur der offenen Kommunikation trägt wesentlich dazu bei, Probleme frühzeitig zu erkennen und zu beheben.
Allerdings haben wir mehrfach eine Logik implementiert, die zwar funktionierte, uns aber entweder in eine Sackgasse führte oder andere Probleme verursachte. Als wir beispielsweise begannen, Anwendungen über Pulumi bereitzustellen, verwendeten wir YAML-Manifeste für ConfigMaps und nutzten Pulumi-Transformationen, um Variablen zu aktualisieren. Das funktionierte, war jedoch aus mehreren Gründen nicht ideal, insbesondere im Hinblick auf die Wartbarkeit. In der nächsten Iteration verbesserten wir die Lesbarkeit und Wartbarkeit des Codes, indem wir kube2pulumi verwendeten, um die Manifeste in Pulumi-Code umzuwandeln, mit dem wir anschließend die ConfigMaps erstellen konnten.
Eine weitere Lektion begann damit, dass durch einen Merge ungültige Einstellungen in die Deployment-YAML-Datei gelangten. Wir waren gezwungen, große Teile der YAML-Datei neu zu schreiben und sorgfältig zu überprüfen, um sicherzustellen, dass der Code sowohl syntaktisch korrekt war als auch das gewünschte Ergebnis lieferte – ein frustrierender und zeitaufwendiger Prozess. Um künftige Probleme zu vermeiden, haben wir nun automatisierte Prüfungen und Validierungen sowohl für allgemeines YAML als auch ein Kubernetes-spezifisches Linting in den GitHub-Push-Prozess integriert.
Schließlich war es von Anfang an unser Ziel, sicherzustellen, dass unser Mainline-Branch jederzeit lauffähig ist. Es ist frustrierend, wenn man ein neues Projekt auscheckt und zunächst ein Problem beheben muss, das die Maintainer in die Mainline eingebracht haben. Leider ist uns das einige Male nicht gelungen, unter anderem bei diesen Beispielen mit dem Bank-of-Sirius-Submodul:
- Wir haben versehentlich vergessen, das URL-Schema von ssh:// auf https:// umzustellen. Für uns war das kein Problem, da wir alle
sshverwenden, um eine Verbindung zu GitHub herzustellen. Nutzer ohne SSH-Schlüssel für GitHub wurden jedoch mit Fehlermeldungen überhäuft, als sie versuchten, das Submodul zu initialisieren. - Eine Version der Verwaltungsskripte war von einem gängigen Paket abhängig, von dem wir fälschlicherweise annahmen, dass es wie auf unseren Rechnern auch auf den Rechnern aller anderen installiert sei.
- Bei der Überarbeitung der Startlogik haben wir vergessen, eine Prüfung auf die Quelle des Submoduls einzubauen. Das Submodul enthält die für die Bereitstellung von Bank of Sirius erforderlichen Manifeste. Leider waren die Fehler und Warnungen, die beim Fehlen dieser Manifeste ausgegeben wurden, so undurchsichtig, dass wir mehrere Tage lang merkwürdiges Verhalten untersuchten, bevor wir die eigentliche Ursache entdeckten.
Wie geht es weiter?
Wir haben große Pläne für die kommenden Entwicklungsmonate. Dazu gehören die Überarbeitung des Builds des NGINX Ingress Controllers sowie der Logik für Registry-Pushes und Ingress-Hostnamen/IP-Adressen.
Bei jeder Inbetriebnahme von MARA fällt uns auf, wie schnell Scans und Angriffe auf den NGINX Ingress Controller einsetzen. Dies hat uns dazu veranlasst, mit der Integration des NGINX Ingress Controller und der NGINX App Protect WAF in MARA zu beginnen. Damit gehen sowohl die Herausforderung als auch die Chance einher, herauszufinden, wie sich die von App Protect erzeugten Protokolldaten am besten verwalten lassen.
Eine weitere Änderung, die wir in den kommenden Monaten vornehmen möchten, besteht darin, dass alle Module Secrets ausschließlich aus Kubernetes statt sowohl aus Pulumi als auch aus Kubernetes abrufen. Dadurch verwenden alle Module ein gemeinsames Secrets-Repository, und der Administrator kann steuern, wie die Secrets bereitgestellt werden. Wir entwickeln ein neues Modul, das Secrets aus einem vom Benutzer ausgewählten Repository ausliest und die entsprechenden Kubernetes-Secrets erstellt.
MARA enthält derzeit ein Tool zur Lastgenerierung, bei dem es sich um eine aktualisierte und leicht modifizierte Version des auf Locust basierenden Tools handelt, das in der ursprünglichen Bank-of-Anthos-App enthalten ist, aus der wir Bank of Sirius abgespalten haben. Das neue Testtool, das wir derzeit entwickeln, Cicada Swarm, generiert nicht nur Last, sondern erfasst und meldet auch, wenn Metriken von Ihnen festgelegte Schwellenwerte überschreiten. Damit bietet es ein Framework für schnelle Performance-Tests von Softwareprodukten in der Cloud. Es nutzt Parallelisierungstechniken, um Testergebnisse mit dem von Ihnen benötigten Konfidenzniveau, höherer Präzision und anpassbaren Regressionsanalysen zu liefern und so den Erfolg oder Misserfolg von Builds in Ihren CI/CD-Pipelines zu bestimmen.
Abschließend können wir nicht über Lasttests sprechen, ohne darauf einzugehen, wie wir deren Auswirkungen messen wollen – womit wir wieder bei der Telemetrie wären. Wir sind vom Potenzial von OpenTelemetry begeistert und hoffen, bald eine umfassendere Implementierung bereitstellen zu können. Auch ohne eine vollständige Implementierung ist es unser Ziel, einen Test durchführen, seine Auswirkungen messen und anhand der gewonnenen Daten betriebliche Entscheidungen treffen zu können.
Wie immer freuen wir uns über Ihre Pull Requests, Issues und Kommentare. Unser Ziel mit MARA ist es, die Community dazu anzuregen, gemeinsam verschiedene mögliche Lösungen zu diskutieren, auszuprobieren, zu testen und schrittweise weiterzuentwickeln, um besser zu verstehen, wie sich eine moderne Anwendung optimal bereitstellen und verwalten lässt.
Ähnliche Beiträge
Dieser Beitrag ist Teil einer Reihe. Während wir MARA nach und nach um neue Funktionen erweitern, veröffentlichen wir die Details dazu im Blog:
- Eine neue Open-Source-Referenzarchitektur für moderne Anwendungen
- Integration von OpenTelemetry in die Referenzarchitektur für moderne Anwendungen – ein Fortschrittsbericht
- MARA: Jetzt auch auf einer Workstation in Ihrer Nähe
- Ankündigung von Version 1.0.0 der NGINX Modern Apps Reference Architecture (dieser Beitrag)
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.