Variablen für das Application Performance Management verwenden
Variablen sind ein wichtiger und manchmal übersehener Aspekt der NGINX-Konfiguration. Mit etwa 150 Variablen stehen Variablen zur Verfügung, mit denen Sie jeden Teil Ihrer Konfiguration optimieren können. In diesem Blogbeitrag erläutern wir, wie Sie NGINX-Variablen für das Anwendungstracing und das Application Performance Management (APM) einsetzen können. Dabei konzentrieren wir uns darauf, Leistungsengpässe in Ihrer Anwendung aufzudecken. Dieser Beitrag gilt sowohl für NGINX Open Source als auch für NGINX Plus. Der Kürze halber verwenden wir durchgehend die Bezeichnung NGINX Plus, sofern es keinen Unterschied zwischen den beiden Versionen gibt.
Die Umgebung für die Anwendungsbereitstellung
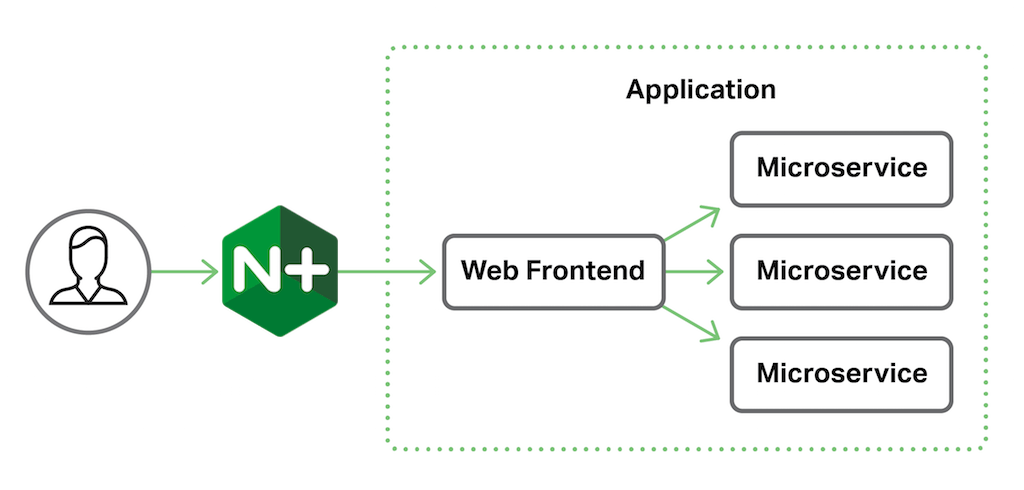
In unserer beispielhaften Umgebung für die Anwendungsbereitstellung fungiert NGINX Plus als Reverse-Proxy für unsere Anwendung. Die Anwendung selbst besteht aus einem Web-Frontend, hinter dem sich mehrere Microservices befinden.
Anfragen durchgängig nachverfolgen
NGINX Plus R10 (und NGINX 1.11.0) führt die Variable $request_id ein. Dabei handelt es sich um eine zufällig generierte Zeichenfolge aus 32 Hexadezimalzeichen, die jeder eingehenden HTTP-Anfrage automatisch zugewiesen wird (zum Beispiel 444535f9378a3dfa1b8604bc9e05a303). Dieser scheinbar einfache Mechanismus bietet ein leistungsstarkes Werkzeug für die Ablaufverfolgung und Fehlerbehebung. Wenn Sie NGINX Plus und alle Backend-Dienste so konfigurieren, dass sie den Wert $request_id weitergeben, können Sie jede Anfrage lückenlos vom Anfang bis zum Ende nachverfolgen. Diese Beispielkonfiguration ist für unseren NGINX Plus-Frontend-Server vorgesehen.
upstream app_server {    server 10.0.0.1:80;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id; # Pass to app server
    }
}
Um NGINX Plus für die Anfrageverfolgung zu konfigurieren, definieren wir zunächst den Netzwerkstandort des Anwendungsservers im upstream-Block. Der Einfachheit halber zeigen wir hier nur einen einzigen Anwendungs-server; normalerweise würden wir jedoch mehrere verwenden, um Hochverfügbarkeit und Lastverteilung zu gewährleisten.
Der server-Block der Anwendung legt fest, wie NGINX Plus eingehende HTTP-Anfragen verarbeitet. Die listen-Direktive weist NGINX Plus an, Port 80 abzuhören – den Standardport für HTTP-Datenverkehr. In einer Produktionskonfiguration sollte jedoch normalerweise SSL/TLS zum Schutz der übertragenen Daten verwendet werden.
Die Direktive „add_header“ sendet den Wert von $request_id als benutzerdefinierten Header in der Antwort an den Client zurück. Dies ist sowohl für Tests als auch für Clientanwendungen nützlich, die eigene Protokolle erstellen, beispielsweise mobile Apps. So lässt sich ein clientseitiger Fehler präzise den Serverprotokollen zuordnen.
Schließlich gilt der location-Block für den gesamten Anwendungsbereich (/), und die proxy_pass-Direktive leitet einfach alle Anfragen per Proxy an den Anwendungsserver weiter. Die proxy_set_header-Direktive ändert die weitergeleitete Anfrage, indem sie einen HTTP-Header hinzufügt, der an die Anwendung übergeben wird. In diesem Fall erstellen wir einen neuen Header namens X-Request-ID und weisen ihm den Wert der Variablen $request_id zu. So erhält unsere Anwendung die von NGINX Plus generierte Anfrage-ID.
Protokollierung von „$request_id“ über die gesamte Verarbeitungskette
Unser Ziel beim Anwendungstracing ist es, im Rahmen des Application Performance Management Leistungsengpässe im Lebenszyklus der Anfrageverarbeitung zu identifizieren. Dazu protokollieren wir wichtige Ereignisse während der Verarbeitung, um sie später auf unerwartete oder unangemessene Verzögerungen analysieren zu können.
NGINX Plus konfigurieren
Zunächst konfigurieren wir den Frontend-Server NGINX Plus so, dass er $request_id in ein benutzerdefiniertes Protokollformat namens trace aufnimmt, das für die Datei access_trace.log verwendet wird.
log_format trace '$remote_addr - $remote_user [$time_local] "$request" '                 '$status $body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id';

upstream app_server {
    server 10.0.0.1;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id;        # Pass to app server
        access_log /var/log/nginx/access_trace.log trace; # Log $request_id
    }
}
Konfigurieren der Backend-Anwendung
Die Request-ID an Ihre Anwendung weiterzugeben, ist zwar schön und gut, hilft aber nicht wirklich bei der Anwendungsverfolgung, solange die Anwendung nichts damit anfängt. In diesem Beispiel verwenden wir eine Python-Anwendung, die von uWSGI verwaltet wird. Passen wir den Einstiegspunkt der Anwendung so an, dass die Request-ID als Protokollierungsvariable erfasst wird.
from uwsgi import set_logvar
def main(environ, start_response):
    set_logvar('requestid', environ['X_REQUEST_ID'])
Anschließend können wir die uWSGI-Konfiguration so anpassen, dass die Anfrage-ID in die Standardprotokolldatei aufgenommen wird.
log-format = %(addr) - %(user) [%(ltime)] "%(method) %(uri) %(proto)" %(status) %(size) "%(referer)" "%(uagent)" %(requestid)Mit dieser Konfiguration erstellen wir nun Protokolldateien, die systemübergreifend einer einzelnen Anfrage zugeordnet werden können.
Protokolleintrag von NGINX:
172.17.0.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.1" 200 90 "-" "-" "-" 5f222ae5938482c32a822dbf15e19f0fProtokolleintrag der Anwendung:
192.168.91.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.0" 200 123 "-" "-" 5f222ae5938482c32a822dbf15e19f0fDurch den Abgleich von Transaktionen mit den Anforderungs-ID-Feldern können wir mithilfe von Tools wie Splunk und Kibana Leistungsengpässe in Ihrem Anwendungsserver identifizieren. Beispielsweise können wir nach Anfragen suchen, deren Verarbeitung länger als zwei Sekunden gedauert hat. Die standardmäßige Zeitauflösung von einer Sekunde bei regulären Zeitstempeln reicht jedoch für die meisten praxisnahen Analysen nicht aus.
Hochpräzise Zeitmessung
Um Anfragen durchgängig präzise messen zu können, benötigen wir Zeitstempel mit einer Genauigkeit im Millisekundenbereich. Indem wir die Variable $msec in die Protokolleinträge aufnehmen, erhalten wir für den Zeitstempel jedes Eintrags eine Auflösung im Millisekundenbereich. Durch das Hinzufügen von Millisekunden-Zeitstempeln zu unserem Anwendungsprotokoll können wir nach Anfragen suchen, deren Verarbeitung länger als 200 Millisekunden statt 2 Sekunden gedauert hat.
Aber selbst dann erhalten wir noch kein vollständiges Bild, da NGINX Plus den Zeitstempel $msec erst am Ende der Verarbeitung jeder Anfrage schreibt. Glücklicherweise gibt es mehrere weitere Zeitmessungsvariablen von NGINX Plus mit Millisekundengenauigkeit, die uns einen besseren Einblick in die Verarbeitung selbst geben:
$request_time– Gesamte Anfragezeit, beginnend mit dem Lesen des ersten Bytes vom Client durch NGINX Plus und endend mit dem Senden des letzten Bytes des Antworttexts durch NGINX Plus$upstream_connect_time– Zeit, die für den Verbindungsaufbau zum Upstream-Server benötigt wird$upstream_header_time– Zeit zwischen dem Herstellen einer Verbindung zum Upstream-Server und dem Empfang des ersten Bytes des Antwort-Headers$upstream_response_time– Zeit zwischen dem Herstellen einer Verbindung zum Upstream-Server und dem Empfang des letzten Bytes des Antworttexts
Ausführliche Informationen zu diesen Zeitvariablen finden Sie unter „NGINX-Protokollierung zur Überwachung der Anwendungsleistung verwenden“.
Erweitern wir unsere log_format-Direktive, um all diese hochpräzisen Zeitmessungsvariablen in unser trace-Protokollformat aufzunehmen.
log_format trace '$remote_addr - $remote_user [$time_local] "$request" $status '                 '$body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id $msec $request_time '
                 '$upstream_connect_time $upstream_header_time $upstream_response_time';
Mit unserem bevorzugten Tool zur Protokollanalyse können wir Variablenwerte extrahieren und anhand der folgenden Berechnung ermitteln, wie lange NGINX Plus für die Verarbeitung der Anfrage benötigte, bevor die Verbindung zum Anwendungsserver hergestellt wurde:
NGINX Plus processing time = $request_time - $upstream_connect_time - $upstream_response_timeWir können auch nach den höchsten Werten für „$upstream_response_time“ suchen, um festzustellen, ob sie bestimmten URIs oder Upstream-Servern zugeordnet sind. Diese können dann mit Anwendungsprotokolleinträgen abgeglichen werden, die dieselbe Anfrage-ID aufweisen.
Fazit
Durch die Verwendung der neuen Variable „$request_id“ und einiger oder aller Variablen mit Millisekundengenauigkeit erhalten Sie wertvolle Einblicke in die Leistungsengpässe Ihrer Anwendung und können so das Anwendungsleistungsmanagement verbessern, ohne auf ressourcenintensive Agents und Plug-ins zurückgreifen zu müssen.
Testen Sie das Anwendungstracing mit NGINX Plus selbst: Starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.