Redaktion – Dieser Beitrag ist Teil einer 10-teiligen Serie:
- Komplexität reduzieren mit Kubernetes für den Produktionseinsatz
- So verbessern Sie die Ausfallsicherheit in Kubernetes mit erweitertem Traffic-Management
- So verbessern Sie die Transparenz in Kubernetes (dieser Beitrag)
- Sechs Möglichkeiten, Kubernetes mit Tools zur Traffic-Verwaltung abzusichern
- Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
- Leitfaden zur Auswahl eines Ingress-Controllers, Teil 2: Risiken und Zukunftssicherheit
- Leitfaden zur Auswahl eines Ingress-Controllers, Teil 3: Open Source vs. Standard vs. kommerzielle Lösungen
- Leitfaden zur Auswahl eines Ingress-Controllers, Teil 4: Optionen für den NGINX Ingress Controller
- So wählen Sie ein Service Mesh aus
- Performance-Tests von NGINX Ingress Controllern in einer dynamischen Kubernetes-Cloud-Umgebung
Sie können die gesamte Blogreihe auch als kostenloses E-Book herunterladen – Kubernetes von der Testumgebung in den Produktivbetrieb bringen.
Der Einsatz von Microservices beschleunigt digitale Erlebnisse, doch Microservices-Architekturen können diese Erlebnisse auch störanfälliger machen. Während Ihre Entwickler mit Hochdruck daran arbeiten, neue Anwendungen bereitzustellen, erhöht Ihre Architektur möglicherweise das Risiko von Ausfällen und Sicherheitslücken sowie den Zeitaufwand für ineffiziente Fehlersuche oder die Behebung vermeidbarer Probleme. In diesem zweiten Beitrag unserer Blogreihe zu Kubernetes für den Produktivbetrieb untersuchen wir, wie Komponenten, die Einblick in den Datenverkehr bieten, die Komplexität reduzieren und die Sicherheit in Ihren Microservices-Umgebungen verbessern können.
Transparenz schaffen, um Erkenntnisse zu gewinnen
Sehen wir uns zunächst ein paar Definitionen an:
- Sichtbarkeit – Der Zustand, sehen zu können oder gesehen zu werden
- Einblick – Ein tiefes Verständnis einer Person oder Sache
In einer 2020 durchgeführten Umfrage von StackRox bezeichneten 75 % der Kubernetes-Nutzer Transparenz als unverzichtbare Funktion. Auch wir halten Transparenz in Kubernetes für entscheidend, da es besonders schwierig sein kann, den Überblick darüber zu behalten, was bereitgestellt ist. Dennoch gaben 95 % der Befragten im F5-Bericht 2021 zum Thema Stand der Anwendungsstrategie (SOAS) an, dass sie zwar über eine Fülle von Daten verfügen, ihnen jedoch die Erkenntnisse zu Anwendungsleistung, Sicherheit und Verfügbarkeit fehlen, die sie benötigen, um ihre Infrastruktur und ihr Unternehmen zu schützen und weiterzuentwickeln. Warum sind solche Erkenntnisse also wichtig und wie gewinnt man sie?
Mit fundierten Erkenntnissen können Sie:
- Stärken Sie Sicherheit und Compliance, indem Sie Schwachstellen und mögliche Angriffsvektoren erkennen.
- Reduzieren Sie Ausfälle und Ausfallzeiten, indem Sie Probleme erkennen, bevor Ihre Kunden es tun.
- Steigern Sie die Effizienz der Fehlerbehebung, indem Sie die Ursache von App-Problemen ermitteln
- Stellen Sie sicher, dass Ihr Datenverkehr nur dorthin gelangt, wo Sie ihn haben möchten.
- Erfahren Sie genau, was in Ihren Kubernetes-Umgebungen läuft und ob es ordnungsgemäß konfiguriert und abgesichert ist
- Finden Sie anhand bisheriger Latenz- und Leistungsdaten heraus, ob Sie die richtige Menge an Ressourcen nutzen
- Saisonalen Bedarf anhand bisheriger Traffic-Muster prognostizieren
- Messen Sie die Leistung anhand der Antwortzeit, um die Einhaltung von Service-Level-Agreements (SLAs) zu überwachen und Probleme frühzeitig zu erkennen, bevor sie die Benutzererfahrung beeinträchtigen.
Um fundierte Einblicke zu gewinnen, benötigen Sie zwei Arten von Daten: Echtzeitdaten und historische Daten. Mit Echtzeitdaten können Sie die Ursache eines aktuell auftretenden Problems ermitteln, während historische Daten dabei helfen, zwischen „normalem“ Verhalten und Ausreißern zu unterscheiden. Zusammen können diese beiden Datenquellen entscheidende Einblicke in die Performance von Anwendungen und Kubernetes liefern.
Wie bei anderen Technologieinvestitionen benötigen Sie auch hier eine Strategie, um die Vorteile nutzen zu können. Der SOAS-Bericht zeigt zudem, dass wertvolle Erkenntnisse aufgrund organisatorischer Faktoren ausbleiben. Dazu zählen Aspekte der Personalgewinnung und -entwicklung, der Strategie und der Prozesse sowie die fehlende Einigkeit darüber, wofür, wann und von wem die Daten genutzt werden sollen. Zu den Ergebnissen gehören:
- Entsprechende Kompetenzen – Es ist kein Geheimnis, dass es an qualifizierten IT-Fachkräften mangelt. Das bestätigen auch 47 % der Befragten, die angeben, Schwierigkeiten zu haben, die benötigten Fachkräfte zu finden.
- Initiativen zum Datenaustausch – Nur 12 % der Befragten verfügen über Prozesse und Strategien, um Daten an die Entscheidungsträger im Unternehmen zurückzumelden und sie so auf die geschäftlichen Auswirkungen resilienter Technologie (oder deren Fehlen) aufmerksam zu machen.
- Der Zweck von Transparenz – Die meisten Befragten nutzen Telemetrie reaktiv (also zur Fehlerbehebung), während nur 24 % der Befragten Daten und Erkenntnisse proaktiv nutzen, um potenzielle Leistungseinbußen frühzeitig zu erkennen, und 16 %, um die Einhaltung von SLAs zu überwachen.
Im weiteren Verlauf dieses Beitrags konzentrieren wir uns auf die technischen Aspekte der Erkenntnisgewinnung. Halten Sie Ausschau nach weiteren Blogbeiträgen zu Strategie, Prozessen und anderen Themen.
Wie NGINX helfen kann
Wir wissen, dass bei den meisten Kubernetes-Bereitstellungen bereits ein Monitoring-Tool im Einsatz ist und kein weiteres benötigt wird. Deshalb haben wir die NGINX Plus API so instrumentiert, dass sich Metriken einfach exportieren lassen, und bieten Integrationen mit beliebten Tools wie OpenTracing und Grafana und Prometheus, damit Sie sich ein umfassendes Bild von der Performance innerhalb Ihrer Cluster machen können. Detaillierte Traces liefern Ihnen gezielte Einblicke in die Performance und Verfügbarkeit Ihrer Anwendungen, sodass Sie nachvollziehen können, wie Anfragen über Ihre Microservices-Anwendungen hinweg verarbeitet werden.
- Einblicke in den eingehenden und ausgehenden Datenverkehr (Nord-Süd)
NGINX Ingress Controller bietet Einblicke in den Datenverkehr, der in Ihre Kubernetes-Cluster ein- und aus ihnen austritt. Wussten Sie, dass es drei beliebte Ingress-Controller auf NGINX-Basis gibt? Nicht alle sind für den Produktionseinsatz geeignet, und die falsche Wahl könnte Ihre Microservices-Strategie eher verkomplizieren als verbessern. Unser Blogbeitrag Moment mal, welchen NGINX Ingress Controller für Kubernetes verwende ich eigentlich? vergleicht die verfügbaren Optionen, damit Sie die beste Entscheidung für Ihre Anforderungen treffen können. - Einblick in den Ost-West-Datenverkehr
NGINX Service Mesh bietet Einblick in den Datenverkehr zwischen containerisierten Anwendungen.
Lesen Sie weiter und erfahren Sie, wie wir Ihnen bei zwei häufigen Problemen helfen können:
- Meine App ist langsam (oder ausgefallen!)
- Meinem Cluster oder meiner Plattform gehen die Ressourcen aus
Wenn Sie die Technologie in Aktion erleben möchten, schauen Sie sich diese Livestream-Demo mit AMA-Runde mit Experten von NGINX und Grafana an. Darin zeigen sie, wie Sie wichtige Lastverteilungs- und Leistungsmetriken in Echtzeit überwachen, die Metriken nach Prometheus exportieren und Grafana-Dashboards erstellen, um einen Überblick über die Gesamtleistung zu erhalten.
Problem: Meine App ist langsam (oder ausgefallen!)
Vermuten Sie einen DDoS-Angriff? Melden Nutzer Fehler auf Ihrer Website? Sie können das Problem erst angehen, wenn Sie genau herausgefunden haben, wo es liegt.
- Live-Monitoring mit NGINX Ingress Controller
Mit NGINX Plus zeigt das Dashboard zur Überwachung der Live-Aktivität, das auf der NGINX Plus API basiert, Hunderte wichtiger Last- und Leistungskennzahlen an. Sie erhalten detaillierte Einblicke bis auf die Ebene einzelner Pods, sodass Sie schnell und einfach die Antwortzeiten von Anwendungen messen und die Ursache eines Problems ermitteln können. Wenn Ihre Kubernetes-Umgebung wächst, erhalten Sie automatisch Dashboards für jede zusätzliche NGINX Ingress Controller-Instanz. Beispielsweise geben Ihnen zwei Spalten auf der Registerkarte HTTP Upstreams einen sofortigen Überblick über den Status von Anwendungen und Infrastruktur: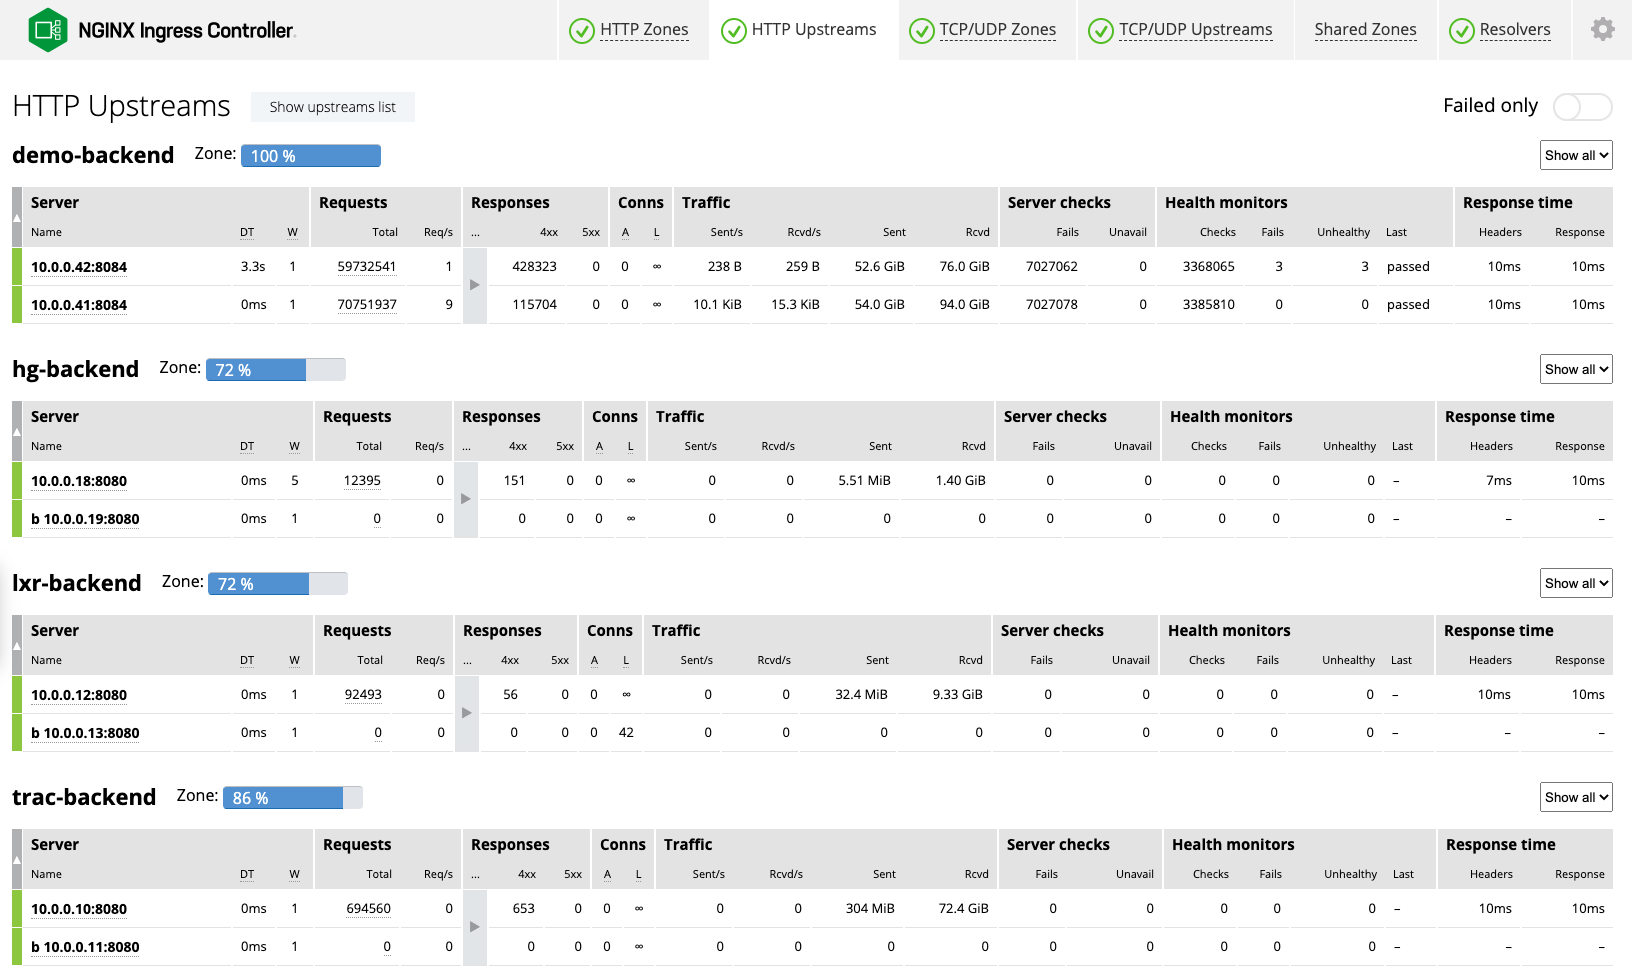
- Anfragen – Wenn die Anzahl der Anfragen pro Sekunde (Req/s) unter den für die jeweilige Anwendung üblichen Wert fällt (z. B. 5 Anfragen pro Sekunde statt der üblichen 40), ist möglicherweise der Ingress Controller oder die Anwendung falsch konfiguriert.
- Antwortzeit – Bei Antwortzeiten von 10 Millisekunden (ms) oder weniger ist alles im grünen Bereich. Eine Latenz von mehr als 30–40 ms deutet auf Probleme mit Ihren Upstream-Anwendungen hin.
- Stub-Status für NGINX Ingress Controller
Mit NGINX Open Source umfasst NGINX Ingress Controller eine Statusseite, die acht grundlegende Metriken anzeigt. - OpenTracing mit NGINX Service Mesh
NGINX Service Mesh unterstützt OpenTracing mit dem NGINX OpenTracing-Modul. Zum Zeitpunkt der Erstellung dieses Textes unterstützt das Modul Datadog, LightStep, Jaeger und Zipkin.
Problem: Meinem Cluster oder meiner Plattform gehen die Ressourcen aus
Treten HTTP-Fehler auf? 503- und 40x-Fehler weisen auf ein Problem mit deinen Ressourcen hin, während 502-Fehler bedeuten, dass eine Konfigurationsänderung nicht funktioniert hat. Nutze historische Daten, um herauszufinden, wo deine Ressourcen möglicherweise knapp werden.
- Protokollierung mit dem NGINX Ingress Controller
Der erste Schritt bei der Diagnose von Netzwerkproblemen besteht darin, die Protokolle des NGINX Ingress Controllers zu prüfen. Dort ist jeder Protokolleintrag mit dem jeweiligen Kubernetes-Service versehen. Fehlereinträge geben den zugehörigen Service an. Die Protokolle enthalten detaillierte Informationen zum gesamten Datenverkehr, der den Ingress Controller durchlaufen hat, einschließlich Zeitstempel, Quell-IP-Adresse und Antwortstatuscode. Sie können Protokolle auch in gängige Aggregationstools wie Datadog, Grafana und Splunk exportieren. - Prometheus-Metriken
Eine der beliebtesten Funktionen des NGINX Ingress Controllers ist seine stetig wachsende Liste von Prometheus-Metriken, die unter anderem die Netzwerkleistung und den Datenverkehr des Ingress Controllers erfassen. Mit NGINX Plus lassen sich über den NGINX Ingress Controller Metriken exportieren zu Verbindungen, Caching, HTTP- und TCP/UDP-Datenverkehr, der von Gruppen von NGINX-Worker-Prozessen verarbeitet wird, die Daten in einer gemeinsamen Speicherzone austauschen, HTTP- und TCP/UDP-Datenverkehr, der von Gruppen von Backend-Servern verarbeitet wird, und vielem mehr. NGINX Service Mesh stellt einen Prometheus-Server bereit, der die NGINX Plus API nutzt, um Metriken von NGINX Service Mesh-Sidecars und NGINX Ingress Controller-Pods abzurufen. Wenn Sie lieber eine vorhandene Prometheus-Bereitstellung verwenden möchten, stellen wir auch Scrape-Konfigurationen bereit, die Sie Ihrer Prometheus-Konfigurationsdatei hinzufügen können. - Grafana-Dashboards
Wir stellen offizielle Grafana-Dashboards für NGINX Ingress Controller und NGINX Service Mesh bereit, die die vom Prometheus Exporter bereitgestellten Metriken visualisieren. Benutzer schätzen den hohen Detailgrad der Daten, der unter anderem Details bis auf die Millisekunde, überlagerte Tagesvergleiche und Lastspitzen umfasst. Beispielsweise kann das NGINX Service Mesh-Dashboard anzeigen, dass Ihre Pods ihre Kapazitätsgrenze erreicht haben, indem es das Datenverkehrsvolumen für einzelne Dienste oder Pods sowie die Anzahl der überwachten aktiven Pods darstellt.
Mit NGINX bereit für den Produktionseinsatz
Der produktionsreife NGINX Ingress Controller (basierend auf NGINX Plus) ist als kostenlose 30-Tage-Testversion verfügbar, die NGINX App Protect zum Schutz Ihrer containerisierten Anwendungen enthält. Das dauerhaft kostenlose NGINX Service Mesh steht zum Download auf f5.com bereit.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.
Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.
Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.