Redaktion – Dieser Beitrag ist Teil einer zehnteiligen Serie:
- Komplexität mit produktionsreifem Kubernetes reduzieren
- So verbessern Sie die Ausfallsicherheit in Kubernetes mit erweitertem Traffic-Management (dieser Beitrag)
- So verbessern Sie die Transparenz in Kubernetes
- Sechs Möglichkeiten, Kubernetes mithilfe von Traffic-Management-Tools abzusichern
- Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
- Leitfaden zur Auswahl eines Ingress-Controllers, Teil 2: Risiken und Zukunftssicherheit
- Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 3: Open Source vs. Standardlösung vs. kommerzielle Lösung
- Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 4: Optionen für den NGINX Ingress Controller
- So wählen Sie ein Service Mesh aus
- Leistungstests von NGINX Ingress Controllern in einer dynamischen Kubernetes-Cloud-Umgebung
Sie können die vollständige Blogreihe auch als kostenloses E-Book herunterladen – „Kubernetes von der Testumgebung in die Produktion überführen“.
Es lässt sich sehr leicht erkennen, ob ein Unternehmen moderne Technologien für die Anwendungsentwicklung nicht erfolgreich einsetzt: Seine Kunden beschweren sich dann schnell in den sozialen Medien. Sie beschweren sich, wenn sie die neueste Serie mit Suchtpotenzial nicht streamen können. Oder keinen Zugriff auf das Onlinebanking haben. Oder keinen Einkauf abschließen können, weil der Warenkorb eine Zeitüberschreitung meldet.
Auch wenn sich Kunden nicht öffentlich beschweren, bedeutet das nicht, dass ihre schlechte Erfahrung keine Folgen hat. Einer unserer Kunden – ein großes Versicherungsunternehmen – berichtete uns, dass er Kunden verliert, wenn seine Homepage nicht innerhalb von 3 Sekunden lädt.
All diese Nutzerbeschwerden über schlechte Performance oder Ausfälle deuten auf einen gemeinsamen Verursacher hin: Resilienz … oder deren Fehlen. Das Schöne an Microservices-Technologien – einschließlich Containern und Kubernetes – ist, dass sie das Kundenerlebnis erheblich verbessern können, indem sie die Resilienz Ihrer Anwendungen erhöhen. Wie? Entscheidend ist die Architektur.
Ich erkläre den grundlegenden Unterschied zwischen monolithischen und Microservices-Architekturen gerne anhand einer Lichterkette. Fällt bei einem älteren Modell eine Glühbirne aus, erlischt die gesamte Lichterkette. Wenn sich die Glühbirne nicht austauschen lässt, können Sie mit der Lichterkette nur noch das Innere Ihres Mülleimers schmücken. Diese ältere Art von Lichterkette ähnelt einer monolithischen App, deren Komponenten ebenfalls eng miteinander gekoppelt sind und die ausfällt, sobald eine Komponente nicht mehr funktioniert.
Doch die Beleuchtungsindustrie hat diesen Schwachpunkt ebenso wie die Softwarebranche erkannt. Wenn bei einer modernen Lichterkette eine Glühbirne ausfällt, leuchten die anderen weiterhin hell – genauso wie eine gut konzipierte Microservices-Anwendung auch dann weiterläuft, wenn eine Serviceinstanz ausfällt.
Kubernetes-Traffic-Management
Container sind eine beliebte Wahl für Microservices-Architekturen, da sie sich ideal eignen, um Anwendungen aus kleineren, eigenständigen Komponenten zu erstellen. Sie sind schlank, portabel und einfach zu skalieren. Kubernetes ist der De-facto-Standard für die Container-Orchestrierung, doch es gibt zahlreiche Herausforderungen bei der Produktionsreife von Kubernetes. Ein ausgereiftes Traffic-Management verbessert sowohl die Kontrolle über Kubernetes-Anwendungen als auch deren Ausfallsicherheit. Damit lassen sich Dienste statt Pakete steuern und Traffic-Management-Regeln dynamisch oder über die Kubernetes-API anpassen. Traffic-Management ist zwar in jeder Architektur wichtig, doch für leistungsstarke Anwendungen sind zwei Traffic-Management-Tools unverzichtbar: Traffic-Steuerung und Traffic-Aufteilung.
Datenverkehrssteuerung
Traffic Control (manchmal auch als „Traffic Routing“ oder „Traffic Shaping“ bezeichnet) beschreibt die Steuerung, wohin der Datenverkehr geleitet wird und auf welchem Weg er dorthin gelangt. Beim Betrieb von Kubernetes in einer Produktionsumgebung ist dies unverzichtbar, da Sie damit Ihre Infrastruktur und Anwendungen vor Angriffen und Lastspitzen schützen können. Zwei Techniken, die Sie in Ihren Anwendungsentwicklungszyklus integrieren sollten, sind Rate Limiting und Circuit Breaking.
- Anwendungsfall: Ich möchte Dienste vor zu vielen Anfragen schützen
Lösung: RatenbegrenzungUnabhängig davon, ob sie böswillig (z. B. Brute-Force-Angriffe zum Erraten von Passwörtern und DDoS-Angriffe) oder harmlos sind (etwa wenn Kunden in großer Zahl auf ein Sonderangebot zugreifen), kann eine hohe Anzahl von HTTP-Anfragen Ihre Dienste überlasten und zum Absturz Ihrer Anwendungen führen. Die Ratenbegrenzung beschränkt die Anzahl der Anfragen, die ein Benutzer innerhalb eines bestimmten Zeitraums stellen kann. Dabei kann es sich beispielsweise um eine einfacheGET-Anfrage für die Startseite einer Website oder einePOST-Anfrage über ein Anmeldeformular handeln. Bei einem DDoS-Angriff können Sie beispielsweise mithilfe der Ratenbegrenzung die Rate eingehender Anfragen auf einen für echte Benutzer typischen Wert begrenzen. - Anwendungsfall: Ich möchte kaskadierende Ausfälle vermeiden
Lösung: Circuit BreakingWenn ein Dienst nicht verfügbar ist oder hohe Latenzzeiten aufweist, kann es lange dauern, bis eingehende Anfragen wegen Zeitüberschreitung abgebrochen werden und die Clients eine Fehlermeldung erhalten. Die langen Zeitüberschreitungen können zu einem kaskadierenden Ausfall führen, bei dem der Ausfall eines Dienstes Zeitüberschreitungen bei anderen Diensten und letztlich den Ausfall der gesamten Anwendung verursacht. Circuit Breaker verhindern kaskadierende Ausfälle, indem sie Dienstausfälle überwachen. Überschreitet die Anzahl der fehlgeschlagenen Anfragen an einen Dienst einen festgelegten Schwellenwert, wird der Circuit Breaker ausgelöst und sendet den Clients sofort nach Eingang der Anfragen eine Fehlermeldung zurück. Dadurch wird der Datenverkehr vom Dienst weggeleitet. Der Circuit Breaker fängt Anfragen weiterhin für einen festgelegten Zeitraum ab und lehnt sie ab, bevor er testweise eine begrenzte Anzahl von Anfragen durchlässt. Sind diese Anfragen erfolgreich, beendet der Circuit Breaker die Drosselung des Datenverkehrs. Andernfalls beginnt der Zeitraum von Neuem und der Circuit Breaker lehnt Anfragen erneut für die festgelegte Dauer ab.
Datenverkehrsaufteilung
Traffic Splitting (manchmal auch als Traffic Testing bezeichnet) ist eine Unterkategorie der Traffic-Steuerung und bezeichnet die gezielte Aufteilung des eingehenden Traffics auf verschiedene Versionen einer Backend-App, die gleichzeitig in einer Umgebung ausgeführt werden (in der Regel die aktuelle Produktionsversion und eine aktualisierte Version). Es ist ein wesentlicher Bestandteil des App-Entwicklungszyklus, da Teams damit die Funktionalität und Stabilität neuer Funktionen und Versionen testen können, ohne Kunden zu beeinträchtigen. Geeignete Bereitstellungsszenarien sind Debug-Routing, Canary-Bereitstellungen, A/B-Tests und Blue-Green-Bereitstellungen. (Die Verwendung dieser vier Begriffe ist in der Branche recht uneinheitlich. Hier verwenden wir sie gemäß unserem Verständnis ihrer Definitionen.)
- Anwendungsfall: Ich bin bereit, eine neue Version in der Produktionsumgebung zu testen
Lösung: Debug-RoutingAngenommen, Sie haben eine Banking-App und möchten eine Funktion zur Anzeige der Kreditwürdigkeit hinzufügen. Bevor Sie sie mit Kunden testen, möchten Sie wahrscheinlich sehen, wie sie sich in der Produktionsumgebung verhält. Mit Debug-Routing können Sie die Funktion öffentlich bereitstellen und dennoch vor tatsächlichen Benutzern „verbergen“, indem Sie nur bestimmten Benutzern den Zugriff darauf erlauben. Grundlage dafür sind Layer-7-Attribute wie ein Sitzungscookie, eine Sitzungs-ID oder eine Gruppen-ID. Beispielsweise können Sie den Zugriff auf Benutzer mit einem Admin-Sitzungscookie beschränken. Deren Anfragen werden an die neue Version mit der Funktion zur Anzeige der Kreditwürdigkeit weitergeleitet, während alle anderen weiterhin die stabile Version verwenden.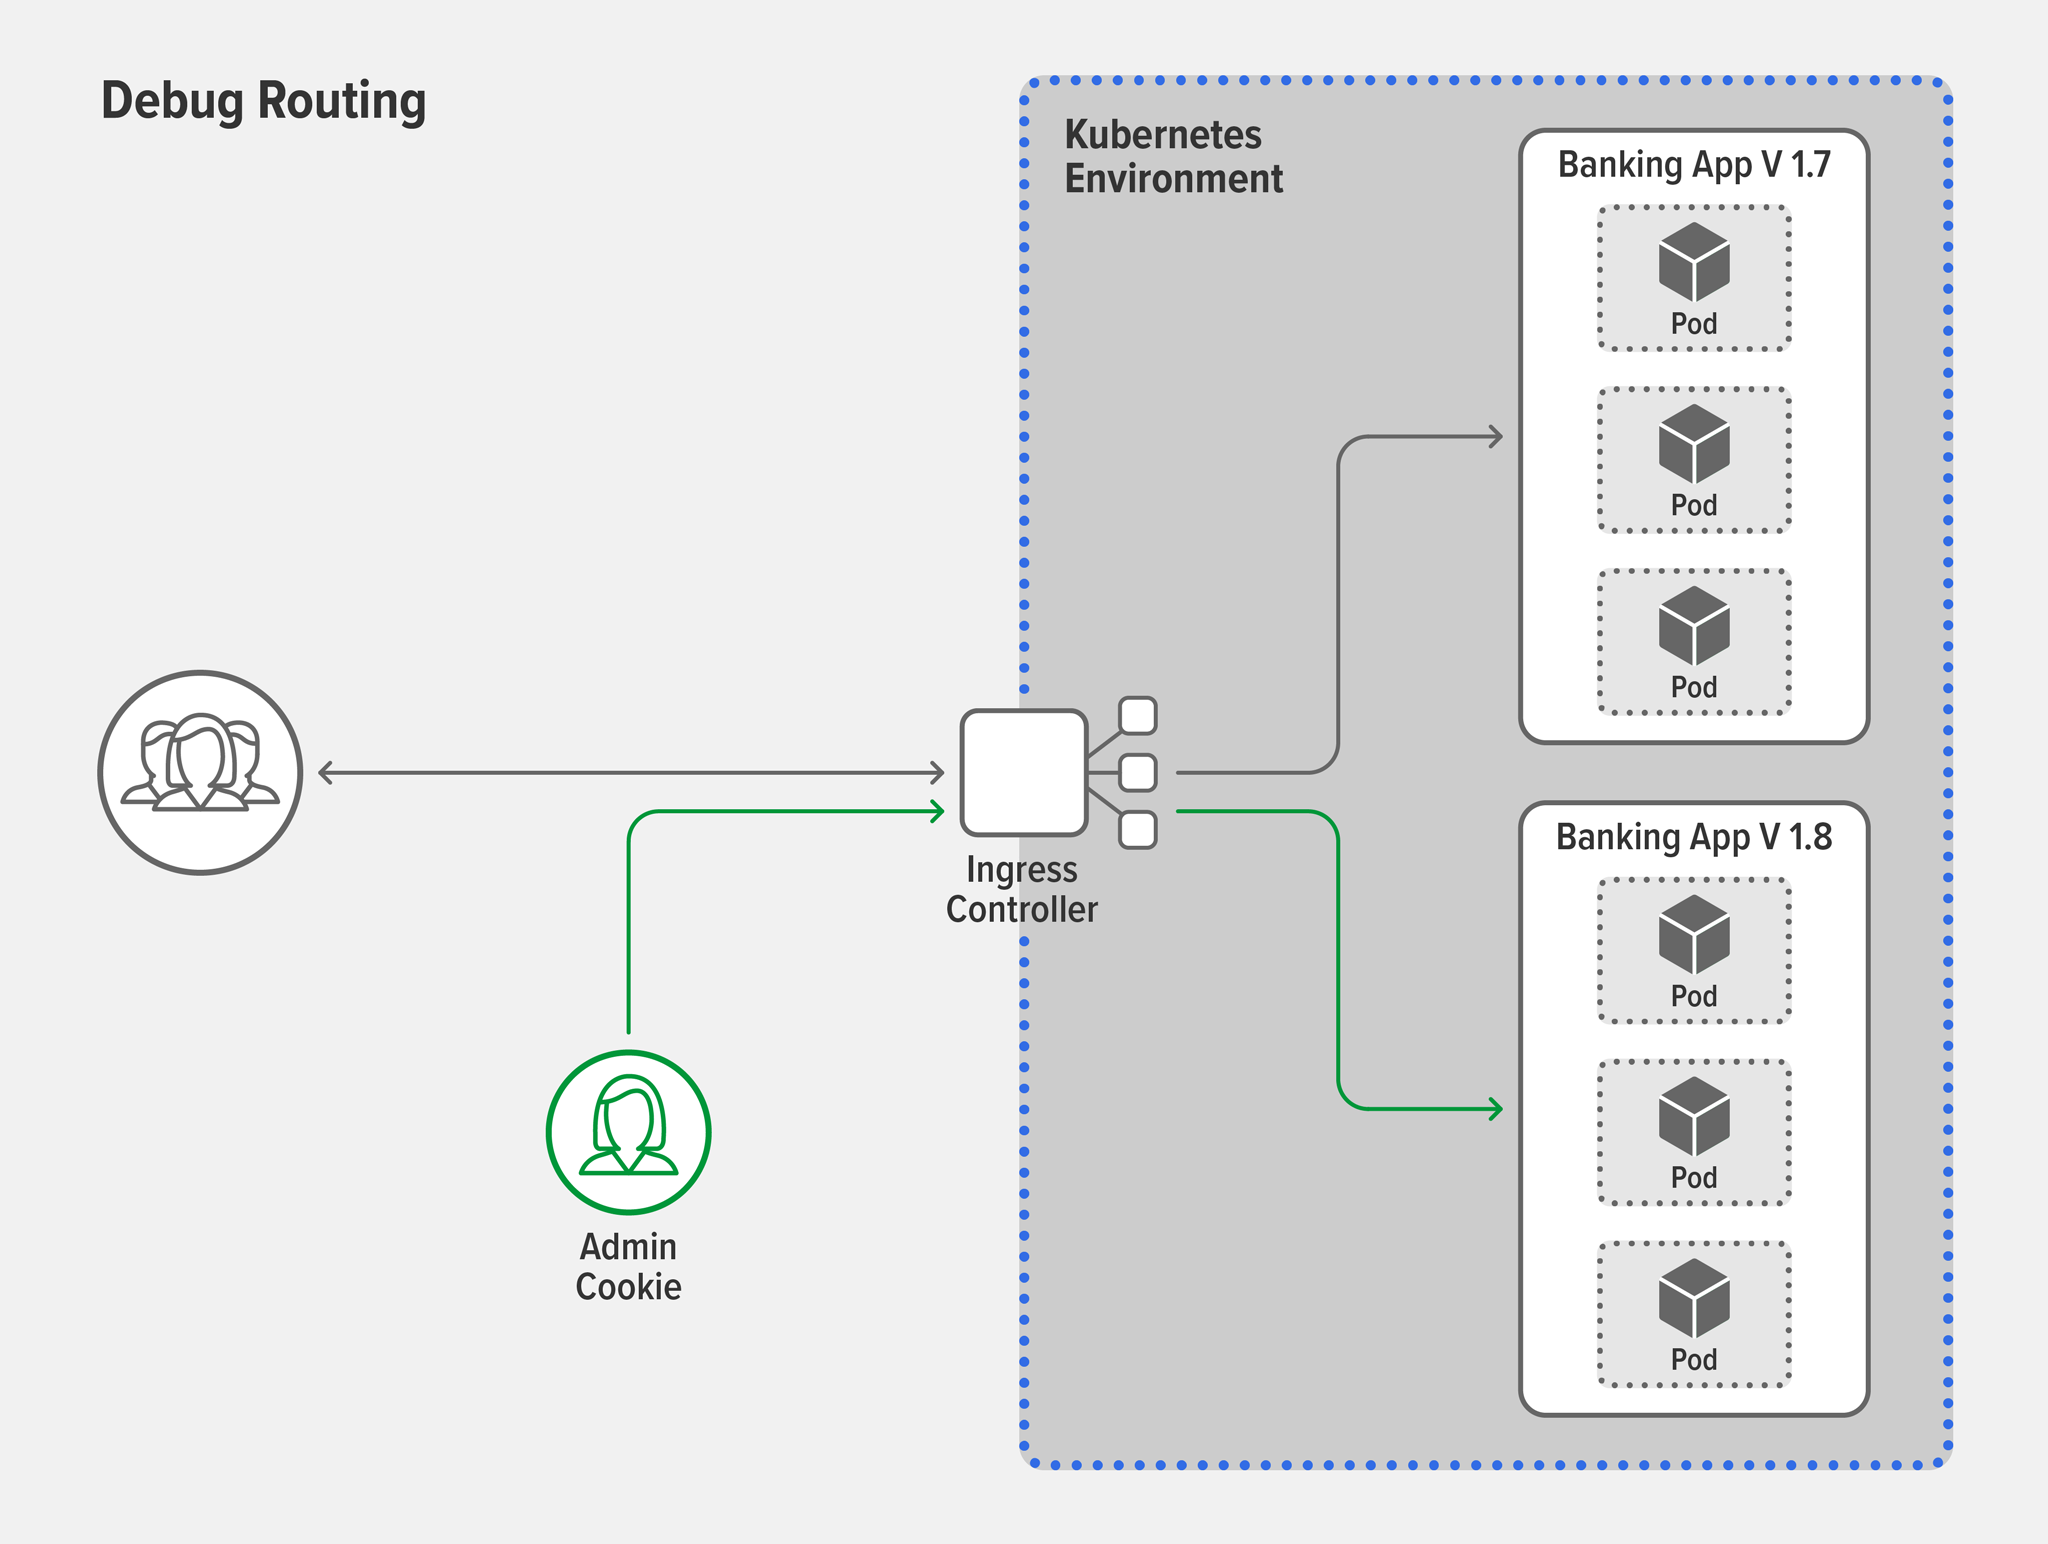
- Anwendungsfall: Ich muss sicherstellen, dass meine neue Version stabil ist
Lösung: Canary-BereitstellungDas Konzept der Canary-Bereitstellung geht auf eine historische Praxis im Bergbau zurück, bei der Bergleute einen Kanarienvogel in einem Käfig mit in ein Kohlebergwerk nahmen, um frühzeitig vor giftigen Gasen gewarnt zu werden. Das Gas tötete den Kanarienvogel, bevor es die Bergleute töten konnte, sodass sie sich schnell in Sicherheit bringen konnten. In der Welt der Apps kommen dabei keine Vögel zu Schaden! Canary-Bereitstellungen bieten eine sichere und agile Möglichkeit, die Stabilität einer neuen Funktion oder Version zu testen. Bei einer typischen Canary-Bereitstellung verbleibt zunächst ein großer Anteil Ihrer Benutzer (beispielsweise 99 %) auf der stabilen Version, während eine kleine Gruppe (die übrigen 1 %) auf die neue Version umgestellt wird. Wenn die neue Version fehlschlägt, beispielsweise abstürzt oder Fehler an Clients zurückgibt, können Sie die Testgruppe sofort wieder auf die stabile Version umstellen. Ist der Test erfolgreich, können Sie die Benutzer entweder alle auf einmal oder – wie es häufiger der Fall ist – im Rahmen einer schrittweisen, kontrollierten Migration von der stabilen auf die neue Version umstellen.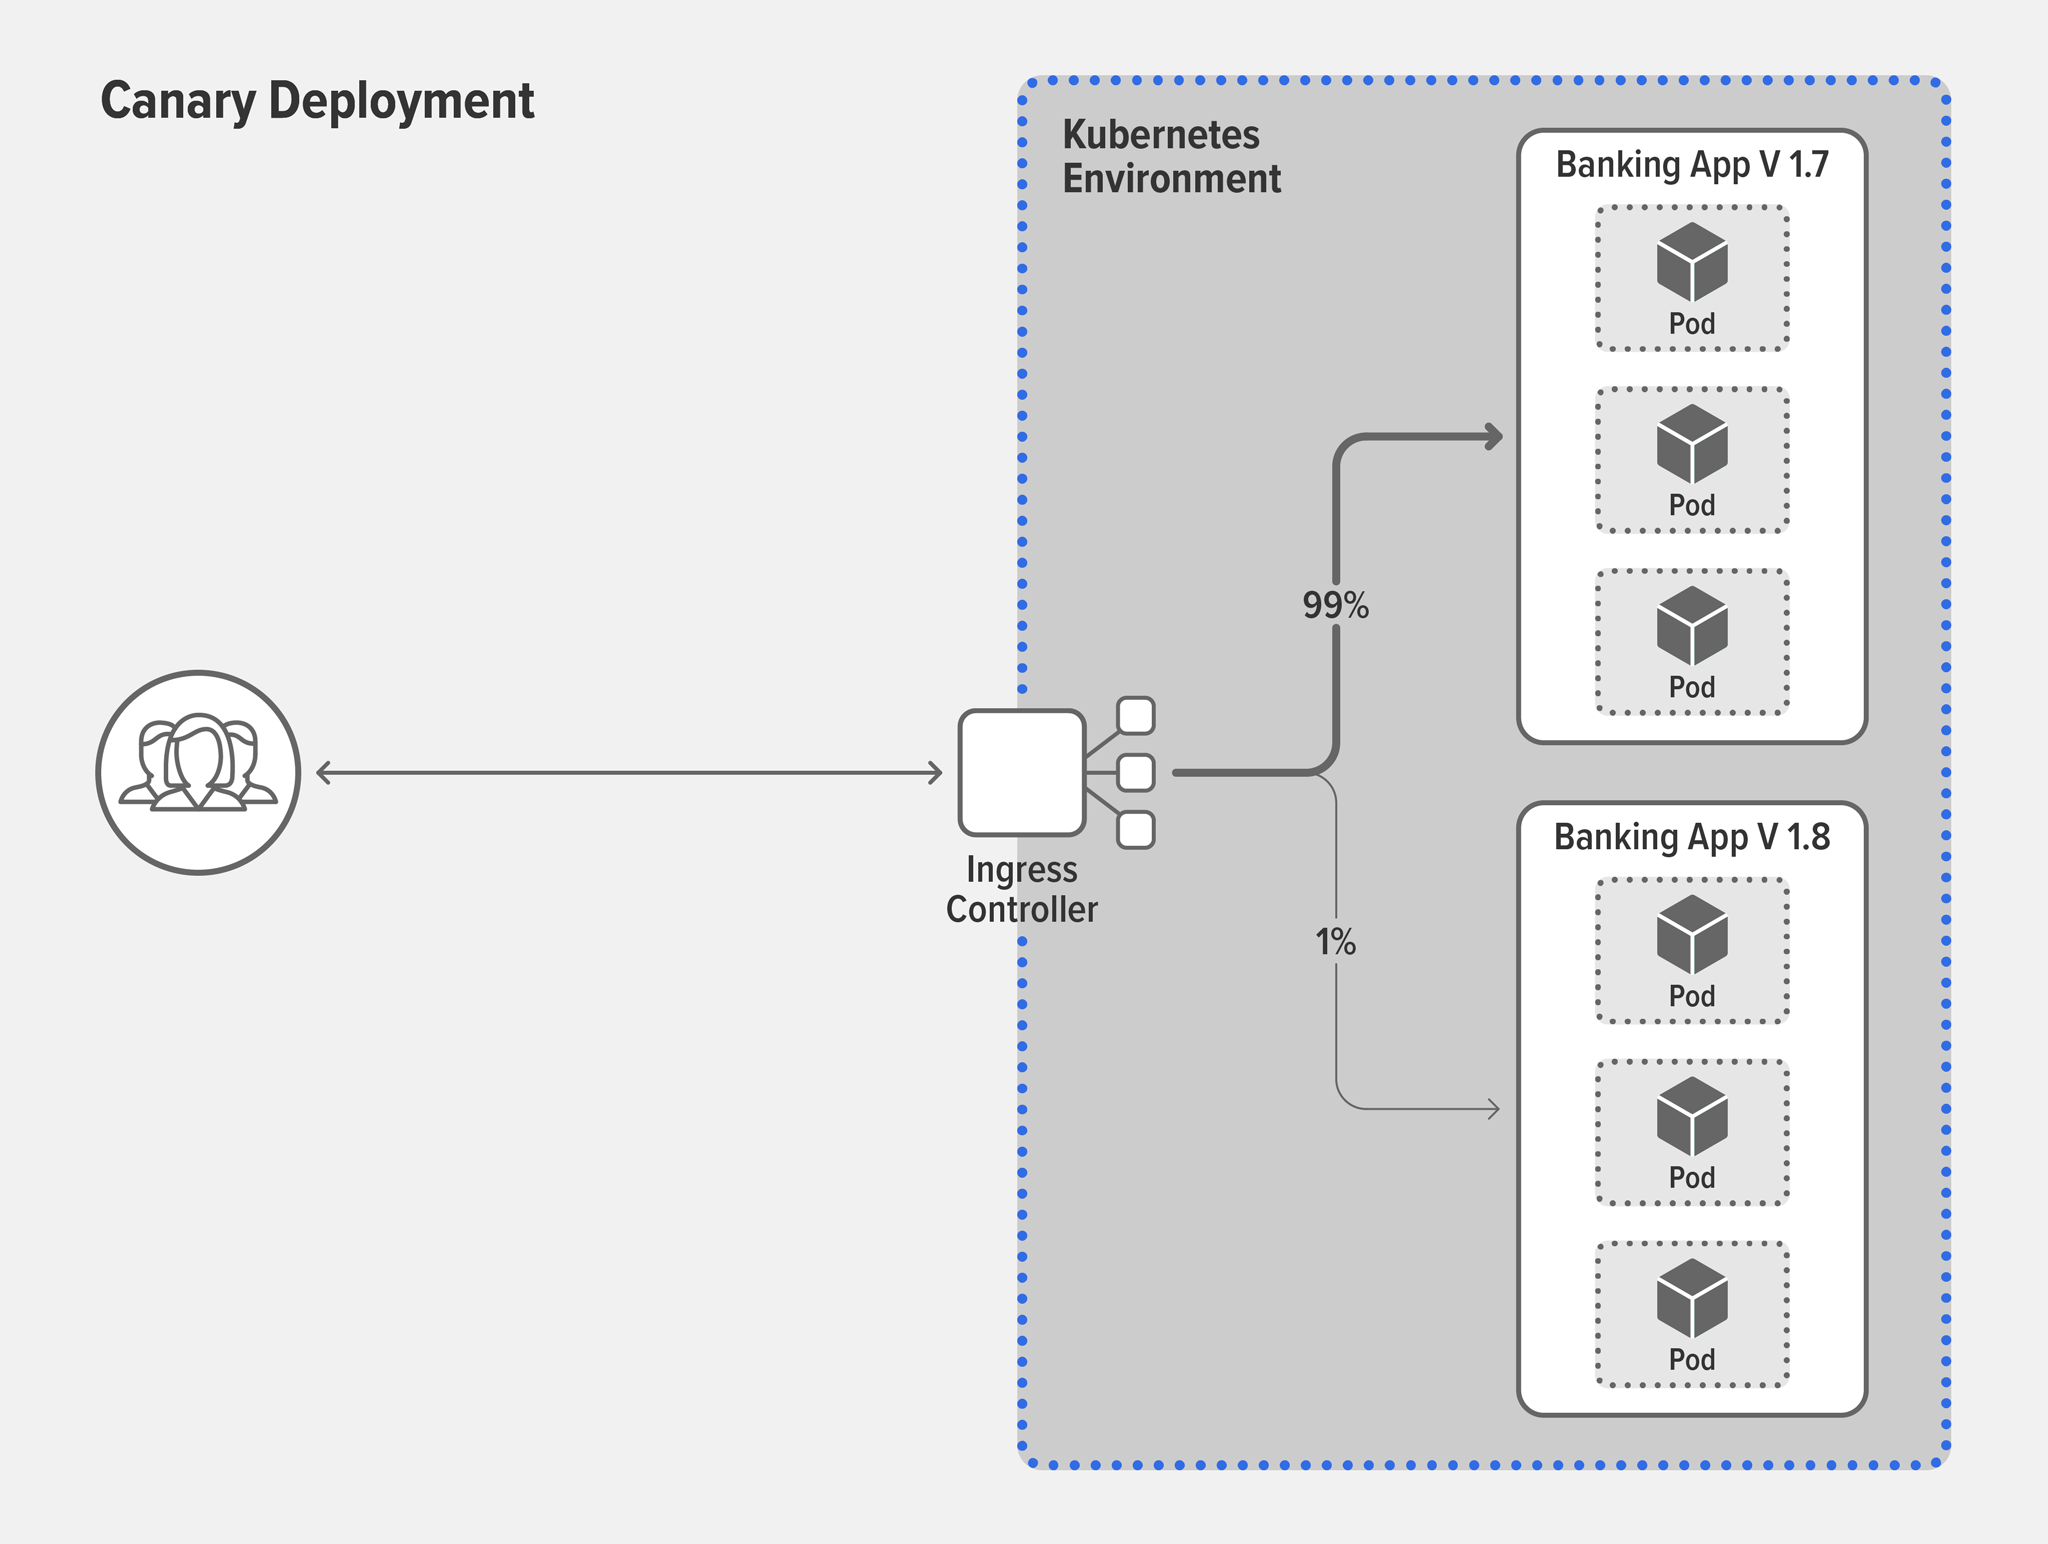
- Anwendungsfall: Ich muss herausfinden, ob Kunden eine neue Version besser finden als die aktuelle Version
Lösung: A/B-TestNachdem Sie sich vergewissert haben, dass Ihre neue Funktion in der Produktionsumgebung funktioniert, möchten Sie möglicherweise anhand wichtiger Leistungsindikatoren (KPIs) wie der Anzahl der Klicks, wiederkehrender Benutzer oder ausdrücklicher Bewertungen Kundenfeedback zum Erfolg der Funktion einholen. A/B-Tests werden in vielen Branchen eingesetzt, um das Benutzerverhalten zu messen und zu vergleichen und so den relativen Erfolg verschiedener Produkt- oder App-Versionen im gesamten Kundenstamm zu ermitteln. Bei einem typischen A/B-Test erhalten 50 % der Benutzer Version A (die aktuelle App-Version), während die übrigen 50 % Version B (die Version mit der neuen, aber stabilen Funktion) erhalten. Gewinner ist die Version mit den insgesamt besseren KPIs.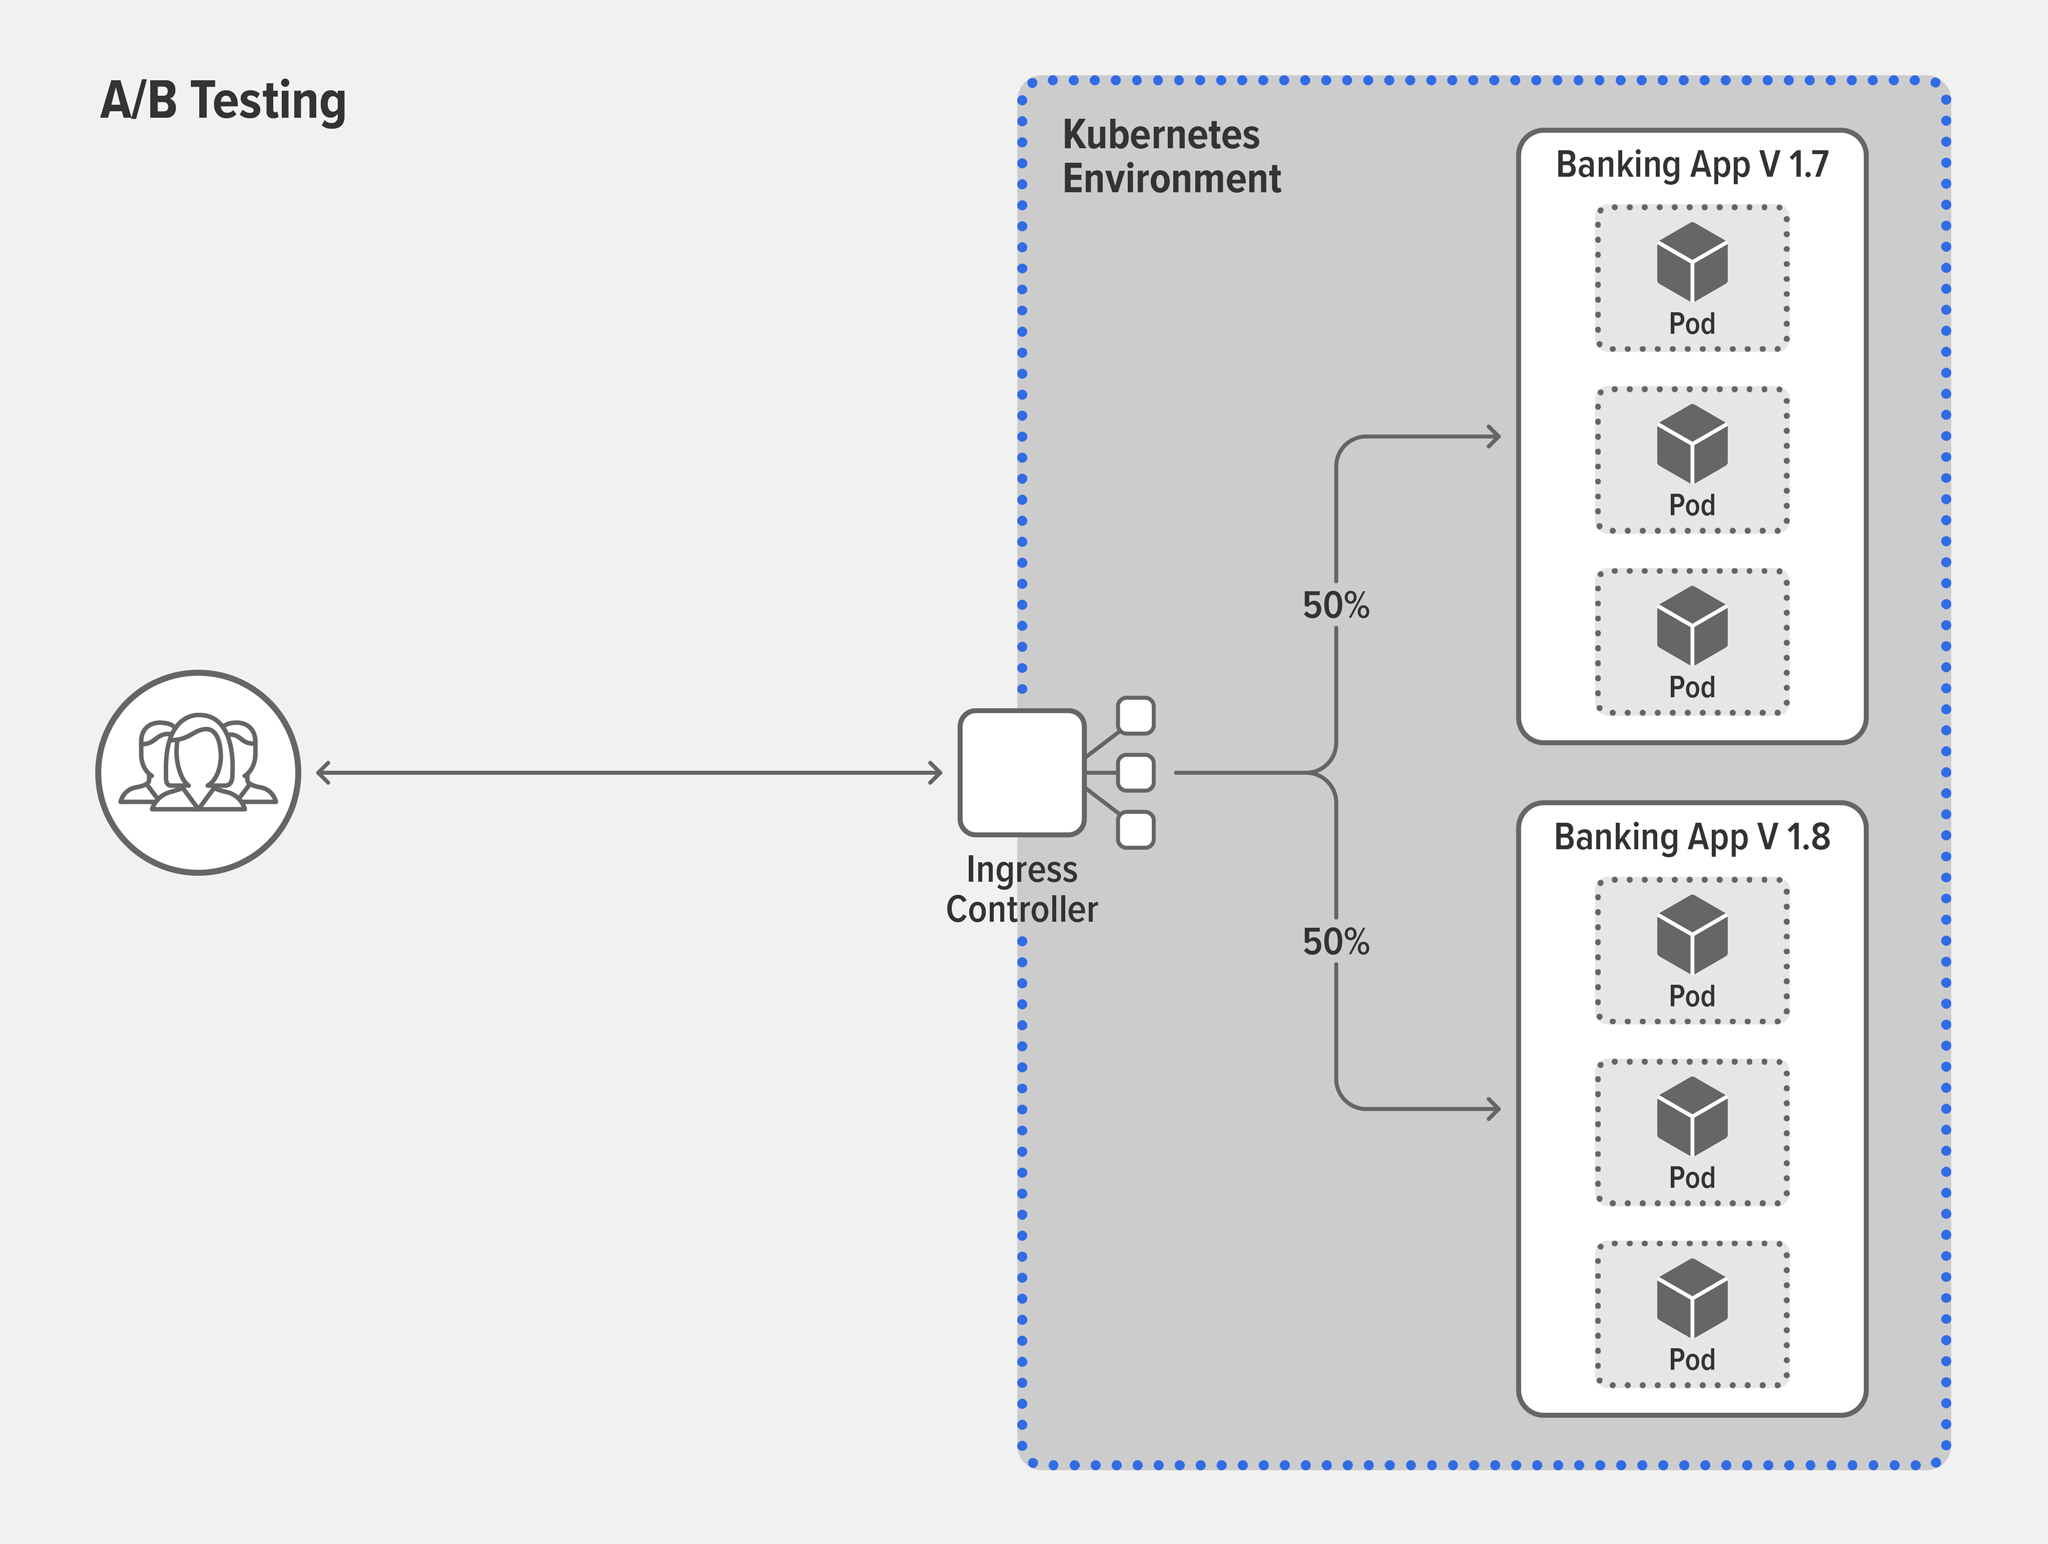
- Anwendungsfall: Ich möchte meine Benutzer ohne Ausfallzeit auf eine neue Version umstellen
Lösung: Blue-Green-DeploymentNehmen wir nun an, für Ihre Banking-App steht ein großer Versionswechsel an … herzlichen Glückwunsch! Früher bedeuteten Versions-Upgrades in der Regel Ausfallzeiten für die Benutzer, da die alte Version außer Betrieb genommen werden musste, bevor die neue Version in die Produktionsumgebung überführt werden konnte. Im heutigen Wettbewerbsumfeld sind Ausfallzeiten aufgrund von Upgrades für die meisten Benutzer jedoch inakzeptabel. Blue-Green-Deployments reduzieren die Ausfallzeiten bei Upgrades erheblich oder vermeiden sie sogar vollständig. Lassen Sie einfach die alte Version (Blue) in der Produktionsumgebung weiterlaufen, während Sie gleichzeitig die neue Version (Green) parallel in derselben Produktionsumgebung bereitstellen. Die meisten Unternehmen möchten nicht 100 % der Benutzer auf einmal von Blue auf Green umstellen – denn was passiert, wenn die Green-Version ausfällt?! Die Lösung besteht darin, ein Canary-Deployment zu verwenden, um die Benutzer in den Schritten umzustellen, die am besten zu Ihrer Strategie zur Risikominderung passen. Sollte sich die neue Version als Desaster erweisen, können Sie mit nur wenigen Tastatureingaben alle Benutzer wieder auf die stabile Version zurücksetzen.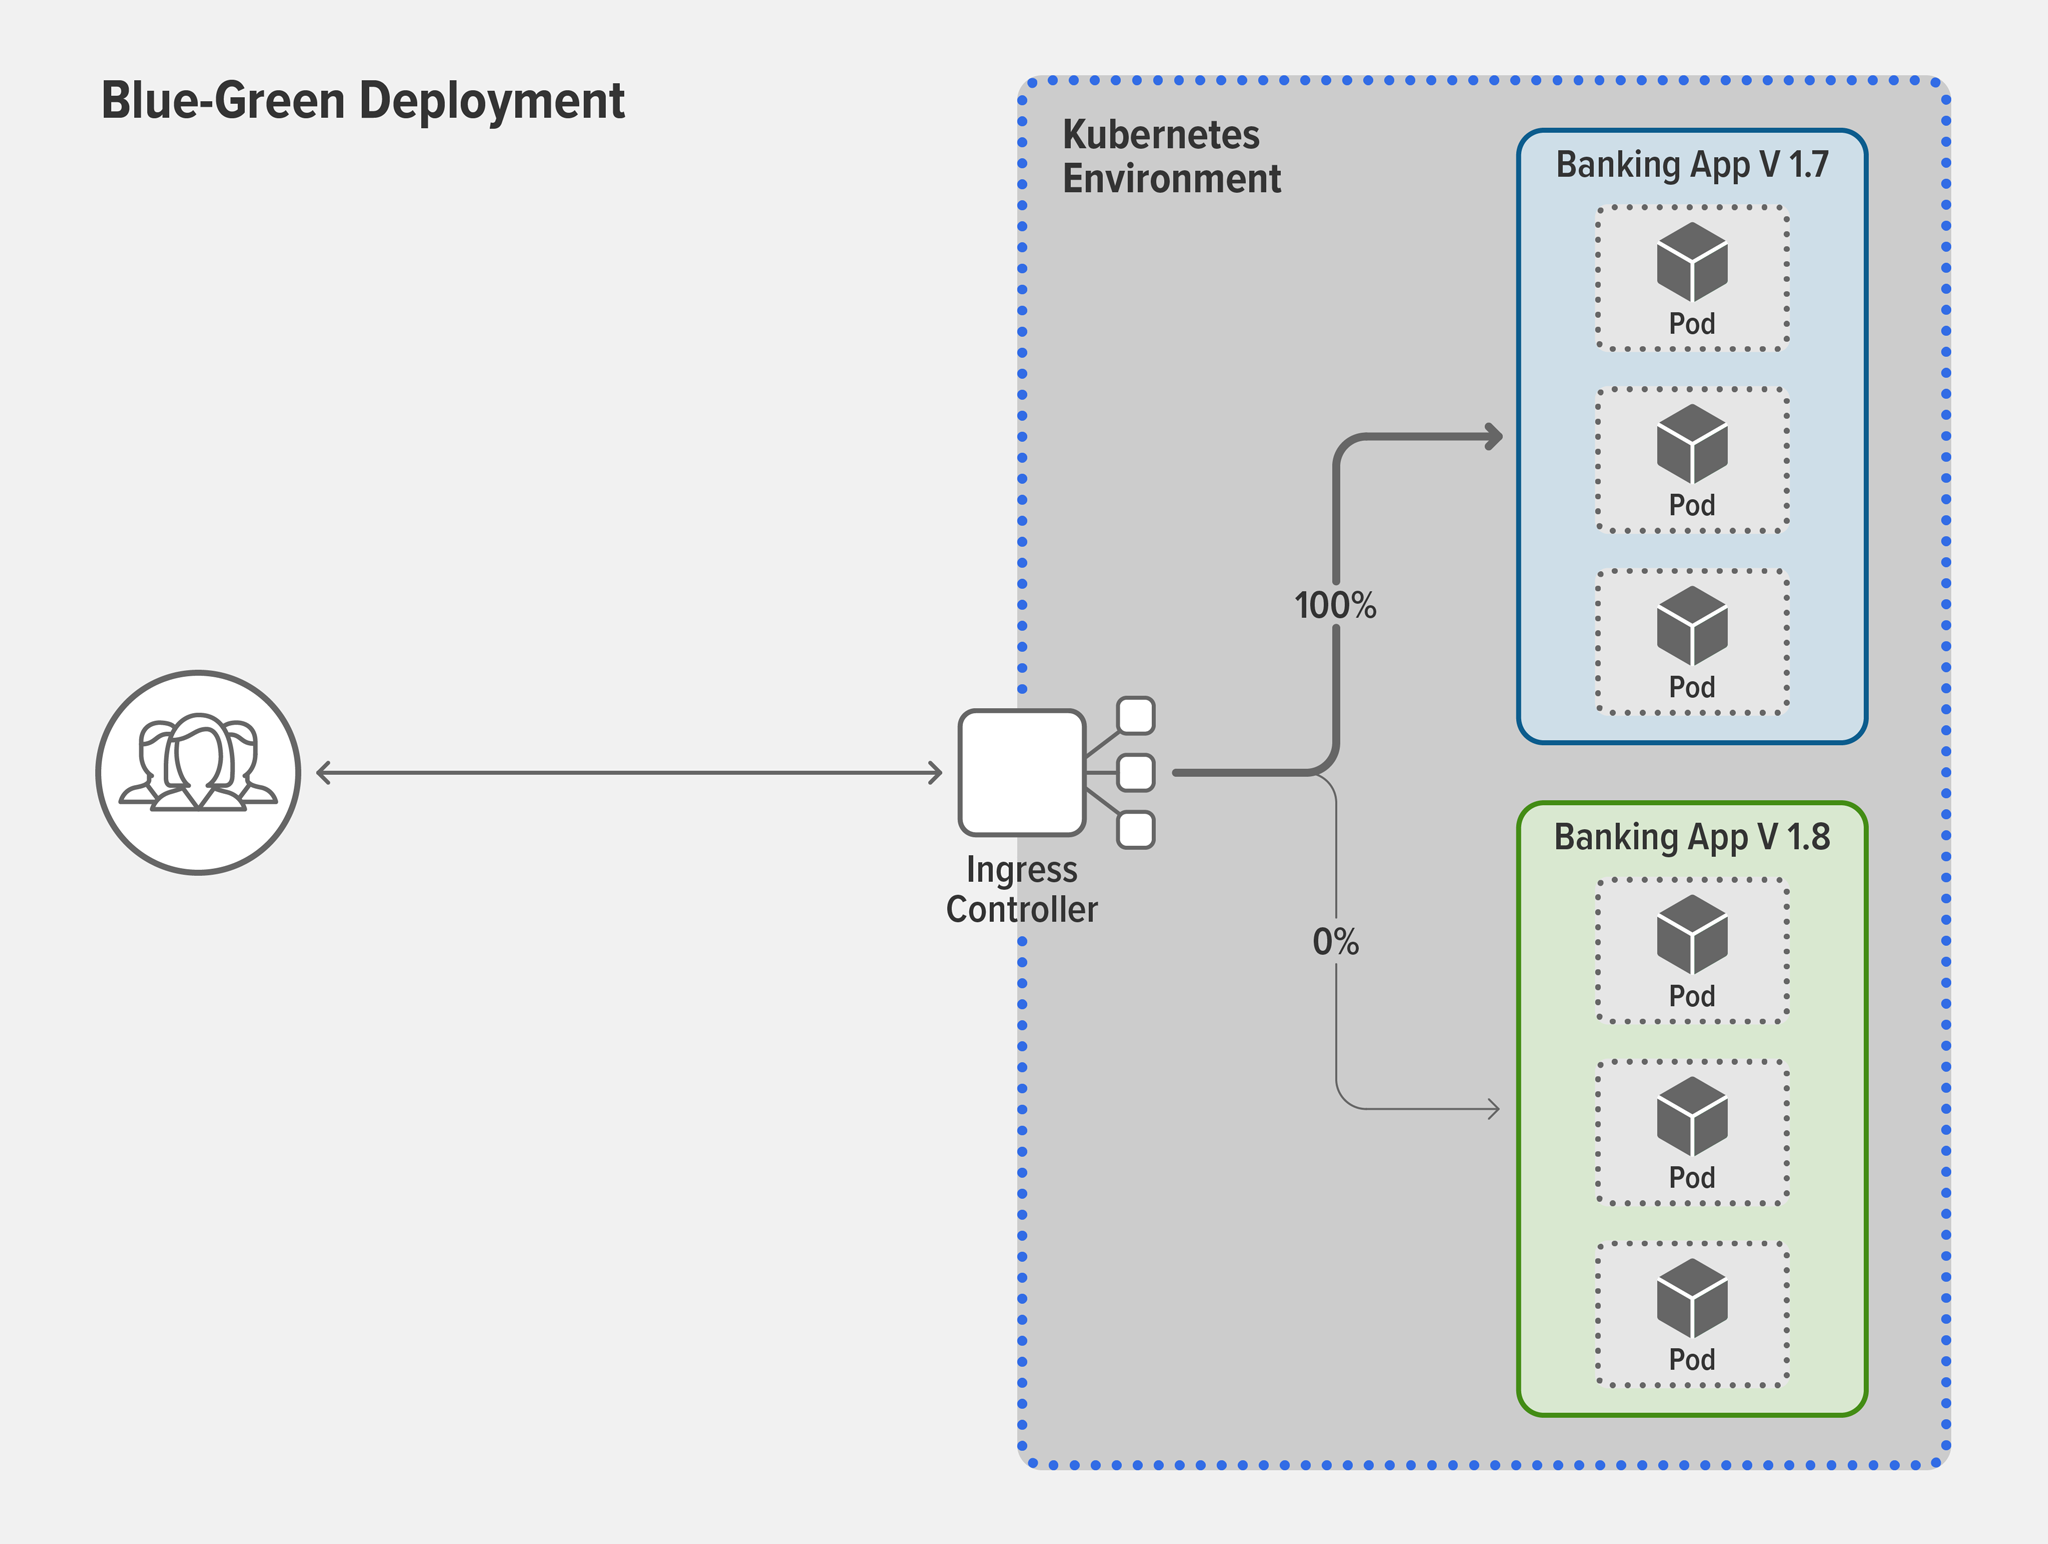
Wie NGINX helfen kann
Mit den meisten Ingress-Controllern und Service Meshes können Sie eine erweiterte Steuerung und Aufteilung des Datenverkehrs realisieren. Welche Technologie Sie verwenden sollten, hängt von Ihrer Anwendungsarchitektur und Ihren Anwendungsfällen ab. In den folgenden drei Szenarien ist beispielsweise der Einsatz eines Ingress-Controllers sinnvoll:
- Ihre Anwendungen haben nur einen einzigen Endpunkt, wie es bei einfachen oder monolithischen Anwendungen der Fall ist, die Sie per „Lift-and-Shift“ zu Kubernetes migriert haben.
- In Ihrem Cluster findet keine Kommunikation zwischen Diensten statt.
- Es gibt eine Service-zu-Service-Kommunikation, aber Sie verwenden noch kein Service Mesh.
Wenn Ihre Bereitstellung so komplex ist, dass sie ein Service Mesh erfordert, besteht ein häufiger Anwendungsfall darin, den Datenverkehr zwischen Diensten aufzuteilen, um einzelne Microservices zu testen oder zu aktualisieren. Beispielsweise könnten Sie hinter Ihrem mobilen Frontend ein Canary Deployment zwischen zwei verschiedenen Versionen Ihrer Microservice-API für die Geolokalisierung durchführen.
Die Einrichtung der Datenverkehrsaufteilung mit einigen Ingress-Controllern und Service Meshes kann jedoch aus verschiedenen Gründen zeitaufwendig und fehleranfällig sein:
- Ingress-Controller und Service Meshes verschiedener Anbieter implementieren Kubernetes-Funktionen auf unterschiedliche Weise.
- Kubernetes ist nicht wirklich darauf ausgelegt, Layer-7-Datenverkehr zu verwalten und zu verstehen.
- Einige Ingress-Controller und Service Meshes unterstützen kein ausgefeiltes Traffic-Management.
Mit dem NGINX Ingress Controller und NGINX Service Mesh können Sie in Sekundenschnelle robuste Richtlinien für die Weiterleitung und Aufteilung des Datenverkehrs konfigurieren. Sehen Sie sich diese Livestream-Demo mit unseren Experten an und lesen Sie weiter, um zu erfahren, wie Sie dank einfacherer Konfigurationen, erweiterter Anpassungsmöglichkeiten und verbesserter Transparenz Zeit sparen.
Einfachere Konfiguration mit NGINX-Ingress-Ressourcen und der SMI-Spezifikation
Diese NGINX-Funktionen erleichtern die Konfiguration:
- NGINX-Ingress-Ressourcen für den NGINX Ingress Controller – Die standardmäßige Kubernetes-Ingress-Ressource erleichtert zwar die Konfiguration von SSL/TLS-Terminierung, HTTP-Lastverteilung und Layer-7-Routing, bietet jedoch nicht die Anpassungsmöglichkeiten, die für Circuit Breaking, A/B-Tests und Blue-Green-Deployments erforderlich sind. Stattdessen müssen Benutzer, die NGINX nicht verwenden, auf Annotationen, ConfigMaps und benutzerdefinierte Vorlagen zurückgreifen. Diese bieten keine präzise Steuerung, sind unsicher, fehleranfällig und schwierig zu verwenden. Der NGINX Ingress Controller bietet NGINX-Ingress-Ressourcen als Alternative zur standardmäßigen Ingress-Ressource, die ebenfalls unterstützt wird. Sie ermöglichen einen nativen, typsicheren und eingerückten Konfigurationsstil, der die Implementierung der Ingress-Lastverteilung vereinfacht. NGINX-Ingress-Ressourcen bieten bestehenden NGINX-Benutzern einen weiteren Vorteil: Konfigurationen für die Lastverteilung aus Nicht-Kubernetes-Umgebungen lassen sich leichter wiederverwenden, sodass alle Ihre NGINX-Load-Balancer dieselben Konfigurationen nutzen können.
- NGINX Service Mesh mit SMI – NGINX Service Mesh implementiert das Service Mesh Interface (SMI), eine Spezifikation, die eine Standardschnittstelle für Service Meshes auf Kubernetes mit typisierten Ressourcen wie
TrafficSplit,TrafficTargetundHTTPRouteGroupdefiniert. Mithilfe standardmäßiger Kubernetes-Konfigurationsmethoden vereinfachen NGINX Service Mesh und die NGINX-SMI-Erweiterungen die Implementierung von Richtlinien zur Datenverkehrsaufteilung, etwa für Canary-Bereitstellungen, bei minimaler Beeinträchtigung des Produktionsdatenverkehrs. So lässt sich beispielsweise eine Canary-Bereitstellung mit NGINX Service Mesh definieren:
apiVersion: split.smi-spec.io/v1alpha2kind: TrafficSplit
metadata:
name: target-ts
spec:
service: target-svc
backends:
- service: target-v1-0
    weight: 90
- service: target-v2-0
weight: 10- Unser Tutorial „Bereitstellungen mit Traffic-Aufteilung“ erläutert anhand von Beispielen Bereitstellungsmuster, die Traffic-Aufteilung nutzen, darunter Canary- und Blue-Green-Bereitstellungen.
Ausgereiftere Datenverkehrssteuerung und -aufteilung mit erweiterten Anpassungen
Mit diesen NGINX-Funktionen lässt sich der Datenverkehr auf ausgefeilte Weise steuern und aufteilen:
- Der Schlüssel-Wert-Speicher für Canary-Bereitstellungen – Bei A/B-Tests oder Blue-Green-Bereitstellungen möchten Sie den Datenverkehr möglicherweise schrittweise auf die neue Version umstellen, beispielsweise auf 0 %, 5 %, 10 %, 25 %, 50 % und 100 %. Bei den meisten Tools ist dies ein sehr manueller Prozess, da Sie für jeden Schritt den Prozentsatz bearbeiten und die Konfigurationsdatei neu laden müssen. Angesichts dieses Aufwands könnten Sie sich dazu entschließen, das Risiko einzugehen und direkt von 5 % auf 100 % zu wechseln. Mit der auf NGINX Plus basierenden Version von NGINX Ingress Controller können Sie jedoch den Schlüssel-Wert-Speicher nutzen, um die Prozentsätze zu ändern, ohne die Konfiguration neu laden zu müssen.
- Circuit Breaking mit NGINX Ingress Controller – Ausgereifte Circuit Breaker sparen Zeit und erhöhen die Ausfallsicherheit, indem sie Fehler schneller erkennen, ein Failover durchführen und sogar benutzerdefinierte, formatierte Fehlerseiten für fehlerhafte Upstream-Server aktivieren. Beispielsweise könnte ein Circuit Breaker für einen Suchdienst so konfiguriert werden, dass er eine korrekt formatierte, aber leere Suchergebnismenge zurückgibt. Um dieses Maß an Funktionalität zu erreichen, verwendet die auf NGINX Plus basierende Version von NGINX Ingress Controller aktive Systemdiagnosen, die den Zustand Ihrer TCP- und UDP-Upstream-Server proaktiv überwachen. Dank der Echtzeitüberwachung ist es weniger wahrscheinlich, dass Ihre Clients auf Anwendungen stoßen, die Fehler zurückgeben.
- Circuit Breaking mit NGINX Service Mesh – Die NGINX Service Mesh-Circuit-Breaker-Spezifikation verfügt über drei benutzerdefinierte Felder: Während
errorsundtimeoutSecondsStandardfunktionen eines Circuit Breakers sind, erhöhtfallbackdie Ausfallsicherheit zusätzlich, indem Sie einen Backup-Server definieren können. Wenn die Antworten Ihres Backup-Servers eindeutig sind, können sie frühzeitig auf Probleme in Ihrem Cluster hinweisen, sodass Sie sofort mit der Fehlerbehebung beginnen können.errors– Die Anzahl der Fehler, bevor der Schutzschalter auslösttimeoutSeconds– Das Zeitfenster, innerhalb dessen Fehler auftreten müssen, bevor der Schutzschalter ausgelöst wird, sowie die Wartezeit, bevor der Schutzschalter wieder geschlossen wirdfallback– Name und Port des Kubernetes-Dienstes, an den der Datenverkehr umgeleitet wird, nachdem der Schutzschalter ausgelöst wurde
Ergebnisse der Datenverkehrsaufteilung mithilfe von Dashboards auswerten
Sie haben Ihre Datenverkehrsaufteilung implementiert … und jetzt? Nun ist es an der Zeit, das Ergebnis zu analysieren. Das kann der schwierigste Teil sein, da vielen Unternehmen wichtige Einblicke in die Performance ihres Kubernetes-Datenverkehrs und ihrer Anwendungen fehlen. NGINX erleichtert die Gewinnung solcher Erkenntnisse mit dem NGINX Plus-Dashboard und vorkonfigurierten Grafana-Dashboards, die die vom Prometheus Exporter bereitgestellten Metriken visualisieren. Weitere Informationen dazu, wie Sie die Transparenz verbessern und Erkenntnisse gewinnen können, finden Sie im Beitrag So verbessern Sie die Transparenz in Kubernetes in unserem Blog.
Microservices mit NGINX meistern
Der auf NGINX Plus basierende NGINX Ingress Controller ist im Rahmen einer 30-tägigen kostenlosen Testversion erhältlich, die NGINX App Protect zum Schutz Ihrer containerisierten Anwendungen umfasst.
Um NGINX Ingress Controller mit NGINX Open Source auszuprobieren, können Sie den Quellcode der Version beziehen oder einen vorkonfigurierten Container von DockerHub herunterladen.
Das dauerhaft kostenlose NGINX Service Mesh steht unter zum Download auf f5.com bereit.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.