In Lastverteilung mit NGINX und NGINX Plus, Teil 1 haben wir einen einfachen HTTP-Proxy eingerichtet, um den Datenverkehr auf mehrere Webserver zu verteilen. In diesem Artikel betrachten wir weitere Funktionen, von denen einige in NGINX Plus verfügbar sind: Leistungsoptimierung mit Keepalive-Verbindungen, Systemzustandsprüfungen, Sitzungspersistenz, Weiterleitungen und Umschreiben von Inhalten.
Weitere Informationen zu den Load-Balancing-Funktionen in NGINX und NGINX Plus finden Sie im NGINX Plus-Administratorhandbuch.
Anmerkung der Redaktion – NGINX Plus Release 5 und höher kann auch die Lastverteilung für TCP-basierte Anwendungen übernehmen. Die TCP-Lastverteilung wurde in Release 6 durch Zustandsprüfungen, dynamische Neukonfiguration, SSL-Terminierung und weitere Funktionen erheblich erweitert. In NGINX Plus Release 7 und höher bietet der TCP-Load-Balancer denselben Funktionsumfang wie der HTTP-Load-Balancer. Die Unterstützung für UDP-Lastverteilung wurde mit Release 9 eingeführt.
Sie konfigurieren den TCP- und UDP-Lastenausgleich im stream-Kontext anstelle des http-Kontexts. Die verfügbaren Direktiven und Parameter unterscheiden sich aufgrund der grundlegenden Unterschiede zwischen HTTP und TCP/UDP teilweise. Weitere Informationen finden Sie in der Dokumentation zu den Upstream-Modulen für HTTP und TCP/UDP.
Ein kurzer Rückblick
Zur Erinnerung: Dies ist die Konfiguration, die wir im vorherigen Artikel erstellt haben:
server {    listen 80;

    location / {
        proxy_pass http://backend;

        # Rewrite the 'Host' header to the value in the client request,
        # or primary server name
        proxy_set_header Host $host;

        # Alternatively, put the value in the config:
        # proxy_set_header Host www.example.com;
    }
}

upstream backend {
    zone backend 64k;  # Use NGINX Plus' shared memory
    least_conn;

    server webserver1 weight=1;
    server webserver2 weight=4;
}
In diesem Artikel sehen wir uns einige einfache Möglichkeiten zur Konfiguration von NGINX und NGINX Plus an, mit denen sich die Effizienz des Load Balancings verbessern lässt.
HTTP-Keepalives
Die Aktivierung von HTTP-Keepalives zwischen NGINX bzw. NGINX Plus und den Upstream-Servern verbessert die Leistung (durch Verringerung der Latenz) und reduziert die Wahrscheinlichkeit, dass NGINX die ephemeren Ports ausgehen.
Das HTTP-Protokoll verwendet zugrunde liegende TCP-Verbindungen, um HTTP-Anfragen zu übertragen und HTTP-Antworten zu empfangen. HTTP-Keepalive-Verbindungen ermöglichen die Wiederverwendung dieser TCP-Verbindungen und vermeiden so den Aufwand, für jede Anfrage eine Verbindung herzustellen und wieder zu schließen:
NGINX ist ein vollständiger Proxy und verwaltet Verbindungen von Clients (Frontend-Keepalive-Verbindungen) und Verbindungen zu Servern (Upstream-Keepalive-Verbindungen) unabhängig voneinander:
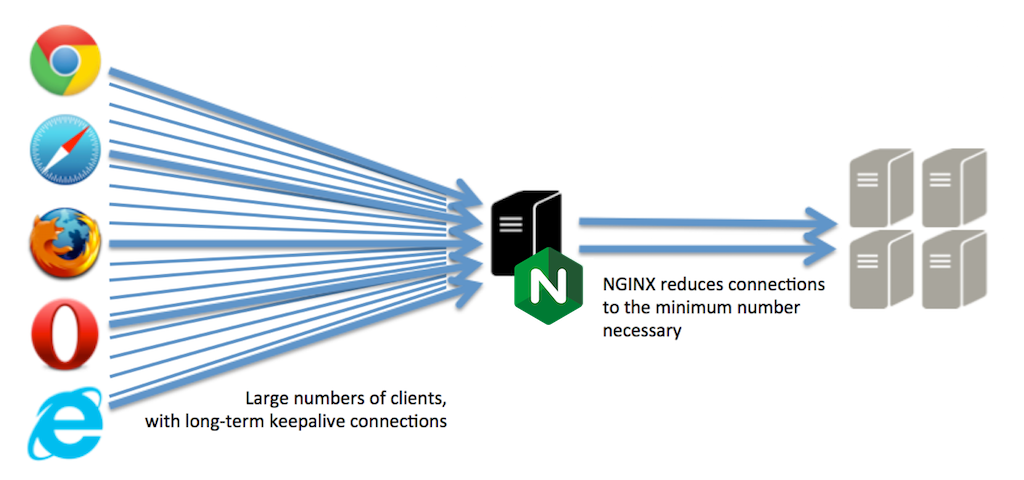
NGINX verwaltet einen „Cache“ mit Keepalive-Verbindungen – eine Gruppe inaktiver Keepalive-Verbindungen zu den Upstream-Servern. Wenn NGINX eine Anfrage an einen Upstream weiterleiten muss, verwendet es eine bereits bestehende Keepalive-Verbindung aus dem Cache, anstatt eine neue TCP-Verbindung herzustellen. Dadurch werden die Latenz bei Transaktionen zwischen NGINX und den Upstream-Servern sowie die Nutzungsrate kurzlebiger Ports reduziert, sodass NGINX große Datenverkehrsmengen bewältigen und per Lastenausgleich verteilen kann. Bei einem starken Anstieg des Datenverkehrs kann der Cache geleert werden. In diesem Fall stellt NGINX neue HTTP-Verbindungen zu den Upstream-Servern her.
Bei anderen Lastverteilungstools wird diese Technik manchmal als „Multiplexing“, „Connection-Pooling“, „Wiederverwendung von Verbindungen“ oder „OneConnect“ bezeichnet.
Sie konfigurieren den Cache für Keepalive-Verbindungen, indem Sie die Direktiven „proxy_http_version“, „proxy_set_header“ und „keepalive“ in die Konfiguration aufnehmen:
server {    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
     }
}

upstream backend {
    server webserver1;
    server webserver2;

    # maintain up to 20 idle connections to the group of upstream servers
    keepalive 20;
}
Integritätsprüfungen
Die Aktivierung von Zustandsprüfungen erhöht die Zuverlässigkeit Ihres lastverteilten Dienstes, verringert die Wahrscheinlichkeit, dass Endbenutzer Fehlermeldungen sehen, und kann zudem gängige Wartungsarbeiten erleichtern.
Mit der Systemdiagnose-Funktion in NGINX Plus lassen sich Ausfälle von Upstream-Servern erkennen. NGINX Plus prüft jeden Server mithilfe „synthetischer Transaktionen“ und gleicht die Antwort mit den Parametern ab, die Sie in der health_check-Direktive konfigurieren (und, wenn Sie den match-Parameter verwenden, mit dem zugehörigen match-Konfigurationsblock):
server {    listen 80;

    location / {
        proxy_pass http://backend;

        health_check interval=2s fails=1 passes=5 uri=/test.php match=statusok;

        # The health checks inherit other proxy settings
        proxy_set_header Host www.foo.com;
    }
}

match statusok {
    # Used for /test.php health check
    status 200;
    header Content-Type = text/html;
    body ~ "Server[0-9]+ is alive";
}
Die Integritätsprüfung übernimmt einige Parameter aus ihrem übergeordneten location-Block. Dies kann zu Problemen führen, wenn Sie Laufzeitvariablen in Ihrer Konfiguration verwenden. Die folgende Konfiguration funktioniert beispielsweise für echten HTTP-Datenverkehr, da sie den Wert des Host-Headers aus der Clientanfrage extrahiert. Für die von der Integritätsprüfung verwendeten synthetischen Transaktionen funktioniert sie wahrscheinlich nicht, da für diese kein Host-Header festgelegt ist. Das bedeutet, dass in der synthetischen Transaktion kein Host-Header verwendet wird.
location / {    proxy_pass http://backend;

    # This health check might not work...
    health_check interval=2s fails=1 passes=5 uri=/test.php match=statusok;

    # Extract the 'Host' header from the request
    proxy_set_header Host $host;
}
Eine gute Lösung besteht darin, einen Dummy-location-Block zu erstellen, der alle von der Health-Check-Transaktion verwendeten Parameter statisch definiert:
location /internal-health-check1 {    internal; # Prevent external requests from matching this location block

    proxy_pass http://backend;

    health_check interval=2s fails=1 passes=5 uri=/test.php match=statusok;

    # Explicitly set request parameters; don't use run-time variables
    proxy_set_header Host www.example.com;
}
Weitere Informationen finden Sie im NGINX Plus-Administratorhandbuch.
Sitzungspersistenz
Mit Sitzungspersistenz können Anwendungen, die nicht in einem Cluster bereitgestellt werden können, zuverlässig lastverteilt und skaliert werden. Anwendungen, die den Sitzungsstatus speichern und replizieren, arbeiten effizienter, und die Leistung für Endbenutzer verbessert sich.
Bestimmte Anwendungen speichern gelegentlich Statusinformationen auf den Upstream-Servern, beispielsweise wenn ein Benutzer einen Artikel in einen virtuellen Warenkorb legt oder ein hochgeladenes Bild bearbeitet. In diesen Fällen empfiehlt es sich, alle nachfolgenden Anfragen dieses Benutzers an denselben Server weiterzuleiten.
Sitzungspersistenz legt fest, wohin eine Anfrage weitergeleitet werden muss, während NGINX beim Lastenausgleich den optimalen Upstream-Server frei auswählen kann. Beide Verfahren können mithilfe der Sitzungspersistenzfunktion von NGINX Plus parallel eingesetzt werden:
Wenn die Anfrage einer Regel für Sitzungspersistenz entspricht
dann den vorgesehenen Upstream-Server verwenden
andernfalls den Upstream-Server mithilfe des Lastverteilungsalgorithmus auswählen
Wenn die Entscheidung zur Sitzungspersistenz fehlschlägt, weil der Zielserver nicht verfügbar ist, trifft NGINX Plus eine Lastverteilungsentscheidung.
Die einfachste Methode für Sitzungspersistenz ist der Ansatz mit einem „Sticky Cookie“. Dabei fügt NGINX Plus in die erste Antwort ein Cookie ein, das den für die Sitzung festgelegten Upstream-Server identifiziert:
sticky cookie srv_id expires=1h domain=.example.com path=/;Bei der alternativen „Sticky-Route“-Methode wählt NGINX den Upstream-Server anhand von Anfrageparametern wie dem JSESSIONID-Cookie aus:
upstream backend {
   server backend1.example.com route=a;
   server backend2.example.com route=b;

    # select first non-empty variable; it should contain either 'a' or 'b'
    sticky route $route_cookie $route_uri;
}
Weitere Informationen finden Sie im NGINX Plus-Administratorhandbuch.
HTTP-Weiterleitungen umschreiben
Schreiben Sie HTTP-Weiterleitungen um, wenn einige Weiterleitungen fehlerhaft sind, insbesondere wenn Sie feststellen, dass Sie vom Proxy zum tatsächlichen Upstream-Server weitergeleitet werden.
Wenn Sie Anfragen über einen Proxy an einen Upstream-Server weiterleiten, stellt der Server die Anwendung unter einer lokalen Adresse bereit, Sie greifen jedoch über eine andere Adresse auf die Anwendung zu – die Adresse des Proxys. Diese Adressen werden in der Regel in Domänennamen aufgelöst, und es können Probleme auftreten, wenn der Server und der Proxy unterschiedliche Domänen verwenden.
In einer Testumgebung greifen Sie beispielsweise möglicherweise direkt (über die IP-Adresse) oder als localhost auf Ihren Proxy zu. Der Upstream-Server lauscht jedoch möglicherweise unter einem echten Domainnamen (z. B. www.nginx.com). Wenn der Upstream-Server eine Weiterleitung ausgibt (mit einem 3xx-Status und einem Location-Header oder mit einem Refresh-Header), enthält diese möglicherweise die tatsächliche Domain des Servers.
NGINX versucht, die häufigsten Fälle dieses Problems abzufangen und zu beheben. Wenn Sie die vollständige Kontrolle benötigen, um bestimmte Umschreibungen zu erzwingen, verwenden Sie die proxy_redirect-Direktive wie folgt:
proxy_redirect http://staging.mysite.com/ http://$host/;HTTP-Antworten umschreiben
Manchmal müssen Sie den Inhalt einer HTTP-Antwort umschreiben. Vielleicht enthält die Antwort, wie im obigen Beispiel, absolute Links, die auf einen anderen Server als den Proxy verweisen.
Mit der Direktive „sub_filter“ können Sie die anzuwendende Umschreibung definieren:
sub_filter /blog/ /blog-staging/;
sub_filter_once off;
Ein sehr häufiger Fallstrick ist die Verwendung der HTTP-Komprimierung. Wenn der Client signalisiert, dass er komprimierte Daten akzeptieren kann, und der Server daraufhin die Antwort komprimiert, kann NGINX die Antwort nicht untersuchen und ändern. Die einfachste Maßnahme besteht darin, den Header Accept-Encoding aus der Anfrage des Clients zu entfernen, indem er auf eine leere Zeichenfolge ("") gesetzt wird:
proxy_set_header Accept-Encoding "";Ein vollständiges Beispiel
Hier ist eine Vorlage für eine Load-Balancing-Konfiguration, die alle in diesem Artikel erläuterten Techniken nutzt. Die erweiterten Funktionen von NGINX Plus sind orange hervorgehoben.
[Redaktion – Die folgende Konfiguration wurde aktualisiert und verwendet nun die NGINX Plus API zur Live-Aktivitätsüberwachung und dynamischen Konfiguration von Upstream-Gruppen. Sie ersetzt damit die ursprünglich verwendeten separaten Module.]
server {
    listen 80;

    location / {
        proxy_pass http://backend;

        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Accept-Encoding "";
        proxy_redirect http://staging.example.com/ http://$host/;

        # Rewrite the Host header to the value in the client request
        proxy_set_header Host $host;

        # Replace any references inline to staging.example.com
        sub_filter http://staging.example.com/ /;
        sub_filter_once off;
    }

    location /internal-health-check1 {
        internal; # Prevent external requests from matching this location block
        proxy_pass http://backend;
        health_check interval=2s fails=1 passes=5 uri=/test.php match=statusok;
        # Explicitly set request parameters; don't use runtime variables
        proxy_set_header Host www.example.com;
    }

upstream backend {
    zone backend 64k; # Use NGINX Plus' shared memory
    least_conn;
    keepalive 20;

    # Apply session persistence for this upstream group
    sticky cookie srv_id expires=1h domain=.example.com path=/servlet;

    server webserver1 weight=1;
    server webserver2 weight=4;
}

match statusok {
    # Used for /test.php health check
    status 200;
    header Content-Type = text/html;
    body ~ "Server[0-9]+ is alive";
}

server {
    listen 8080;
    root /usr/share/nginx/html;

    location = /api {
        api write=on; # Live activity monitoring and
                      # dynamic configuration of upstream groups

        allow 127.0.0.1; # permit access from localhost
        deny all;        # deny access from everywhere else
    }
}
Testen Sie selbst all die großartigen Lastverteilungsfunktionen von NGINX Plus – starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.