Wir haben Version 3.0 des NGINX Ingress Controller im Januar 2023 mit zahlreichen wichtigen neuen Funktionen und erweiterten Leistungsmerkmalen veröffentlicht. Eine neue Funktion, die für Sie besonders wertvoll sein dürfte, ist Deep Service Insight, das in der NGINX Plus-Edition des NGINX Ingress Controller verfügbar ist.
Deep Service Insight behebt eine Einschränkung, die den optimalen Betrieb beeinträchtigt, wenn ein System für Routing-Entscheidungen, beispielsweise ein Load Balancer, einem oder mehreren Kubernetes-Clustern vorgeschaltet ist: Das System hat keinen Zugriff auf Informationen zum Zustand der einzelnen Dienste, die in den Clustern hinter dem Ingress Controller ausgeführt werden. Daher kann es den Datenverkehr nicht ausschließlich an Cluster mit fehlerfrei funktionierenden Diensten weiterleiten, wodurch Ihre Benutzer möglicherweise von Ausfällen und Fehlern wie 404 und 500 betroffen sind.
Deep Service Insight behebt dieses Problem, indem es den Integritätsstatus der Pods des Backend-Dienstes (wie vom NGINX Ingress Controller erfasst) an einem dedizierten Endpunkt bereitstellt, über den Ihre Systeme darauf zugreifen und ihn für bessere Routing-Entscheidungen nutzen können.
In diesem Beitrag befassen wir uns eingehend mit dem Problem, das Deep Service Insight löst, erklären die Funktionsweise anhand einiger gängiger Anwendungsfälle und zeigen, wie es konfiguriert wird.
Warum Deep Service Insight?
Die standardmäßigen Kubernetes-Probes für Liveness, Readiness und Startup liefern Ihnen einige Informationen über die in Ihren Clustern ausgeführten Backend-Services. Diese reichen jedoch nicht aus, um die nötigen Einblicke zu gewinnen und über Ihren gesamten Stack hinweg bessere Routing-Entscheidungen zu treffen. Fehlende Informationen werden umso problematischer, je komplexer Ihre Kubernetes-Bereitstellungen werden und je dringlicher Ihre geschäftlichen Anforderungen an eine unterbrechungsfreie Verfügbarkeit sind.
Ein gängiger Ansatz zur Verbesserung der Verfügbarkeit bei der Skalierung Ihrer Kubernetes-Umgebung besteht darin, Ihren Clustern Load Balancer, DNS-Manager und andere automatisierte Entscheidungssysteme vorzuschalten. Aufgrund der Funktionsweise von Ingress-Controllern hat ein Load Balancer vor einem Kubernetes-Cluster jedoch normalerweise keinen Zugriff auf Statusinformationen zu den Diensten hinter dem Ingress-Controller im Cluster – er kann lediglich überprüfen, ob die Pods des Ingress-Controllers selbst fehlerfrei sind und Datenverkehr annehmen.
NGINX Ingress Controller hingegen verfügt über Informationen zum Zustand der Services. Er überwacht bereits den Zustand der Upstream-Pods in einem Cluster, indem er regelmäßig passive Zustandsprüfungen für HTTP-, TCP-, UDP- und gRPC-Services durchführt, die Reaktionsfähigkeit auf Anfragen überwacht und erfolgreiche Antwortcodes sowie weitere Metriken erfasst. Anhand dieser Informationen entscheidet er, wie der Datenverkehr auf die Pods Ihrer Services verteilt wird, um eine konsistente und vorhersehbare Benutzererfahrung zu gewährleisten. Normalerweise vollbringt NGINX Ingress Controller all diese Magie unbemerkt im Hintergrund, sodass Sie sich möglicherweise nie Gedanken darüber machen, was unter der Haube geschieht. Deep Service Insight macht diese wertvollen Informationen sichtbar, damit Sie sie auf anderen Ebenen Ihres Stacks effektiver nutzen können.
Wie funktioniert Deep Service Insight?
Deep Service Insight ist für Dienste verfügbar, die Sie mit den benutzerdefinierten NGINX-Ressourcen VirtualServer und TransportServer bereitstellen (für HTTP bzw. TCP/UDP). Deep Service Insight verwendet die NGINX Plus API zur Bereitstellung der Ansicht des NGINX Ingress Controllers auf die einzelnen Pods in einem Backend-Dienst über einen dedizierten, ausschließlich für Deep Service Insight vorgesehenen Endpunkt:
- Für VirtualServer – <IP_address> :<port> /probe/<hostname>
- Für TransportServer – <IP_address> :<port> /probe/ts/<service_name>
wobei
- <IP_address> gehört zum NGINX Ingress Controller
- <port> ist die Portnummer von Deep Service Insight (standardmäßig 9114)
- <hostname> ist der Domänenname des Dienstes, wie im Feld
spec.hostder VirtualServer-Ressource definiert - <service_name> ist der Name des Dienstes, wie im Feld
spec.upstreams.serviceder TransportServer-Ressource definiert
Die Ausgabe enthält zwei Arten von Informationen:
- Ein HTTP-Statuscode für den Hostnamen oder Dienstnamen:
200OK– Mindestens ein Pod ist fehlerfrei418Ich bineineTeekanne– Keine Pods sind fehlerfrei404Nichtgefunden– Es gibt keine Pods, die dem angegebenen Hostnamen oder Dienstnamen entsprechen
- Drei Zähler für den angegebenen Hostnamen oder Dienstnamen:
Gesamtzahlder Dienstinstanzen (Pods)- Anzahl der Pods im Zustand „
Up“ (fehlerfrei) - Anzahl der Pods im Zustand „
Fehlerhaft“
Hier ist ein Beispiel, bei dem alle drei Pods eines Dienstes fehlerfrei sind:
HTTP/1.1 200 OKContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}
Weitere Informationen finden Sie in der Dokumentation zum NGINX Ingress Controller.
Sie können die Kriterien, anhand derer der NGINX Ingress Controller entscheidet, ob ein Pod fehlerfrei ist, durch die Konfiguration aktiver Integritätsprüfungen weiter anpassen. Sie können unter anderem den Pfad und Port, an den die Integritätsprüfung gesendet wird, die Anzahl der fehlgeschlagenen Prüfungen, die innerhalb eines bestimmten Zeitraums auftreten müssen, damit ein Pod als fehlerhaft gilt, den erwarteten Statuscode sowie Zeitüberschreitungen beim Verbindungsaufbau oder beim Empfang einer Antwort konfigurieren. Fügen Sie das Feld „Upstream.Healthcheck“ in die Ressource „VirtualServer“ oder „TransportServer“ ein.
Beispielanwendungsfälle für detaillierte Service-Einblicke
Ein Anwendungsfall, in dem Deep Service Insight besonders wertvoll ist, liegt vor, wenn ein Load Balancer den Datenverkehr an einen Dienst weiterleitet, der beispielsweise zur Gewährleistung einer hohen Verfügbarkeit in zwei Clustern ausgeführt wird. Innerhalb jedes Clusters überwacht der NGINX Ingress Controller wie oben beschrieben den Zustand der Upstream-Pods. Wenn Sie Deep Service Insight aktivieren, werden Informationen zur Anzahl der fehlerfreien und fehlerhaften Upstream-Pods zusätzlich über einen dedizierten Endpunkt bereitgestellt. Ihr System für Routing-Entscheidungen kann auf diesen Endpunkt zugreifen und anhand dieser Informationen den Anwendungsdatenverkehr von fehlerhaften Pods auf fehlerfreie Pods umleiten.
Das Diagramm veranschaulicht, wie Deep Service Insight in diesem Szenario funktioniert.
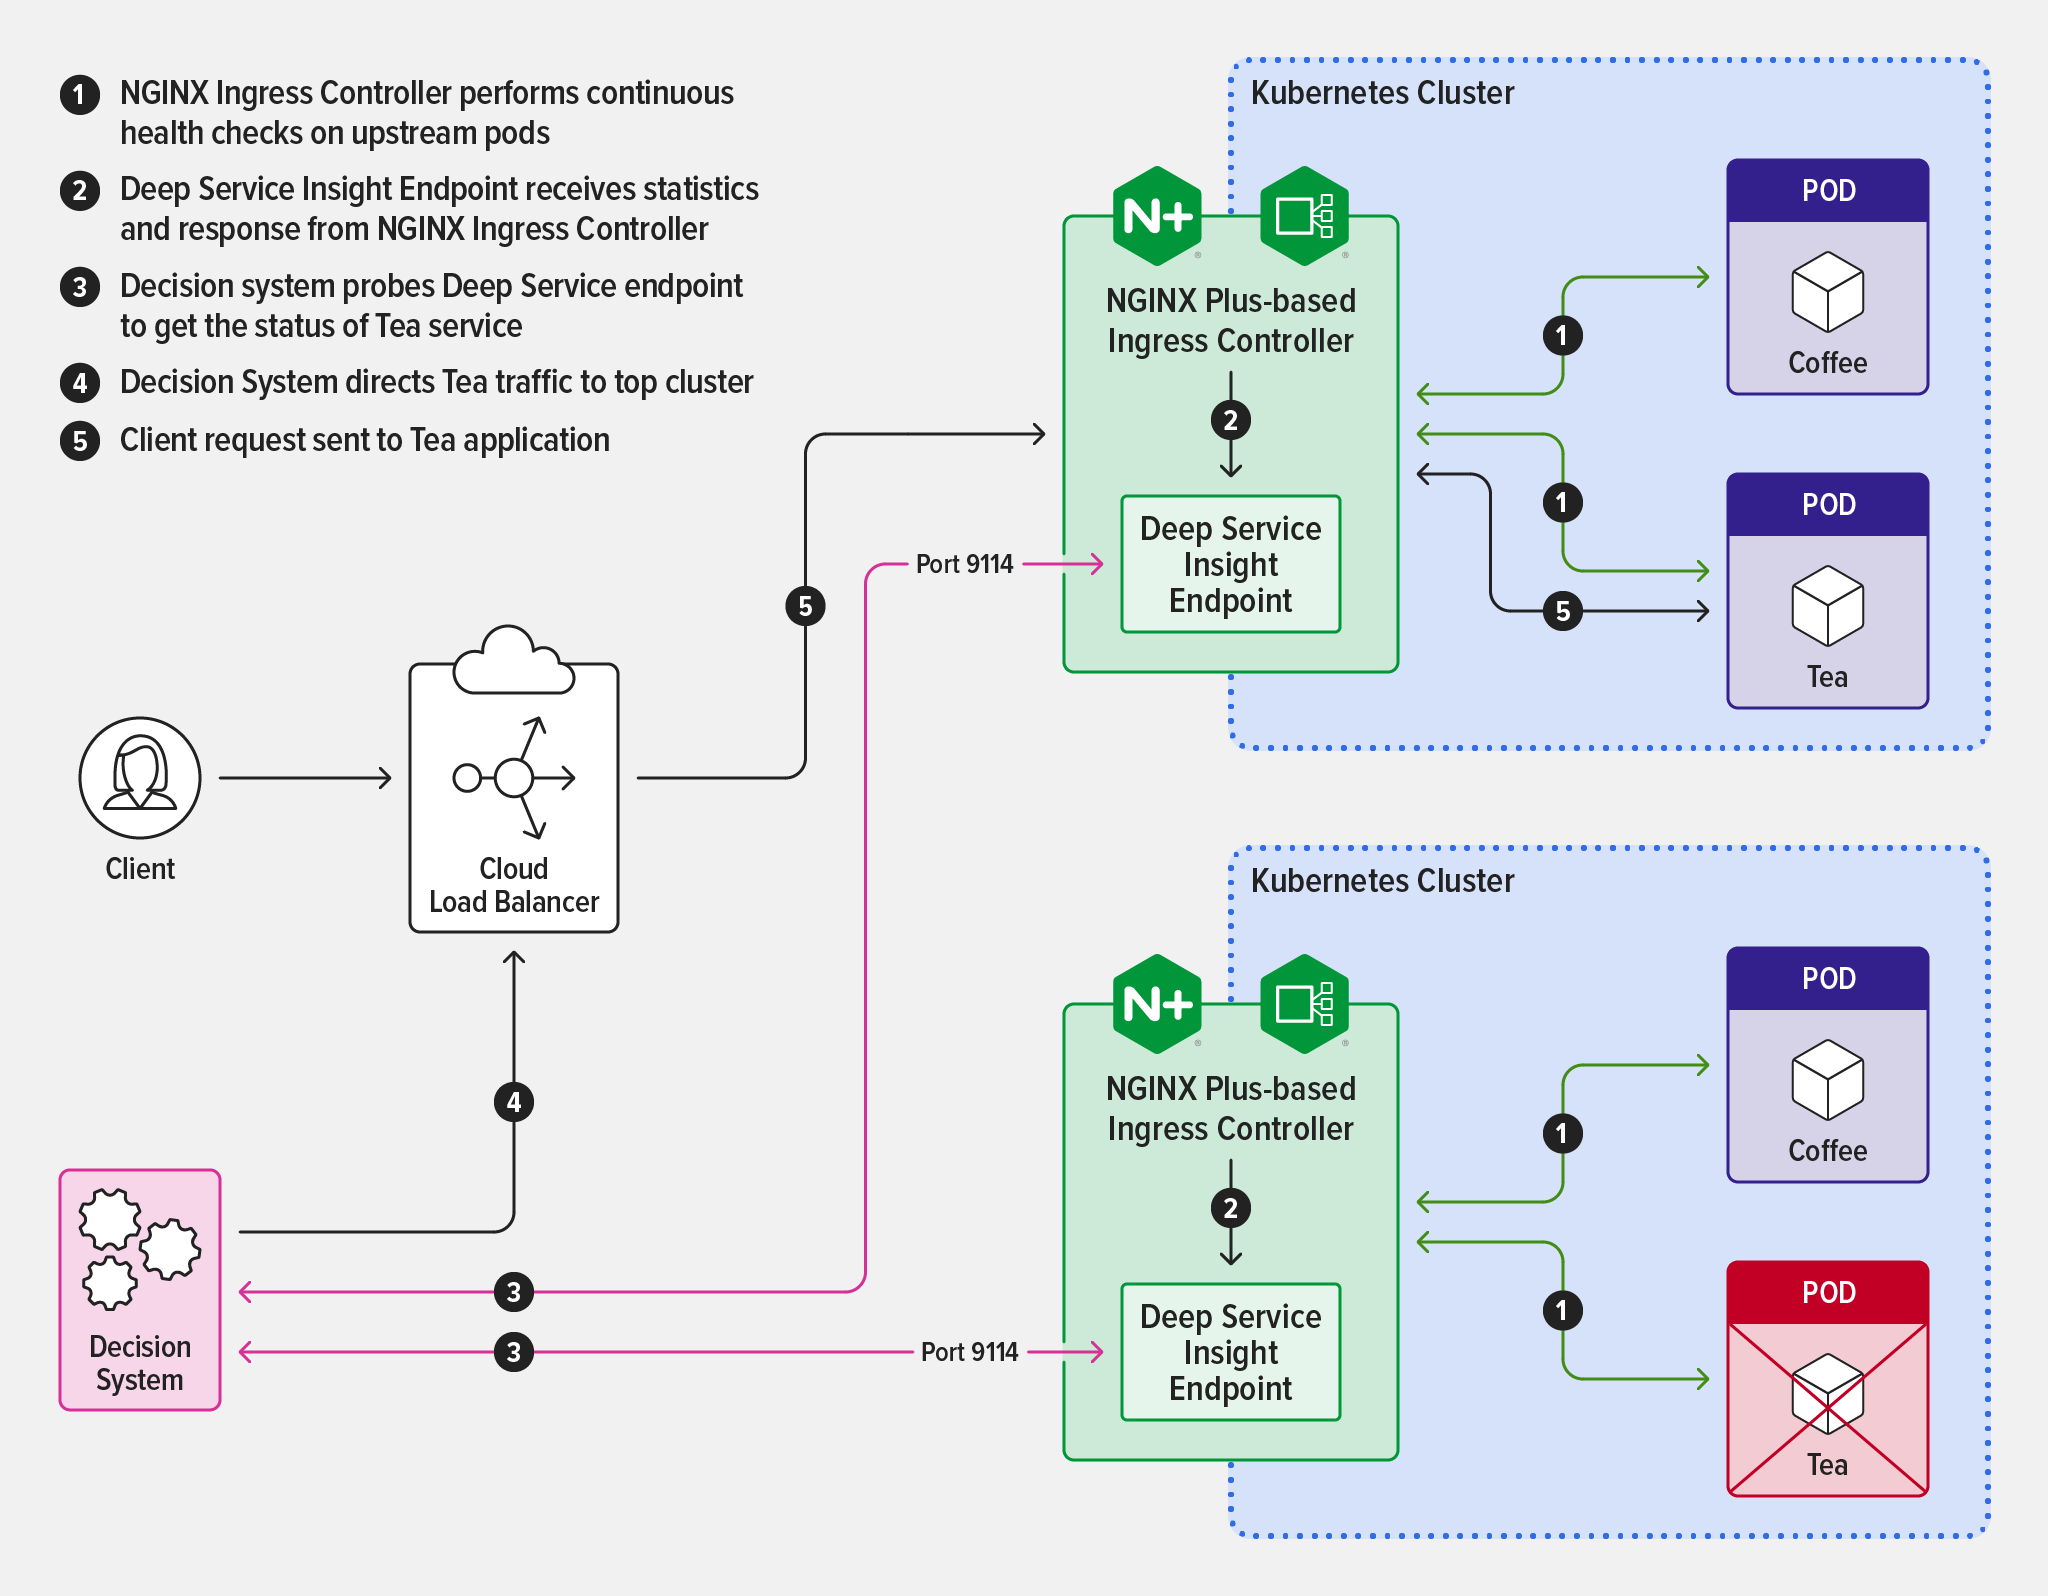
Sie können Deep Service Insight auch nutzen, wenn Sie in einem Hochverfügbarkeitsszenario Wartungsarbeiten an einem Cluster durchführen. Skalieren Sie dazu einfach die Anzahl der Pods für einen Dienst in dem Cluster, in dem Sie die Wartungsarbeiten durchführen, auf null. Das Fehlen funktionsfähiger Pods wird automatisch am Deep Service Insight-Endpunkt angezeigt. Ihr System für Routing-Entscheidungen nutzt diese Information, um den Datenverkehr an die funktionsfähigen Pods im anderen Cluster weiterzuleiten. So erhalten Sie praktisch ein automatisches Failover, ohne die Konfiguration des NGINX Ingress Controllers oder des Systems ändern zu müssen, und Ihre Kunden erleben keinerlei Dienstunterbrechung.
Deep Service Insight aktivieren
Um Deep Service Insight zu aktivieren, fügen Sie das Befehlszeilenargument „-enable-service-insight“ in das Kubernetes-Manifest ein oder setzen Sie den Parameter „serviceInsight.create“ auf „true“, wenn Sie Helm verwenden.
Es gibt zwei optionale Argumente, mit denen Sie den Endpunkt an Ihre Umgebung anpassen können:
-service-insight-listen-port<port>– Ändert die Portnummer von Deep Service Insight vom Standardwert 9114 (<port>ist eine Ganzzahl im Bereich 1024–65535). Die entsprechende Helm-Option ist der ParameterserviceInsight.port.-service-insight-tls-string<secret>– Ein Kubernetes-Secret (TLS-Zertifikat und -Schlüssel) für die TLS-Terminierung des Deep Service Insight-Endpunkts (<secret>ist eine Zeichenfolge im Format<namespace>/<secret_name>). Das Helm-Äquivalent ist der ParameterserviceInsight.secret.
Beispiel: Deep Service Insight für die Cafe-Anwendung aktivieren
Um Deep Service Insight in Aktion zu sehen, können Sie es für die Cafe-Anwendung aktivieren, die in der Dokumentation zum NGINX Ingress Controller häufig als Beispiel verwendet wird.
- Installieren Sie die NGINX Plus-Edition von NGINX Ingress Controller mit Unterstützung für benutzerdefinierte NGINX-Ressourcen und aktivieren Sie Deep Service Insight:
- Wenn Sie Helm verwenden, setzen Sie den Parameter
serviceInsight.createauftrue. - Wenn Sie ein Kubernetes-Manifest (Deployment oder DaemonSet) verwenden, fügen Sie das Argument
-enable-service-insightin die Manifestdatei ein.
- Wenn Sie Helm verwenden, setzen Sie den Parameter
- Überprüfen Sie, ob der NGINX Ingress Controller ausgeführt wird:
$ kubectl get pods -n nginx-ingressNAME                                          READY ...
ingress-plus-nginx-ingress-6db8dc5c6d-cb5hp   1/1   ...

    ...  STATUS   RESTARTS   AGE
... Running 0 9d- Stellen Sie die Cafe-Anwendung gemäß den Anweisungen in der README-Datei bereit.
- Überprüfen Sie, ob die benutzerdefinierte NGINX-VirtualServer-Ressource für die Cafe-Anwendung bereitgestellt wurde (die IP-Adresse wurde zur besseren Lesbarkeit weggelassen):
$ kubectl get vs NAME   STATE   HOST               IP    PORTS      AGE
cafe Valid cafe.example.com ... [80,443] 7h1m- Überprüfen Sie, ob drei Upstream-Pods für den Cafe-Dienst unter „cafe.example.com“ ausgeführt werden:
$ kubectl get pods NAME                     READY   STATUS    RESTARTS   AGE
coffee-87cf76b96-5b85h   1/1     Running   0          7h39m
coffee-87cf76b96-lqjrp   1/1     Running   0          7h39m
tea-55bc9d5586-9z26v 1/1 Running 0 111m- Greifen Sie auf den Deep Service Insight-Endpunkt zu:
$ curl -i <NIC_IP_address>:9114/probe/cafe.example.com- Der Antwortcode
200OKzeigt an, dass der Dienst bereit ist, Datenverkehr anzunehmen (mindestens ein Pod ist fehlerfrei). In diesem Fall befinden sich alle drei Pods im Status „Up“.
HTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}- Der Statuscode
418I’mateapotzeigt an, dass der Dienst nicht verfügbar ist (alle Pods sind fehlerhaft).
HTTP/1.1 418 I'm a teapotContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":0,"Unhealthy":3}- Der Statuscode
404NotFoundgibt an, dass unter dem angegebenen Hostnamen kein Dienst ausgeführt wird.
HTTP/1.1 404 Not FoundDate: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 0
Ressourcen
Das vollständige Änderungsprotokoll für NGINX Ingress Controller Version 3.0.0 finden Sie in den Versionshinweisen.
Wenn Sie NGINX Ingress Controller mit NGINX Plus und NGINX App Protect testen möchten, starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.