Der Markt für API-Management (APIM) ist hart umkämpft. Der aktuelle Gartner Magic Quadrant for Full Life Cycle API Management führt 22 Anbieter auf, davon 7 im Leaders-Quadranten. Wer in einem bestehenden Markt konkurriert, muss sich klar positionieren, um sich vom Wettbewerb abzuheben. Was also unterscheidet die API-Management-Lösung von NGINX von anderen Lösungen?
Unser Ziel bei NGINX ist es, schlanke, leistungsstarke Software zu entwickeln. NGINX Open Source hat sich zum bevorzugten Webserver für die meistbesuchten Websites der Welt entwickelt, da seine ereignisgesteuerte Architektur besser skaliert als Webserver, die für jede Verbindung einen eigenen Prozess oder Thread erzeugen. NGINX Open Source ist außerdem das am weitesten verbreitete API-Gateway der Branche – eine Infrastrukturkomponente, die den API-Datenverkehr in APIM-Lösungen verarbeitet, etwa in denen von Apigee, Axway, IBM DataPower, Kong, Red Hat 3scale und Torry Harris.
Das NGINX Controller API Management Module ist eine leistungsstarke APIM-Lösung. In diesem Blog vergleichen wir seine Leistung mit der von Kong, einem für seine hohe Leistung bekannten Wettbewerber. Kong basiert auf NGINX und nutzt Lua zur Implementierung seiner API-Funktionen, während das API Management Module vollständig auf nativen Hochleistungsfunktionen beruht, die als NGINX Plus-Module implementiert sind. Die API-Management-Lösung von NGINX basiert auf einer innovativen Architektur, die Daten- und Steuerungsebene voneinander entkoppelt. Alle API-Aufrufe werden direkt von NGINX Plus verarbeitet, das als API-Gateway (Datenebene) fungiert, ohne dass eine Interaktion mit der Steuerungsebene erforderlich ist. Dies ermöglicht eine leistungsstarke Vermittlung des API-Datenverkehrs sowohl für den Nord-Süd- als auch für den Ost-West-Datenverkehr.
Ein kleiner Vorgeschmack auf die Ergebnisse: Das NGINX Controller API Management Module ist doppelt so leistungsfähig wie Kong.
Ein besonderer Dank gilt Intel für die Bereitstellung der Hardware und der Laborräume, die für diese Tests genutzt wurden. Ausführliche Informationen zu den Tests und zur Hardware finden Sie im Anhang.
Zusätzliche Latenz bei einer einzelnen Anfrage
In diesem Test haben wir die zusätzliche Latenz verglichen, die der API-Manager bei einer einzelnen Anfrage für Dateien mit einer Größe von 0 KB und 1 KB verursacht. Wir haben curl verwendet, um die einzelne HTTP-Anfrage zu senden (Details).
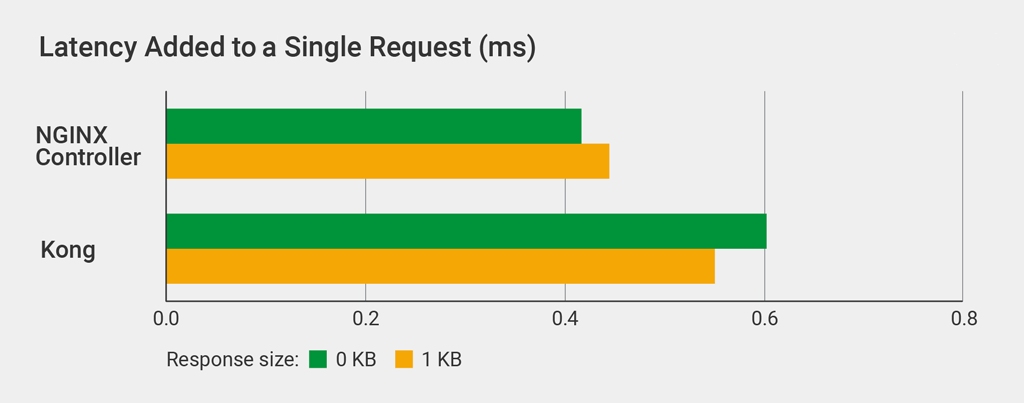
Kong erhöht die Latenz im Vergleich zum API Management Module: bei einer 0-KB-Datei um 44 % und bei einer 1-KB-Datei um 24 %.
API-Aufrufe pro Sekunde
Eine gängige Kennzahl für die Skalierbarkeit von HTTP ist die Anzahl der Anfragen pro Sekunde (Requests per Second, RPS). Die entsprechende Kennzahl im Kontext von APIM ist die Anzahl der API-Aufrufe pro Sekunde. Wir haben wrk verwendet, um über 300 Verbindungen drei Minuten lang kontinuierlich Anfragen für eine 0-KB- oder 1-KB-Datei zu senden (Details).
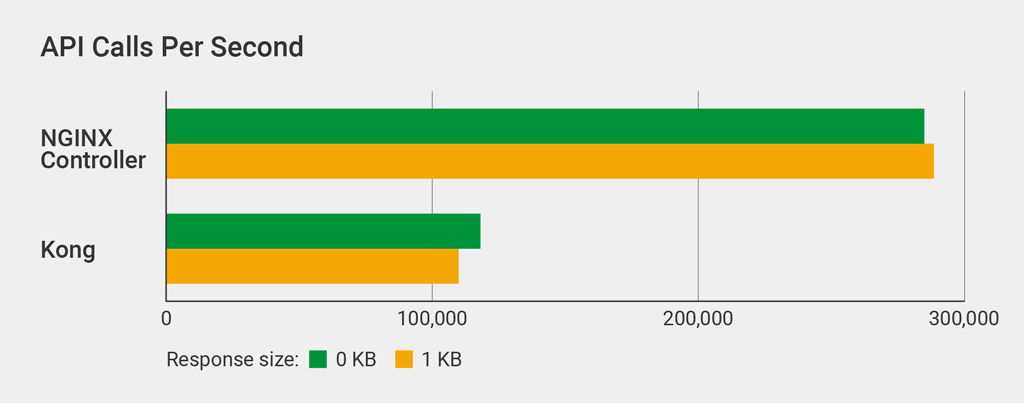
Das API-Management-Modul übertraf Kong und verarbeitete bei 1-KB-Antworten 2,6-mal so viele API-Aufrufe pro Sekunde.
CPU-Auslastung
Das API-Management-Modul verursacht eine geringere Latenz und verarbeitet mehr API-Aufrufe pro Sekunde als Kong, da es die CPU effizienter nutzt. Wir haben die CPU-Auslastung bei einer steigenden Anzahl von API-Aufrufen pro Sekunde gemessen. Dabei haben wir nur einen Kern verwendet, weshalb die absolute Anzahl der API-Aufrufe pro Sekunde deutlich niedriger ist als im vorherigen Test, bei dem wir 22 Kerne verwendet haben (Details).
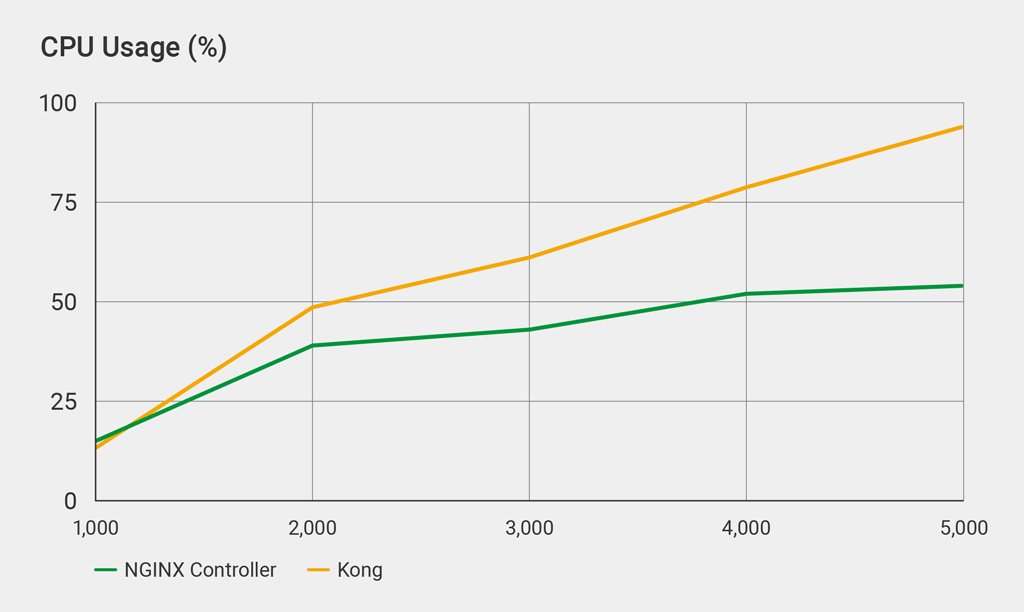
Kong erreicht bei 5.000 API-Aufrufen pro Sekunde faktisch seine Obergrenze – bei einem höheren Aufrufvolumen steigt die Latenz deutlich an, was darauf hindeutet, dass das System vollständig ausgelastet ist. Bei 5.000 Aufrufen pro Sekunde liegt die CPU-Auslastung bei 93 % und damit 73 % höher als beim API Management Module.
API-Aufrufe pro Sekunde mit JWTs
Der abschließende Test misst, wie gut die einzelnen API-Gateways JSON Web Tokens (JWTs) validieren – die bevorzugte Methode zur Authentifizierung von API-Anfragen. Da Ihre wichtigsten API-Endpunkte wahrscheinlich eine Authentifizierung erfordern, bildet dieser Test eine reale Konfiguration besser ab.
Wir haben für beide Gateways dasselbe mit HS256 signierte JWT verwendet (Details).
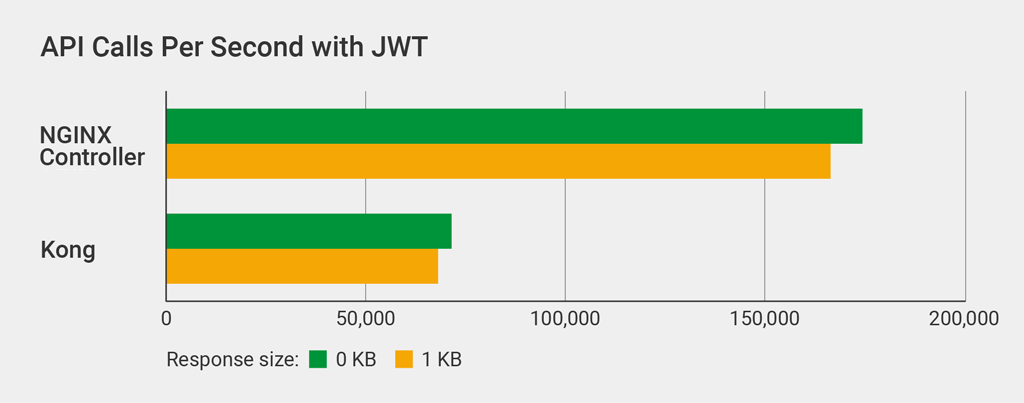
Das API-Management-Modul verarbeitet pro Sekunde mehr als doppelt so viele JWT-authentifizierte API-Aufrufe wie Kong.
So funktioniert NGINX Controller
NGINX Controller ist eine Control-Plane-Lösung zur Verwaltung der NGINX Plus-Datenebene. Mit NGINX Controller können Sie den gesamten Lebenszyklus von NGINX Plus verwalten – als Load Balancer, API-Gateway oder Proxy in einer Service-Mesh-Umgebung. Mit dem API Management Module von NGINX Controller können Sie APIs definieren, veröffentlichen, absichern, überwachen und analysieren.
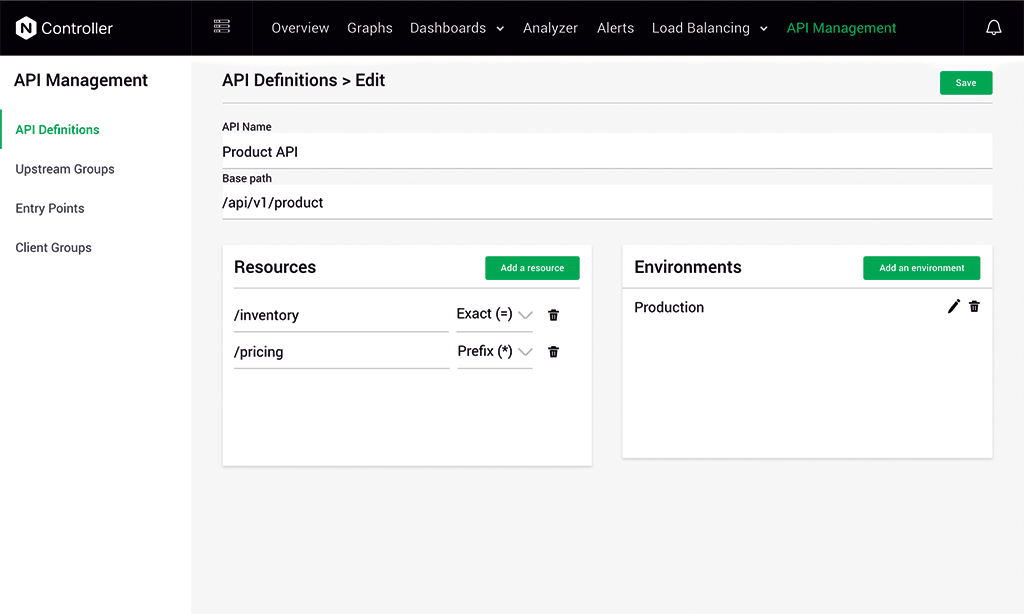
Im Hintergrund generiert NGINX Controller eine NGINX Plus-Konfiguration, die auf der zugrunde liegenden NGINX Plus-Datenebene veröffentlicht wird. Das zentrale Konfigurationsladeprogramm verfügt über einen äußerst effizienten Mechanismus zum Speichern von Konfigurationen im Arbeitsspeicher, sodass das API Management Module eine hohe Leistung für APIs bereitstellen kann.
Fazit
Viele Unternehmen nutzen NGINX Open Source bereits als API-Gateway. Capital One konnte auf über 12 Milliarden API-Aufrufe pro Tag skalieren und setzt dabei NGINX Open Source ein. Tatsächlich verwenden viele unserer Wettbewerber, darunter Kong, NGINX Open Source als technische Grundlage für ihre APIM-Lösungen. Dank unseres schlanken Designs – basierend auf nativer, leistungsstarker NGINX-Konfiguration in Verbindung mit NGINX Plus-Modulen – lässt sich das API Management Module besser skalieren als die von NGINX abgeleiteten Lösungen der Konkurrenz.
Die Latenz ist eine der wichtigsten Kennzahlen für das Benutzererlebnis. Eine hohe Latenz beeinträchtigt die Reaktionsfähigkeit von Anwendungen und frustriert die Benutzer. Das API Management Module verursacht bei Benutzeranfragen eine um 20–30 % geringere zusätzliche Latenz als Kong. Zudem nutzt es Systemressourcen effizienter und benötigt bei gleicher Arbeitslast 40 % weniger CPU-Leistung als Kong.
Anhang
Topologie
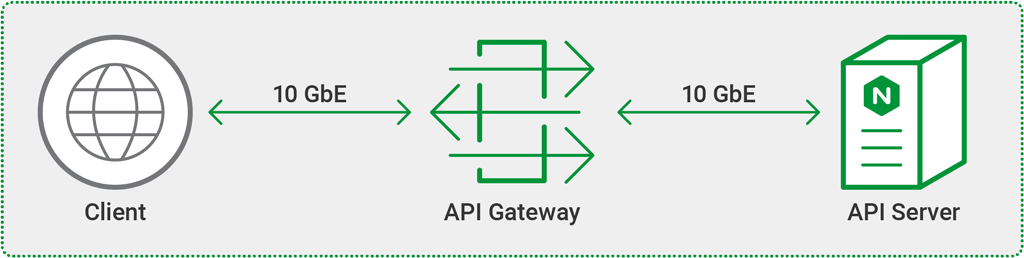
Alle Tests wurden mit drei separaten Rechnern durchgeführt, die über 10-GbE-Verbindungen in einem einfachen, flachen Layer-2-Netzwerk miteinander verbunden waren.
Verwendete Hardware
Für die Tests wurde die folgende Hardware verwendet. Alle drei Rechner waren identisch. Hyper-Threading wurde nicht verwendet. Bei früheren Tests konnten wir durch Hyper-Threading keinen wesentlichen Leistungsunterschied feststellen.
| CPU | Netzwerk | Arbeitsspeicher |
|---|---|---|
| Intel® Xeon(R) CPU E5‑2699 v4 @ 2,20 GHz, 22 Kerne | Intel Ethernet Controller 10‑Gigabit X540‑AT2 | 128 GB |
Verwendete Software
Für die Tests wurde die folgende Software verwendet:
- NGINX Controller API Management Module Version 2.
- Kong Open Source Version 1.0.0. Wir haben Kong Enterprise nicht getestet, aber keine der zusätzlichen Funktionen ist für unsere Tests relevant (beispielsweise verwenden Kong Open Source und Kong Enterprise dasselbe JWT-Plug-in).
curlVersion 7.61.0.- Docker-Version 18.09.1. Um die Verwaltung zu vereinfachen, haben wir sowohl Kong als auch das API-Management-Modul in Docker-Containern ausgeführt. Wir haben festgestellt, dass Docker die Leistung um etwa 30 % reduziert. Da wir jedoch die relative Leistung vergleichen, überwogen die Vorteile der Verwendung von Docker die Leistungseinbußen.
mpstatin Version 12.0.1 dessystat-Pakets.wrkVersion 4.1.0, installiert gemäß dieser Anleitung.
NGINX-Konfiguration
Für die Tests wurde die folgende NGINX-Konfiguration verwendet.
upstream my_upstream { keepalive 60; server API-server:80; keepalive_requests 3000000; keepalive_timeout 300;}server { listen 8000; access_log off; keepalive_requests 3000000; keepalive_timeout 300; tcp_nodelay on; location /test { set $apimgmt_environment 4; set $apimgmt_definition 3; set $upstream my_upstream; set $upstream_protocol http; rewrite ^ /_devel_4 last; } location = /_devel_4 { internal; set $apimgmt_definition_name my_api; set $apimgmt_environment_name devel; proxy_intercept_errors on; proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass $upstream_protocol://$upstream/0kb; # 0-KB file #proxy_pass $upstream_protocol://$upstream/1kb.bin; # 1-KB file }}Wir haben die folgenden Einstellungen vorgenommen, um die Leistung zu maximieren. Wie im nächsten Abschnitt beschrieben, haben wir ähnliche Einstellungen in der Kong-Konfiguration vorgenommen.
keepalive_requestsundkeepalive_timeoutwurden auf einen hohen Wert gesetzt, um den Aufwand für den Aufbau von TCP-Verbindungen zu minimieren.tcp_nodelaywurde aktiviert, wodurch sich die Leistung durch die Deaktivierung des Nagle-Algorithmus leicht verbesserte.access_logwurde deaktiviert. Die Aktivierung verringert die Leistung um etwa 10 %.- Wir haben die beiden
proxy_pass-Direktiven verwendet, um die Datei in der entsprechenden Größe anzufordern.
Kong-Konfiguration
Wir haben die folgenden Konfigurationsanweisungen zu „kong.conf.default“ hinzugefügt, die den im vorherigen Abschnitt erläuterten Einstellungen der NGINX-Konfiguration entsprechen.
nginx_http_tcp_nodelay=onnginx_http_keepalive_requests=3000000nginx_http_keepalive_timeout=300proxy_access_log=offWir haben die folgenden Kong-API-Aufrufe ausgeführt, um eine Route zum API-Server zu erstellen. Der erste Befehl erstellt einen Dienst namens test, und der zweite erstellt die Route /test zum Server.
$ curl -X POST http://localhost:8001/services/ --data 'name=test' --data 'url=http://API-server:80/0kb'$ curl -X POST http://localhost:8001/services/test/routes --data 'paths[]=/test'Die folgenden Befehle zeigen die Konfiguration des Dienstes beziehungsweise der Route an. Wir leiten die Ausgabe an das Tool „jq“ weiter, damit die JSON-Ausgabe leichter lesbar ist.
$ curl localhost:8001/services/ | jq '.'{ "next": null, "data": [ { "host": "172.20.40.32", "created_at": 1556770191, "connect_timeout": 60000, "id": "f4629d56-550b-4b37-aa59-66d931aa6f37", "protocol": "http", "name": "test", "read_timeout": 60000, "port": 80, "path": "/0kb", "updated_at": 1556770191, "retries": 5, "write_timeout": 60000 } ]}$ curl localhost:8001/services/test/routes | jq '.'{ "next": null, "data": [ { "created_at": 1556770191, "methods": null, "id": "a7b417af-ccd4-48f7-b787-ae19490194dc", "service": { "id": "f4629d56-550b-4b37-aa59-66d931aa6f37" }, "name": null, "hosts": null, "updated_at": 1556770191, "preserve_host": false, "regex_priority": 0, "paths": [ "/test" ], "sources": null, "destinations": null, "snis": null, "protocols": [ "http", "https" ], "strip_path": true } ]}Testmethodik
Zusätzliche Latenz bei einer einzelnen Anfrage
Wir verwendeten curl für die Latenztests mit einzelnen Anfragen. Um einen Ausgangswert zu ermitteln, sendeten wir zunächst eine Anfrage an den API-Server, ohne dass ein API-Gateway vorgeschaltet war. Anschließend sendeten wir dieselbe Anfrage mit jedem der API-Gateways vor dem API-Server, um die jeweils zusätzlich verursachte Latenz zu messen.
$ curl -w "@curl-latency.txt" -o /dev/null -s http://target-serverDer Inhalt von curl-latency.txt:
time_namelookup: %{time_namelookup}n time_connect: %{time_connect}n time_appconnect: %{time_appconnect}n time_pretransfer: %{time_pretransfer}n time_redirect: %{time_redirect}n time_starttransfer: %{time_starttransfer}n ----------n time_total: %{time_total}nDas Diagramm unter „Zusätzliche Latenz bei einer einzelnen Anfrage“ zeigt time_total in Millisekunden. Hier ist eine Beispielausgabe:
$ curl -w "@curl-latency.txt" -o /dev/null -s http://192.0.2.1/api-endpoint time_namelookup: 0.000035 time_connect: 0.000364 time_appconnect: 0.000000 time_pretransfer: 0.000401 time_redirect: 0.000000 time_starttransfer: 0.001701 ---------- time_total: 0.001727API-Aufrufe pro Sekunde
Wir haben die API-Aufrufe pro Sekunde mit wrk, einem skalierbaren Benchmarking-Tool, das wir häufig verwenden, getestet. Wir haben verschiedene Parameterkombinationen ausprobiert. Diese Kombination erzielte sowohl für das API Management Module als auch für Kong die beste Leistung:
$ wrk -t 22 -c 300 -d 180 http://target-serverDer Befehl erstellt 22 wrk-Threads (einen pro Kern) und insgesamt 300 Verbindungen, die auf die Threads verteilt sind. Der Parameter -d legt die Dauer des Tests fest, in unserem Fall 180 Sekunden (3 Minuten). Beispielausgabe:
$ wrk -t 22 -c 300 -d 180 http://192.0.2.1/api-endpointRunning 3m test @ http://192.0.2.1/api-endpoint 22 threads and 300 connections Thread Stats Avg Stdev Max +/- Stdev Latency 13.96ms 7.84ms 279.85ms 77.37% Req/Sec 0.96k 298.23 1.88k 68.55% 3769861 requests in 3.00m, 36.25GB readRequests/sec: 20934.34Transfer/sec: 206.16MBCPU-Auslastung
Wir haben die CPU-Auslastung mit mpstat (einem dafür vorgesehenen Standard-Linux-Tool) gemessen, während wir den Befehl wrk zur Ermittlung der API-Aufrufe pro Sekunde ausführten. Beispielausgabe (zur besseren Lesbarkeit auf zwei Zeilen verteilt):
$ mpstatLinux 4.18.0-13-generic (nbdw38) 04/29/2019 _x86_64_ (88 CPU)03:34:50 PM CPU %usr %nice %sys %iowait %irq %soft %steal ...03:34:50 PM all 0.04 0.00 0.02 0.00 0.00 0.03 0.00 ... ... %guest %gnice %idle ... 0.00 0.00 99.91API-Aufrufe pro Sekunde mit JWTs
Wir haben die JWT-Performance mit dem Befehl „wrk“ anhand der API-Aufrufe pro Sekunde getestet und zusätzlich den Parameter „-H“ verwendet, um das JWT in den HTTP-Header „Authorization: Bearer“ einzufügen. Wir haben das JWT und die JSON Web Keys (JWKs) gemäß der Anleitung in diesem Blogbeitrag generiert und das JWT in einer Datei namens „test.jwt“ gespeichert.
$ wrk -t 22 -c 300 -d 180 -H "Authorization: Bearer `cat test.jwt`" http://target-serverÜber den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.