Observability ist beim Betrieb cloudnativer Anwendungen von entscheidender Bedeutung, da deren Funktionalität aus dem Zusammenspiel zahlreicher, an verschiedenen Standorten ausgeführter Microservices entsteht. Aufgrund der losen Kopplung von Microservice-Anwendungen kann jeder Microservice seine Aktivitäten auf eigene Weise melden. Ohne ein Tool, das diese Telemetriedaten zusammenführt und korreliert, ist es äußerst schwierig – wenn nicht gar unmöglich –, die Verarbeitung einer Anfrage von Anfang bis Ende nachzuverfolgen. Genau das ist jedoch für die Fehlerbehebung unerlässlich.
Auf der Suche nach einem vielseitigen Observability-Tool entschied sich das Team hinter dem Projekt NGINX Modern Apps Reference Architecture (MARA) für OpenTelemetry. Da sich unser OSS-Team für dieses aufstrebende Projekt entschieden hat, möchten wir uns eingehender damit befassen. Auf der GlueCon 2022 traf ich mich mit Granville Schmidt, Architekt im Office of the CTO bei F5, um darüber zu sprechen, warum uns der aktuelle Stand und die künftigen Möglichkeiten von OpenTelemetry begeistern. Unten können Sie sich unser Gespräch ansehen und in diesem Blog mehr darüber erfahren, warum OpenTelemetry für die Cloud-native-Anwendungslandschaft so wertvoll ist.
OpenTelemetry treibt Observability 2.0 voran
OpenTelemetry wurde erstmals auf der KubeCon 2019 in Barcelona angekündigt und OpenTelemetry hat eine engagierte Gruppe von Mitwirkenden gewonnen. Gemessen an der Anzahl der Beiträge ist es das zweitbeliebteste Projekt der Cloud Native Computing Foundation (CNCF), und in den vergangenen sechs Monaten war die Beteiligung so hoch wie nie zuvor. Die große Zahl der Mitwirkenden zeigt, dass OpenTelemetry inzwischen ausgereift ist und allmählich die Kluft zwischen Early Adopters (die bereit sind, ihrer Zeit voraus zu sein) und Pragmatikern (die ausgereifte Produkte bevorzugen) überwindet.
OpenTelemetry konzentriert sich auf Daten – genauer gesagt auf die Daten und Datenströme (Telemetrie), die erforderlich sind, um unsere Anwendungen bestmöglich zu verstehen, Fehler zu beheben und sie zu verbessern. Daten sind nur dann nützlich, wenn sie in großem Maßstab aggregiert, analysiert und visualisiert werden können. OpenTelemetry macht zwar keine Vorgaben dazu, wie die Daten visualisiert werden sollen, aber wir müssen uns dadurch keine Gedanken mehr darüber machen, welche Daten wir erhalten können, sondern können uns stattdessen darauf konzentrieren, was wir mit den Daten tun können.
OpenTelemetry ermöglicht zudem eine natürliche Korrelation zwischen diesen Datenquellen, anstatt von uns zu erwarten, diese Korrelation selbst herzustellen. Die Fähigkeit von OpenTelemetry, Ereignisse anwendungsübergreifend zu korrelieren, führt uns zu Observability 2.0 – einem neuen Maßstab für die Messung von Anwendungsaktivitäten in der Cloud. Die Daten sind bereits für uns korreliert, was unsere Sicht auf unsere Anwendungslandschaft verändert. Wir sind nicht mehr darauf beschränkt, lediglich zu wissen, ob die Anwendung ausgeführt wird oder nicht; nun können wir nachvollziehen, welchen Weg eine beliebige Anfrage durch unsere Anwendungen nimmt.
Vor OpenTelemetry gab es zwei bedeutende Open-Source-Projekte: OpenTracing (OT) und OpenCensus (OC). Beide stellten sich der Herausforderung, das Format von Trace-Daten zu standardisieren, damit wir die erforderlichen Informationen erhalten und nachvollziehen konnten, wie sie sich auf unsere modernen Anwendungen auswirkten. Obwohl sich die beiden Projekte ähnelten, konkurrierten sie um Ressourcen, und Unternehmen mussten sich häufig für eines von ihnen entscheiden. Im März 2019 gaben die beiden Projekte ihren Zusammenschluss zu OpenTelemetry bekannt, mit dem Ziel, die Erzeugung und Formatierung von Trace-Daten zu vereinheitlichen. Das OpenTelemetry-Projekt definiert darüber hinaus Standards für die Erfassung weiterer Arten von Observability-Daten (Metriken und Protokolle) über dieselben Telemetriekanäle wie Traces, was zu einer besseren Integration und mehr Übersichtlichkeit führt.
Sehen wir uns als Nächstes zwei spannende funktionale Aspekte von OpenTelemetry an: verteiltes Tracing und Anwendungsintelligenz.
Warum Distributed Tracing in modernen Anwendungsarchitekturen unverzichtbar ist
Obwohl es Distributed Tracing schon seit Jahren gibt, haben zahlreiche Veränderungen im letzten Jahrzehnt den Bedarf daran erhöht. Mithilfe des Cynefin-Frameworks können wir einige der Veränderungen und Herausforderungen aufzeigen, mit denen wir heute bei modernen Anwendungen konfrontiert sind:
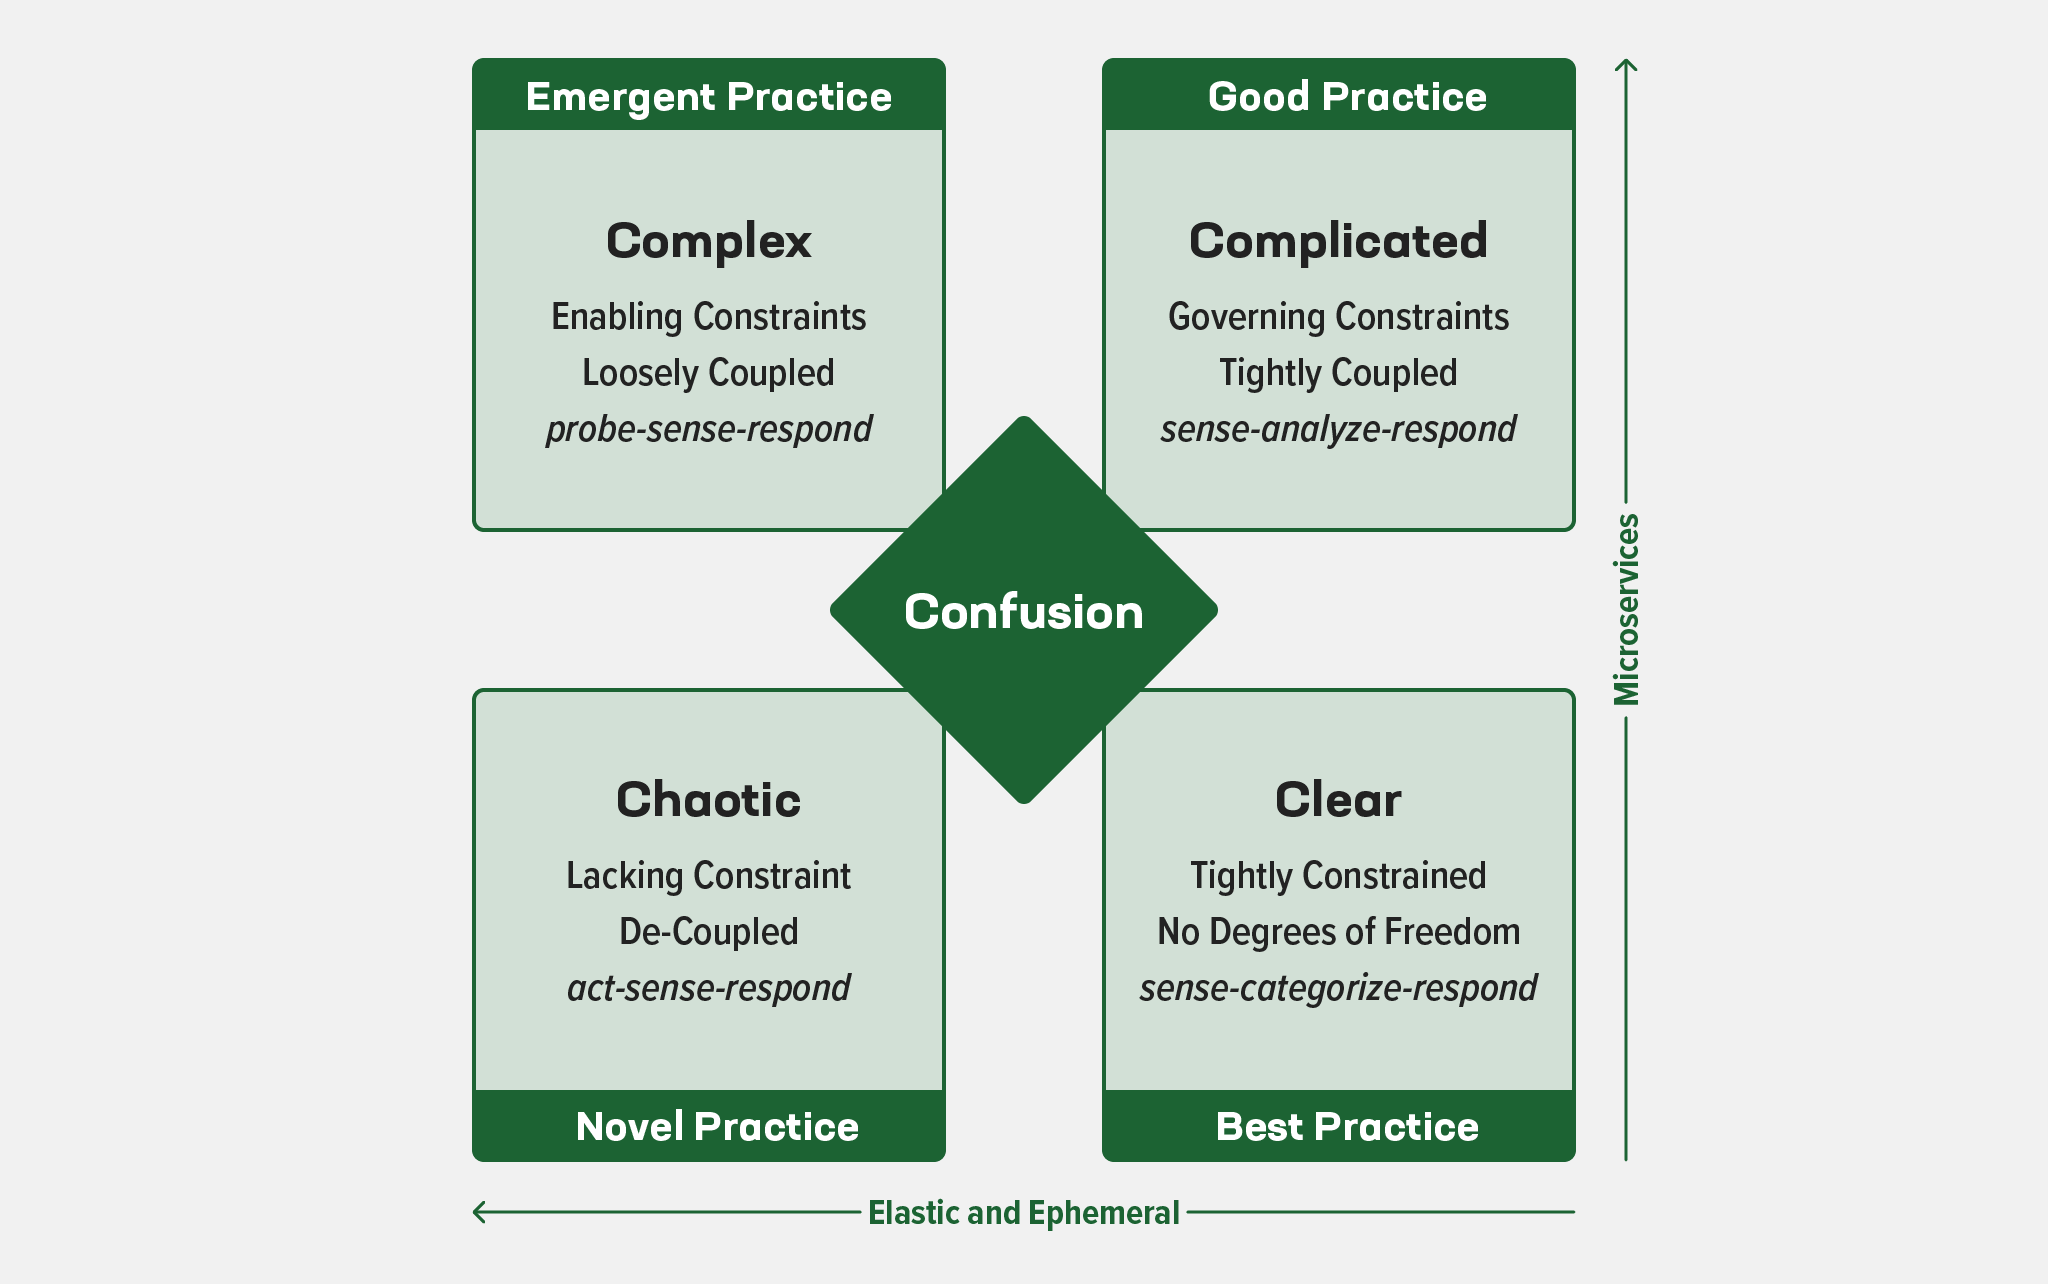
Das Cynefin-Framework veranschaulicht, wie wir unsere Vorgehensweisen anpassen können, wenn wir uns vom Einfachen zum Komplexen bewegen. Die Herausforderung besteht darin, dass diese Entwicklung auf zwei getrennten Wegen mit jeweils eigenen Merkmalen verläuft. Der Versuch, auf direktem Weg vom Einfachen zum Komplexen abzukürzen, führt häufig zu Unordnung und unvollständigen Fortschritten.
Lassen Sie uns herausfinden, welche Elemente die Pfade auf unserem Weg zu modernen Anwendungen und Cloud-Native-Technologien bilden. Auf unserem ersten Pfad (der Y-Achse im Cynefin-Diagramm) befinden sich moderne Anwendungen, die in der Regel auf Microservices-Architekturen basieren, wobei jede Anwendung eine bestimmte Aufgabe erfüllt. Auf dem zweiten Pfad (der X-Achse) ist unsere komplizierte Umgebung kurzlebig, da Microservice-Instanzen je nach Bedarf hoch- und heruntergefahren und bei Netzwerkproblemen auf andere Hosts verschoben werden.
Wir müssen auch die Entstehung und das massive Wachstum von Cloud-Umgebungen wie Amazon Web Services (AWS), Microsoft Azure und Google Cloud Platform (GCP) berücksichtigen. Ein Vorteil solcher Clouds ist ihre elastische Skalierbarkeit: Ressourcen können entsprechend dem aktuellen Bedarf erweitert oder reduziert werden. Durch den zusätzlichen Einfluss der Container-Orchestrierung (meist mit Kubernetes) beobachten wir zunehmend chaotisches Verhalten, da sich Anzahl und Standort der Ressourcen im Laufe der Zeit verändern. (Selbst diese relativ eingeschränkte Betrachtungsweise ist chaotisch, und Elemente wie serverlose Funktionen können das Chaos noch verstärken.)
In einer modernen Architektur mit vielen separaten Komponenten, die die Telemetriedaten erzeugen, die wir zur Überwachung und Wartung unserer Anwendungen benötigen, ist die Datenlast enorm und komplex. Probleme lassen sich möglicherweise nicht zuverlässig reproduzieren oder ohne Weiteres hervorrufen, da wir die Infrastruktur und Kommunikationswege nicht vollständig kontrollieren. Wir benötigen eine Technologie, mit der wir sämtliche Aktivitäten und zugehörigen Elemente nachverfolgen können, um unsere sich verändernden Umgebungen zu verstehen und zu analysieren.
Hier kommt OpenTelemetry ins Spiel.
Die Zukunft des verteilten Tracings mit OpenTelemetry
Distributed Tracing führt zu großen Veränderungen in der Branche, insbesondere bei der Frage, wie Anfragen mithilfe von Metriken einen internen Einblick in die Performance ermöglichen. Mit Distributed Tracing können wir viele Arten neuer Metriken erfassen, am häufigsten jedoch die Anzahl der Anfragen pro Zeiteinheit, die Anzahl der Fehler pro Zeiteinheit und die Dauer einer aggregierten Anfrage innerhalb dieser Zeiteinheit.
Metriken gibt es schon seit geraumer Zeit – sie lassen sich einfach verwalten und speichern, problemlos aggregieren und eignen sich für mathematische Analysen. In OpenTelemetry können alle Anwendungen, die Metriken erzeugen, diese über eine Telemetrie- bzw. Übertragungsschicht an eine zentrale Erfassungsstelle senden. Dadurch lassen sich die Daten der lose gekoppelten Dienste, die sie erzeugen, aufeinander abstimmen. Dies schließt auch die Abstimmung mit der zugrunde liegenden Infrastruktur ein. Kurz gesagt: Mit OpenTelemetry lassen sich Metriken einfacher erfassen und übertragen.
OpenTelemetry kann auch dazu beitragen, das Problem von Abweichungen und Verschiebungen bei Zeitstempeln zu lösen, die das Korrelieren von Ereignissen erschweren. OpenTelemetry weist jeder Anfrage eine TraceId zu. Die Daten können jedoch weiterhin durch Abweichungen und Verschiebungen beeinträchtigt werden, die in Cloud-nativen Architekturen häufig auftreten. Diese können durch Übertragungswege mit unterschiedlichen Laufzeiten oder durch eine unzureichende Synchronisierung der Uhren auf den verschiedenen Hosts entstehen. Durch die Nachverfolgung der Kommunikation zwischen Komponenten während der Verarbeitung des Datenverkehrs ermöglicht verteiltes Tracing OpenTelemetry, einzelne Spans – die Arbeitseinheiten und Bausteine eines Traces – zu messen, ohne dass eine tiefgreifende Instrumentierung der zugehörigen Anwendung erforderlich ist.
Durch die Kombination dieser drei Signale (Telemetriekategorien) können wir Probleme beheben und unsere Anwendungen wieder auf Produktionsniveau bringen:
- Metriken – „Gibt es ein Problem?“
- Traces – „Wo liegt das Problem?“
- Protokolle – „Was ist das Problem?“
Hier kommen wir wieder auf Observability 2.0 zurück. Die Möglichkeit, Traces abzurufen und sofort zu erkennen, welche Metriken welchem Trace entsprechen, eröffnet uns viele Möglichkeiten. Wenn die Metriken beispielsweise auf ein Problem hinweisen, können Sie mithilfe von Distributed Tracing bis zu der konkreten Anfrage zurückgehen, die das ursprüngliche Problem verursacht hat, und den Verlauf durch jeden einzelnen Schritt der Anfrageverarbeitung verfolgen. Da sich unser Trace aus den Spans in der Reihenfolge ihres Auftretens zusammensetzt, können wir die Anfrage auf jedem Schritt ihres Weges verfolgen. Wenn wir verstehen, was in welcher Reihenfolge geschehen ist – vom ursprünglichen Ereignis über das angezeigte Problem bis hin zum Endergebnis –, können wir genau bestimmen, „wo“ innerhalb unserer Anwendungen wir unsere Aufmerksamkeit gezielt einsetzen müssen.
So einfach es auch klingen mag: Das verteilte Tracing von OpenTelemetry kann uns wertvolle Einblicke in die Erfahrungen unserer Nutzer geben, da es als Indikator für den Erfolg von Anfragen und die Ausführungsdauer dient. Als Nutzer ist mir meine Anfrage wichtig. Als Site Reliability Engineer (SRE) sind mir die aggregierten Anfragen wichtig. OpenTelemetry bietet mir beides sowie die Möglichkeit, von der aggregierten Ansicht bis zu den Einzelheiten vorzudringen, da es darauf ausgelegt ist, alle benötigten Daten anwendungsübergreifend verfügbar zu machen.
Anwendungsintelligenz mit KI und ML
Dieser neue Datenstrom von OpenTelemetry ermöglicht es uns außerdem, unsere Entwicklungs- und Betriebsprozesse adaptiv zu gestalten und zu automatisieren. Mithilfe all dieser gesammelten Daten können wir unsere Anwendung intelligenter machen. F5 konzentriert sich derzeit darauf, unsere Kunden bei der Entwicklung und Bereitstellung sogenannter „adaptiver Anwendungen“ zu unterstützen. Adaptive Anwendungen sind genau das, wonach es klingt: Anwendungen, die ihr Verhalten automatisch und intelligent an Veränderungen in ihrer Umgebung anpassen.
Deshalb kommen künstliche Intelligenz (KI) und maschinelles Lernen (ML) in verschiedenen Lösungen immer häufiger zum Einsatz. Das liegt jedoch nicht nur daran, dass es sich dabei um Trendbegriffe handelt – KI und ML sind nützlich, weil uns inzwischen genügend Daten zur Verfügung stehen, um zuverlässige Rückschlüsse auf Ursache-Wirkungs-Zusammenhänge zu ziehen und geeignete Reaktionen zu entwickeln.
Indem OpenTelemetry Telemetriedaten zugänglich macht und standardisiert, erleichtert es den Weg zu adaptiven Anwendungen erheblich. Wenn verschiedene Produkttypen beginnen, ähnliche Metriken auszugeben, und die etablierten semantischen Konventionen von OpenTelemetry genutzt werden, lassen sich ihre Aktionen während der Anfrageverarbeitung leichter miteinander in Beziehung setzen. Diese Informationen können anschließend ML- und KI-Algorithmen zugeführt werden, damit sich Anwendungen und Infrastruktur dynamisch anpassen können.
Wenn Sie die zugrunde liegende Data Science verstehen und sicherstellen, dass Ihre Telemetriedaten mit Ihrer KI und Ihrem maschinellen Lernen verknüpft sind, kann sich der datengesteuerte Charakter adaptiver Anwendungen voll entfalten.
Zusammenfassung
Die Standardisierung der Telemetrie ist sowohl für die Nutzer von OpenTelemetry als auch für die Anwendungen, die es als Telemetriekanal verwenden, ein klarer Gewinn. Daten können aus mehreren Quellen erfasst und an beliebige kompatible Aggregations- und Analysetools weitergeleitet werden. Darüber hinaus nimmt der OpenTelemetry Collector den Anbietern die Notwendigkeit ab, selbst Collectors zu implementieren. Stattdessen können sie sich darauf konzentrieren, ihren Code so zu verbessern, dass er aussagekräftige Analysen durchführt und intelligente Maßnahmen ergreift. Zudem können sie neue Tools entwickeln, die dabei helfen, diese komplexe und chaotische neue Welt besser zu verstehen. Tatsächlich ist der OpenTelemetry Collector – gestützt auf die Innovationskraft von Open Source – äußerst leistungsfähig, kann mit nahezu jedem bestehenden Format arbeiten und schlägt zugleich die technologische Brücke in die Zukunft.
Durch die Konzentration auf die wichtigsten Datenklassen, die wir zum Verständnis unserer Anwendungen benötigen, ermöglicht OpenTelemetry unseren Apps tiefere Einblicke sowohl in die Leistung als auch in die Probleme unserer komplexen modernen Anwendungslandschaft. Indem OpenTelemetry unsere Daten korreliert und sie an semantischen und standardisierten Konventionen ausrichtet, erleichtert es den Weg zu modernen Anwendungen. Und während das Projekt weiter reift und sich zunehmend durchsetzt, ist OpenTelemetry der klare Ansatz, um ein tieferes Verständnis zu erlangen und KI- und ML-Techniken einzusetzen, die diese Komplexität verständlich machen.
Wenn Sie mehr darüber erfahren möchten, wie die OSS-Entwickler von NGINX OpenTelemetry einsetzen, probieren Sie die Referenzarchitektur für moderne Anwendungen und die Beispielanwendung (Bank of Sirius) aus.
Ähnliche Beiträge
Über die Autoren
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.