Als wir das Projekt NGINX Modern Apps Reference Architecture vorstellten (MARA) im vergangenen Herbst auf der Sprint 2.0, betonten wir, dass es anders als manche Architekturen kein „Spielzeug“ sein sollte, sondern eine Lösung, die „solide, getestet und bereit für den Einsatz in produktiven Anwendungen in Kubernetes-Umgebungen“ ist. Für ein solches Projekt sind Observability-Tools unverzichtbar. Alle Mitglieder des MARA-Teams haben selbst erlebt, wie frustrierend die Entwicklung und Bereitstellung von Anwendungen sein kann, wenn Einblicke in Status und Performance fehlen. Wir waren uns sofort einig, dass MARA eine Instrumentierung für Debugging und Tracing in einer Produktionsumgebung enthalten muss.
Ein weiteres Leitprinzip der MARA ist die Bevorzugung von Open-Source-Lösungen. In diesem Beitrag beschreiben wir, wie uns die Suche nach einem multifunktionalen Open-Source-Tool für Observability zu OpenTelemetry führte. Anschließend erläutern wir die Kompromisse, Entwurfsentscheidungen, Verfahren und Technologien, mit denen wir OpenTelemetry in eine mit Python, Java und NGINX entwickelte Microservices-Anwendung integriert haben.
Wir hoffen, dass unsere Erfahrungen Ihnen helfen, mögliche Fallstricke zu vermeiden und OpenTelemetry schneller einzuführen. Bitte beachten Sie, dass dieser Beitrag eine Momentaufnahme des Entwicklungsstands ist – wir gehen davon aus, dass die hier besprochenen Technologien innerhalb eines Jahres ausgereift sein werden. Auch wenn wir auf aktuelle Schwachstellen einiger Projekte hinweisen, sind wir für die gesamte geleistete Open-Source-Arbeit äußerst dankbar und freuen uns darauf, ihre weitere Entwicklung zu verfolgen.
Unsere Anwendung
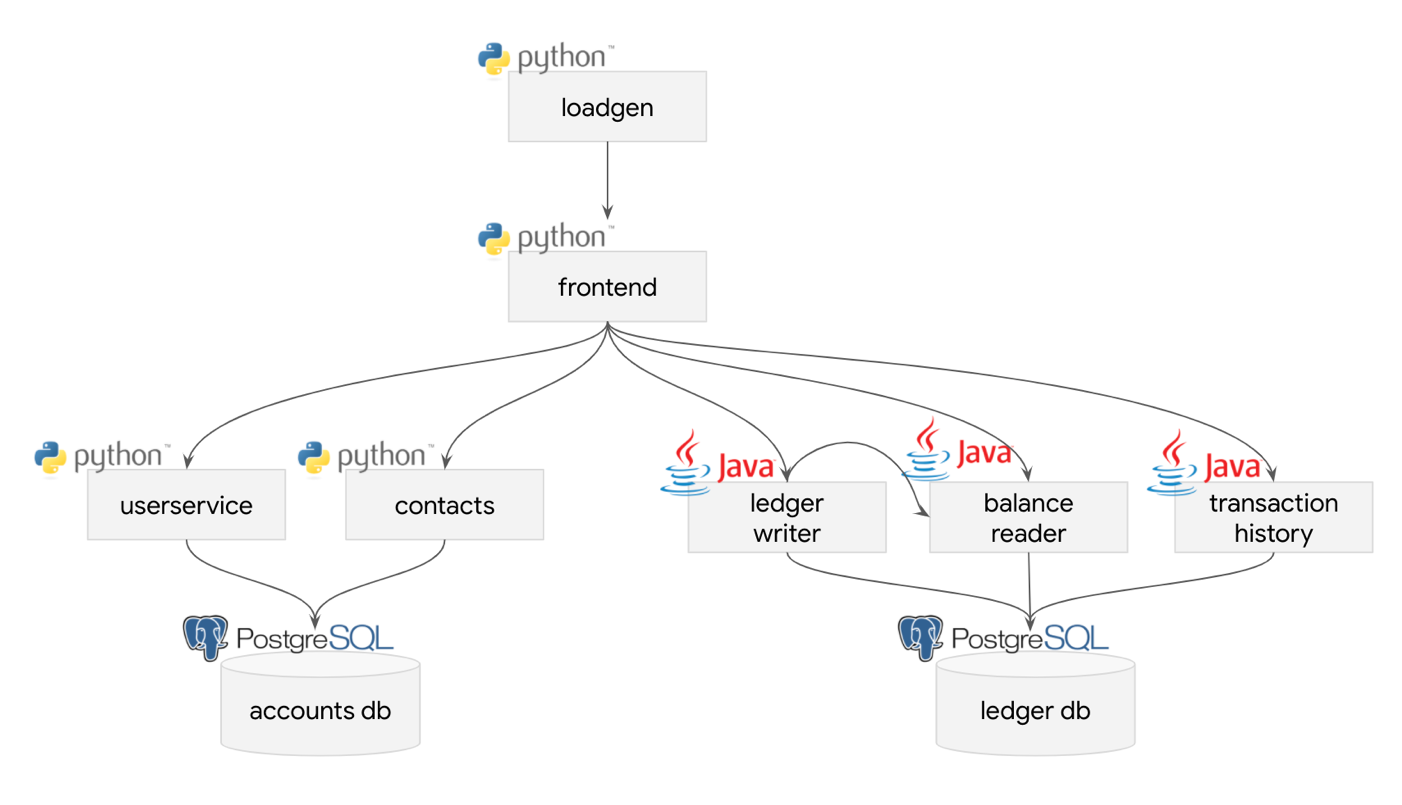
Als Anwendung für die Integration mit einer Observability-Lösung haben wir uns für die Bank of Sirius entschieden, unseren Fork der Google-Beispielanwendung Bank of Anthos. Dabei handelt es sich um eine Webanwendung mit einer Microservices-Architektur, die sich per Infrastructure as Code bereitstellen lässt. Die Anwendung lässt sich in puncto Performance und Zuverlässigkeit an vielen Stellen verbessern, ist aber ausgereift genug, um als Brownfield-Anwendung zu gelten. Daher halten wir sie für ein gutes Beispiel, um zu zeigen, wie sich OpenTelemetry in eine Anwendung integrieren lässt, denn theoretisch liefert verteiltes Tracing wertvolle Einblicke in die Schwachstellen einer Anwendungsarchitektur.
Wie im Diagramm zu sehen ist, sind die Dienste, auf denen die Anwendung basiert, relativ einfach aufgebaut.
Warum wir uns für OpenTelemetry entschieden haben
Unser Weg zur Entscheidung für OpenTelemetry war recht kurvenreich und verlief in mehreren Etappen.
Eine Wunschliste für Funktionen erstellen
Bevor wir die verfügbaren Open-Source-Observability-Tools selbst bewerteten, legten wir fest, welche Aspekte der Observability uns wichtig sind. Auf Grundlage unserer bisherigen Erfahrungen haben wir die folgende Liste zusammengestellt.
- Logging – Darunter verstehen wir die Erzeugung klassischer, durch Zeilenumbrüche getrennter Meldungen aus Anwendungen; die Bank-of-Sirius-App strukturiert ihre Logs im Bunyan-Format
- Verteiltes Tracing – Zeitmessungen und Metadaten für jede Komponente innerhalb der gesamten Anwendung, wie sie Anbieter von Application Performance Management (APM) bereitstellen
- Metriken – Messwerte, die über einen bestimmten Zeitraum erfasst und als Zeitreihendaten grafisch dargestellt werden
- Aggregation von Ausnahmen und Fehlern sowie Benachrichtigung – Eine zusammengefasste Sammlung der häufigsten Ausnahmen und Fehler, die durchsuchbar sein muss, damit wir feststellen können, welche Anwendungsfehler am häufigsten auftreten
- Zustandsprüfungen – Regelmäßige Prüfanfragen an Dienste, um festzustellen, ob sie innerhalb der Anwendung ordnungsgemäß funktionieren
- Introspektion des Laufzeitzustands – Eine Reihe von APIs, die nur für Administratoren sichtbar sind und Informationen über den Laufzeitzustand der Anwendung zurückgeben
- Heap-/Core-Dumps – Umfassende Momentaufnahmen des Laufzeitzustands eines Dienstes; für unsere Zwecke ist entscheidend, wie einfach sich diese Dumps bei Bedarf oder beim Absturz eines Dienstes erstellen lassen
Abgleich der Tool-Funktionen mit der Wunschliste
Natürlich haben wir nicht erwartet, dass ein einzelnes Open-Source-Tool oder ein einzelner Ansatz all diese Funktionen bietet. Doch zumindest hatten wir damit eine Idealvorstellung als Grundlage für den Vergleich der verfügbaren Tools. Wir haben die Dokumentation der einzelnen Tools herangezogen, um herauszufinden, welche der sieben Funktionen auf unserer Wunschliste sie unterstützen. Die Tabelle fasst unsere Ergebnisse zusammen.
Technologie Protokollierung Verteiltes Tracing Metriken Fehleraggregation Zustandsprüfungen Laufzeitintrospektion Heap-/Core-DumpsELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry Beta ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
* Als Erweiterung
Die Erstellung dieser Tabelle war eine ernüchternde Erfahrung. Die verschiedenen Tools unterscheiden sich in ihrem Funktionsumfang und ihren Einsatzzwecken so stark, dass wir sie nicht alle derselben Kategorie zuordnen konnten – es war, als würde man Äpfel mit Toastern vergleichen!
Beispielsweise erfüllen ELK (Elasticsearch-Logstash-Kibana, ergänzt um Filebeat) und Zipkin so grundlegend unterschiedliche Aufgaben, dass ein Vergleich eher Verwirrung stiftet als Klarheit schafft. Leider sorgt die schleichende Ausweitung des Funktionsumfangs für noch mehr Unklarheit – zweifellos als Reaktion auf Nutzerwünsche wurden Funktionen hinzugefügt, die für den eigentlichen Zweck des jeweiligen Tools zweitrangig sind und Überschneidungen mit anderen Tools schaffen. Auf den ersten Blick dient ELK der Speicherung und Visualisierung von Logs, während Zipkin für verteiltes Tracing zuständig ist. Doch schon bei einem etwas genaueren Blick auf das Produktportfolio von Elastic stößt man auf Elastic APM, das verteiltes Tracing unterstützt und sogar mit Jaeger kompatibel ist.
Abgesehen von der schleichenden Ausweitung des Funktionsumfangs lassen sich viele der Tools miteinander integrieren, sodass sich unterschiedliche Kombinationen aus Kollektoren, Aggregatoren, Dashboards und weiteren Komponenten ergeben. Einige der Technologien sind miteinander kompatibel, andere nicht.
Durchführung einer qualitativen Untersuchung
Diese Vergleichstabelle lieferte uns also kein ausreichend genaues Bild, um darauf unsere Entscheidung zu stützen. Wir mussten die Ziele, Leitprinzipien und mögliche künftige Ausrichtung der einzelnen Projekte qualitativ untersuchen. Dabei gingen wir davon aus, dass wir langfristig umso eher kompatibel bleiben würden, je ähnlicher die Werte eines Projekts unseren eigenen sind. Beim Besuch der Projektseiten fiel uns auf der Seite von OpenCensus sofort Folgendes auf.
OpenCensus und OpenTracing haben sich zu OpenTelemetry zusammengeschlossen, das die nächste Hauptversion von OpenCensus und OpenTracing darstellt. OpenTelemetry wird Abwärtskompatibilität mit bestehenden OpenCensus-Integrationen bieten, und wir werden die bestehenden OpenCensus-Bibliotheken noch zwei Jahre lang mit Sicherheitspatches versorgen.
Das war für uns eine entscheidende Information. Uns war klar, dass wir nicht garantieren konnten, dass unsere Wahl zukunftssicher sein würde. Aber wir wollten zumindest wissen, dass sie auch künftig auf eine starke Unterstützung durch die Community zählen konnte. Mit dieser Information konnten wir OpenCensus von unserer Kandidatenliste streichen. Vermutlich war es auch keine gute Idee, Jaeger zu verwenden, denn es ist die Referenzimplementierung für das inzwischen offiziell als veraltet eingestufte Projekt OpenTracing – der Großteil der neuen Beiträge wird in OpenTelemetry einfließen.
Dann informierten wir uns über den OpenTelemetry Collector.
Der OpenTelemetry Collector bietet eine herstellerunabhängige Implementierung zum Empfangen, Verarbeiten und Exportieren von Telemetriedaten. Außerdem entfällt damit die Notwendigkeit, mehrere Agenten bzw. Collectors auszuführen, zu betreiben und zu warten, um Open-Source-Telemetriedatenformate (z. B. Jaeger, Prometheus usw.) zu unterstützen und die Daten an verschiedene Open-Source- oder kommerzielle Backends zu senden.
Der OpenTelemetry Collector fungiert als Aggregator, mit dem wir verschiedene Methoden zur Erfassung von Observability-Daten und zur Instrumentierung mit unterschiedlichen Backends kombinieren können. So kann unsere Anwendung beispielsweise Traces mit Zipkin und Metriken von Prometheus erfassen, die wir anschließend an ein konfigurierbares Backend senden und mit Grafana visualisieren können. Dieser Aufbau lässt sich auf vielfältige Weise variieren. So können wir verschiedene Ansätze ausprobieren, um herauszufinden, welche Technologien sich für unseren Anwendungsfall eignen.
Die Integration von OpenTelemetry als Weg in die Zukunft
Letztlich hat uns der OpenTelemetry Collector überzeugt, weil er uns theoretisch ermöglicht, zwischen Observability-Technologien zu wechseln. Obwohl das Projekt noch vergleichsweise unausgereift war, haben wir uns entschieden, den Sprung zu wagen und OpenTelemetry ausschließlich mit Open-Source-Integrationen einzusetzen. Denn nur wenn man die Technologien nutzt, kann man die Technologielandschaft wirklich verstehen.
Allerdings fehlen dem OpenTelemetry Collector einige Funktionen, für die wir auf andere Technologien zurückgreifen müssen. Die folgenden Abschnitte fassen unsere Entscheidungen und die Gründe dafür zusammen.
- Logging implementieren
- Implementierung von verteiltem Tracing
- Implementierung der Metrikerfassung
- Implementierung der Fehleraggregation
- Implementierung von Zustandsprüfungen und Laufzeitintrospektion
- Implementierung von Heap- und Core-Dumps
Implementierung der Protokollierung
Logging ist ein auf den ersten Blick einfacher Teil der Observability, der jedoch schnell komplexe Entscheidungen erfordert. Einfach ist es, weil Sie lediglich die Log-Ausgaben Ihrer Container erfassen. Kompliziert wird es jedoch, weil Sie anschließend entscheiden müssen, wo Sie die Daten speichern, wie Sie sie dorthin übertragen, wie Sie sie indexieren, um sie nutzbar zu machen, und wie lange Sie sie aufbewahren. Damit Log-Dateien nützlich sind, müssen sie sich anhand ausreichend vieler verschiedener Kriterien einfach durchsuchen lassen, um den Anforderungen unterschiedlicher Nutzer gerecht zu werden.
Wir haben uns die Unterstützung für Logging im OpenTelemetry Collector angesehen. Zum Zeitpunkt der Erstellung dieses Textes befindet sie sich noch in einer sehr frühen Betaphase. Wir haben uns entschieden, kurzfristig ELK für das Logging einzusetzen und parallel weiterhin andere Optionen zu prüfen.
Da keine triftigen Gründe dagegensprachen, entschieden wir uns für die Elasticsearch-Tools. Damit konnten wir die Bereitstellung in Ingest-, Koordinations-, Master- und Datenknoten aufteilen. Um die Bereitstellung zu vereinfachen, verwendeten wir ein Bitnami-Chart. Für den Datentransport stellten wir Filebeat als Teil eines Kubernetes-DaemonSets bereit. Die Suchfunktion ergänzten wir durch die Bereitstellung von Kibana und die Nutzung der vorinstallierten Indizes, Suchabfragen, Visualisierungen und Dashboards.
Es wurde recht schnell deutlich, dass diese Lösung zwar funktionierte, die Standardkonfiguration jedoch recht ressourcenhungrig war. Das erschwerte den Betrieb in ressourcensparenden Umgebungen wie K3S oder Microk8s. Durch die Möglichkeit, die Anzahl der Replikate für jede Komponente anzupassen, ließ sich dieses Problem beheben. Allerdings kam es dadurch zu einigen Ausfällen, die möglicherweise auf erschöpfte Ressourcen oder übermäßig große Datenmengen zurückzuführen waren.
Wir sind darüber keineswegs enttäuscht, sondern sehen darin eine Gelegenheit, unser Logging-System mit unterschiedlichen Konfigurationen einem Benchmark zu unterziehen und andere Optionen wie Grafana Loki und Graylog zu untersuchen. Dabei könnte sich durchaus herausstellen, dass schlankere Logging-Lösungen nicht den gesamten Funktionsumfang bieten, den manche Nutzer benötigen und den sie bei ressourcenintensiveren Tools erhalten. Aufgrund des modularen Aufbaus von MARA werden wir wahrscheinlich zusätzliche Module für diese Optionen entwickeln, um den Nutzern mehr Auswahl zu bieten.
Implementierung von Distributed Tracing
Neben der Frage, welches Tool die gewünschte Tracing-Funktionalität bietet, mussten wir auch berücksichtigen, wie sich die Lösung implementieren lässt und welche Technologien darin integriert werden müssen.
Zunächst wollten wir sicherstellen, dass die Instrumentierung die Dienstqualität der Anwendung selbst nicht beeinträchtigt. Wir alle hatten bereits mit Systemen gearbeitet, deren Leistung zuverlässig einmal pro Stunde beim Exportieren der Logs einbrach, und wir wollten diese Erfahrung nicht noch einmal machen. Die Architektur des OpenTelemetry Collector war in dieser Hinsicht überzeugend, da sich pro Host eine Instanz betreiben lässt. Jeder Collector empfängt Daten von Clients und Agenten in den verschiedenen Anwendungen, die auf dem Host ausgeführt werden – ob containerisiert oder nicht. Der Collector aggregiert die Daten und komprimiert sie gegebenenfalls, bevor er sie an ein Speicher-Backend sendet. Das klang ideal.
Als Nächstes haben wir die Unterstützung für OpenTelemetry in den verschiedenen Programmiersprachen und Frameworks untersucht, die wir in der Anwendung verwenden. Hier wurde es etwas kniffliger. Obwohl wir nur die beiden in der Tabelle aufgeführten Programmiersprachen und die zugehörigen Frameworks verwenden, war die Komplexität überraschend hoch.
Sprache Framework Anzahl der DiensteJava Spring Boot 3Python Flask 3
Um Tracing auf Programmiersprachenebene hinzuzufügen, haben wir zunächst die Agenten von OpenTelemetry für die automatische Instrumentierung ausprobiert, fanden deren Ausgabe jedoch unübersichtlich und verwirrend. Wir sind sicher, dass sich dies mit zunehmender Reife der Bibliotheken für automatische Instrumentierung verbessern wird. Vorerst haben wir uns jedoch gegen die OpenTelemetry-Agenten entschieden und stattdessen Tracing direkt in unseren Code integriert.
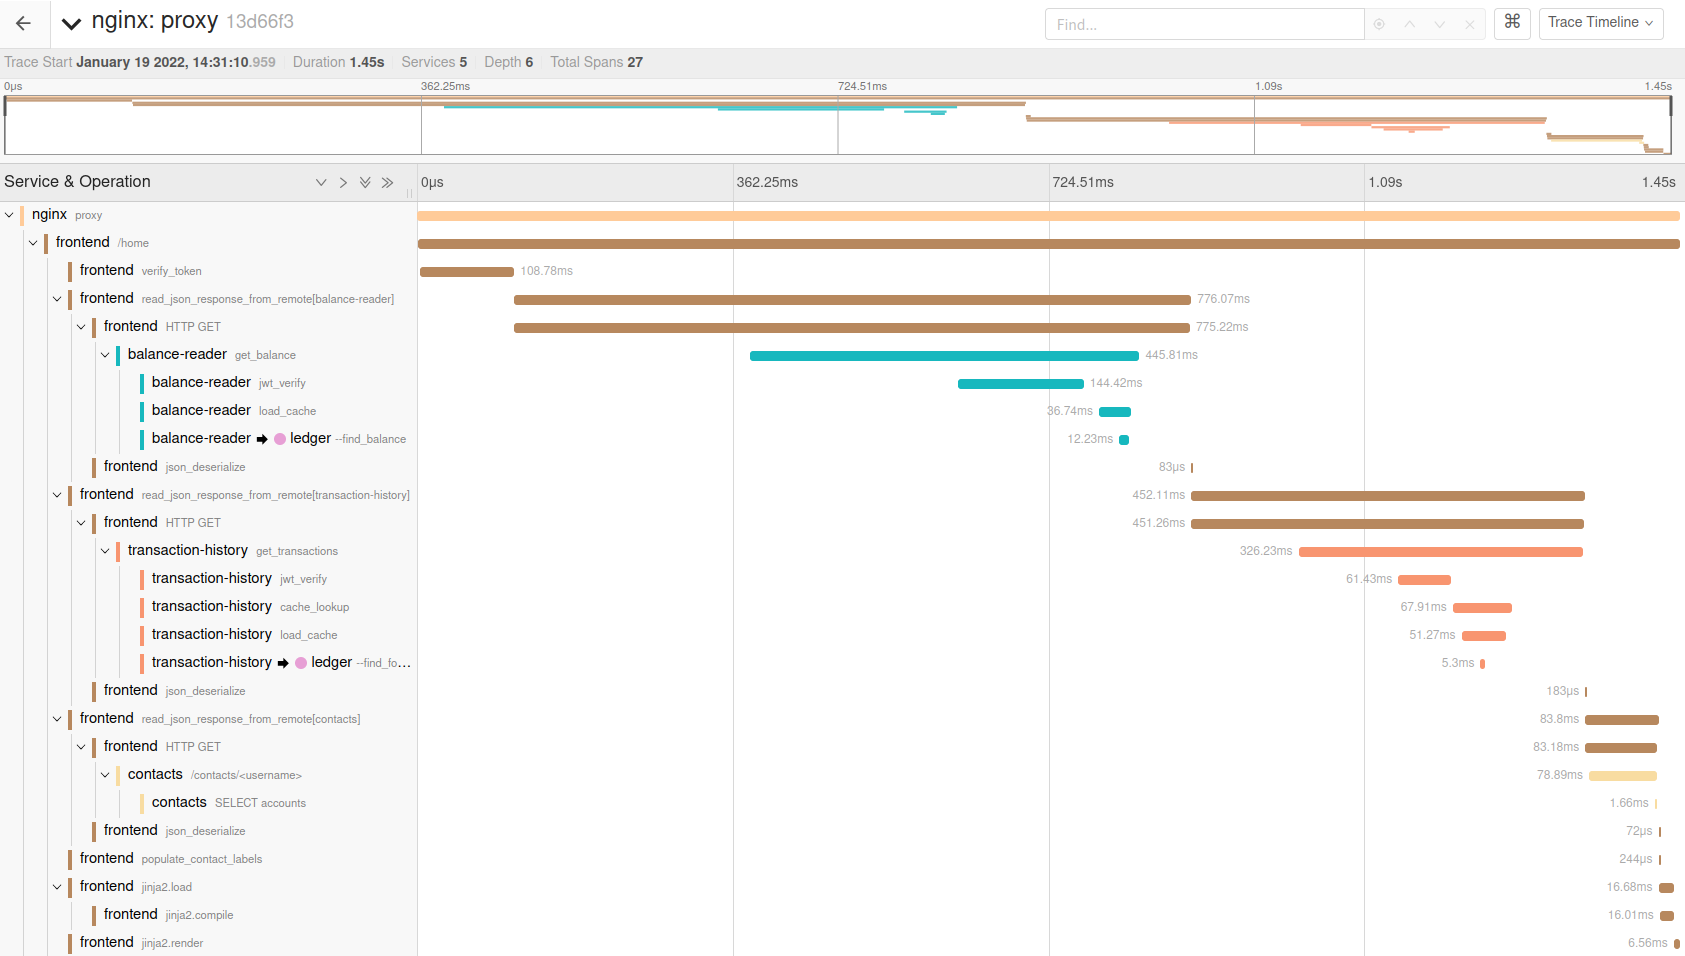
Bevor wir Tracing direkt im Code implementierten, konfigurierten wir zunächst den OpenTelemetry Collector so, dass er alle Trace-Daten an eine lokal laufende Jaeger-Instanz ausgab. Dort konnten wir die Ausgabe leichter einsehen. Das war sehr hilfreich, denn so konnten wir mit der visuellen Darstellung der Tracing-Daten experimentieren, während wir herausfanden, wie sich OpenTelemetry vollständig integrieren ließ. Wenn wir beispielsweise feststellten, dass eine HTTP-Clientbibliothek bei Aufrufen eines nachgelagerten Dienstes keine Tracing-Daten übermittelte, setzten wir das Problem sofort auf unsere Liste der zu behebenden Fehler. Jaeger bietet eine übersichtliche Darstellung aller Spans innerhalb eines einzelnen Traces:
Verteiltes Tracing für Python
Das Hinzufügen von Tracing zu unserem Python-Code war relativ unkompliziert. Wir haben zwei Python-Quelldateien hinzugefügt, die von allen unseren Diensten referenziert werden, und die jeweiligen requirements.txt-Dateien um die entsprechenden opentelemetry-instrumentation-*-Abhängigkeiten ergänzt. Dadurch konnten wir für alle Python-Dienste dieselbe Tracing-Konfiguration verwenden sowie die Trace-ID jeder Anfrage in Logmeldungen aufnehmen und in Anfragen an nachgelagerte Dienste einbetten.
Verteiltes Tracing für Java
Als Nächstes haben wir uns den Java-Services zugewandt. Die direkte Verwendung der OpenTelemetry-Java-Bibliotheken in einem Greenfield-Projekt ist relativ unkompliziert – Sie müssen lediglich die erforderlichen Bibliotheken importieren und die Tracing-API direkt verwenden. Wenn Sie jedoch wie wir Spring verwenden, müssen Sie weitere Entscheidungen treffen.
Spring verfügt bereits über eine API für verteiltes Tracing: Spring Cloud Sleuth. Sie bietet eine Fassade für die zugrunde liegende Implementierung des verteilten Tracings, die laut Dokumentation Folgendes leistet:
- Fügt dem Slf4J-MDC Trace- und Span-IDs hinzu, sodass Sie in einem Log-Aggregator alle Logs eines bestimmten Traces oder Spans extrahieren können.
- Instrumentiert gängige Ein- und Ausgangspunkte von Spring-Anwendungen (Servlet-Filter, RestTemplate, geplante Aktionen, Nachrichtenkanäle, Feign-Client).
- Wenn
spring-cloud-sleuth-zipkinverfügbar ist, … [generiert und übermittelt] Zipkin-kompatible Traces über HTTP. Standardmäßig werden diese an einen Zipkin-Collector-Dienst auf localhost (Port 9411) gesendet. Konfigurieren Sie die Adresse des Dienstes mitspring.zipkin.baseUrl.
Mit der API können wir außerdem Traces zu Aufgaben hinzufügen, die mit @Scheduled annotiert sind.
Mit anderen Worten: Allein durch den Einsatz von Spring Cloud Sleuth erhalten wir ohne zusätzliche Konfiguration Traces auf Ebene der HTTP-Service-Endpunkte – ein praktischer Vorteil. Da unser Projekt bereits Spring verwendet, haben wir beschlossen, alles innerhalb dieses Frameworks zu belassen und die bereitgestellten Funktionen zu nutzen. Allerdings sind wir auf einige Probleme gestoßen, als wir alles mit Maven zusammengeführt haben:
- Das Spring Cloud Sleuth Autoconfigure-Modul liegt noch immer als Meilenstein-Version vor.
- Das Spring Cloud Sleuth Autoconfigure-Modul hängt von einer veralteten Alpha-Version von
opentelemetry-instrumentation-apiab. Derzeit gibt es keine aktuelle Version 1.x dieser Bibliothek, die keine Alpha-Version ist. - Das Projekt muss das übergeordnete Project Object Model (POM)
spring-cloud-buildaus den Spring-Snapshot-Repositories beziehen, da Spring Cloud Sleuth seine Abhängigkeitsreferenzen für Meilenstein-Releases entsprechend kodiert.
Dadurch wurde unsere Maven-Projektdefinition etwas komplizierter, da Maven die Abhängigkeiten sowohl aus den Spring-Repositories als auch aus Maven Central beziehen musste – ein deutliches Zeichen dafür, wie sehr die OpenTelemetry-Unterstützung in Spring Cloud noch in den Kinderschuhen steckte. Dennoch machten wir weiter und erstellten ein gemeinsames Telemetriemodul, um verteiltes Tracing mit Spring Cloud Sleuth und OpenTelemetry zu konfigurieren, einschließlich verschiedener telemetriebezogener Hilfsfunktionen und Erweiterungen.
Im gemeinsamen Telemetriemodul erweitern wir die Tracing-Funktionalität der Bibliotheken Spring Cloud Sleuth und OpenTelemetry um Folgendes:
- Spring-fähige
Autoconfiguration-Klassen, die Tracing und erweiterte Funktionen für das Projekt einrichten und zusätzliche Ressourcenattribute für Traces laden. - NoOp-Implementierungen der Schnittstellen, sodass wir das Tracing beim Start deaktivieren können, indem wir NoOp-Instanzen in alle Spring Cloud Sleuth-Schnittstellen injizieren.
- Ein Interceptor für die Trace-Benennung zur Vereinheitlichung von Trace-Namen.
- Ein Fehlerhandler, der Fehler über slf4j und das Tracing von Spring Cloud Sleuth ausgibt.
- Eine erweiterte Implementierung von Tracing-Attributen, die zusätzliche Informationen in jeden ausgegebenen Trace einbettet, darunter die Serviceversion, die Serviceinstanz-ID, die Maschinen-ID, den Pod-Namen, die Container-ID, den Containernamen und den Namespace-Namen.
- Ein Tracing-Statement-Inspektor, der Trace-IDs in Kommentare einfügt, die den von Hibernate ausgegebenen SQL-Anweisungen vorangestellt werden. Anscheinend ist das inzwischen auch mit SQLCommenter möglich, aber wir sind noch nicht darauf umgestiegen.
Zusätzlich haben wir einen Spring-kompatiblen HTTP-Client implementiert, der auf dem Apache HTTP Client basiert, da wir uns für HTTP-Aufrufe zwischen Diensten mehr Metriken und Anpassungsmöglichkeiten wünschten. In dieser Implementierung werden die Trace- und Span-IDs beim Aufruf abhängiger Dienste als Header übergeben, sodass sie in die Tracing-Ausgabe aufgenommen werden können. Darüber hinaus stellt diese Implementierung Metriken zum HTTP-Verbindungspool bereit, die von OpenTelemetry aggregiert werden.
Alles in allem war es mühsam, das Tracing mit Spring Cloud Sleuth und OpenTelemetry zum Laufen zu bringen, aber wir sind überzeugt, dass sich der Aufwand gelohnt hat. Wir hoffen, dass dieses Projekt und dieser Beitrag anderen, die diesen Weg einschlagen möchten, als Orientierung dienen.
Verteiltes Tracing für NGINX
Um Traces zu erhalten, die alle Dienste über den gesamten Lebenszyklus einer Anfrage hinweg miteinander verknüpfen, mussten wir OpenTelemetry in NGINX integrieren. Dafür verwendeten wir das OpenTelemetry-Modul für NGINX (noch in der Betaphase). Da wir damit rechneten, dass es schwierig sein könnte, funktionsfähige Binärdateien des Moduls zu erhalten, die mit allen NGINX-Versionen kompatibel sind, erstellten wir ein GitHub-Repository mit Container-Images, die nicht unterstützte NGINX-Module enthalten. Wir führen nächtliche Builds durch und stellen die Binärdatei des Moduls über Docker-Images bereit, aus denen sie sich einfach importieren lässt.
Wir haben diesen Prozess noch nicht in den Build-Prozess für den NGINX Ingress Controller im MARA-Projekt integriert, planen dies aber in Kürze.
Implementierung der Metrikerfassung
Nachdem wir die Integration von OpenTelemetry für das Tracing abgeschlossen hatten, widmeten wir uns als Nächstes den Metriken. Für unsere Python-basierten Anwendungen gab es noch keine Metriken, und wir beschlossen, deren Einführung vorerst aufzuschieben. Bei den Java-Anwendungen unterstützt der ursprüngliche Quellcode von Bank of Anthos, der Micrometer in Verbindung mit Google Clouds Stackdriver verwendet, bereits Metriken. Wir hatten diesen Code jedoch nach dem Fork von Bank of Anthos aus Bank of Sirius entfernt, da er es uns nicht ermöglichte, ein Metrik-Backend zu konfigurieren. Dass bereits Hooks für Metriken vorhanden waren, unterstrich dennoch die Notwendigkeit einer ordnungsgemäßen Metrikintegration.
Um eine konfigurierbare und praxistaugliche Lösung zu finden, haben wir uns zunächst die Unterstützung für Metriken in den OpenTelemetry-Java-Bibliotheken und in Micrometer angesehen. Bei einer Suche nach Vergleichen zwischen den Technologien fanden wir mehrere Ergebnisse, die die Schwächen von OpenTelemetry aufzählten – bei dessen Einsatz als Metrik-API in der JVM, obwohl sich OpenTelemetry Metrics zum Zeitpunkt der Erstellung dieses Textes noch in der Alpha-Phase befindet. Micrometer ist eine ausgereifte Metrik-Fassadenschicht für die JVM, die ähnlich wie slf4j einen einheitlichen API-Wrapper für eine konfigurierbare Metrikimplementierung bereitstellt, statt selbst Metriken zu implementieren. Interessanterweise ist Micrometer die standardmäßige Metrik-API für Spring.
Zu diesem Zeitpunkt wogen wir die folgenden Fakten ab:
- Der OpenTelemetry Collector kann Metriken aus nahezu jeder Quelle aufnehmen, darunter Prometheus, StatsD und das native OpenTelemetry Protocol (OTLP)
- Micrometer unterstützt außerdem zahlreiche Metrik-Backends, darunter Prometheus und StatsD.
- Das OpenTelemetry Metrics SDK für die JVM unterstützt das Senden von Metriken über OTLP.
Nach einigen Experimenten entschieden wir uns für den pragmatischsten Ansatz: die Micrometer-Fassade mit einer Prometheus-Implementierung im Hintergrund zu verwenden und den OpenTelemetry Collector so zu konfigurieren, dass er Metriken über die Prometheus-API aus der Anwendung abruft. Aus zahlreichen Artikeln wussten wir, dass fehlende Metriktypen in OpenTelemetry zu Problemen führen können. Da wir diese Typen für unsere Anwendungsfälle jedoch nicht benötigen, war der Kompromiss akzeptabel.
Wir haben etwas Interessantes über den OpenTelemetry Collector herausgefunden: Obwohl wir ihn so konfiguriert hatten, dass er Traces über OTLP und Metriken über die Prometheus-API empfängt, lässt er sich dennoch so konfigurieren, dass er beide Datentypen über OTLP oder ein anderes unterstütztes Protokoll an einen externen Datenempfänger sendet. Dadurch konnten wir unsere Anwendung ganz einfach mit LightStep ausprobieren.
Insgesamt war die Implementierung von Metriken in Java recht einfach, da wir uns dabei an der Micrometer-API orientierten, für die zahlreiche Beispiele und Tutorials verfügbar sind. Die wohl größte Herausforderung sowohl bei den Metriken als auch beim Tracing bestand darin, den Maven-Abhängigkeitsgraphen in der Datei pom.xml für telemetry-common genau richtig zu konfigurieren.
Implementierung der Fehleraggregation
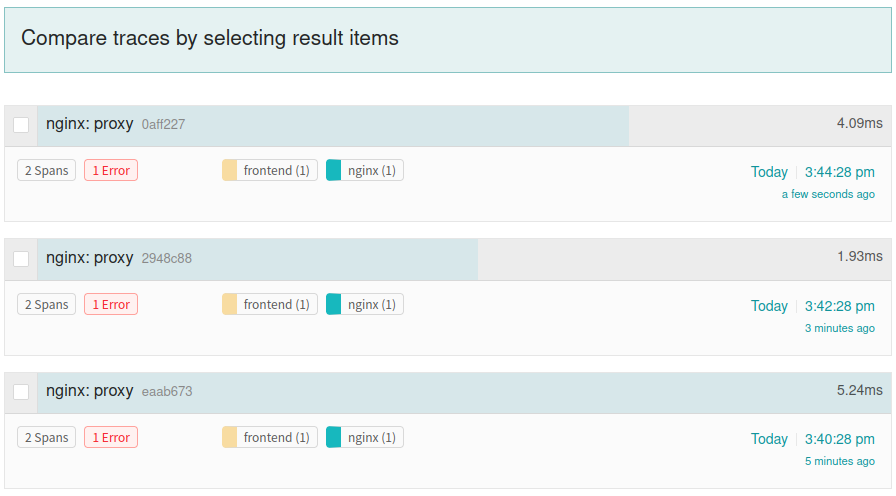
Die Aggregation von Fehlern gehört nicht zum eigentlichen Aufgabenbereich des OpenTelemetry-Projekts, und es bietet keine so elegante Implementierung der Fehlerkennzeichnung wie Lösungen wie Sentry oder Honeybadger.io. Dennoch haben wir uns entschieden, kurzfristig OpenTelemetry für die Fehleraggregation zu nutzen, statt ein weiteres Tool einzuführen. Mit einem Tool wie Jaeger können wir nach error=true suchen, um alle Traces mit einem Fehlerzustand zu finden. Das gibt uns zumindest einen Eindruck davon, welche Fehler häufig auftreten. In Zukunft ziehen wir möglicherweise eine Integration von Sentry in Betracht.
Implementierung von Integritätsprüfungen und Laufzeitintrospektion
Im Kontext unserer Anwendung teilen Zustandsprüfungen Kubernetes mit, ob ein Dienst fehlerfrei läuft oder seine Startphase abgeschlossen hat. Falls der Dienst nicht fehlerfrei läuft, kann Kubernetes so konfiguriert werden, dass Instanzen beendet oder neu gestartet werden. In unserer Anwendung haben wir uns gegen die Verwendung der Zustandsprüfungen von OpenTelemetry entschieden, da wir die Dokumentation als unzureichend empfanden.
Stattdessen verwenden wir für die JVM-Dienste ein Spring-Projekt namens Spring Boot Actuator, das nicht nur Endpunkte für Zustandsprüfungen, sondern auch für Laufzeitintrospektion und Heap-Dumps bereitstellt. Für die Python-Dienste verwenden wir das Flask Management Endpoints module, das einen Teil der Funktionen von Spring Boot Actuator bietet. Derzeit stellt es lediglich anpassbare Anwendungsinformationen und Zustandsprüfungen bereit.
Spring Boot Actuator integriert sich in die JVM und Spring und stellt Endpunkte für Introspektion, Monitoring und Zustandsprüfungen bereit. Darüber hinaus bietet es ein Framework, mit dem sich die an seinen Endpunkten bereitgestellten Standarddaten um benutzerdefinierte Informationen erweitern lassen. Die Endpunkte ermöglichen zur Laufzeit Einblicke in Aspekte wie Cache-Zustand, Laufzeitumgebung, Datenbankmigrationen, Zustandsprüfungen, anpassbare Anwendungsinformationen, Metriken, regelmäßig ausgeführte Aufgaben, HTTP-Sitzungsstatus und Thread-Dumps.
Die von Spring Boot Actuator implementierten Health-Check-Endpunkte sind modular konfiguriert, sodass sich der Zustand eines Dienstes anhand mehrerer einzelner Prüfungen ermitteln lässt, die entweder als Liveness- oder als Readiness-Prüfungen kategorisiert sind. Ein vollständiger Health-Check, der alle Prüfmodule anzeigt, ist ebenfalls verfügbar und sieht typischerweise wie dieses Beispiel aus.
Die Informationsendpunkte werden in einem JSON-Dokument als ein einzelnes JSON-Objekt auf oberster Ebene mit einer Reihe hierarchisch strukturierter Schlüssel und Werte definiert. In der Regel enthält das Dokument den Namen und die Version des Dienstes, die Architektur, den Hostnamen, Informationen zum Betriebssystem, die Prozess-ID, den Namen der ausführbaren Datei sowie Details zum Host, etwa eine Maschinen-ID oder eine eindeutige Dienst-ID.
Implementierung von Heap- und Core-Dumps
Wie Sie sich vielleicht aus der Tabelle in Vergleich der Tool-Funktionen mit der Wunschliste erinnern, unterstützt keines der Tools Laufzeitintrospektion oder Heap-/Core-Dumps. Spring als unser zugrunde liegendes Framework unterstützt jedoch beides – auch wenn es einige Arbeit erforderte, die Observability-Funktionen in die Anwendung zu integrieren. Wie im vorherigen Abschnitt ausführlich beschrieben, verwenden wir für die Laufzeitintrospektion ein Python-Modul in Verbindung mit Spring Boot Actuator.
Ebenso nutzen wir für Heap-Dumps die von Spring Boot Actuator bereitgestellten Thread-Dump-Endpunkte, um einen Teil der gewünschten Funktionen umzusetzen. Wir können zwar weder Core-Dumps bei Bedarf noch Heap-Dumps der JVM mit der gewünschten feinen Granularität erstellen, erhalten aber mit geringem Zusatzaufwand einen Teil der gewünschten Funktionalität. Core-Dumps für die Python-Dienste erfordern leider deutlich mehr Arbeit, die wir auf einen späteren Zeitpunkt verschoben haben.
Zusammenfassung
Nachdem wir viele Tränen vergossen und unsere Lebensentscheidungen infrage gestellt haben, haben wir uns auf die folgenden Technologien für Observability in MARA geeinigt (im Folgenden steht OTel für OpenTelemetry):
- Protokollierung (für alle Container) – Filebeat → Elasticsearch / Kibana
- Verteilte Ablaufverfolgung
- Java – Spring Cloud Sleuth → Spring Cloud Sleuth-Exporter für OTel → OTel Collector → austauschbare Exporter wie Jaeger, Lightstep, Splunk usw.
- Python – OTel-Python-Bibliotheken → OTel Collector → austauschbares Speichersystem
- NGINX und NGINX Plus (NGINX Ingress Controller wird noch nicht unterstützt) – NGINX OTel-Modul → OTel Collector → austauschbarer Exporter
- Erfassung von Metriken
- Java – Micrometer über Spring → Prometheus-Exporter → OTel Collector
- Python – Noch keine Implementierung
- Python WSGI – GUnicorn StatsD → Prometheus (über StatsD / ServiceMonitor)
- NGINX – Prometheus-Endpunkt → Prometheus (über ServiceMonitor)
- Fehleraggregation – Verteilte OTel-Traces → austauschbarer Exporter → Suchfunktion des Exporters zum Auffinden von Traces mit der Markierung
error - Integritätsprüfungen
- Java – Spring Boot Actuator → Kubernetes
- Python – Flask Management Endpoints-Modul → Kubernetes
- Laufzeit-Introspektion
- Java – Spring Boot Actuator
- Python – Flask Management Endpoints-Modul
- Heap-/Core-Dumps
- Java – Unterstützung für Thread-Dumps mit Spring Boot Actuator
- Python – Noch keine Unterstützung
Diese Implementierung ist eine Momentaufnahme. Sie wird sich im Laufe der weiteren Entwicklung definitiv verändern und weiterentwickeln. Demnächst werden wir die Anwendung umfangreichen Lasttests unterziehen. Wir erwarten, dabei viel über die Schwachstellen unseres Observability-Ansatzes zu lernen und zusätzliche Observability-Funktionen zu ergänzen.
Probieren Sie die Referenzarchitektur für moderne Anwendungen und die Beispielanwendung (Bank of Sirius) aus. Wenn Sie Ideen haben, wie wir uns verbessern können, freuen wir uns über Ihre Beiträge in unserem GitHub-Repository!
Verwandte Beiträge
Dieser Beitrag ist Teil einer Serie. Wir erweitern MARA laufend um neue Funktionen und veröffentlichen die Details dazu hier im Blog:
- Eine neue Open-Source-Referenzarchitektur für moderne Anwendungen
- Integration von OpenTelemetry in die Referenzarchitektur für moderne Apps – Ein Fortschrittsbericht (dieser Beitrag)
- MARA: Jetzt auch auf einer Workstation in Ihrer Nähe
- Vorstellung von Version 1.0.0 der NGINX-Referenzarchitektur für moderne Anwendungen
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.
Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.
Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.