Es ist allgemein bekannt, dass NGINX einen asynchronen, ereignisgesteuerten Ansatz zur Verarbeitung von Verbindungen verwendet. Das bedeutet, dass NGINX nicht für jede Anfrage einen eigenen Prozess oder Thread erstellt (wie Server mit herkömmlicher Architektur), sondern mehrere Verbindungen und Anfragen in einem einzigen Worker-Prozess verarbeitet. Dazu arbeitet NGINX mit Sockets im nicht blockierenden Modus und nutzt effiziente Verfahren wie epoll und kqueue.
Da die Anzahl vollwertiger Prozesse gering (in der Regel nur einer pro CPU-Kern) und konstant ist, wird deutlich weniger Arbeitsspeicher benötigt, und es werden keine CPU-Zyklen durch Taskwechsel verschwendet. Die Vorteile eines solchen Ansatzes sind am Beispiel von NGINX selbst hinlänglich bekannt. NGINX bewältigt erfolgreich Millionen gleichzeitiger Anfragen und lässt sich sehr gut skalieren.
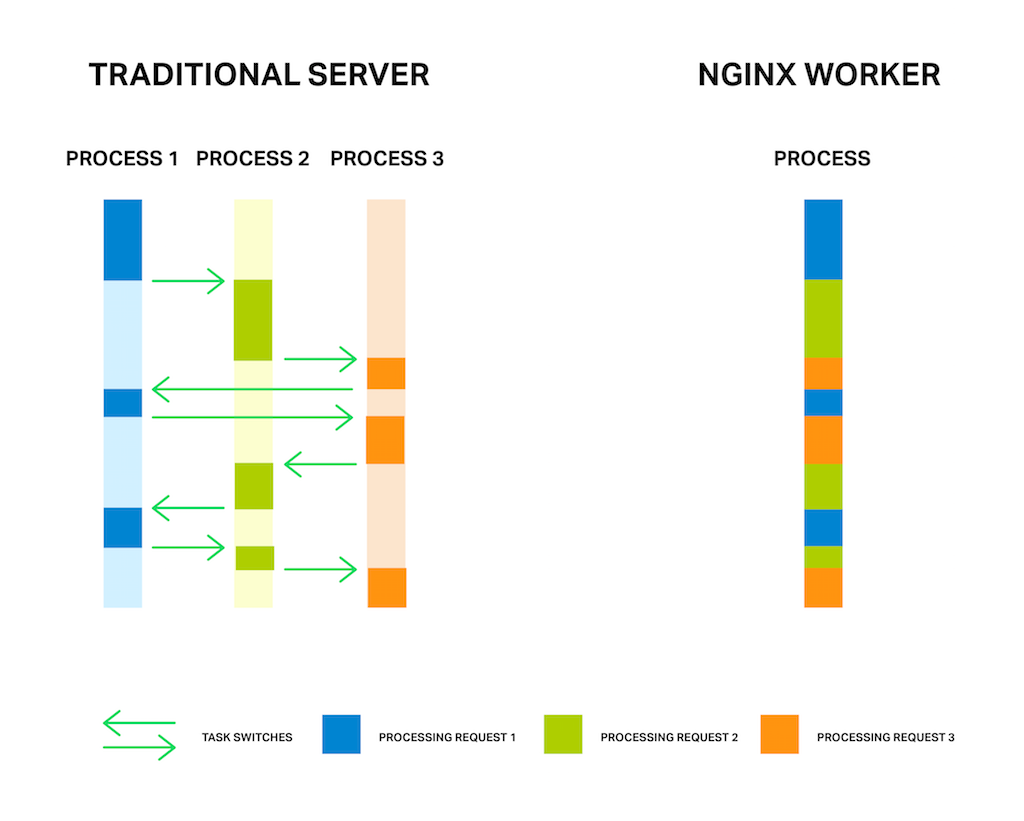
Doch der asynchrone, ereignisgesteuerte Ansatz hat nach wie vor ein Problem. Oder, wie ich es gerne nenne, einen „Feind“. Und dieser Feind heißt: Blockierung. Leider verwenden viele Module von Drittanbietern blockierende Aufrufe, und die Benutzer (und manchmal sogar die Entwickler der Module) sind sich der Nachteile nicht bewusst. Blockierende Operationen können die Leistung von NGINX erheblich beeinträchtigen und müssen unter allen Umständen vermieden werden.
Selbst im aktuellen offiziellen NGINX-Code lassen sich blockierende Operationen nicht in jedem Fall vermeiden. Um dieses Problem zu lösen, wurde der neue Mechanismus der „Thread-Pools“ in NGINX Version 1.7.11 implementiert sowie in NGINX Plus Release 7 eingeführt. Was es damit auf sich hat und wie dieser Mechanismus eingesetzt werden soll, behandeln wir später. Sehen wir unserem Feind nun direkt ins Auge.
Anmerkung der Redaktion – Einen Überblick über NGINX Plus R7 finden Sie in unserem Blogbeitrag „Ankündigung von NGINX Plus R7“.
Ausführliche Erläuterungen zu weiteren neuen Funktionen in NGINX Plus R7 finden Sie in diesen thematisch verwandten Blogbeiträgen:
- HTTP/2 wird jetzt vollständig in NGINX Plus unterstützt
- Socket-Sharding in NGINX
- Das neue NGINX Plus-Dashboard in Version 7<.htmla>
- TCP-Lastverteilung in NGINX Plus R7<.htmla>
Das Problem
Zunächst ein paar Worte zur Funktionsweise von NGINX, um das Problem besser zu verstehen.
Im Allgemeinen ist NGINX ein Event-Handler, also eine Steuerungskomponente, die vom Kernel Informationen über alle bei Verbindungen auftretenden Ereignisse erhält und dem Betriebssystem anschließend Anweisungen gibt, was zu tun ist. Tatsächlich übernimmt NGINX die gesamte anspruchsvolle Arbeit, indem es das Betriebssystem orchestriert, während das Betriebssystem die Routineaufgaben des Lesens und Sendens von Bytes erledigt. Daher ist es sehr wichtig, dass NGINX schnell und rechtzeitig reagiert.
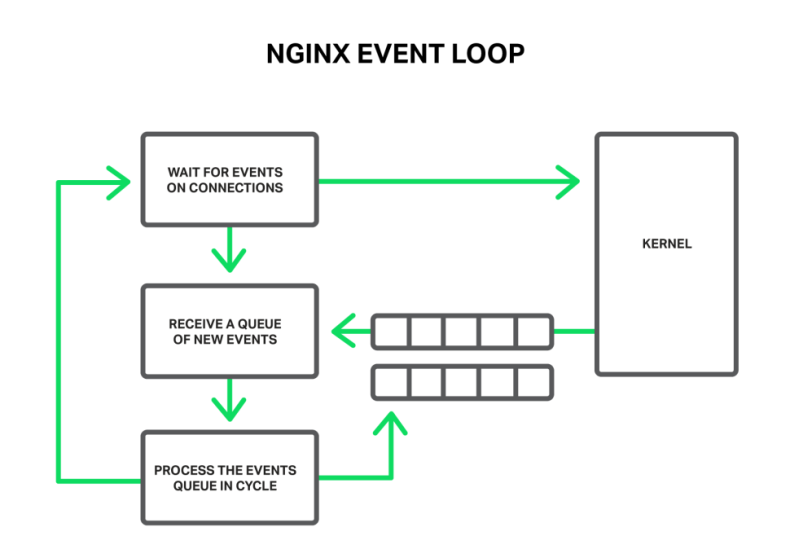
Bei den Ereignissen kann es sich um Zeitüberschreitungen, Benachrichtigungen über zum Lesen oder Schreiben bereite Sockets oder Meldungen über einen aufgetretenen Fehler handeln. NGINX empfängt eine Reihe von Ereignissen und verarbeitet sie anschließend nacheinander, indem es die erforderlichen Aktionen ausführt. Die gesamte Verarbeitung erfolgt somit in einer einfachen Schleife über eine Warteschlange in einem einzigen Thread. NGINX entnimmt ein Ereignis aus der Warteschlange und reagiert darauf, indem es beispielsweise in einen Socket schreibt oder daraus liest. In den meisten Fällen geschieht dies äußerst schnell (möglicherweise sind nur wenige CPU-Zyklen erforderlich, um einige Daten im Arbeitsspeicher zu kopieren), sodass NGINX alle Ereignisse in der Warteschlange im Handumdrehen abarbeitet.
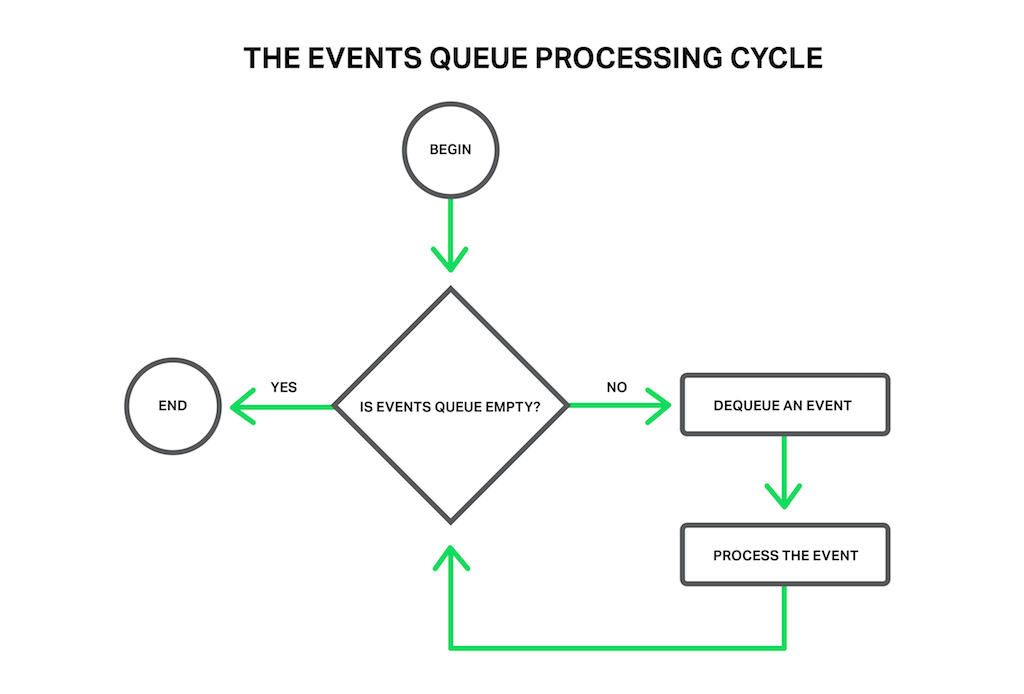
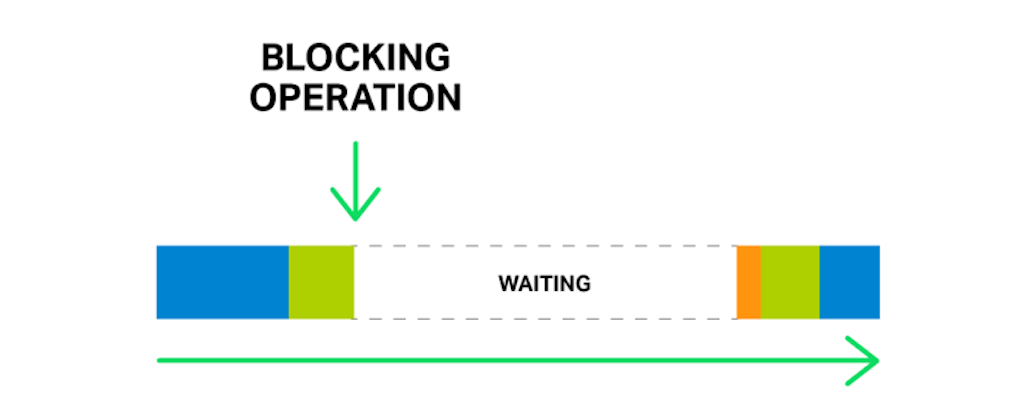
Aber was passiert, wenn ein langwieriger und rechenintensiver Vorgang ausgeführt wird? Dann bleibt der gesamte Zyklus der Ereignisverarbeitung hängen und wartet darauf, dass dieser Vorgang abgeschlossen wird.
Mit „blockierendem Vorgang“ meinen wir also jeden Vorgang, der den Zyklus der Ereignisverarbeitung für einen erheblichen Zeitraum anhält. Vorgänge können aus verschiedenen Gründen blockierend sein. Beispielsweise könnte NGINX mit einer langwierigen, CPU-intensiven Verarbeitung beschäftigt sein oder auf den Zugriff auf eine Ressource warten müssen (etwa auf eine Festplatte, einen Mutex oder den Aufruf einer Bibliotheksfunktion, die Antworten synchron aus einer Datenbank abruft usw.). Entscheidend ist, dass der Worker-Prozess während der Verarbeitung solcher Vorgänge nichts anderes tun und keine weiteren Ereignisse verarbeiten kann – selbst wenn zusätzliche Systemressourcen verfügbar sind und einige Ereignisse in der Warteschlange diese Ressourcen nutzen könnten.
Stellen Sie sich einen Verkäufer in einem Geschäft vor, vor dem sich eine lange Schlange gebildet hat. Der Erste in der Schlange fragt nach etwas, das nicht im Laden, sondern im Lager vorrätig ist. Der Verkäufer geht ins Lager, um die Ware zu holen. Nun muss die gesamte Schlange ein paar Stunden darauf warten, und alle Wartenden sind unzufrieden. Können Sie sich die Reaktion der Leute vorstellen? Für jeden in der Schlange verlängert sich die Wartezeit um diese Stunden, obwohl sich die Artikel, die sie kaufen möchten, möglicherweise direkt im Laden befinden.
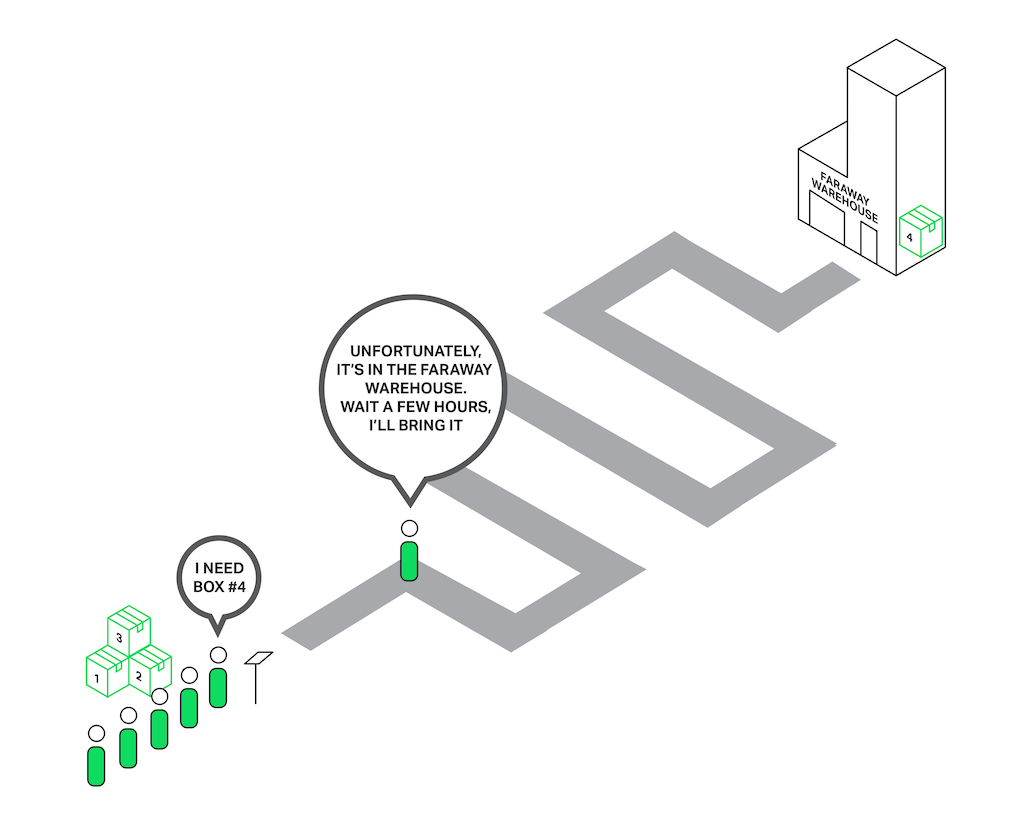
Fast die gleiche Situation tritt bei NGINX auf, wenn eine Datei gelesen werden soll, die nicht im Arbeitsspeicher zwischengespeichert ist, sondern von der Festplatte gelesen werden muss. Festplatten sind langsam (insbesondere solche mit rotierenden Scheiben), und obwohl die anderen in der Warteschlange stehenden Anfragen möglicherweise nicht auf die Festplatte zugreifen müssen, sind sie dennoch zum Warten gezwungen. Dadurch steigen die Latenzzeiten und die Systemressourcen werden nicht vollständig ausgelastet.
Einige Betriebssysteme stellen eine asynchrone Schnittstelle zum Lesen und Senden von Dateien bereit, die NGINX nutzen kann (siehe die Direktive aio). Ein gutes Beispiel hierfür ist FreeBSD. Leider lässt sich das über Linux nicht sagen. Linux bietet zwar eine Art asynchrone Schnittstelle zum Lesen von Dateien, diese weist jedoch einige erhebliche Nachteile auf. Einer davon sind die Ausrichtungsanforderungen für Dateizugriffe und Puffer, mit denen NGINX allerdings gut zurechtkommt. Das zweite Problem wiegt jedoch schwerer. Für die asynchrone Schnittstelle muss das Flag O_DIRECT für den Dateideskriptor gesetzt sein. Das bedeutet, dass bei jedem Zugriff auf die Datei der Arbeitsspeicher-Cache umgangen und die Festplatten stärker belastet werden. Daher ist diese Lösung für viele Anwendungsfälle definitiv nicht optimal.
Um insbesondere dieses Problem zu lösen, wurden in NGINX 1.7.11 und NGINX Plus Release 7 Thread-Pools eingeführt.
Sehen wir uns nun genauer an, was Thread-Pools sind und wie sie funktionieren.
Threadpools
Kehren wir zu unserem armen Verkäufer zurück, der Waren aus einem weit entfernten Lager holt. Doch inzwischen ist er klüger geworden (vielleicht nachdem ihn die aufgebrachte Kundenschar verprügelt hat?) und hat einen Lieferdienst beauftragt. Wenn nun jemand etwas aus dem weit entfernten Lager bestellt, fährt er nicht mehr selbst dorthin, sondern gibt den Auftrag einfach an den Lieferdienst weiter. Dieser kümmert sich um die Bestellung, während unser Verkäufer weiterhin andere Kunden bedient. So müssen nur diejenigen Kunden auf die Lieferung warten, deren Waren nicht im Geschäft vorrätig sind, während alle anderen sofort bedient werden können.
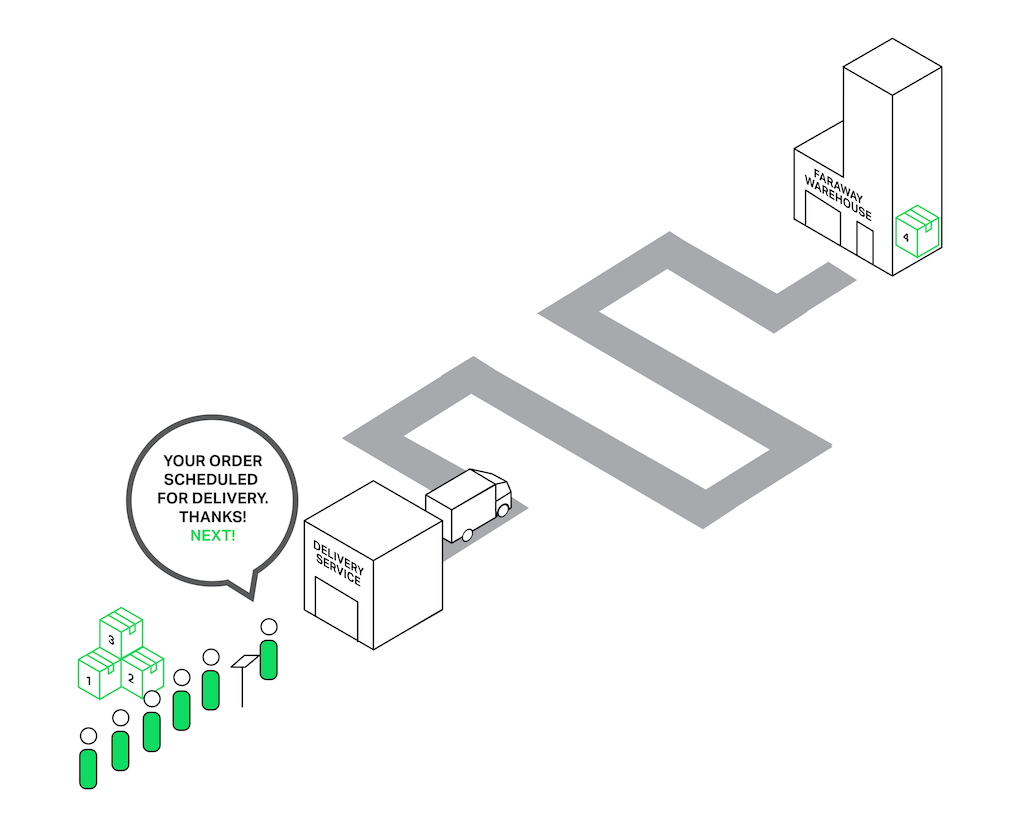
Bei NGINX übernimmt der Thread-Pool die Funktion des Lieferdienstes. Er besteht aus einer Aufgabenwarteschlange und mehreren Threads, die diese Warteschlange abarbeiten. Wenn ein Worker-Prozess einen potenziell langwierigen Vorgang ausführen muss, stellt er eine Aufgabe in die Warteschlange des Pools, anstatt den Vorgang selbst zu verarbeiten. Von dort kann sie von jedem freien Thread übernommen und verarbeitet werden.
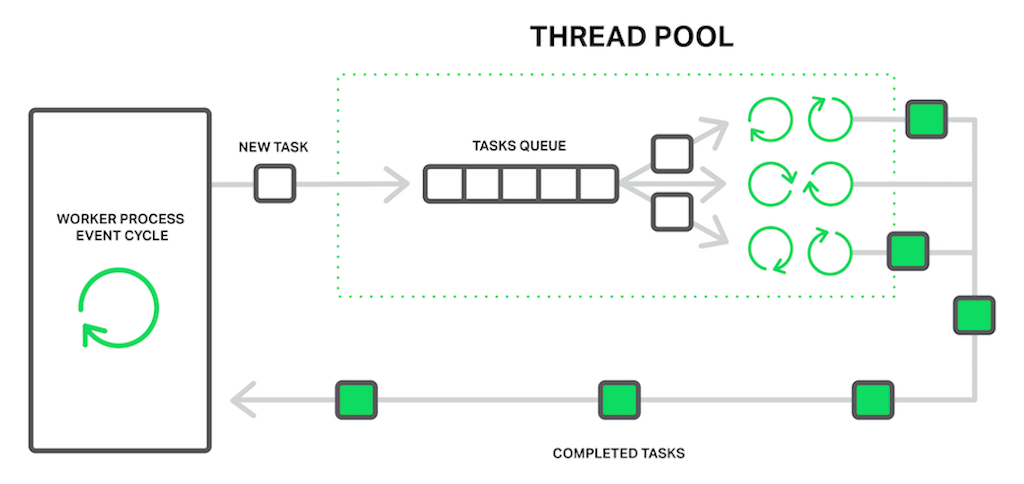
Anscheinend haben wir es also mit einer weiteren Warteschlange zu tun. Richtig. In diesem Fall wird die Warteschlange jedoch durch eine bestimmte Ressource begrenzt. Wir können Daten nicht schneller von einem Laufwerk lesen, als dieses sie bereitstellen kann. Zumindest verzögert das Laufwerk nun nicht mehr die Verarbeitung anderer Ereignisse, und nur die Anfragen, die auf Dateien zugreifen müssen, müssen warten.
Der Vorgang „Lesen von der Festplatte“ wird häufig als gängigstes Beispiel für einen blockierenden Vorgang angeführt. Tatsächlich kann die Threadpool-Implementierung in NGINX jedoch für alle Aufgaben verwendet werden, deren Verarbeitung im Hauptarbeitszyklus ungeeignet ist.
Derzeit ist die Auslagerung in Thread-Pools nur für drei wesentliche Operationen implementiert: den Systemaufruf read() auf den meisten Betriebssystemen, sendfile() unter Linux und aio_write() unter Linux, der beim Schreiben bestimmter temporärer Dateien verwendet wird, beispielsweise für den Cache. Wir werden die Implementierung weiterhin testen und Benchmarks durchführen. Wenn sich daraus ein klarer Vorteil ergibt, werden wir in zukünftigen Versionen möglicherweise weitere Operationen in die Thread-Pools auslagern.
Anmerkung der Redaktion – Die Unterstützung für den aio_write()-Systemaufruf wurde in NGINX 1.9.13 und NGINX Plus R9 hinzugefügt.
Benchmarking
Es ist an der Zeit, von der Theorie zur Praxis überzugehen. Um die Auswirkungen der Verwendung von Thread-Pools zu veranschaulichen, führen wir einen synthetischen Benchmark durch, der die ungünstigste Kombination aus blockierenden und nicht blockierenden Operationen simuliert.
Dafür ist ein Datensatz erforderlich, der garantiert nicht in den Arbeitsspeicher passt. Auf einem Rechner mit 48 GB RAM haben wir 256 GB Zufallsdaten in 4‑MB-Dateien erzeugt und anschließend NGINX 1.9.0 so konfiguriert, dass diese bereitgestellt werden.
Die Konfiguration ist recht einfach:
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}
Wie Sie sehen, wurden einige Optimierungen vorgenommen, um eine bessere Leistung zu erzielen: logging und accept_mutex wurden deaktiviert, sendfile wurde aktiviert und sendfile_max_chunk wurde festgelegt. Die letzte Direktive kann die maximale Dauer blockierender sendfile()-Aufrufe verkürzen, da NGINX nicht versucht, die gesamte Datei auf einmal zu senden, sondern sie in 512‑KB-Blöcken überträgt.
Der Rechner verfügt über zwei Intel-Xeon-E5645-Prozessoren (insgesamt 12 Kerne und 24 HT-Threads) sowie eine 10-Gbit/s-Netzwerkschnittstelle. Das Festplattensubsystem besteht aus vier Western-Digital-WD1003FBYX-Festplatten, die zu einem RAID-10-Verbund zusammengeschlossen sind. Auf dieser Hardware läuft Ubuntu Server 14.04.1 LTS.
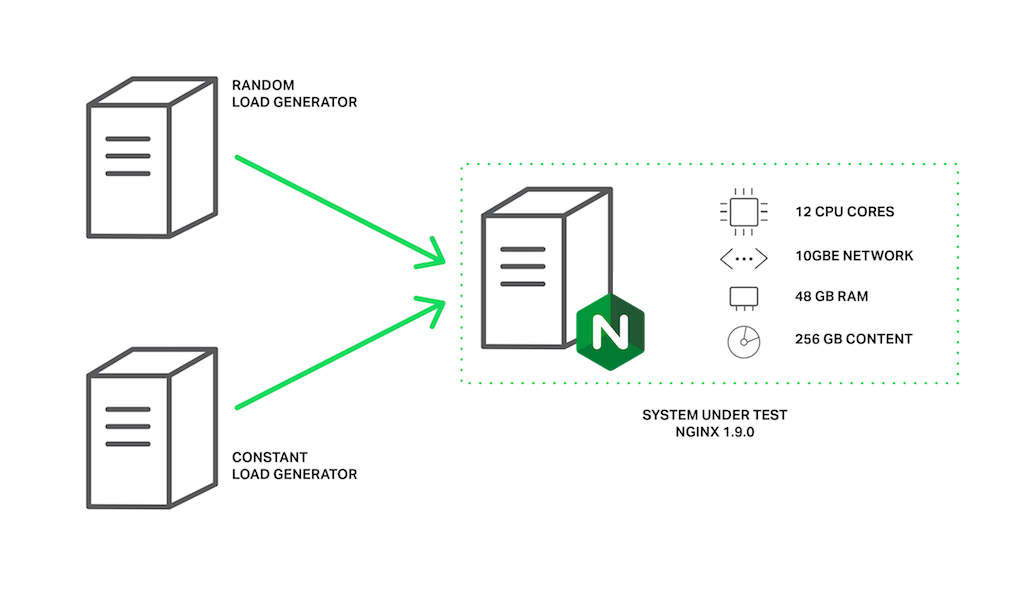
Die Clients werden durch zwei Rechner mit identischen Spezifikationen repräsentiert. Auf einem dieser Rechner erzeugt wrk mithilfe eines Lua-Skripts Last. Das Skript fordert Dateien in zufälliger Reihenfolge von unserem Server an und verwendet dabei 200 parallele Verbindungen. Jede Anfrage führt mit hoher Wahrscheinlichkeit zu einem Cache-Fehlschlag und einem blockierenden Lesezugriff auf die Festplatte. Bezeichnen wir diese Last als zufällige Last.
Auf dem zweiten Client-Rechner führen wir eine weitere Instanz von wrk aus, die dieselbe Datei über 50 parallele Verbindungen wiederholt anfordert. Da häufig auf diese Datei zugegriffen wird, verbleibt sie dauerhaft im Arbeitsspeicher. Unter normalen Umständen würde NGINX diese Anfragen sehr schnell verarbeiten. Die Leistung sinkt jedoch, wenn die Worker-Prozesse durch andere Anfragen blockiert werden. Bezeichnen wir diese Last als konstante Last.
Die Leistung wird gemessen, indem der Durchsatz des Servers mit ifstat überwacht und die wrk-Ergebnisse des zweiten Clients ausgewertet werden.
Der erste Durchlauf ohne Thread-Pools liefert uns nun keine besonders beeindruckenden Ergebnisse:
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
Wie Sie sehen können, kann der Server mit dieser Konfiguration insgesamt etwa 1 Gbit/s Datenverkehr erzeugen. In der Ausgabe von top sehen wir, dass alle Worker-Prozesse die meiste Zeit mit blockierenden E/A-Vorgängen verbringen (sie befinden sich im Zustand D):
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart    20   0   40304   4160    2208 S   0.0  0.0  0:00.53 zsh
In diesem Fall wird der Durchsatz durch das Festplattensubsystem begrenzt, während die CPU die meiste Zeit im Leerlauf ist. Auch die Ergebnisse von wrk sind sehr niedrig:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
Und nicht vergessen: Hier geht es um die Datei, die aus dem Arbeitsspeicher ausgeliefert werden sollte! Die extrem hohen Latenzen entstehen, weil alle Worker-Prozesse damit beschäftigt sind, Dateien von den Laufwerken zu lesen, um die durch 200 Verbindungen des ersten Clients erzeugte zufällige Last zu bewältigen, und unsere Anfragen daher nicht rechtzeitig bearbeiten können.
Jetzt ist es an der Zeit, unsere Thread-Pools ins Spiel zu bringen. Dazu fügen wir einfach die Direktive aio threads zum location-Block hinzu:
location / {    root /storage;
    aio threads;
}
und weisen Sie NGINX an, seine Konfiguration neu zu laden.
Danach wiederholen wir den Test:
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
Jetzt erreicht unser Server 9,5 Gbit/s, verglichen mit etwa 1 Gbit/s ohne Thread-Pools!
Wahrscheinlich könnte er sogar noch mehr leisten, aber die praktisch maximal mögliche Netzwerkkapazität ist bereits erreicht. Daher wird NGINX in diesem Test durch die Netzwerkschnittstelle begrenzt. Die Worker-Prozesse verbringen die meiste Zeit damit, einfach zu schlafen und auf neue Ereignisse zu warten (sie befinden sich in S Status in top):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
Es sind noch reichlich CPU-Ressourcen verfügbar.
Die Ergebnisse von wrk:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
Die durchschnittliche Zeit für die Bereitstellung einer 4‑MB-Datei wurde von 7,42 Sekunden auf 226,32 Millisekunden reduziert (33‑mal kürzer), und die Anzahl der Anfragen pro Sekunde ist um das 31‑Fache gestiegen (250 gegenüber 8)!
Der Grund dafür ist, dass unsere Anfragen nicht mehr in der Ereigniswarteschlange auf ihre Verarbeitung warten, während die Worker-Prozesse durch Lesevorgänge blockiert sind, sondern von freien Threads bearbeitet werden. Während das Festplattensubsystem die zufällige Last des ersten Client-Rechners so gut wie möglich bewältigt, nutzt NGINX die verbleibenden CPU-Ressourcen und Netzwerkkapazitäten, um die Anfragen des zweiten Clients aus dem Arbeitsspeicher zu bedienen.
Noch immer kein Allheilmittel
Nach all unseren Befürchtungen hinsichtlich blockierender Operationen und einigen vielversprechenden Ergebnissen planen die meisten von Ihnen wahrscheinlich bereits, Thread-Pools auf Ihren Servern zu konfigurieren. Überstürzen Sie nichts.
Tatsächlich greifen die meisten Dateioperationen zum Lesen und Senden glücklicherweise nicht auf langsame Festplatten zu. Wenn genügend RAM für den Datensatz vorhanden ist, ist das Betriebssystem intelligent genug, häufig verwendete Dateien in einem sogenannten „Seitencache“ zwischenzuspeichern.
Der Seitencache funktioniert ziemlich gut und ermöglicht NGINX in fast allen gängigen Anwendungsfällen eine hervorragende Leistung. Das Lesen aus dem Seitencache geht recht schnell, und niemand würde solche Vorgänge als „blockierend“ bezeichnen. Andererseits verursacht die Auslagerung in einen Thread-Pool einen gewissen Overhead.
Wenn Sie also über ausreichend RAM verfügen und Ihr aktiver Datensatz nicht sehr groß ist, arbeitet NGINX bereits ohne den Einsatz von Thread-Pools optimal.
Das Auslagern von Lesevorgängen in den Thread-Pool ist eine Technik, die sich für sehr spezifische Aufgaben eignet. Sie ist besonders dann nützlich, wenn die Menge der häufig angeforderten Inhalte nicht in den VM-Cache des Betriebssystems passt. Dies kann beispielsweise bei einem stark ausgelasteten, auf NGINX basierenden Streaming-Media-Server der Fall sein. Diese Situation haben wir in unserem Benchmark simuliert.
Es wäre großartig, wenn wir die Auslagerung von Lesevorgängen in Thread-Pools verbessern könnten. Wir benötigen lediglich eine effiziente Möglichkeit, festzustellen, ob sich die benötigten Dateidaten im Arbeitsspeicher befinden. Nur wenn dies nicht der Fall ist, sollte der Lesevorgang an einen separaten Thread ausgelagert werden.
Um auf unsere Verkaufsanalogie zurückzukommen: Der Verkäufer kann derzeit nicht wissen, ob sich der gewünschte Artikel im Geschäft befindet, und muss daher entweder stets alle Bestellungen an den Lieferdienst weiterleiten oder sie immer selbst bearbeiten.
Der Grund dafür ist, dass diese Funktion in Betriebssystemen fehlt. Erste Versuche, sie in Form des Systemaufrufs fincore() in Linux zu integrieren, gab es 2010, doch daraus wurde nichts. Später folgten mehrere Versuche, sie als neuen Systemaufruf preadv2() mit dem Flag RWF_NONBLOCK zu implementieren (Einzelheiten dazu finden Sie in den LWN.net-Artikeln „Nicht blockierende gepufferte Dateilesevorgänge“ und „Asynchrone gepufferte Lesevorgänge“). Das Schicksal all dieser Patches ist nach wie vor unklar. Bedauerlicherweise scheint der Hauptgrund dafür, dass diese Patches noch nicht in den Kernel aufgenommen wurden, in endlosen Detaildiskussionen zu liegen.
Andererseits müssen sich FreeBSD-Benutzer überhaupt keine Sorgen machen. FreeBSD verfügt bereits über eine ausreichend gute asynchrone Schnittstelle zum Lesen von Dateien, die Sie anstelle von Thread-Pools verwenden sollten.
Threadpools konfigurieren
Wenn Sie also sicher sind, dass der Einsatz von Thread-Pools für Ihren Anwendungsfall Vorteile bietet, ist es an der Zeit, sich eingehend mit der Konfiguration zu befassen.
Die Konfiguration ist recht einfach und flexibel. Zunächst benötigen Sie NGINX ab Version 1.7.11, das mit dem Argument --with-threads für den Befehl configure kompiliert wurde. Benutzer von NGINX Plus benötigen Release 7 oder höher. Im einfachsten Fall ist die Konfiguration sehr übersichtlich. Sie müssen lediglich die Direktive aio threads im entsprechenden Kontext einfügen:
# in the 'http', 'server', or 'location' contextaio threads;Dies ist die kleinstmögliche Konfiguration von Thread-Pools. Tatsächlich handelt es sich dabei um eine Kurzfassung der folgenden Konfiguration:
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;
Damit wird ein Thread-Pool namens „default“ mit 32 Arbeitsthreads und einer maximalen Länge der Aufgabenwarteschlange von 65536 Aufgaben definiert. Wenn die Aufgabenwarteschlange überlastet ist, lehnt NGINX die Anfrage ab und protokolliert diesen Fehler:
thread pool "NAME" queue overflow: N tasks waitingDer Fehler bedeutet, dass die Threads die Aufgaben möglicherweise nicht so schnell verarbeiten können, wie sie der Warteschlange hinzugefügt werden. Sie können versuchen, die maximale Größe der Warteschlange zu erhöhen. Wenn das jedoch nicht hilft, deutet dies darauf hin, dass Ihr System nicht in der Lage ist, so viele Anfragen zu verarbeiten.
Wie Sie bereits festgestellt haben, können Sie mit der Direktive „thread_pool“ die Anzahl der Threads, die maximale Länge der Warteschlange und den Namen eines bestimmten Thread-Pools konfigurieren. Letzteres bedeutet, dass Sie mehrere unabhängige Thread-Pools konfigurieren und sie an verschiedenen Stellen Ihrer Konfigurationsdatei für unterschiedliche Zwecke verwenden können:
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
Wenn der Parameter max_queue nicht angegeben ist, wird standardmäßig der Wert 65536 verwendet. Wie gezeigt, kann max_queue auf null gesetzt werden. In diesem Fall kann der Thread-Pool nur so viele Aufgaben verarbeiten, wie Threads konfiguriert sind; es warten keine Aufgaben in der Warteschlange.
Stellen wir uns nun vor, Sie haben einen Server mit drei Festplatten und möchten, dass dieser als „Caching-Proxy“ fungiert, der alle Antworten Ihrer Backends zwischenspeichert. Die erwartete Menge der zwischengespeicherten Daten übersteigt den verfügbaren Arbeitsspeicher bei Weitem. Im Grunde handelt es sich um einen Caching-Knoten für Ihr persönliches CDN. In diesem Fall kommt es natürlich vor allem darauf an, die maximale Leistung aus den Festplatten herauszuholen.
Eine Möglichkeit besteht darin, einen RAID-Verbund zu konfigurieren. Dieser Ansatz hat Vor- und Nachteile. Mit NGINX steht Ihnen nun eine weitere Möglichkeit zur Verfügung:
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}
In dieser Konfiguration definieren die thread_pool-Direktiven für jede Festplatte einen eigenen, unabhängigen Thread-Pool und die proxy_cache_path-Direktiven einen eigenen, unabhängigen Cache auf jeder Festplatte.
Das split_clients-Modul wird für den Lastenausgleich zwischen den Caches (und damit auch zwischen den Festplatten) verwendet und eignet sich daher perfekt für diese Aufgabe.
Der Parameter „use_temp_path=off“ der Direktive „proxy_cache_path“ weist NGINX an, temporäre Dateien in denselben Verzeichnissen zu speichern, in denen sich die entsprechenden Cache-Daten befinden. Dadurch wird vermieden, dass beim Aktualisieren unserer Caches Antwortdaten zwischen den Festplatten kopiert werden.
All dies zusammen ermöglicht es uns, die maximale Leistung aus dem aktuellen Festplattensubsystem herauszuholen, da NGINX über separate Thread-Pools parallel und unabhängig mit den Laufwerken interagiert. Jedes Laufwerk wird von 16 unabhängigen Threads mit einer eigenen Aufgabenwarteschlange zum Lesen und Senden von Dateien bedient.
Ich wette, Ihre Kunden schätzen diesen maßgeschneiderten Ansatz. Und seien Sie versichert: Auch Ihre Festplatten werden ihn mögen.
Dieses Beispiel veranschaulicht sehr gut, wie flexibel NGINX speziell auf Ihre Hardware abgestimmt werden kann. Es ist, als würden Sie NGINX Anweisungen dazu geben, wie es am besten mit dem Rechner und Ihrem Datensatz interagieren soll. Durch die Feinabstimmung von NGINX im Userspace können Sie sicherstellen, dass Ihre Software, Ihr Betriebssystem und Ihre Hardware optimal zusammenarbeiten, um sämtliche Systemressourcen so effizient wie möglich zu nutzen.
Fazit
Zusammenfassend lässt sich sagen, dass Thread-Pools eine großartige Funktion sind, die NGINX zu neuen Leistungsdimensionen verhilft, indem sie einen seiner bekannten und langjährigen Gegner beseitigen: blockierende Vorgänge – insbesondere bei sehr großen Inhaltsmengen.
Und es kommt noch mehr. Wie bereits erwähnt, ermöglicht diese brandneue Schnittstelle potenziell die Auslagerung beliebiger langwieriger und blockierender Vorgänge ohne Leistungseinbußen. NGINX eröffnet neue Horizonte für eine Vielzahl neuer Module und Funktionen. Viele beliebte Bibliotheken bieten nach wie vor keine asynchrone, nicht blockierende Schnittstelle, weshalb sie bisher nicht mit NGINX kompatibel waren. Wir könnten viel Zeit und Ressourcen in die Entwicklung eines eigenen nicht blockierenden Prototyps einer Bibliothek investieren, aber lohnt sich dieser Aufwand wirklich immer? Mit Thread-Pools lassen sich solche Bibliotheken nun relativ einfach nutzen und entsprechende Module ohne Leistungseinbußen entwickeln.
Bleiben Sie dran.
Testen Sie Thread-Pools in NGINX Plus selbst – starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.