Vor über zehn Jahren habe ich als Solutions Engineer miterlebt, wie Unternehmen begannen, Kubernetes als Nebenprojekt einzusetzen. Es war ein inoffizielles Experiment, das oft parallel zu Tests anderer Container-Scheduler lief. Die eigentlichen Workloads liefen weiterhin auf virtuellen Maschinen in vSphere – einer Umgebung, die auf Service-Level- und Wiederherstellungszeitziele ausgelegt war. Alle waren daran beteiligt, nicht nur die Serveradministratoren. Das war, wenn man so will, unternehmenstauglich.
Dann kam Bewegung in die Sache. Die Public Cloud erlebte einen Aufschwung, Anwendungen wurden modernisiert und Kubernetes wurde zum Standard für den Betrieb containerisierter Anwendungen in Unternehmen. Die treibende Kraft war dieselbe wie immer: das Geschäft, das schnell skalieren musste. Unternehmen wollten schneller vorankommen, und ich begleitete viele Kunden der ersten Stunde bei dem Versuch, Kubernetes zu einer Enterprise-Plattform zu machen.
Für diese Kunden gaben die Erwartungen des Unternehmens das Ziel vor. Ein experimentelles Projekt wird nach bestem Bemühen vorangetrieben – wenn überhaupt. Eine Unternehmensplattform muss mit dem Unternehmen Schritt halten und wird im Idealfall zu einem entscheidenden Faktor für seine Wettbewerbsfähigkeit. An Kubernetes werden inzwischen genau diese Erwartungen gestellt, doch für sich genommen ist es keine vollständige Plattform, wie es vSphere ist. Seine Open-Source-Basis ist großartig, aber sie ist erst der Anfang.
Eine neue Studie, die F5 bei SlashData in Auftrag gegeben hat, zeigt, wie groß die Lücke zu den Anforderungen im Unternehmenseinsatz ist. Von den Unternehmen, die Kubernetes produktiv einsetzen, legen 61 % dieselben oder höhere Maßstäbe an wie an ihre übrige IT-Landschaft. Dennoch erreichen nur 38 % einen Reifegrad, der den Anforderungen im Unternehmenseinsatz gerecht wird.
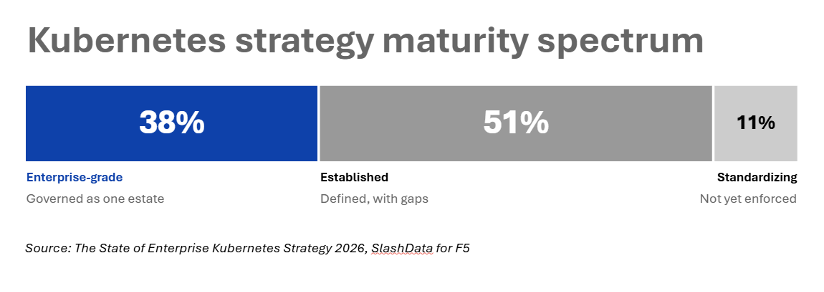
In dem Bericht bedeutet „Enterprise-Grade“ mehr als eine hohe Punktzahl. Vorausgesetzt werden eine automatisierte Zulassungssteuerung, eine konsequent durchgesetzte Mandantenisolierung, zentrale Observability, dokumentierte Wiederherstellungsziele und ein innerhalb der letzten zwölf Monate getestetes Failover. Die Umfrage bewertete, was Teams tatsächlich tun – nicht, wie hoch sie ihren eigenen Reifegrad einschätzen. Grundlage waren 445 Antworten von Fachkräften aus der Praxis in Unternehmen mit mehr als 500 Beschäftigten, die im August 2026 erhoben wurden.
Die meisten IT-Landschaften sind etabliert, aber nicht ausgereift
Ich sehe die Definitionen des Berichts als Wegmarken auf einer Reise, auf der sich alle befinden. Ich bezweifle, dass eine Organisation jemals am Ziel ist, und bei der Prioritätensetzung sind immer Kompromisse nötig. Der Bericht liefert uns eine Momentaufnahme davon, wo Unternehmen heute stehen. Die Hälfte der Unternehmen (51 %) fällt in die Kategorie „etabliert“: Standards sind definiert und werden weitgehend durchgesetzt, allerdings gibt es erkennbare Lücken. Weitere 11 % befinden sich noch in der Standardisierungsphase. Fast neun von zehn Unternehmen (88 %) erreichen in mindestens einem Bereich die höchste Stufe, aber nur 22 % schaffen dies in allen vier Bereichen. Selbst unter den 51 % der Unternehmen, die insgesamt 80 oder mehr Punkte erzielen, erfüllt jedes vierte (24 %) eine einzelne Voraussetzung nicht und verfehlt dadurch die höchste Stufe.
Observability ist der Baustein, der am häufigsten fehlt. Unter den Unternehmen, die die höchste Stufe knapp verfehlen, fehlt es 36 % an zentralisierter Observability und 31 % an automatisierter Admission Control. Beides deckt sich mit meinen Erfahrungen aus der Praxis. Bei den meisten meiner Kunden war Observability die entscheidende Lücke – unabhängig davon, ob Kubernetes im Einsatz war oder nicht. Die Fehlerbehebung war schwierig, band weit mehr Personen ein als nötig und endete allzu oft in gegenseitigen Schuldzuweisungen.
Admission Control ist aufgrund der Skalierung wichtig. Ein Kunde setzte bei der Verwaltung von vSphere wegen der Größe seiner Umgebung stark darauf. Kubernetes-Umgebungen wachsen schnell, und die im Bericht am häufigsten genannte Herausforderung ist die Komplexität der Verwaltung von Clustern und Umgebungen (39 %). Kontrollmechanismen, die in großen Umgebungen wichtig sind, werden früher relevant, als die meisten Teams erwarten. Dennoch planen nur 28 %, in den nächsten zwölf Monaten in Observability zu investieren, während 42 % in Sicherheit und die Durchsetzung von Richtlinien investieren wollen.
Reife ist ein Teamsport
Im Laufe der Jahre spielten die verschiedenen Rollen eine größere Rolle, als ich erwartet hatte. Ich kam mit den Plattform- und DevOps-Teams ins Gespräch, weil sie NGINX kannten, darauf vertrauten und es einsetzen wollten. Außerdem traf ich die Netzwerk- und Sicherheitsteams, die sicherstellen wollten, dass sich Kubernetes in die NetOps- und SecOps-Praktiken ihres Unternehmens integrieren ließ, statt völlig separate Arbeitsabläufe zu schaffen.
Ein Kunde tat etwas, das damals ungewöhnlich war: Er stellte seinem DevOps-Engineer einen eigenen F5 BIG-IP zur Verfügung. Der Engineer lernte das System bis ins Detail kennen und brachte es dazu, Dinge zu tun, die ich traditionelle BIG-IP-Administratoren nur selten selbst hatte umsetzen sehen (viele Grüße an Steven!). Das war gelebtes Vertrauen. Erfolg entstand immer durch Partnerschaft und Vertrauen, denn Ergebnisse auf Enterprise-Niveau setzen voraus, dass Teams sich aufeinander verlassen, statt aneinander vorbeizuarbeiten.
Die Forschungsergebnisse weisen in dieselbe Richtung. Wenn ein dediziertes Platform-Engineering-Team Kubernetes betreibt und ein separates, zentrales Sicherheitsteam die Richtlinien festlegt, erreichen 66 % der Unternehmen einen unternehmensgerechten Reifegrad – etwa doppelt so viele wie bei anderen Organisationsmodellen. Nur 19 % arbeiten auf diese Weise. Auch die Breite des Einsatzes ist entscheidend: 53 % der Unternehmen, die Kubernetes unternehmensweit als Standardplattform einsetzen, erreichen die höchste Reifestufe. Bei Unternehmen, in denen Kubernetes nur von einem einzelnen Team genutzt wird, sind es dagegen 25 %.
Das ist eine Korrelation, kein Beleg für einen ursächlichen Zusammenhang. Größere Organisationen, die sich stärker engagieren, neigen möglicherweise einfach eher dazu, die Arbeit auf diese Weise aufzuteilen. Dennoch deckt sich das mit meiner Erfahrung: Die Teams, die sich die Arbeit teilen und darauf vertrauen, dass alle ihren Teil übernehmen, sind diejenigen, die das erforderliche Reifeniveau für den unternehmensweiten Einsatz erreichen.
KI entwickelt sich schneller als die Governance
Ich habe auch die Anfänge dieser Entwicklung miterlebt. Ein Unternehmen führte in rascher Folge Machine-Learning-Workloads ein, die zunehmend geschäftskritisch wurden. Dieser Geschäftsbereich war das Innovationszentrum eines ansonsten eher traditionell aufgestellten Unternehmens. Bei einem solchen Tempo kann die Governance auf der Strecke bleiben.
Von den Unternehmen, die Kubernetes produktiv einsetzen, stellen 45 % Modelle bereit oder betreiben sie für Inferenzanfragen. 86 % dieser Unternehmen haben ihre bestehende Web Application Firewall (WAF) oder ihren API-Schutz auf diesen Datenverkehr ausgeweitet. KI-spezifische Kontrollen hinken hinterher. Nur 43 % überprüfen Agenten-Tools und den Datenverkehr des Model Context Protocol (MCP), während 49 % dies innerhalb der nächsten zwölf Monate planen. Ausgereifte IT-Umgebungen liegen bei der Ratenbegrenzung und bei Token-Kontingenten vorn (80 % gegenüber 50 %), doch bei der Überprüfung von Prompts und MCP-Datenverkehr verschwindet dieser Vorsprung. Bewährte Governance-Praktiken für traditionelle Workloads helfen, decken aber noch nicht alles ab.
Was die Forschungsergebnisse für Ihren Stack bedeuten
Die Studie verweist nicht auf ein einzelnes Produkt. Sie zeigt Lücken auf, die sich bestimmten Zuständigkeitsbereichen zuordnen lassen. Observability beginnt mit Telemetrie am Edge und fällt damit in die Zuständigkeit der Plattform- und Netzwerkteams. Bei Web application and API protection (WAAP) zeigt sich eine der größten technologischen Lücken zwischen den Reifegraden: 69 % der IT-Umgebungen auf Enterprise-Niveau setzen diese Technologie ein, gegenüber 50 % der übrigen Umgebungen. Die zugehörigen Richtlinien liegen in der Verantwortung der Sicherheitsteams und müssen von jedem Cluster übernommen werden. Failover muss clusterübergreifend getestet werden, was eine Zusammenarbeit von Netzwerk- und Plattformteams erfordert.
Der Ansatz von F5 orientiert sich daran, wie diese Teams tatsächlich arbeiten. Kubernetes-Teams beginnen mit Open Source, da ein Software-Stack wie Kubernetes dies zum Standard macht. Sie können mit Projekten wie NGINX Ingress Controller beginnen, einer langfristig unterstützten Ingress-Lösung trotz der Einstellung des Community-Projekts ingress-nginx, oder mit NGINX Gateway Fabric, das vollständig Gateway-API-konform ist.
Mit der Zeit wünschen sie sich die Sicherheit, die eine kommerzielle Lösung bietet. Dann wechseln sie zu F5 NGINX Enterprise – für gehärtete Images, Identitätsmanagement am Edge, anwendungsspezifische Sicherheitsrichtlinien, Support-SLAs oder die Skalierung ganzer Flotten.
Netzwerk- und Sicherheitsteams möchten Kubernetes in ihre bestehenden Arbeitsabläufe integrieren. Daher ermöglicht es ihnen F5 BIG-IP mit Container Ingress Services (CIS), zentrale Richtlinien für Datenverkehr und Sicherheit sowie clusterübergreifendes Failover über BIG-IP umzusetzen, während Plattformteams weiterhin in Kubernetes arbeiten.
Für KI-Workloads, die in der Größenordnung einer Neocloud oder einer KI-Fabrik ausgeführt werden, erweitert F5 BIG-IP Next for Kubernetes diesen Ansatz um Traffic-Management und Sicherheit, die speziell für KI in Kubernetes entwickelt wurden. Jedes Team arbeitet weiterhin mit seinen vertrauten Tools, während der gemeinsame Kontrollpunkt dafür sorgt, dass alle aufeinander abgestimmt bleiben.
Unser ergänzendes Whitepaper gliedert dies in vier Phasen mit jeweils klaren Abschlusskriterien. Der Zeitplan dient als Orientierung. Beginnen Sie daher mit der Phase, die Ihrem aktuellen Reifegrad entspricht, und passen Sie den Zeitplan an Ihre Gegebenheiten an.
- Standardisieren (Monate 0–3): ein unterstütztes Ingress-Muster in jedem Cluster, Edge-Telemetrie sowie klar definierte Plattform- und Sicherheitsrollen.
- Etablieren (Monate 3–9): ein Gateway-API-Standard, eine WAF für vererbte Sicherheit und zentralisierte Telemetrie.
- Enterprise-Niveau (Monate 9–18): automatisierte Zulassungskontrolle, ein zentraler Kontrollpunkt für Datenverkehr und Richtlinien sowie getestetes Failover.
- Optimieren (ab Monat 18): KI-Leitplanken, Richtlinien als Code und vierteljährliche Neubewertung des Reifegrads.
In Phase 4 kommt KI wieder ins Spiel, etwa bei den zuvor erwähnten Machine-Learning-Workloads. Teams erreichen diese Phase auf der Grundlage, die sie bereits mit F5 NGINX Enterprise und BIG-IP mit CIS geschaffen haben. Für die Skalierung von Neoclouds und KI-Fabriken lässt sich diese Grundlage um BIG-IP Next for Kubernetes erweitern. Unabhängig von der Größenordnung funktioniert die Technologie nur so gut wie die Partnerschaften, auf denen sie aufbaut.
Finden Sie Ihren Ausgangspunkt. Laden Sie eine Roadmap herunter, um Ihren Kubernetes-Reifegrad auf Enterprise-Niveau zu bringen – mit einer Selbsteinschätzung und einem Schritt-für-Schritt-Plan. Lesen Sie anschließend Der Stand der Kubernetes-Strategie in Unternehmen 2026, um die vollständigen Studienergebnisse zu erhalten.
Lesen Sie auch unseren Blogbeitrag „Cloudnative-Traffic-Steuerung und Sicherheit für Kubernetes – entwickelt für jedes Team“.
Über den Autor
Ähnliche Blogbeiträge

Wie CISOs KI-Sicherheitsrisiken messen können
Erfahren Sie, wie CASI, ARS und die Threat Intelligence von F5 Labs CISOs dabei unterstützen, KI-Sicherheitsrisiken über den gesamten KI-Lebenszyklus hinweg zu bewerten.
Drei Kräfte, die die Sicherheitsführung neu gestalten: verteilte KI-Inferenz, Bedrohungsentwicklung und hybride Multicloud
Entdecken Sie die neuesten KI-Trends, die die Sicherheitslandschaft rasant verändern.
F5-Bericht 2026: KI-Inferenz ist angekommen und macht eine ohnehin komplexe IT-Landschaft noch komplizierter
Neu veröffentlichte Forschungsergebnisse von F5 zeigen, dass die Mehrheit der Unternehmen KI-Inferenz intern durchführt und ein durchschnittliches Unternehmen inzwischen sieben KI-Modelle nutzt.
Inferenz: Der wichtigste Teil der KI, von dem du so tust, als gäbe es ihn nicht
KI zu skalieren bedeutet, die Inferenz zu skalieren. Erfahren Sie, warum Inferenzserver für die Verwaltung von Leistung, Telemetrie und Sicherheit bei produktiven KI-Workloads entscheidend sind.
Umgang mit Anwendungsschwachstellen: Best Practices für Sicherheitstests
Sowohl das Ausmaß als auch die Komplexität von Anwendungsschwachstellen nehmen rasant zu. Erfahren Sie, warum ein proaktiver, mehrschichtiger Ansatz für Sicherheitstests unerlässlich ist.
Wie steht SecOps zu KI?
F5 führte eine umfassende Stimmungsanalyse unter Sicherheitsexperten auf Reddit durch, um ihre Ansichten zu KI zu untersuchen.