編集部 – 全7回の記事シリーズが完結しました:
- マイクロサービス入門
- マイクロサービスの構築:APIゲートウェイの使用
- マイクロサービスの構築:マイクロサービスアーキテクチャにおけるプロセス間通信
- マイクロサービスアーキテクチャにおけるサービスディスカバリ
- マイクロサービス向けイベント駆動型データ管理(本記事)
- マイクロサービスのデプロイ戦略の選択
- モノリスからマイクロサービスへのリファクタリング
一連の記事すべてと、NGINX Plusを使用したマイクロサービスの実装に関する情報をまとめた電子書籍「マイクロサービス:設計からデプロイまで」もダウンロードできます。また、マイクロサービスリファレンスアーキテクチャのシリーズとマイクロサービスソリューションのページもご覧ください。
本記事は、マイクロサービスを使用したアプリケーション構築について解説するシリーズの第5回です。第1回では、マイクロサービスアーキテクチャパターンを紹介し、マイクロサービスを使用するメリットとデメリットについて説明しています。シリーズの第2回<.htmla>と第3回では、マイクロサービスアーキテクチャ内の通信について、さまざまな側面から説明しています。第4回では、これと密接に関連するサービスディスカバリの問題を取り上げています。本記事では視点を変え、マイクロサービスアーキテクチャで生じる分散データ管理の問題について説明します。
マイクロサービスと分散データ管理の課題
モノリシックアプリケーションでは通常、単一のリレーショナルデータベースを使用します。リレーショナルデータベースを使用する主な利点の1つは、アプリケーションで「ACIDトランザクション」を利用でき、次のような重要な特性が保証されることです。
- 原子性 – 変更は不可分な単位として行われます
- 一貫性 – データベースの状態は常に一貫しています
- 分離性 – トランザクションが同時に実行されても、逐次実行されているように見える
- 永続性 – トランザクションは一度コミットされると取り消されない
そのため、アプリケーションでは、トランザクションを開始し、複数の行を変更(挿入、更新、削除)して、トランザクションをコミットするだけで済みます。
リレーショナルデータベースを使用するもう1つの大きな利点は、機能が豊富で宣言的な標準クエリ言語であるSQLを利用できることです。複数のテーブルのデータを組み合わせるクエリも簡単に記述できます。その後、RDBMSのクエリプランナーが、クエリを実行する最適な方法を決定します。データベースへのアクセス方法など、低レベルの詳細を意識する必要はありません。また、アプリケーションのすべてのデータが1つのデータベースに格納されているため、容易にクエリできます。
残念ながら、マイクロサービスアーキテクチャに移行すると、データアクセスははるかに複雑になります。これは、各マイクロサービスが所有するデータがそのマイクロサービス専用であり、そのAPIを介してのみアクセスできるためです。データをカプセル化することで、マイクロサービス間の疎結合が維持され、それぞれを独立して進化させることができます。複数のサービスが同じデータにアクセスする場合、スキーマを更新するには、すべてのサービスを連携して更新する必要があり、多くの時間を要します。
さらに問題を複雑にしているのは、マイクロサービスごとに異なる種類のデータベースが使用されることが多い点です。最新のアプリケーションでは多様な種類のデータを保存、処理するため、リレーショナルデータベースが常に最適な選択肢とは限りません。ユースケースによっては、特定のNoSQLデータベースの方が扱いやすいデータモデルを備え、パフォーマンスとスケーラビリティも大幅に優れている場合があります。たとえば、テキストを保存して検索するサービスでは、Elasticsearchなどのテキスト検索エンジンを使用するのが合理的です。同様に、ソーシャルグラフデータを保存するサービスでは、Neo4jなどのグラフデータベースを使用するのが適切でしょう。そのため、マイクロサービスベースのアプリケーションでは、SQLデータベースとNoSQLデータベースを組み合わせて使用する、いわゆる「ポリグロットパーシステンス」アプローチがよく採用されます。
データストレージにパーティショニングとポリグロット永続化を採用したアーキテクチャには、サービス間の疎結合化や、パフォーマンスとスケーラビリティの向上など、多くのメリットがあります。ただし、分散データ管理に関する課題も生じます。
最初の課題は、複数のサービス間で整合性を維持するビジネストランザクションをどのように実装するかです。これが問題となる理由を理解するために、オンラインB2Bストアの例を見てみましょう。Customer Serviceは、与信枠を含む顧客情報を保持します。Order Serviceは注文を管理し、新しい注文が顧客の与信限度額を超えないことを確認する必要があります。このアプリケーションのモノリシック版では、Order ServiceはACIDトランザクションを使用するだけで、利用可能な与信額を確認して注文を作成できます。
一方、マイクロサービスアーキテクチャでは、次の図に示すように、ORDERテーブルとCUSTOMERテーブルはそれぞれ対応するサービス専用です。
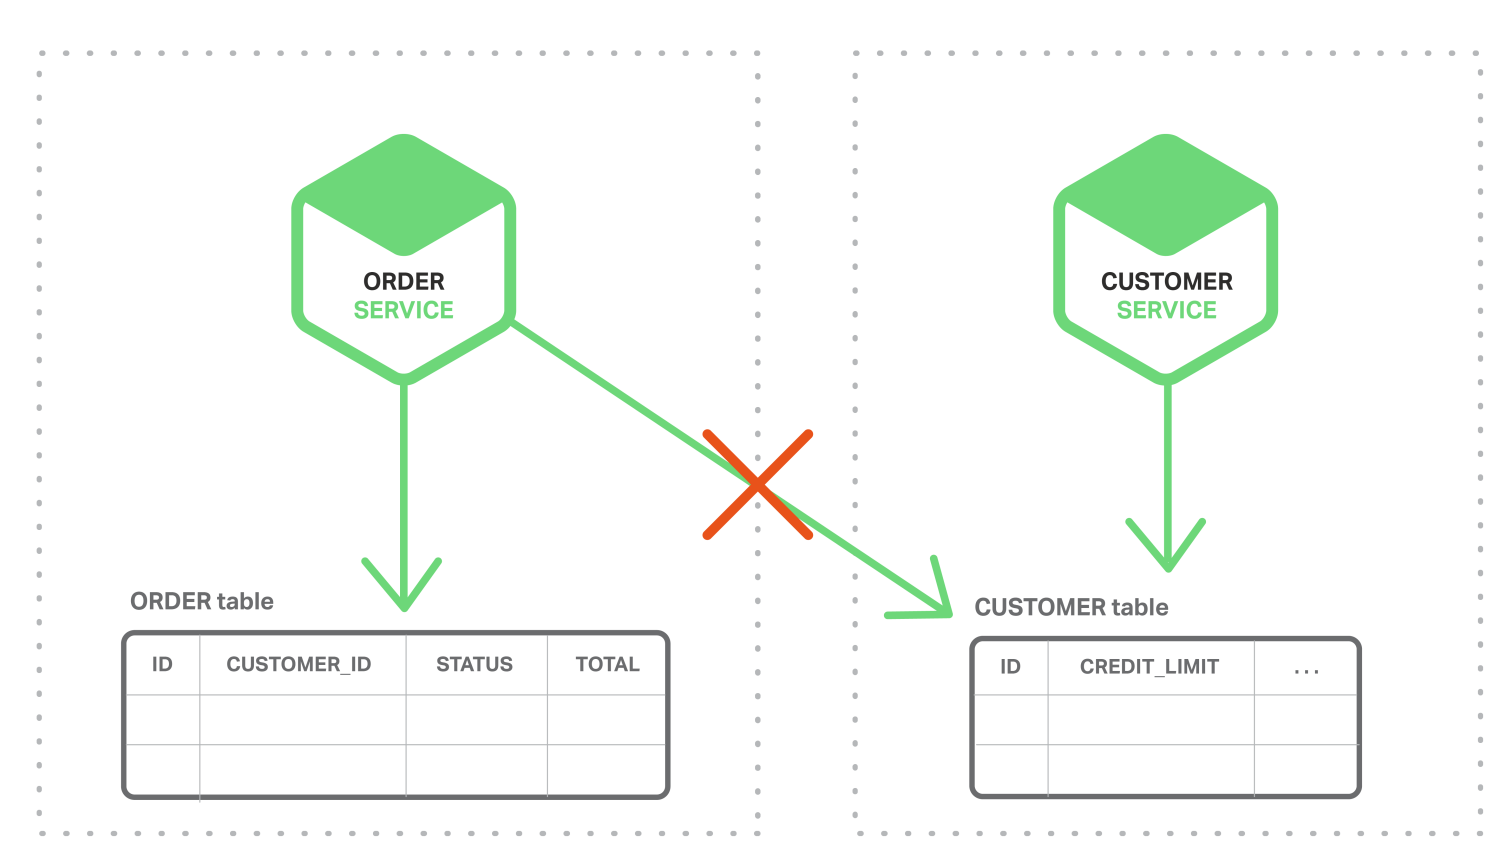
Order ServiceはCUSTOMERテーブルに直接アクセスできません。Customer Serviceが提供するAPIのみを使用できます。Order Serviceでは、分散トランザクション(2相コミット(2PC)とも呼ばれます)を使用できる可能性があります。しかし、通常、最新のアプリケーションでは2PCは現実的な選択肢ではありません。CAP定理では、可用性とACID形式の一貫性のどちらかを選択する必要があり、通常は可用性を選ぶ方が適切です。さらに、ほとんどのNoSQLデータベースをはじめ、多くの最新テクノロジーは2PCをサポートしていません。サービスやデータベース間でデータの一貫性を維持することは不可欠なため、別のソリューションが必要です。
2つ目の課題は、複数のサービスからデータを取得するクエリをどのように実装するかです。たとえば、アプリケーションで顧客とその顧客の最近の注文を表示する必要があるとします。Order Serviceが顧客の注文を取得するためのAPIを提供している場合は、アプリケーション側の結合を使用してこのデータを取得できます。アプリケーションは、Customer Serviceから顧客を取得し、Order Serviceからその顧客の注文を取得します。しかし、Order Serviceが主キーによる注文の検索にしか対応していないとします(主キーに基づく取得のみをサポートするNoSQLデータベースを使用している場合など)。この場合、必要なデータを取得する明確な方法はありません。
イベント駆動型アーキテクチャ
多くのアプリケーションでは、イベント駆動型アーキテクチャの採用が解決策となります。このアーキテクチャでは、ビジネスエンティティの更新など、注目すべき事象が発生すると、マイクロサービスがイベントを発行します。他のマイクロサービスは、そのイベントをサブスクライブします。イベントを受信したマイクロサービスは、自身のビジネスエンティティを更新できます。その結果、さらにイベントが発行される場合があります。
イベントを使用して、複数のサービスにまたがるビジネストランザクションを実装できます。トランザクションは一連のステップで構成されます。各ステップでは、マイクロサービスがビジネスエンティティを更新し、次のステップをトリガーするイベントを発行します。以下の一連の図は、注文の作成時に利用可能な与信枠を確認するために、イベント駆動型のアプローチを使用する方法を示しています。マイクロサービスは、メッセージブローカーを介してイベントを交換します。
- Order Serviceは、ステータスがNEWのOrderを作成し、Order Createdイベントを発行します。
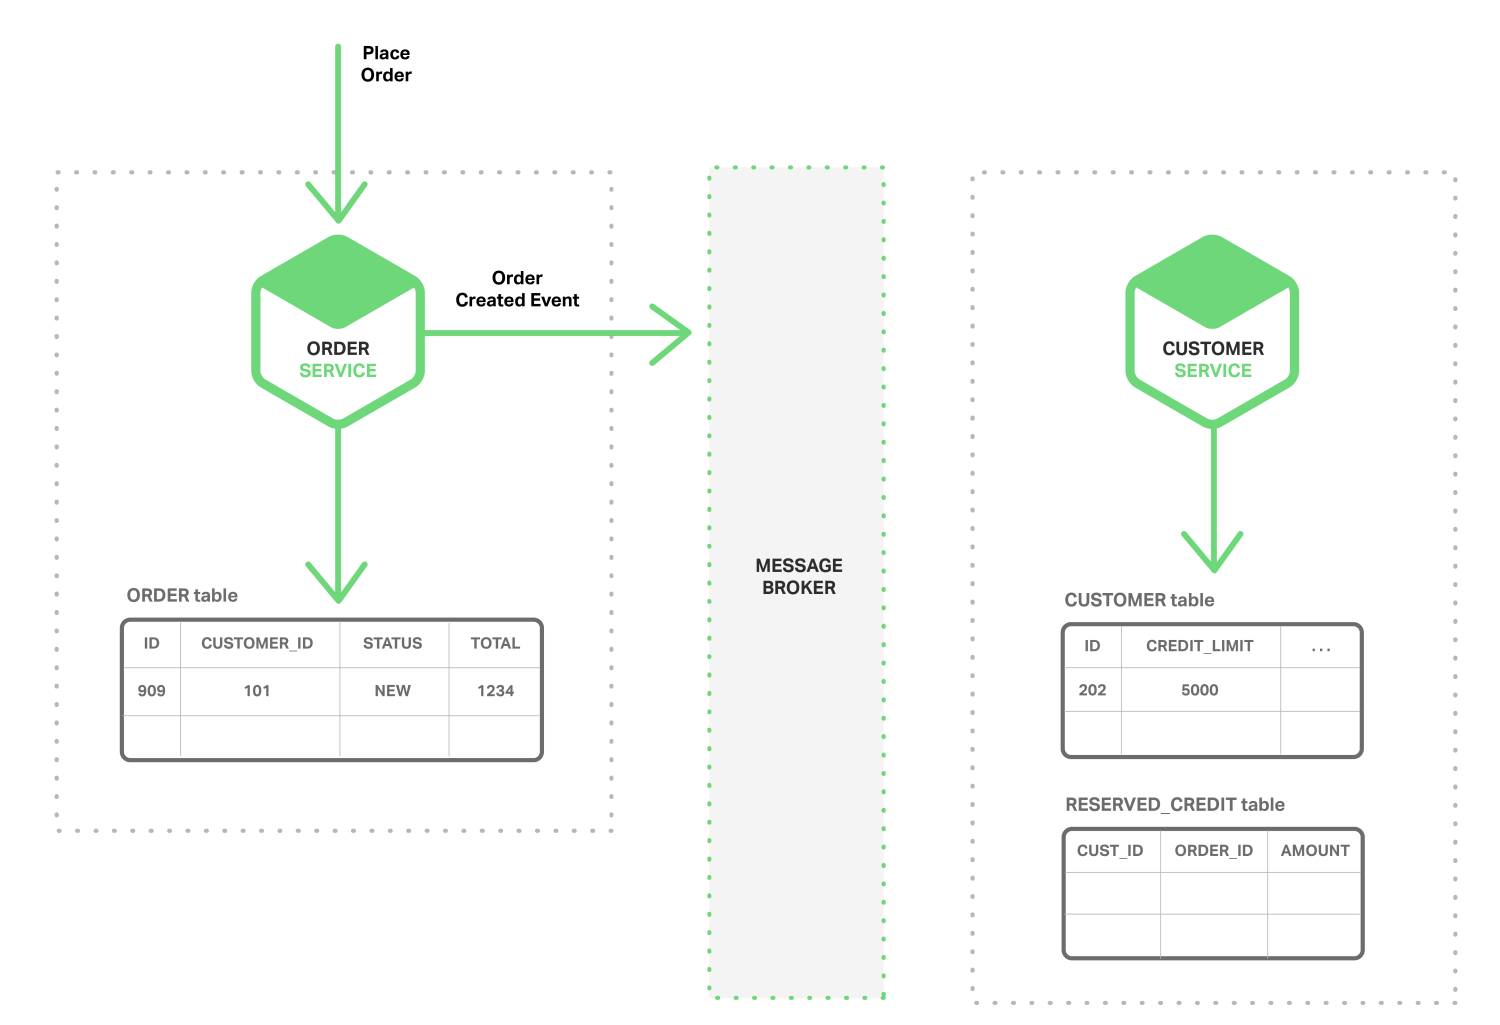
- Customer ServiceはOrder Createdイベントを受信し、注文に必要な与信枠を確保して、Credit Reservedイベントを発行します。
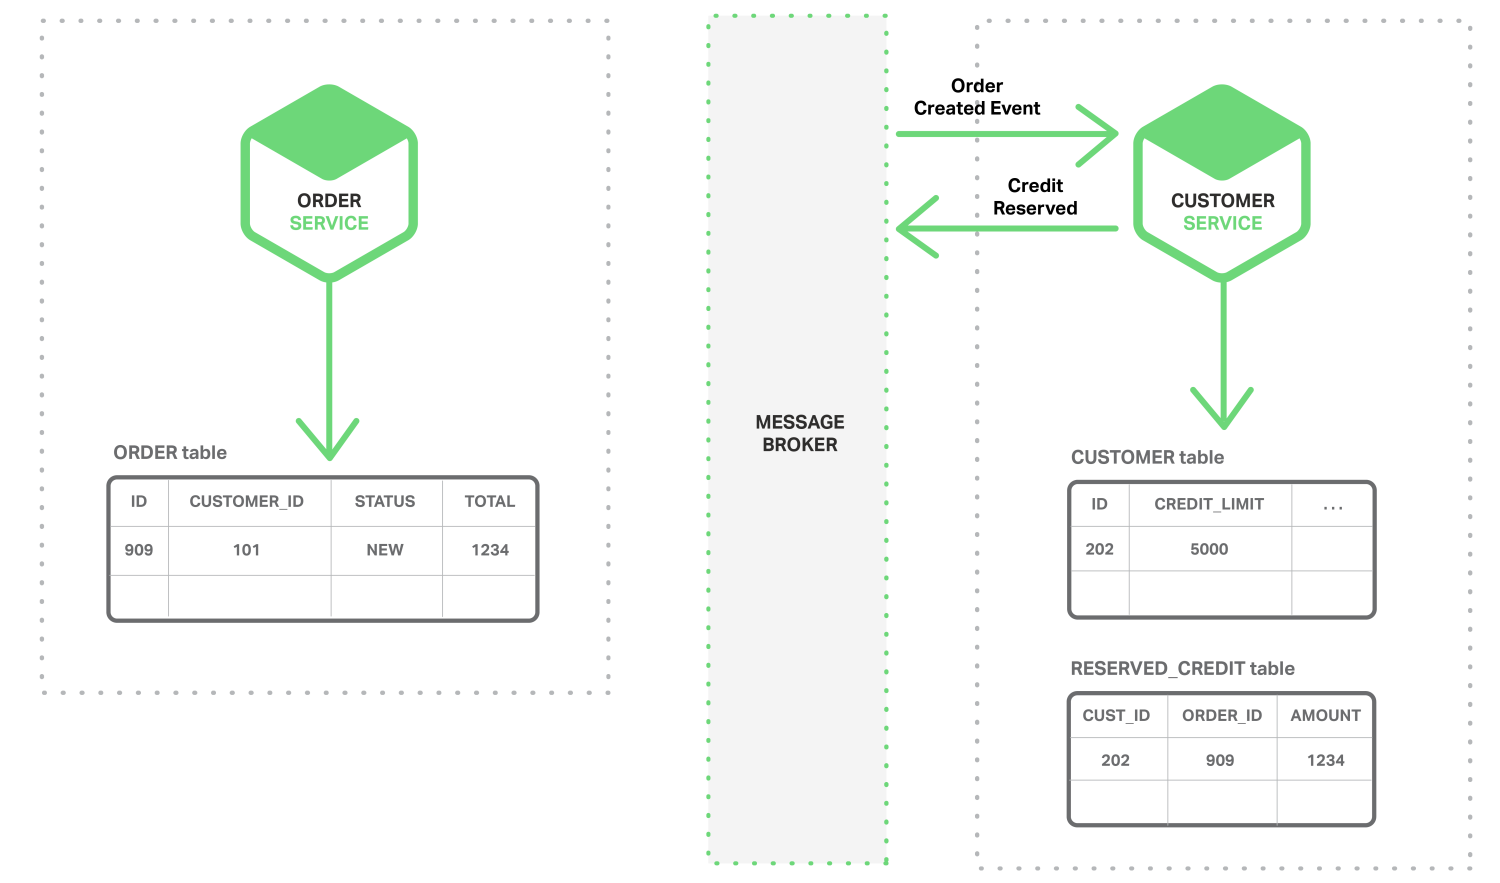
- Order ServiceはCredit Reservedイベントを受信し、注文のステータスをOPENに変更します。
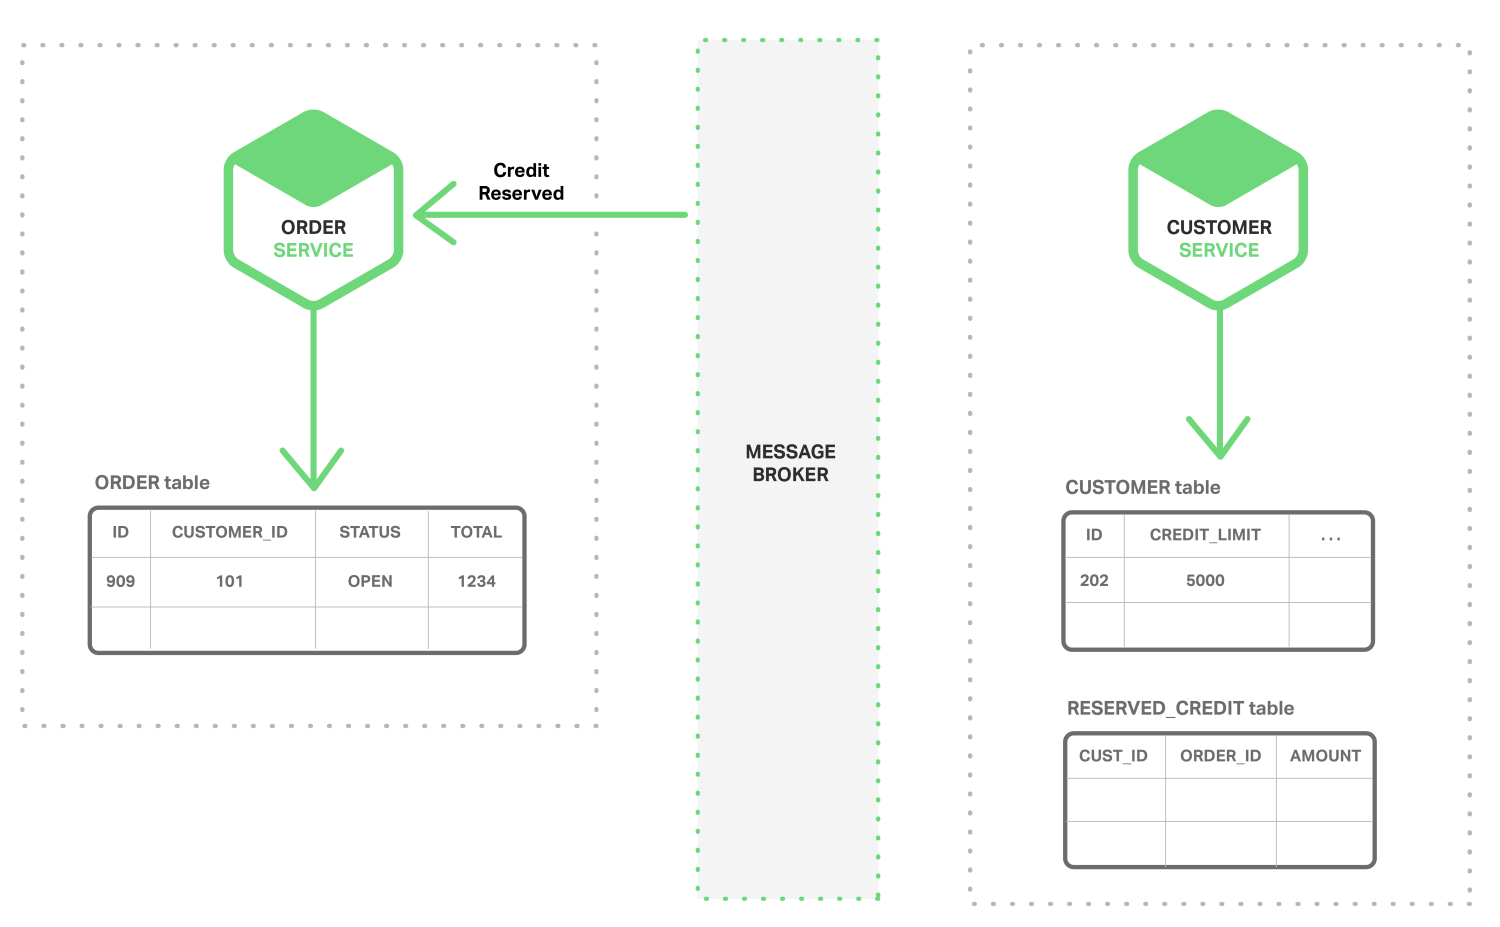
より複雑なシナリオでは、顧客の与信確認と同時に在庫を確保するなど、追加のステップが含まれる場合があります。
(a)各サービスがデータベースをアトミックに更新してイベントを発行し(これについては後述します)、かつ(b)Message Brokerがイベントを少なくとも1回配信することを保証する場合、複数のサービスにまたがるビジネストランザクションを実装できます。ただし、これらはACIDトランザクションではない点に注意が必要です。提供される保証は、次のような、はるかに弱いものです。結果整合性。このトランザクションモデルは「BASEモデル」と呼ばれています。
イベントを使用して、複数のマイクロサービスが所有するデータを事前に結合したマテリアライズドビューを維持することもできます。ビューを維持するサービスは、関連するイベントをサブスクライブしてビューを更新します。たとえば、Customer Ordersビューを維持するCustomer Order View Updater Serviceは、Customer ServiceとOrder Serviceが発行するイベントをサブスクライブします。
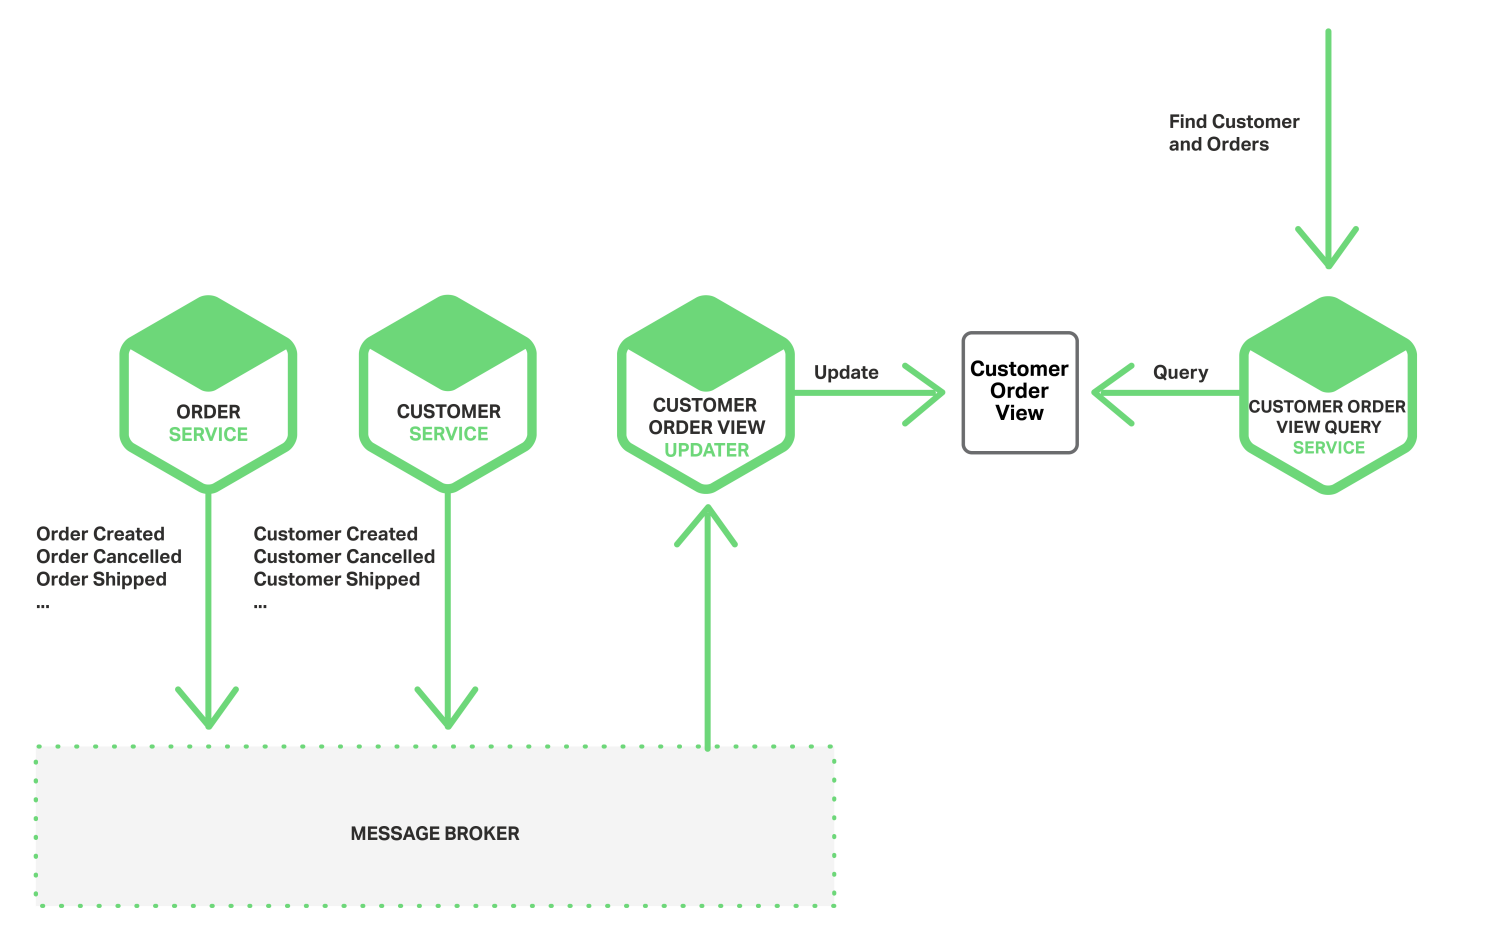
Customer Order View Updater Serviceは、CustomerイベントまたはOrderイベントを受信すると、Customer Order Viewデータストアを更新します。Customer Order Viewは、MongoDBなどのドキュメントデータベースを使用し、Customerごとに1つのドキュメントを保存する形で実装できます。Customer Order View Query Serviceは、Customer Order Viewデータストアにクエリを実行し、顧客と最近の注文に関するリクエストを処理します。
イベント駆動型アーキテクチャには、いくつかの利点と欠点があります。複数のサービスにまたがり、結果整合性を実現するトランザクションを実装できます。また、アプリケーションでマテリアライズドビューを維持できることも利点です。一方、ACIDトランザクションを使用する場合よりもプログラミングモデルが複雑になるという欠点があります。多くの場合、アプリケーションレベルの障害から復旧するために補償トランザクションを実装する必要があります。たとえば、与信確認に失敗した場合は注文をキャンセルしなければなりません。また、アプリケーションはデータの不整合に対処する必要があります。これは、処理中のトランザクションによる変更が可視化されるためです。まだ更新されていないマテリアライズドビューから読み取る場合にも、アプリケーションで不整合が確認されることがあります。さらに、サブスクライバーが重複イベントを検出して無視しなければならないことも欠点です。
アトミック性の実現
イベント駆動型アーキテクチャには、データベースの更新とイベントの発行をアトミックに行うという課題もあります。たとえば、Order ServiceはORDERテーブルに行を挿入し、Order Createdイベントを発行する必要があります。この2つの操作は、アトミックに実行することが不可欠です。データベースの更新後、イベントを発行する前にサービスがクラッシュすると、システムに不整合が生じます。アトミック性を確保する標準的な方法は、データベースとMessage Brokerを含む分散トランザクションを使用することです。しかし、CAP定理など前述の理由から、これはまさに避けたい方法です。
ローカルトランザクションを使用したイベントの発行
アトミック性を実現する方法の1つは、アプリケーションがローカルトランザクションのみを使用する複数ステップのプロセスでイベントを発行することです。ポイントは、ビジネスエンティティの状態を格納するデータベース内に、メッセージキューとして機能するEVENTテーブルを用意することです。アプリケーションは(ローカル)データベーストランザクションを開始し、ビジネスエンティティの状態を更新して、EVENTテーブルにイベントを挿入した後、トランザクションをコミットします。別のアプリケーションスレッドまたはプロセスがEVENTテーブルを照会し、イベントをMessage Brokerに発行してから、ローカルトランザクションを使用してイベントを発行済みとしてマークします。次の図に、この設計を示します。
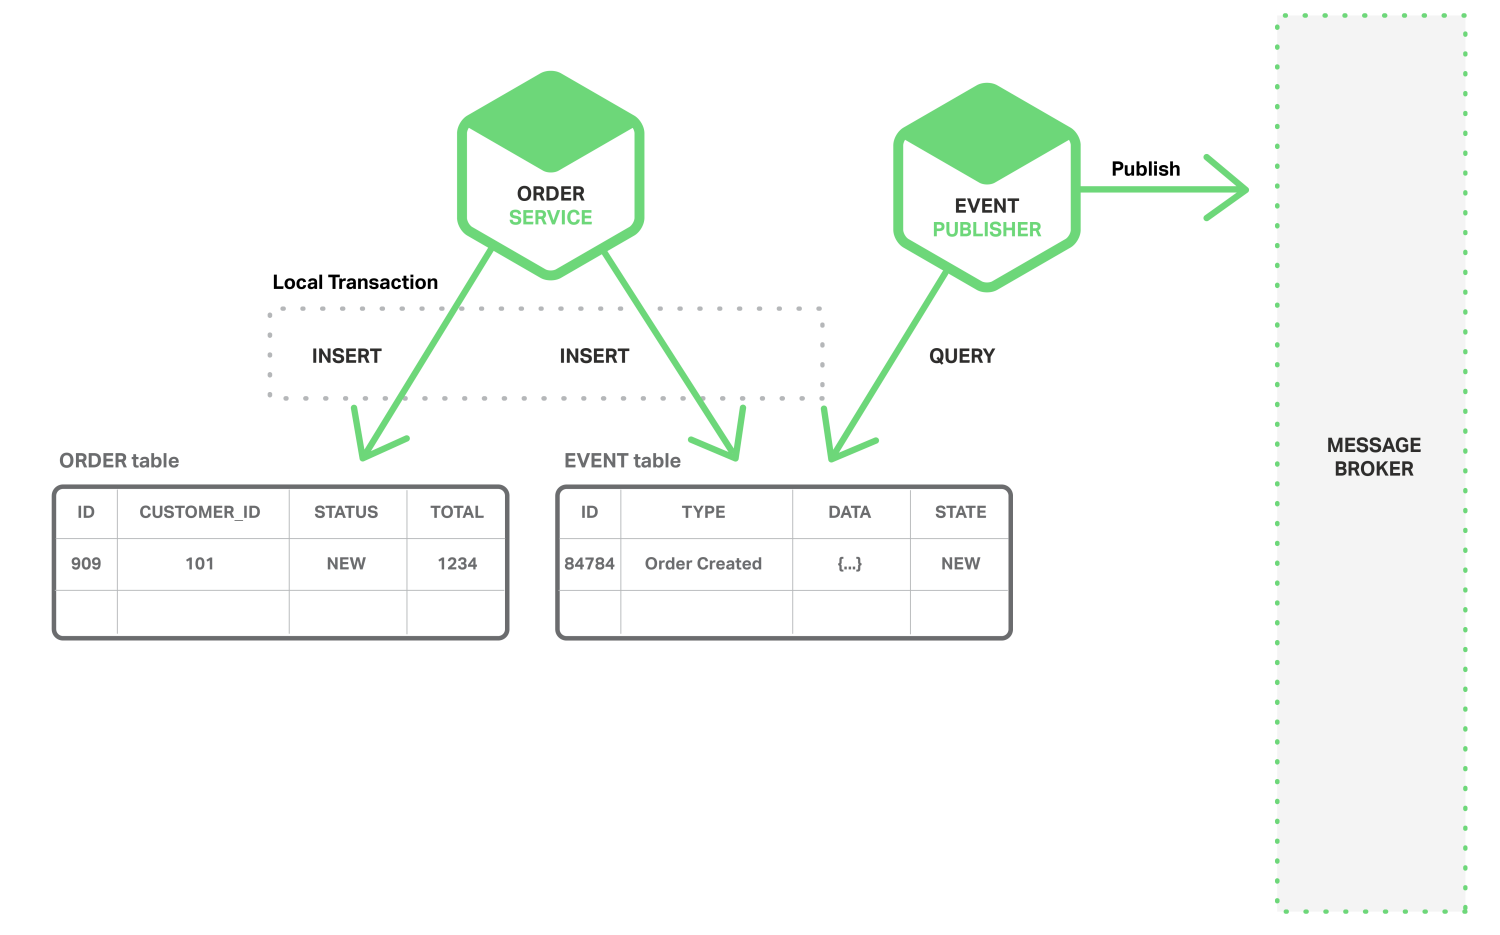
Order Serviceは、ORDERテーブルに行を挿入し、EVENTテーブルにOrder Createdイベントを挿入します。Event Publisherのスレッドまたはプロセスは、EVENTテーブルから未発行のイベントを照会して発行した後、発行済みとしてマークするためにEVENTテーブルを更新します。
このアプローチには、いくつかの利点と欠点があります。利点の1つは、2PCに依存することなく、更新のたびにイベントが確実に発行されることです。また、アプリケーションがビジネスレベルのイベントを発行するため、イベントを推測する必要がありません。一方、開発者がイベントの発行を忘れないようにする必要があるため、ミスが発生する可能性がある点は欠点です。また、一部のNoSQLデータベースではトランザクション機能とクエリ機能が限られているため、実装が難しいという制約もあります。
このアプローチでは、アプリケーションがローカルトランザクションを使用して状態を更新し、イベントを発行するため、2PCが不要になります。次に、アプリケーションが状態を更新するだけで原子性を実現するアプローチを見ていきます。
データベーストランザクションログのマイニング
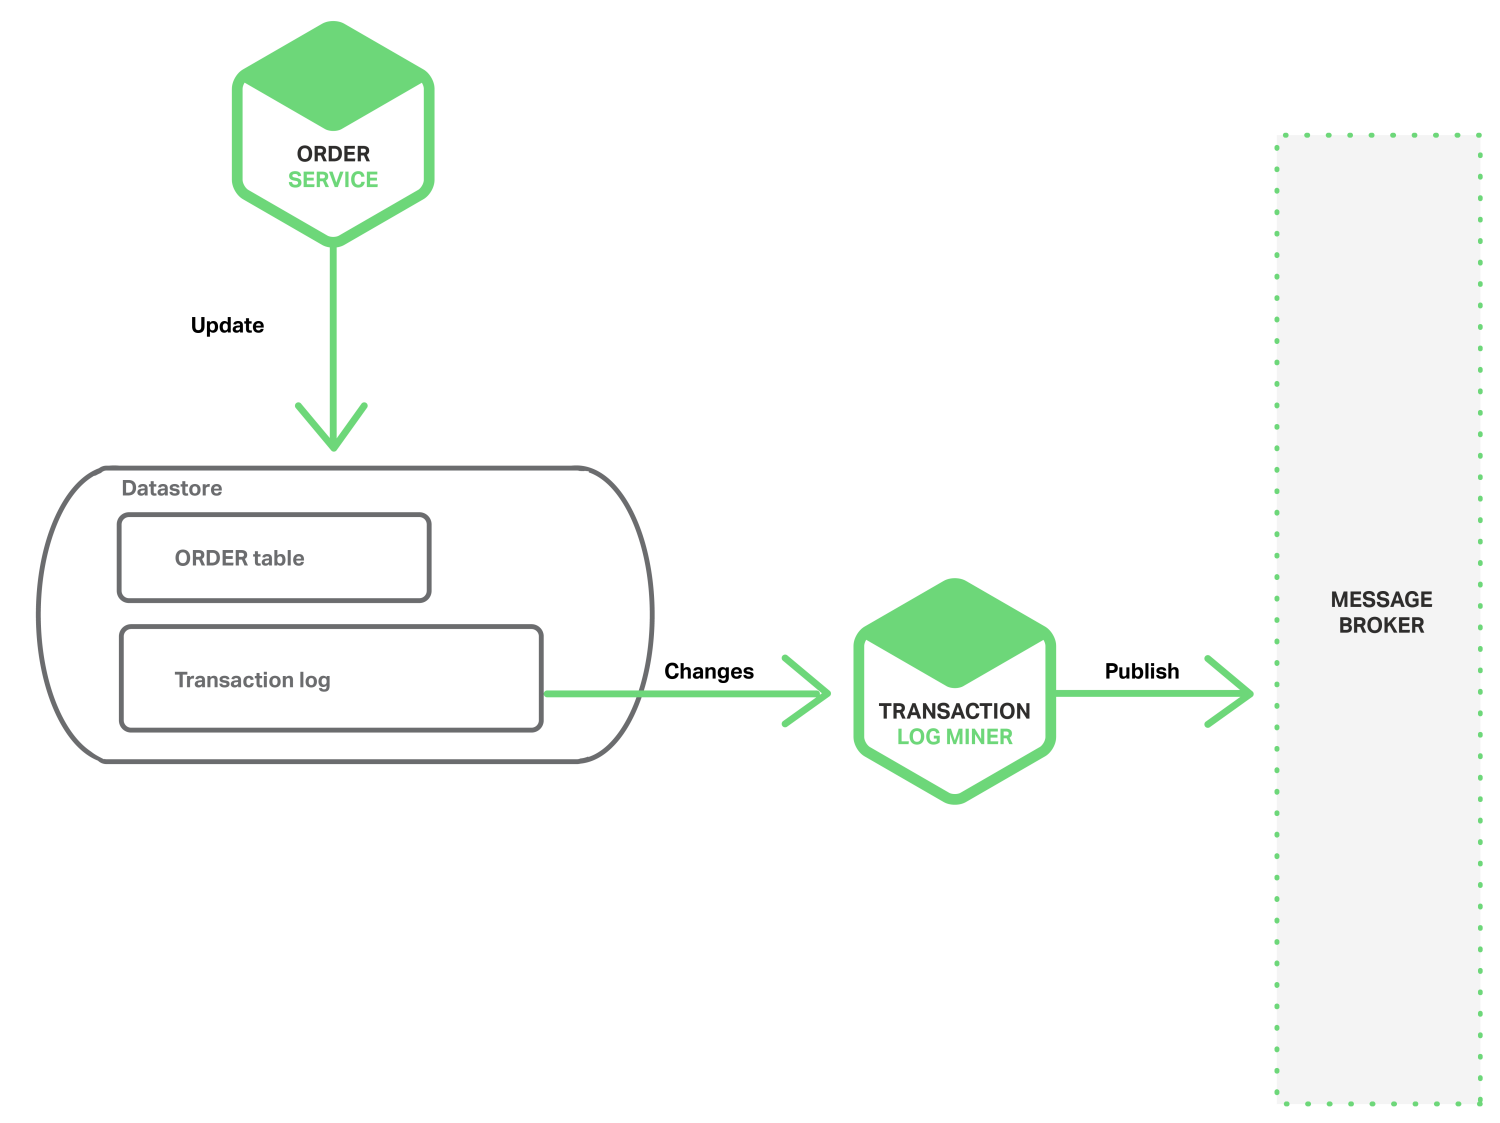
2PCを使用せずに原子性を実現するもう1つの方法は、データベースのトランザクションログまたはコミットログをマイニングするスレッドやプロセスからイベントを発行することです。アプリケーションがデータベースを更新すると、その変更がデータベースのトランザクションログに記録されます。Transaction Log Minerのスレッドまたはプロセスは、トランザクションログを読み取り、Message Brokerにイベントを発行します。次の図は、この設計を示しています。
このアプローチの一例として、オープンソースの「LinkedIn Databus」プロジェクトがあります。DatabusはOracleのトランザクションログを解析し、変更に対応するイベントを発行します。LinkedInではDatabusを使用して、さまざまな派生データストアと記録システムとの整合性を維持しています。
もう1つの例は、マネージドNoSQLデータベースであるAWS DynamoDBのストリームメカニズムです。DynamoDBストリームには、過去24時間にDynamoDBテーブル内の項目に加えられた変更(作成、更新、削除の各操作)が時系列で格納されます。アプリケーションはストリームからこれらの変更を読み取り、たとえばイベントとして発行できます。
トランザクションログのマイニングには、さまざまな利点と欠点があります。利点の1つは、2PCを使用せずに、更新ごとにイベントが確実に発行されることです。また、イベントの発行をアプリケーションのビジネスロジックから分離することで、アプリケーションを簡素化できます。大きな欠点は、トランザクションログの形式がデータベースごとに固有であり、データベースのバージョン間で変更される場合もあることです。さらに、トランザクションログに記録された低レベルの更新から、高レベルのビジネスイベントをリバースエンジニアリングするのが難しい場合があります。
トランザクションログマイニングでは、アプリケーションがデータベースの更新だけを行うようにすることで、2PCが不要になります。次に、更新をなくし、イベントのみに依存する別のアプローチを見てみましょう。
イベントソーシングの使用
イベントソーシングは、ビジネスエンティティを永続化する手法として、従来とは根本的に異なるイベント中心のアプローチを採用することで、2PCを使用せずにアトミック性を実現します。アプリケーションは、エンティティの現在の状態を保存する代わりに、状態を変更する一連のイベントを保存します。イベントを再生することで、エンティティの現在の状態を再構築します。ビジネスエンティティの状態が変化するたびに、イベントのリストへ新しいイベントが追加されます。イベントの保存は単一の操作であるため、本質的にアトミックです。
イベントソーシングの仕組みを理解するために、Orderエンティティを例に考えてみましょう。従来のアプローチでは、各注文はORDERテーブルの1行と、たとえばORDER_LINE_ITEMテーブルの複数の行に対応します。一方、イベントソーシングを使用する場合、Order ServiceはOrderを状態変更イベント(Created、Approved、Shipped、Cancelled)として保存します。各イベントには、Orderの状態を再構築するために十分なデータが含まれています。
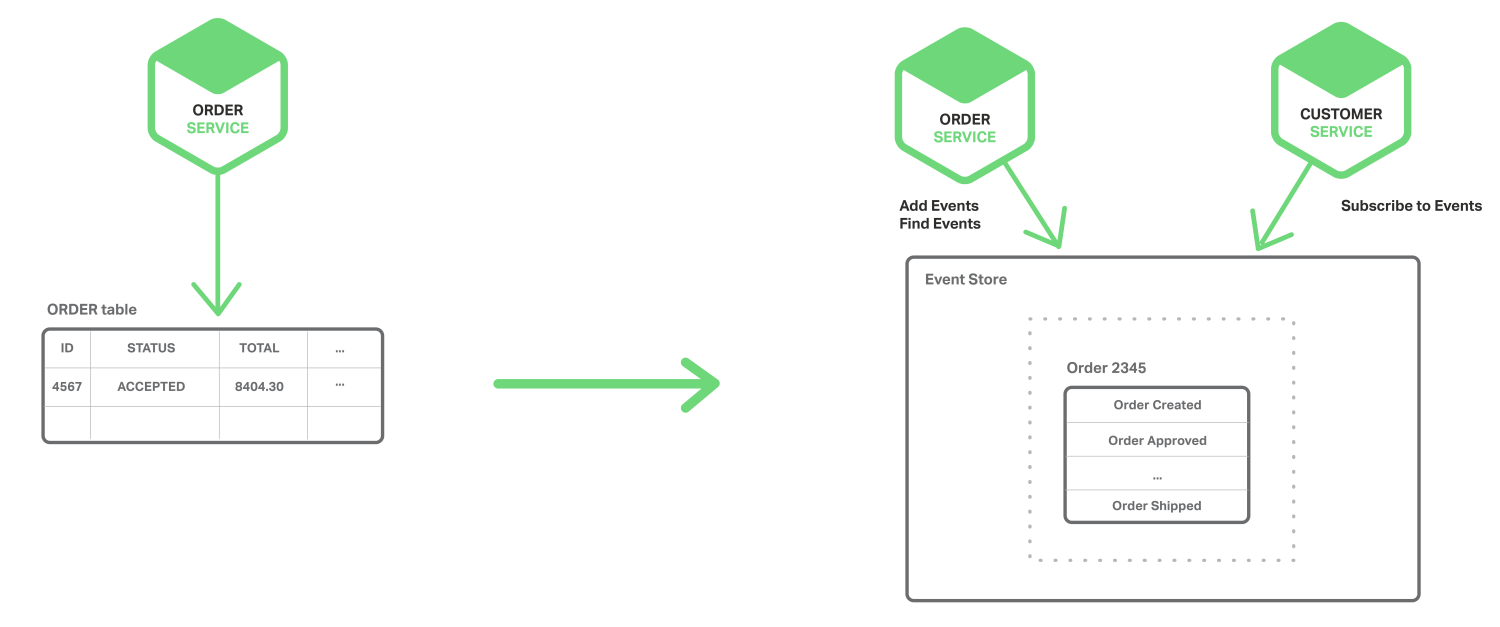
イベントは、イベントのデータベースであるEvent Storeに永続化されます。Event Storeには、エンティティのイベントを追加および取得するためのAPIがあります。また、前述のアーキテクチャにおけるMessage Brokerとしても機能します。サービスがイベントをサブスクライブできるAPIを提供し、対象のすべてのイベントを関係するすべてのサブスクライバーに配信します。Event Storeは、イベント駆動型マイクロサービスアーキテクチャの基盤です。
イベントソーシングには、いくつかの利点があります。イベント駆動型アーキテクチャの実装における主要な問題の1つを解決し、状態が変化するたびにイベントを確実に発行できるようにします。その結果、マイクロサービスアーキテクチャにおけるデータ整合性の問題を解決できます。また、ドメインオブジェクトではなくイベントを永続化するため、オブジェクト関係インピーダンスミスマッチの問題をほぼ回避できます。さらに、イベントソーシングは、ビジネスエンティティに加えられた変更について100%信頼できる監査ログを提供し、任意の時点におけるエンティティの状態を特定する時間的クエリを実装できるようにします。イベントソーシングのもう1つの大きな利点は、ビジネスロジックが、イベントを交換する疎結合のビジネスエンティティで構成されることです。これにより、モノリシックアプリケーションからマイクロサービスアーキテクチャへの移行が大幅に容易になります。
イベントソーシングには、いくつかの欠点もあります。従来とは異なるなじみの薄いプログラミングスタイルであるため、習得には時間がかかります。イベントストアが直接サポートするのは、主キーによるビジネスエンティティの検索のみです。クエリを実装するには、コマンドクエリ責務分離(CQRS)を使用する必要があります。そのため、アプリケーションでは結果整合性のあるデータを扱う必要があります。
まとめ
マイクロサービスアーキテクチャでは、各マイクロサービスが専用のプライベートデータストアを持ちます。マイクロサービスごとに異なるSQLデータベースやNoSQLデータベースを使用する場合もあります。このデータベースアーキテクチャには大きなメリットがある一方で、分散データ管理に関する課題も生じます。1つ目の課題は、複数のサービス間で整合性を維持するビジネストランザクションをどのように実装するかです。2つ目の課題は、複数のサービスからデータを取得するクエリをどのように実装するかです。
多くのアプリケーションでは、イベント駆動型アーキテクチャの採用が解決策となります。イベント駆動型アーキテクチャを実装する際の課題の1つは、状態をアトミックに更新し、イベントを発行する方法です。これを実現する方法には、データベースをメッセージキューとして使用する方法、トランザクションログマイニング、イベントソーシングなどがあります。
今後のブログ記事では、マイクロサービスのその他の側面についても引き続き掘り下げていきます。
編集部 – 全7回の記事シリーズが完結しました:
- マイクロサービス入門
- マイクロサービスの構築:APIゲートウェイの使用
- マイクロサービスの構築:マイクロサービスアーキテクチャにおけるプロセス間通信
- マイクロサービスアーキテクチャにおけるサービスディスカバリ
- マイクロサービス向けイベント駆動型データ管理(本記事)
- マイクロサービスのデプロイ戦略の選択
- モノリスからマイクロサービスへのリファクタリング
一連の記事に加え、NGINX Plusを使用したマイクロサービスの実装に関する情報をまとめた電子書籍「マイクロサービス:設計からデプロイまで」もダウンロードできます。また、「マイクロサービスリファレンスアーキテクチャ」シリーズと「マイクロサービスソリューションのページ」もご覧ください。
ゲストブロガーのChris Richardson氏は、初期のAmazon EC2向けJava PaaS(Platform as a Service)である、当初の「CloudFoundry.com」の創設者です。現在は、アプリケーションの開発およびデプロイ方法の改善に向けて、組織にコンサルティングを提供しています。また、マイクロサービスについて「http://microservices.io」で定期的にブログを執筆しています。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります