編集部 – 全7回の記事シリーズが完結しました:
- マイクロサービス入門
- マイクロサービスの構築:APIゲートウェイの使用
- マイクロサービスの構築:マイクロサービスアーキテクチャにおけるプロセス間通信
- マイクロサービスアーキテクチャにおけるサービスディスカバリ(本記事)
- マイクロサービス向けイベント駆動型データ管理
- マイクロサービスのデプロイ戦略の選択
- モノリスからマイクロサービスへのリファクタリング
一連の記事に加え、NGINX Plusを使用したマイクロサービスの実装に関する情報をまとめたeBook「マイクロサービス:設計からデプロイまで」もダウンロードできます。また、新しい「マイクロサービスソリューションのページ」もご覧ください。
本稿は、マイクロサービスを使用したアプリケーション構築に関するシリーズの第4回です。第1回の記事では、マイクロサービスアーキテクチャパターンを紹介し、マイクロサービスを使用するメリットとデメリットについて説明しました。シリーズの第2回<.htmla>と第3回の記事では、マイクロサービスアーキテクチャ内の通信について、さまざまな側面から説明しています。本稿では、これと密接に関連するサービスディスカバリの問題について解説します。
サービスディスカバリを使用する理由
REST APIまたはThrift APIを備えたサービスを呼び出すコードを記述しているとします。リクエストを送信するには、サービスインスタンスのネットワーク上の場所(IPアドレスとポート)をコード側で把握しておく必要があります。物理ハードウェア上で稼働する従来型のアプリケーションでは、サービスインスタンスのネットワーク上の場所は比較的固定されています。たとえば、随時更新される設定ファイルからネットワーク上の場所を読み取ることができます。
しかし、最新のクラウドベースのマイクロサービスアプリケーションでは、次の図に示すように、この問題の解決ははるかに困難です。
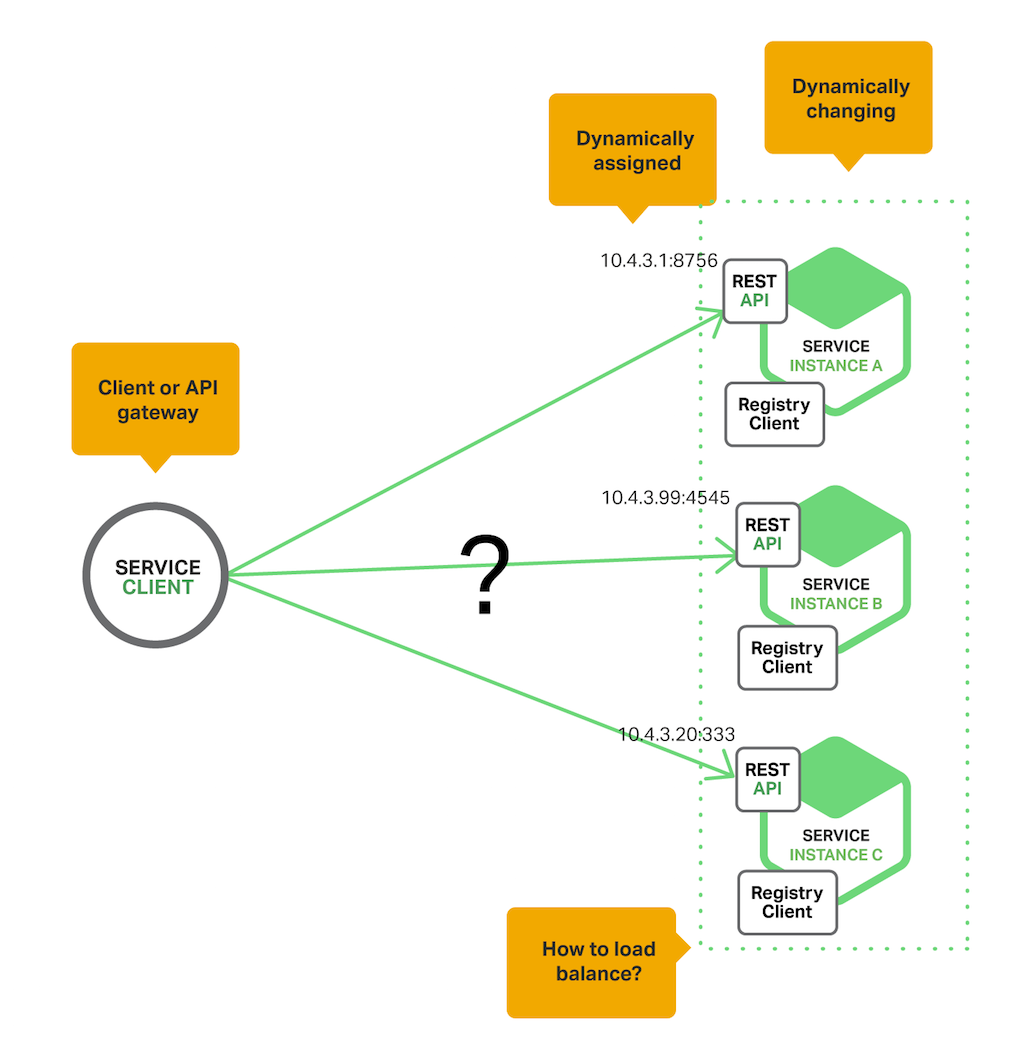
サービスインスタンスのネットワーク上の場所は動的に割り当てられます。さらに、自動スケーリング、障害、アップグレードにより、サービスインスタンスの構成も動的に変化します。そのため、クライアントコードでは、より高度なサービスディスカバリメカニズムを使用する必要があります。
サービスディスカバリには、主に2つのパターンがあります。クライアントサイドディスカバリとサーバーサイドディスカバリです。まず、クライアントサイドディスカバリについて見ていきます。
クライアント側サービスディスカバリパターン
When using クライアント側ディスカバリを使用する場合、クライアントは利用可能なサービスインスタンスのネットワーク上の場所を特定し、それらのインスタンス間でリクエストを負荷分散します。クライアントは、利用可能なサービスインスタンスのデータベースであるサービスレジストリに問い合わせます。次に、負荷分散アルゴリズムを使用して利用可能なサービスインスタンスを1つ選択し、リクエストを送信します。
次の図は、このパターンの構造を示しています。
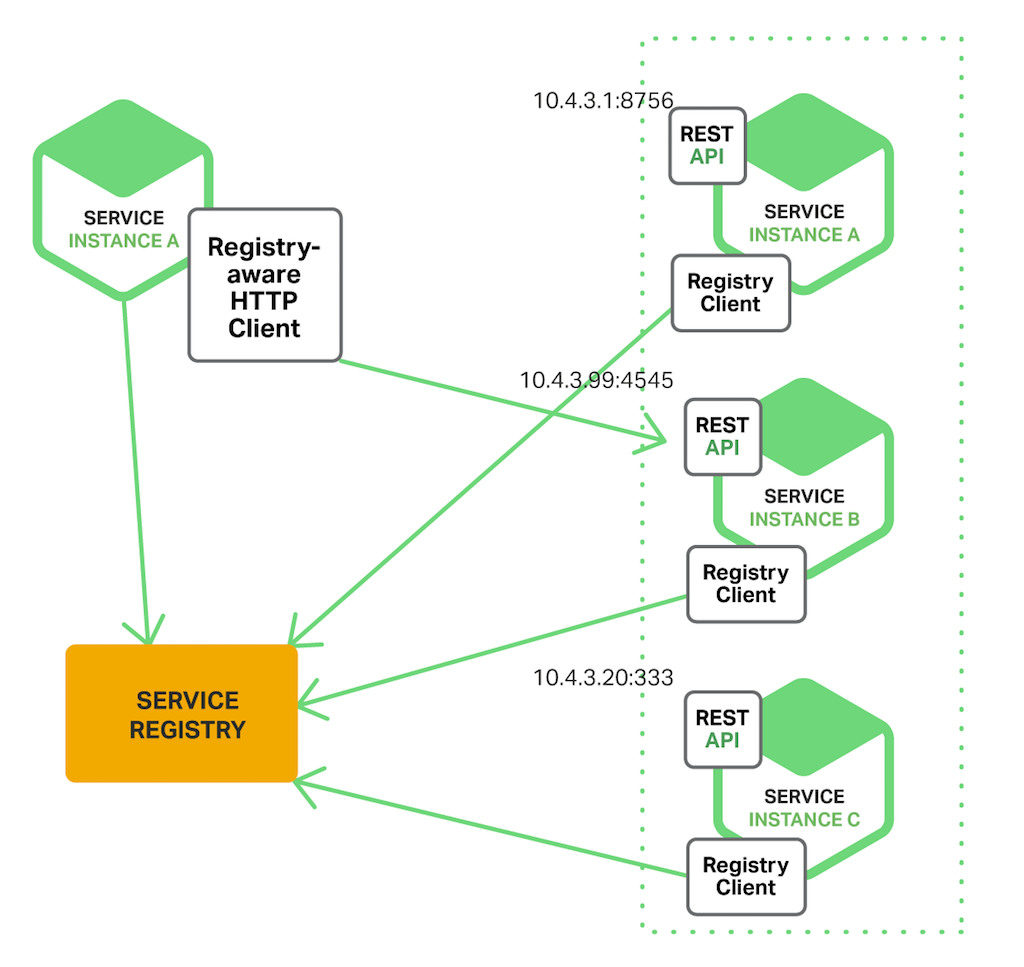
サービスインスタンスの起動時に、そのネットワーク上の場所がサービスレジストリに登録されます。インスタンスが終了すると、サービスレジストリから削除されます。通常、サービスインスタンスの登録情報は、ハートビートの仕組みによって定期的に更新されます。
Netflix OSSは、クライアント側サービスディスカバリパターンの優れた例です。Netflix Eurekaはサービスレジストリです。サービスインスタンスの登録を管理し、利用可能なインスタンスを照会するためのREST APIを提供します。Netflix Ribbonは、Eurekaと連携し、利用可能なサービスインスタンス間でリクエストを負荷分散するIPCクライアントです。Eurekaについては、この記事の後半で詳しく説明します。
クライアント側サービスディスカバリパターンには、さまざまな利点と欠点があります。このパターンは比較的単純で、サービスレジストリ以外に動作するコンポーネントはありません。また、クライアントは利用可能なサービスインスタンスを把握しているため、一貫性のあるハッシュを使用するなど、アプリケーション固有の要件に応じてインテリジェントに負荷分散を判断できます。このパターンの大きな欠点の1つは、クライアントがサービスレジストリに密結合することです。サービスクライアントで使用するプログラミング言語とフレームワークごとに、クライアント側のサービスディスカバリロジックを実装する必要があります。
クライアント側のサービスディスカバリについて確認したところで、次はサーバー側のサービスディスカバリについて見ていきましょう。
サーバーサイドディスカバリパターン
サービスディスカバリのもう1つのアプローチは、サーバーサイドディスカバリパターンです。次の図は、このパターンの構造を示しています。
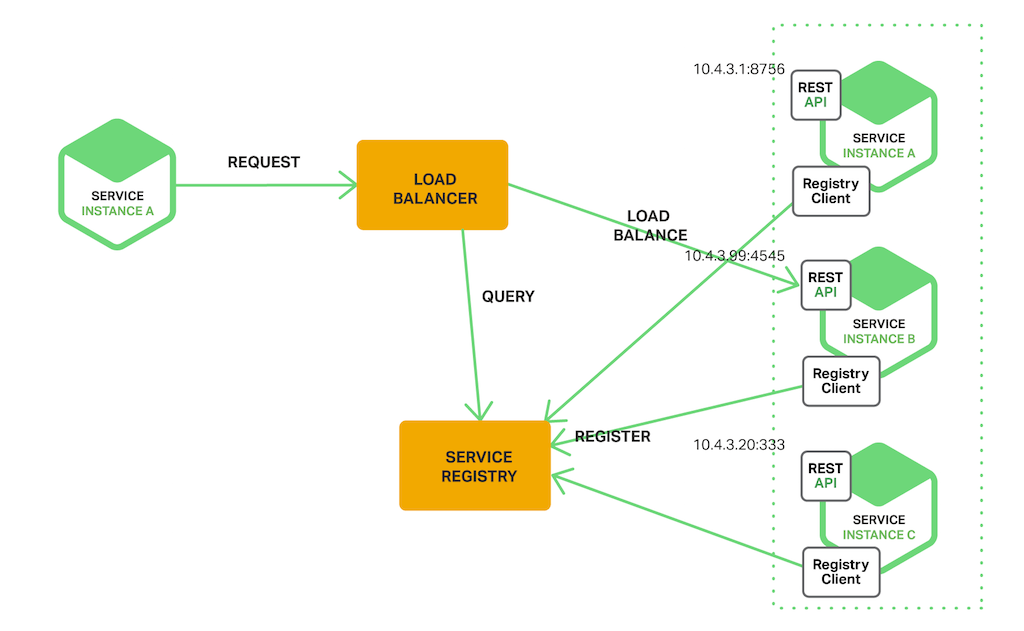
クライアントは、ロードバランサーを介してサービスにリクエストを送信します。ロードバランサーはサービスレジストリに問い合わせ、各リクエストを利用可能なサービスインスタンスにルーティングします。クライアント側のサービスディスカバリと同様に、サービスインスタンスはサービスレジストリに登録され、登録解除されます。
The AWS Elastic Load Balancer(ELB)は、サーバーサイドディスカバリルーターの一例です。ELBは通常、インターネットからの外部トラフィックを負荷分散するために使用されます。ただし、仮想プライベートクラウド(VPC)内のトラフィックの負荷分散にも使用できます。クライアントは、ELBのDNS名を使用して、ELB経由でリクエスト(HTTPまたはTCP)を送信します。ELBは、登録済みのElastic Compute Cloud(EC2)インスタンスまたはEC2 Container Service(ECS)コンテナ間でトラフィックを負荷分散します。独立したサービスレジストリはありません。代わりに、EC2インスタンスとECSコンテナがELB自体に登録されます。
HTTPサーバーやNGINX Plus、NGINXなどのロードバランサーも、サーバーサイドディスカバリのロードバランサーとして使用できます。たとえば、こちらのブログ記事では、Consul Templateを使用してNGINXのリバースプロキシ設定を動的に再構成する方法を説明しています。Consul Templateは、Consul サービスレジストリに保存された構成データを基に、任意の構成ファイルを定期的に再生成するツールです。ファイルが変更されるたびに、任意のシェルコマンドを実行します。ブログ記事で紹介されている例では、Consul Templateがリバースプロキシを構成するnginx.confファイルを生成し、NGINXに構成を再読み込みさせるコマンドを実行します。より高度な実装では、HTTP APIまたはDNSを使用してNGINX Plusを動的に再構成できます。
一部のデプロイ環境(KubernetesやMarathonなど)では、クラスター内の各ホストでプロキシを実行します。このプロキシは、サーバー側サービスディスカバリのロードバランサーとして機能します。クライアントがサービスにリクエストを送信する際は、ホストのIPアドレスとサービスに割り当てられたポートを使用し、プロキシ経由でリクエストをルーティングします。その後、プロキシはクラスター内のいずれかの場所で稼働している利用可能なサービスインスタンスに、リクエストを透過的に転送します。
サーバー側ディスカバリパターンには、いくつかの利点と欠点があります。大きな利点の1つは、ディスカバリの詳細がクライアントから抽象化されることです。クライアントはロードバランサーにリクエストを送信するだけで済みます。そのため、サービスクライアントが使用するプログラミング言語やフレームワークごとにディスカバリロジックを実装する必要がありません。また、前述のとおり、一部のデプロイ環境ではこの機能が無償で提供されます。一方、このパターンには欠点もあります。ロードバランサーがデプロイ環境から提供されない場合は、高可用性が求められるシステムコンポーネントがさらに1つ増え、そのセットアップと管理が必要になります。
サービスレジストリ
The サービスレジストリは、サービスディスカバリの重要な要素です。サービスインスタンスのネットワーク上の場所を格納するデータベースであり、高可用性を備え、常に最新の状態に保つ必要があります。クライアントは、サービスレジストリから取得したネットワーク上の場所をキャッシュできます。しかし、その情報はいずれ古くなり、クライアントがサービスインスタンスを検出できなくなります。そのため、サービスレジストリは、レプリケーションプロトコルを使用して整合性を維持するサーバークラスターで構成されます。
前述のとおり、Netflix Eurekaはサービスレジストリの好例です。サービスインスタンスの登録と照会に使用するREST APIを提供します。サービスインスタンスは、POSTリクエストを使用してネットワーク上の場所を登録します。30秒ごとに、PUTリクエストを使用して登録を更新する必要があります。登録は、HTTP DELETEリクエストを使用するか、インスタンスの登録がタイムアウトすると削除されます。また、クライアントはHTTP GETリクエストを使用して、登録済みのサービスインスタンスを取得できます。
Netflixは高可用性を実現しています。そのために、Amazon EC2の各アベイラビリティーゾーンで1台以上のEurekaサーバーを実行しています。各Eurekaサーバーは、Elastic IPアドレスが割り当てられたEC2インスタンス上で実行されます。DNSのTEXTレコードには、Eurekaクラスター構成が保存されます。この構成は、各アベイラビリティーゾーンとEurekaサーバーのネットワークロケーション一覧を対応付けたマップです。Eurekaサーバーは起動時にDNSへ問い合わせてEurekaクラスター構成を取得し、ピアを特定して、未使用のElastic IPアドレスを自身に割り当てます。
Eurekaクライアント(サービスおよびサービスクライアント)は、DNSに問い合わせてEurekaサーバーのネットワーク上の場所を検出します。クライアントは、同じアベイラビリティゾーン内のEurekaサーバーを優先的に使用します。ただし、利用可能なサーバーがない場合は、別のアベイラビリティゾーンにあるEurekaサーバーを使用します。
サービスレジストリのその他の例:
- etcd – 共有構成とサービスディスカバリに使用される、高可用性を備えた分散型の一貫性のあるキーバリューストアです。etcdを使用している代表的なプロジェクトとして、KubernetesとCloud Foundryがあります。
- consul – サービスの検出と設定を行うためのツールです。クライアントがサービスを登録および検出できるAPIを提供します。Consulはヘルスチェックを実行して、サービスが利用可能かどうかを判断できます。
- Apache Zookeeper – 分散アプリケーション向けに広く利用されている高性能なコーディネーションサービスです。Apache Zookeeperは当初Hadoopのサブプロジェクトでしたが、現在はトップレベルプロジェクトです。
また、前述のとおり、Kubernetes、Marathon、AWSなどの一部のシステムには、明示的なサービスレジストリがありません。代わりに、サービスレジストリがインフラストラクチャの一部として組み込まれています。
サービスレジストリの概念を確認したところで、次にサービスインスタンスがサービスレジストリに登録される仕組みを見ていきます。
サービス登録オプション
前述のとおり、サービスインスタンスはサービスレジストリへの登録と登録解除が必要です。登録と登録解除を処理する方法はいくつかあります。1つは、サービスインスタンスが自身を登録する「自己登録パターン」です。もう1つは、別のシステムコンポーネントがサービスインスタンスの登録を管理する「サードパーティ登録パターン」です。まず、自己登録パターンについて見ていきます。
自己登録パターン
When using the 自己登録パターンを使用する場合、サービスインスタンスは自身をサービスレジストリに登録し、登録を解除します。また、必要に応じて、登録の有効期限が切れないようにハートビートリクエストを送信します。次の図は、このパターンの構造を示しています。
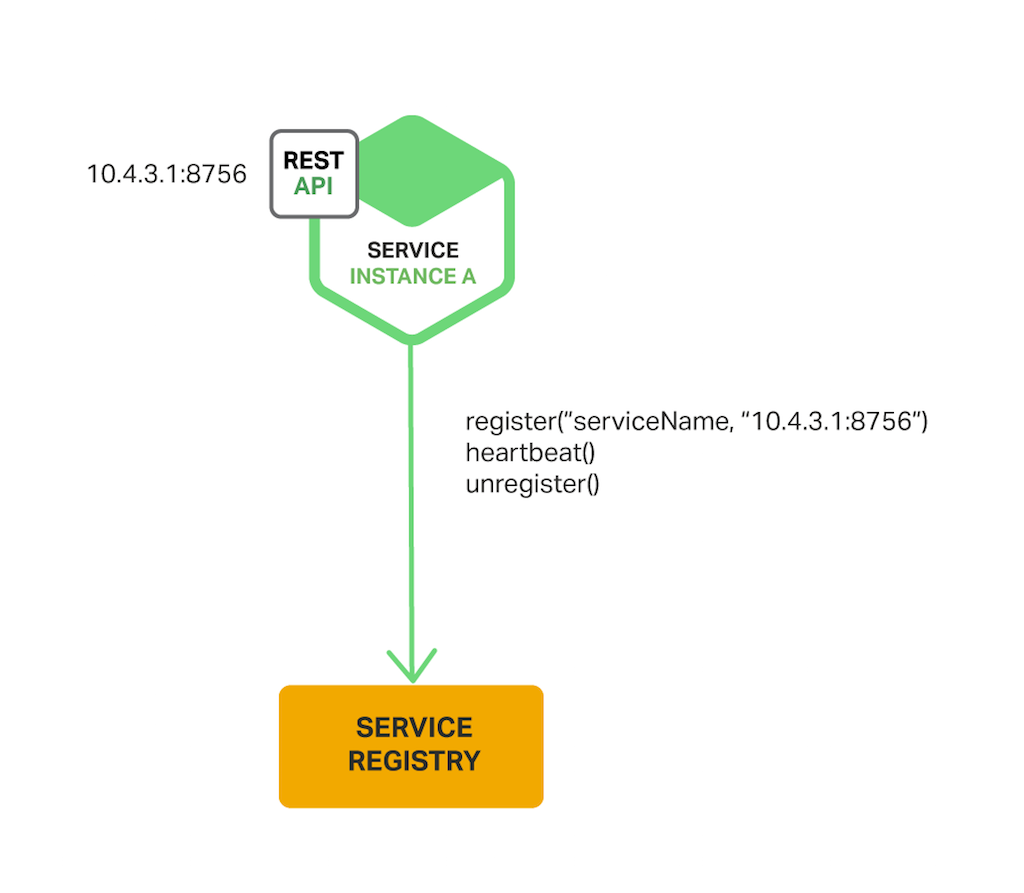
このアプローチの好例が、Netflix OSS Eureka clientです。Eureka clientは、サービスインスタンスの登録と登録解除に関するすべての処理を担います。サービスディスカバリを含むさまざまなパターンを実装するSpring Cloud projectを使用すると、サービスインスタンスをEurekaに簡単に自動登録できます。Java Configurationクラスに@EnableEurekaClientアノテーションを付けるだけです。
自己登録パターンには、さまざまな利点と欠点があります。利点の1つは、比較的シンプルで、ほかのシステムコンポーネントを必要としないことです。ただし、サービスインスタンスがサービスレジストリに密結合するという大きな欠点があります。サービスで使用するプログラミング言語とフレームワークごとに、登録コードを実装する必要があります。
サービスをサービスレジストリから分離する代替アプローチが、サードパーティ登録パターンです。
サードパーティ登録パターン
When using the サードパーティ登録パターンを使用する場合、サービスインスタンス自体がサービスレジストリへの登録を担うことはありません。代わりに、サービスレジストラと呼ばれる別のシステムコンポーネントが登録を処理します。サービスレジストラは、デプロイ環境をポーリングするか、イベントをサブスクライブすることで、実行中のインスタンス群の変化を追跡します。新たに利用可能になったサービスインスタンスを検出すると、そのインスタンスをサービスレジストリに登録します。また、終了したサービスインスタンスをサービスレジストリから登録解除します。次の図は、このパターンの構造を示しています。
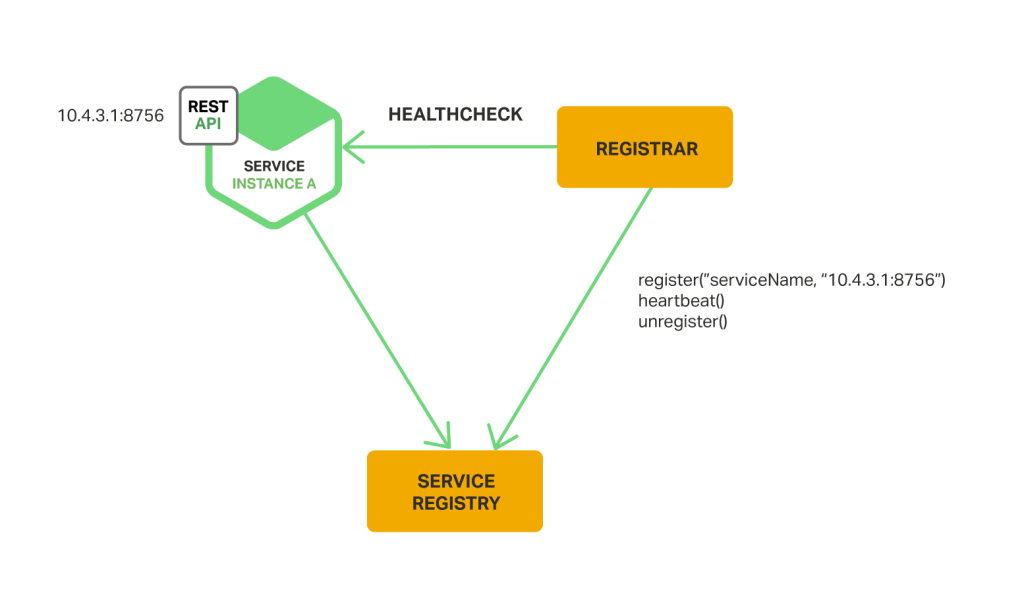
サービスレジストラの一例として、オープンソースの「Registrator」プロジェクトがあります。Dockerコンテナとしてデプロイされたサービスインスタンスを自動的にサービスレジストリへ登録し、登録を解除します。Registratorは、etcdやConsulなど、複数のサービスレジストリをサポートしています。
サービスレジストラのもう1つの例は、NetflixOSS Pranaです。主に非JVM言語で記述されたサービスを対象とし、サービスインスタンスと並行して動作するサイドカーアプリケーションです。Pranaは、Netflix Eurekaにサービスインスタンスを登録し、登録を解除します。
サービスレジストラは、デプロイ環境に組み込まれたコンポーネントです。Autoscaling Groupによって作成されたEC2インスタンスは、ELBに自動的に登録できます。Kubernetesサービスは自動的に登録され、検出できるようになります。
サードパーティ登録パターンには、さまざまな利点と欠点があります。大きな利点は、サービスがサービスレジストリから分離されることです。開発者が使用するプログラミング言語やフレームワークごとに、サービス登録ロジックを実装する必要はありません。代わりに、専用サービス内でサービスインスタンスの登録を一元的に処理します。
このパターンの欠点の1つは、デプロイ環境に組み込まれていない場合、高可用性が求められるシステムコンポーネントがさらに増え、そのセットアップと管理が必要になることです。
まとめ
マイクロサービスアプリケーションでは、実行中のサービスインスタンスの構成が動的に変化します。各インスタンスには、ネットワーク上の場所が動的に割り当てられます。そのため、クライアントがサービスにリクエストを送信するには、サービスディスカバリの仕組みを使用する必要があります。
サービスディスカバリの主要な構成要素は、サービスレジストリです。サービスレジストリは、利用可能なサービスインスタンスのデータベースです。管理APIとクエリAPIを提供します。サービスインスタンスは、管理APIを使用してサービスレジストリに登録され、登録解除されます。システムコンポーネントは、クエリAPIを使用して利用可能なサービスインスタンスを検出します。
サービスディスカバリには、クライアントサイドディスカバリとサービスサイドディスカバリという2つの主要なパターンがあります。クライアントサイドサービスディスカバリを使用するシステムでは、クライアントがサービスレジストリに問い合わせ、利用可能なインスタンスを選択してリクエストを送信します。サーバーサイドディスカバリを使用するシステムでは、クライアントはルーター経由でリクエストを送信します。ルーターはサービスレジストリに問い合わせ、利用可能なインスタンスにリクエストを転送します。
サービスインスタンスをサービスレジストリに登録し、登録解除する方法には、主に2つあります。1つは、サービスインスタンスが自らサービスレジストリに登録する自己登録パターンです。もう1つは、別のシステムコンポーネントがサービスに代わって登録と登録解除を処理するサードパーティ登録パターンです。
一部のデプロイ環境では、Netflix Eureka、etcd、Apache Zookeeperなどのサービスレジストリを使用して、独自のサービスディスカバリインフラストラクチャを構築する必要があります。一方、サービスディスカバリが組み込まれているデプロイ環境もあります。たとえば、KubernetesとMarathonは、サービスインスタンスの登録と登録解除を処理します。また、各クラスターホスト上で、サーバーサイドディスカバリルーターの役割を果たすプロキシも実行します。
NGINXなどのHTTPリバースプロキシおよびロードバランサーは、サーバー側サービスディスカバリのロードバランサーとしても使用できます。サービスレジストリからNGINXにルーティング情報をプッシュし、サービスを中断せずに設定を更新できます。たとえば、Consul Templateを使用できます。NGINX Plusは、追加の動的再構成メカニズムをサポートしています。DNSを使用してレジストリからサービスインスタンスに関する情報を取得できるほか、リモートで再構成するためのAPIも提供します。
今後のブログ記事では、マイクロサービスのその他の側面についても引き続き掘り下げていきます。シリーズの新しい記事が公開された際に通知を受け取るには、以下のフォームからNGINXメーリングリストにご登録ください。
編集部注 – 全7回の本記事シリーズは完結しました:
- マイクロサービス入門
- マイクロサービスの構築:APIゲートウェイの使用
- マイクロサービスの構築:マイクロサービスアーキテクチャにおけるプロセス間通信
- マイクロサービスアーキテクチャにおけるサービスディスカバリ(本記事)
- マイクロサービス向けイベント駆動型データ管理
- マイクロサービスのデプロイ戦略の選択
- モノリスからマイクロサービスへのリファクタリング
一連の記事に加え、NGINX Plusを使用したマイクロサービスの実装に関する情報をまとめた電子書籍「マイクロサービス:設計からデプロイまで」もダウンロードできます。
ゲストブロガーのChris Richardson氏は、Amazon EC2向けの初期のJava PaaS(Platform as a Service)である、初代CloudFoundry.comの創設者です。現在は、アプリケーションの開発およびデプロイ方法の改善に向けて、組織にコンサルティングを提供しています。また、マイクロサービスに関するブログを定期的にhttps://microservices.ioで公開しています。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります