編集部より:この記事は全10回のシリーズの一部です。
- 本番環境で使えるKubernetesで複雑さを軽減
- 高度なトラフィック管理でKubernetesのレジリエンスを向上させる方法
- Kubernetesの可視性を向上させる方法(本記事)
- トラフィック管理ツールでKubernetesのセキュリティを確保する6つの方法
- Ingressコントローラー選定ガイド、第1部:要件の明確化
- Ingressコントローラー選択ガイド、第2部:リスクと将来の変化への備え
- Ingress Controller選定ガイド、第3部:オープンソース版・デフォルト版・商用版の比較
- Ingress Controller選定ガイド、第4回:NGINX Ingress Controllerの選択肢
- サービスメッシュの選び方
- 動的なKubernetesクラウド環境におけるNGINX Ingress Controllersのパフォーマンステスト
ブログシリーズ全体をまとめた無料の電子書籍もダウンロードできます。『Kubernetesをテスト環境から本番環境へ』
マイクロサービスの導入はデジタル体験を加速させますが、マイクロサービスアーキテクチャは、その体験をより不安定にすることもあります。開発者が新しいアプリのリリースを急ぐ一方で、アーキテクチャによっては、システム停止やセキュリティ上の露出のリスクが高まったり、非効率なトラブルシューティングや予防可能な問題の修正に時間を浪費するリスクが高まったりする可能性があります。本番環境に対応したKubernetesを取り上げる本シリーズの第2回では、トラフィックの可視性を提供するコンポーネントが、マイクロサービス環境の複雑さを軽減し、セキュリティを向上させる仕組みを解説します。
可視性を確保し、インサイトを獲得
まず、2つの定義を確認しましょう。
- 可視性 – 見ることができる、または見られる状態
- 洞察 – 人や物事に対する深い理解
In a StackRoxが2020年に実施した調査では、Kubernetesユーザーの75%が可視性を「必須」の機能と位置付けています。Kubernetesでは、何がデプロイされているかを把握することが特に難しい場合があるため、可視性が重要であるという点にF5も同意します。それにもかかわらず、F5の2021年版「State of Application Strategy」(SOAS)の回答者の95%は、豊富なデータはあるものの、インフラストラクチャとビジネスを保護し、進化させるために必要な、アプリのパフォーマンス、セキュリティ、可用性に関するインサイトが不足していると回答しています。では、インサイトはなぜ重要で、どうすれば得られるのでしょうか。
インサイトを活用すると、次のことが可能になります。
- 脆弱性や攻撃経路となり得る箇所を検出し、セキュリティとコンプライアンスを強化
- 顧客が気づく前に問題を発見し、サービス停止とダウンタイムを削減
- アプリの問題の根本原因を特定し、トラブルシューティングを効率化
- トラフィックの送信先が意図した宛先のみに限定されていることを確認
- Kubernetes環境で何が稼働しているか、また、それらが適切に構成され、セキュリティが確保されているかを正確に把握します
- レイテンシとパフォーマンスの履歴に基づいて、リソースの使用量が適切かどうかを把握
- 過去のトラフィックパターンに基づいて季節ごとのニーズを予測
- 応答時間を指標としてパフォーマンスを測定し、サービスレベル契約(SLA)に照らしてパフォーマンスを追跡するとともに、問題がユーザーエクスペリエンスに影響する前に早期警告を行う仕組みとして活用します
インサイトを得るには、リアルタイムと履歴の2種類の可視性データが必要です。リアルタイムデータを使うと、現在発生している問題の原因を診断できます。一方、履歴データは、何が「正常」で、何が外れ値なのかを判断するための視点を提供します。この2種類の可視性データを組み合わせることで、アプリとKubernetesのパフォーマンスに関する重要なインサイトを得ることができます。
他のテクノロジー投資と同様に、そのメリットを得るための戦略も必要です。また、SOASレポートは、採用や人材育成、戦略やプロセス、そしてデータを何のために、いつ、誰が活用すべきかについての合意形成に関わる組織的な要因によって、有益なインサイトが得られていないことを示しています。調査結果には、次のようなものがあります。
- 関連するスキルセット — 熟練した技術者の不足は広く知られています。回答者の47%が必要な人材の確保に苦労していると答えており、この状況が裏付けられています。
- データ共有の取り組み:レジリエンスを備えたテクノロジーの有無がビジネスに与える影響を意思決定者に認識してもらうために、データを報告するプロセスと戦略を整備している回答者は、わずか12%です。
- 可視性の目的 — 回答者の大半は、問題発生後の対応(トラブルシューティング)にテレメトリを利用しています。一方、データとインサイトを先回りして活用し、パフォーマンス低下の兆候を監視している回答者はわずか24%、SLAの達成状況を追跡している回答者は16%にとどまります。
この記事の以降の部分では、インサイトの技術的な側面に焦点を当てます。戦略やプロセスなどを取り上げる今後のブログ記事にもご注目ください。
NGINXができること
ほとんどのKubernetes環境ではすでに監視ツールを使用しており、新たなツールは不要であると認識しています。そこで、NGINX Plus APIからメトリクスを簡単にエクスポートできるようにし、広く使われているツールであるOpenTracingやGrafanaおよびPrometheusとの連携を提供することで、クラスター内のパフォーマンスの全体像を把握できるようにしています。詳細なトレースにより、アプリのパフォーマンスと可用性に関する的確なインサイトが得られ、マイクロサービスアプリ全体でリクエストがどのように処理されるかを理解できます。
- イングレス・エグレス(南北)トラフィックの可視化
NGINX Ingress Controllerは、Kubernetesクラスターに出入りするトラフィックを可視化します。NGINXをベースとする主要なIngressコントローラーが3つあることをご存じでしょうか。すべてが本番環境での利用に対応しているわけではなく、選択を誤ると、マイクロサービス戦略を改善するどころか、かえって複雑にしてしまう可能性があります。ブログ記事「今使っているのは、Kubernetes向けのどのNGINX Ingress Controller?」では、ニーズに最適な選択ができるよう、各選択肢を比較しています。 - East-Westトラフィックの可視化
NGINX Service Meshは、コンテナ化されたアプリ間を流れるトラフィックを可視化します。
よくある2つの問題の解決をどのように支援できるか、以下でご紹介します。
この技術が実際に動作する様子を確認するには、NGINXとGrafanaのエキスパートによるライブ配信デモとAMAをご覧ください。負荷分散とパフォーマンスに関する主要なメトリクスをリアルタイムで監視し、それらをPrometheusにエクスポートして、累積的なパフォーマンスを把握するためのGrafanaダッシュボードを作成する方法を実演します。
課題:アプリが遅い(またはダウンしている!)
DDoS攻撃の疑いはありませんか?Webサイトでエラーが発生しているとユーザーから報告を受けていませんか?問題の所在を正確に突き止めなければ、解決に着手できません。
- NGINX Ingress Controllerによるライブ監視
NGINX Plusでは、ライブアクティビティ監視ダッシュボードに、NGINX Plus APIを通じて、負荷とパフォーマンスに関する数百もの主要なメトリクスが表示されます。個々のポッド単位まで詳細を確認できるため、アプリの応答時間をすばやく簡単に測定し、問題の原因を診断できます。Kubernetes環境が拡大した場合も、追加されたNGINX Ingress Controllerインスタンスごとにダッシュボードが自動的に用意されます。たとえば、[HTTP Upstreams]タブの2つの列で、アプリケーションとインフラストラクチャの状態を即座に把握できます。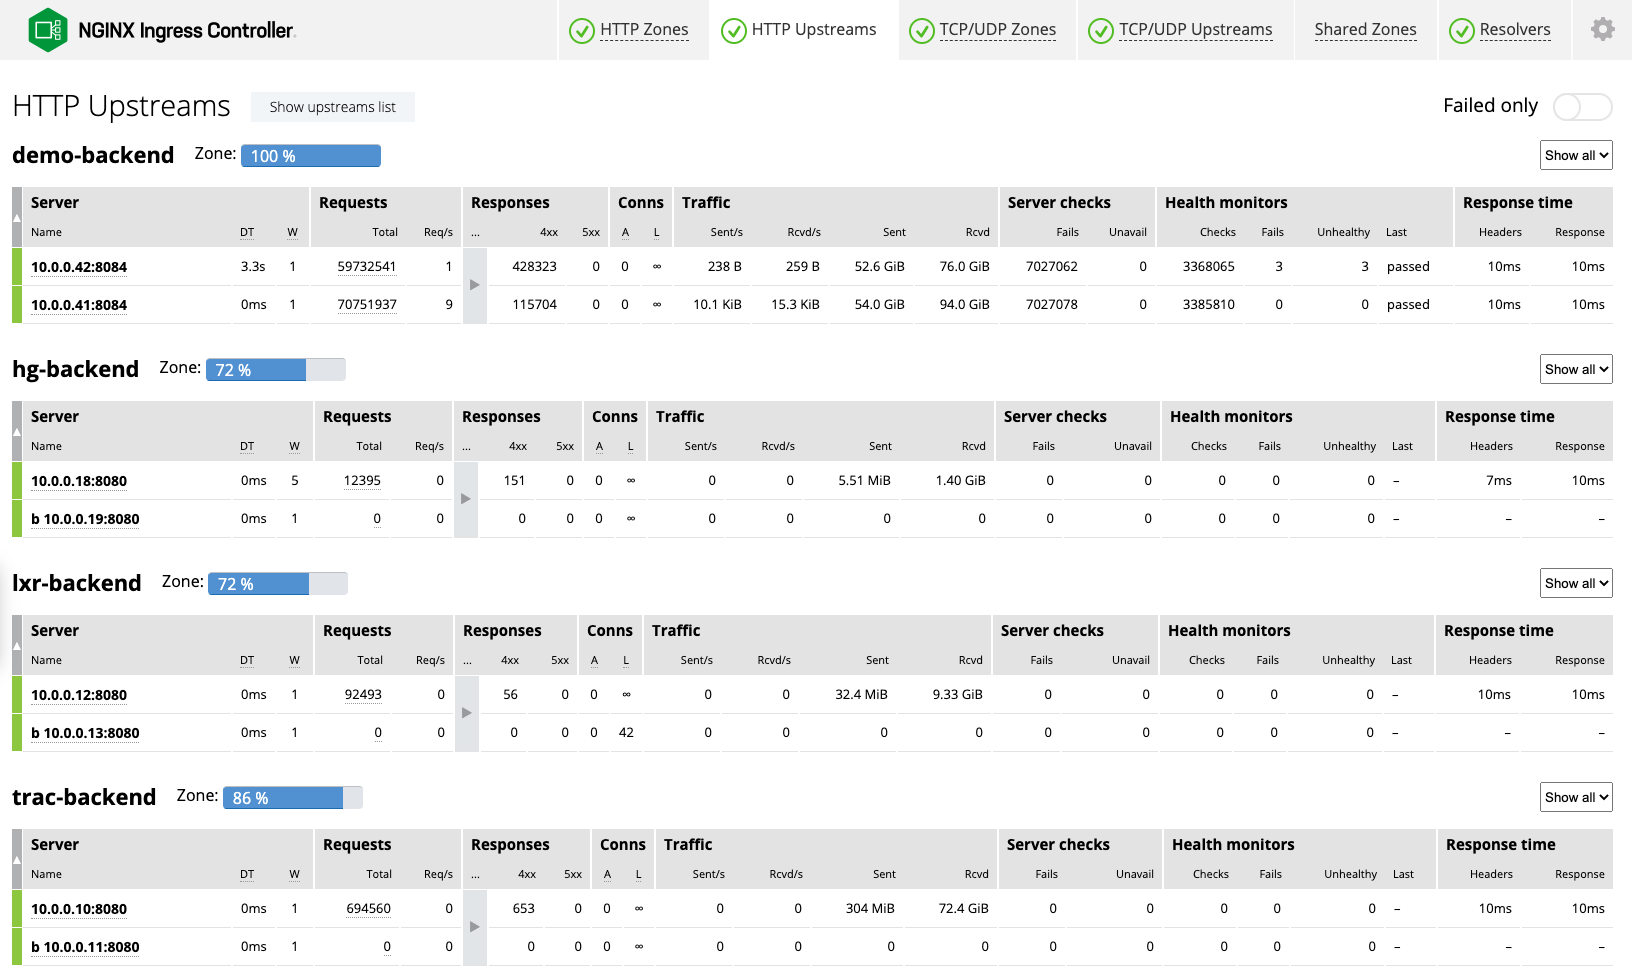
- リクエスト数 — 1秒あたりのリクエスト数(Req/s)が、そのアプリケーションの通常の値を下回っている場合(たとえば、通常は毎秒40件のところが5件になっている場合)、Ingress Controllerまたはアプリケーションの設定に誤りがある可能性があります。
- 応答時間:応答時間が10ミリ秒(ms)以下であれば、非常に良好な状態です。レイテンシが30~40 ms以上になる場合は、アップストリームアプリケーションに問題がある兆候です。
- NGINX Ingress Controllerのスタブステータス
NGINX Open Sourceを使用する場合、NGINX Ingress Controllerには、8つの基本メトリクスを報告するステータスページが含まれています。 - NGINX Service MeshでのOpenTracing
NGINX Service Meshは、NGINX OpenTracing moduleを使用してOpenTracingをサポートします。本稿執筆時点で、このモジュールはDatadog、LightStep、Jaeger、Zipkinをサポートしています。
問題:クラスターまたはプラットフォームのリソースが不足しかけている
HTTPエラーが発生していませんか?503や40xエラーはリソースに問題があることを示し、502エラーは設定変更がうまくいかなかったことを示します。履歴データを使用して、リソースが不足している可能性のある箇所を診断してください。
- NGINX Ingress Controllerによるログ記録
ネットワークの問題を診断する最初のステップは、NGINX Ingress Controllerのログを確認することです。各ログエントリには、関連するKubernetesサービスが注記されています。エラーに関するエントリでは、関連するサービスを特定できます。ログには、タイムスタンプ、送信元IPアドレス、応答ステータスコードなど、Ingress Controllerを通過したすべてのトラフィックの詳細情報が含まれます。また、Datadog、Grafana、Splunkなどの広く利用されているログ集約ツールにログをエクスポートすることもできます。 - Prometheusメトリクス
NGINX Ingress Controllerで特に人気のある機能の1つが、継続的に拡充されているPrometheusメトリクスです。ネットワークパフォーマンスやIngress Controllerのトラフィックに関するメトリクスが含まれます。NGINX Plusを使用すると、NGINX Ingress Controllerはメトリクスをエクスポートします。対象には、接続、キャッシュ、メモリゾーンでデータを共有するNGINXワーカーのグループが処理するHTTPおよびTCP/UDPトラフィック、バックエンドサーバーのグループが処理するHTTPおよびTCP/UDPトラフィックなどが含まれます。NGINX Service MeshはPrometheusサーバーをデプロイします。このサーバーはNGINX Plus APIを使用して、NGINX Service MeshのサイドカーとNGINX Ingress Controllerのポッドからメトリクスをスクレイプします。既存のPrometheusデプロイメントを使用したい場合に備え、Prometheus設定ファイルに追加できるスクレイプ設定も提供しています。 - Grafanaダッシュボード
NGINX Ingress ControllerとNGINX Service Mesh向けに、Prometheus Exporterが公開するメトリクスを可視化する公式Grafanaダッシュボードを提供しています。ミリ秒単位の詳細データ、日ごとのデータの重ね合わせ、トラフィックの急増などを確認できるデータのきめ細かさが、ユーザーから評価されています。たとえば、NGINX Service Meshダッシュボードでは、任意のサービスやポッドのトラフィック量と、監視対象の稼働中ポッド数を表示することで、ポッドが処理能力の上限に達しているかどうかを把握できます。
NGINXで本番環境への準備を整える
本番環境に対応したNGINX Ingress Controller(NGINX Plusベース)の30日間無料トライアルをご利用いただけます。これには、コンテナ化されたアプリのセキュリティを確保するためのNGINX App Protectが含まれています。常時無料のNGINX Service Meshのダウンロードは、f5.comからご利用いただけます。
著者について
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。
SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります