ダウンタイムは深刻な影響をもたらす可能性があります。
この言葉は、他の多くの業界以上に、医療テクノロジー分野の企業に当てはまります。この分野では、「深刻な結果」が文字どおり死を意味することもあります。先日、医療記録の管理を紙とペンによる方法から、世界中のどこからでもいつでもアクセスできる安全なデジタルデータへと変革しようとしている企業の技術スタックを詳しく分析する機会がありました。こうしたデータには、患者情報、ケアに関する指示、生体マーカー、医療分析、過去の記録をはじめ、医療チーム間で共有されるあらゆる情報が含まれます。
同社は創業当初から、一見単純に思える「医療従事者がリアルタイムでデータを簡単に記録できるようにするには、どうすればよいか」という課題に取り組んできました。しかし、事業の成長に伴い、拡張性を確保し、データを常時利用可能にする必要が生じたことで、この課題の解決はますます複雑になりました。ここでは、同社が技術面で歩んできた道のりと、その結果として導入したKubernetesとNGINX Ingress Controllerについて説明します。
技術スタックの概要
- OS:Linux
- コンテナオーケストレーション – Microsoft Azure Kubernetes Service
- Networking – Kubernetes, NGINX Ingress Controller based on NGINX Plus
- ソフトウェア開発言語/フレームワーク – .Net
- 監視、オブザーバビリティ、アラート通知 – Prometheus
- 監視ダッシュボード – Grafana
- ロギング – Grafana Loki
- データベース – Azure SQL Service
- アプリケーションサーバー – Azure App Service, .Net
- メッセージングとストリーミング – Azure Event Hubs
- キャッシュ – Redis
- セキュリティ – NGINX App Protect
- ロケーションとインフラストラクチャ – 2つのアベイラビリティゾーン、2つのKubernetesクラスター、15~20ノード、60~100ポッド
- DevOps – Azure DevOps Services
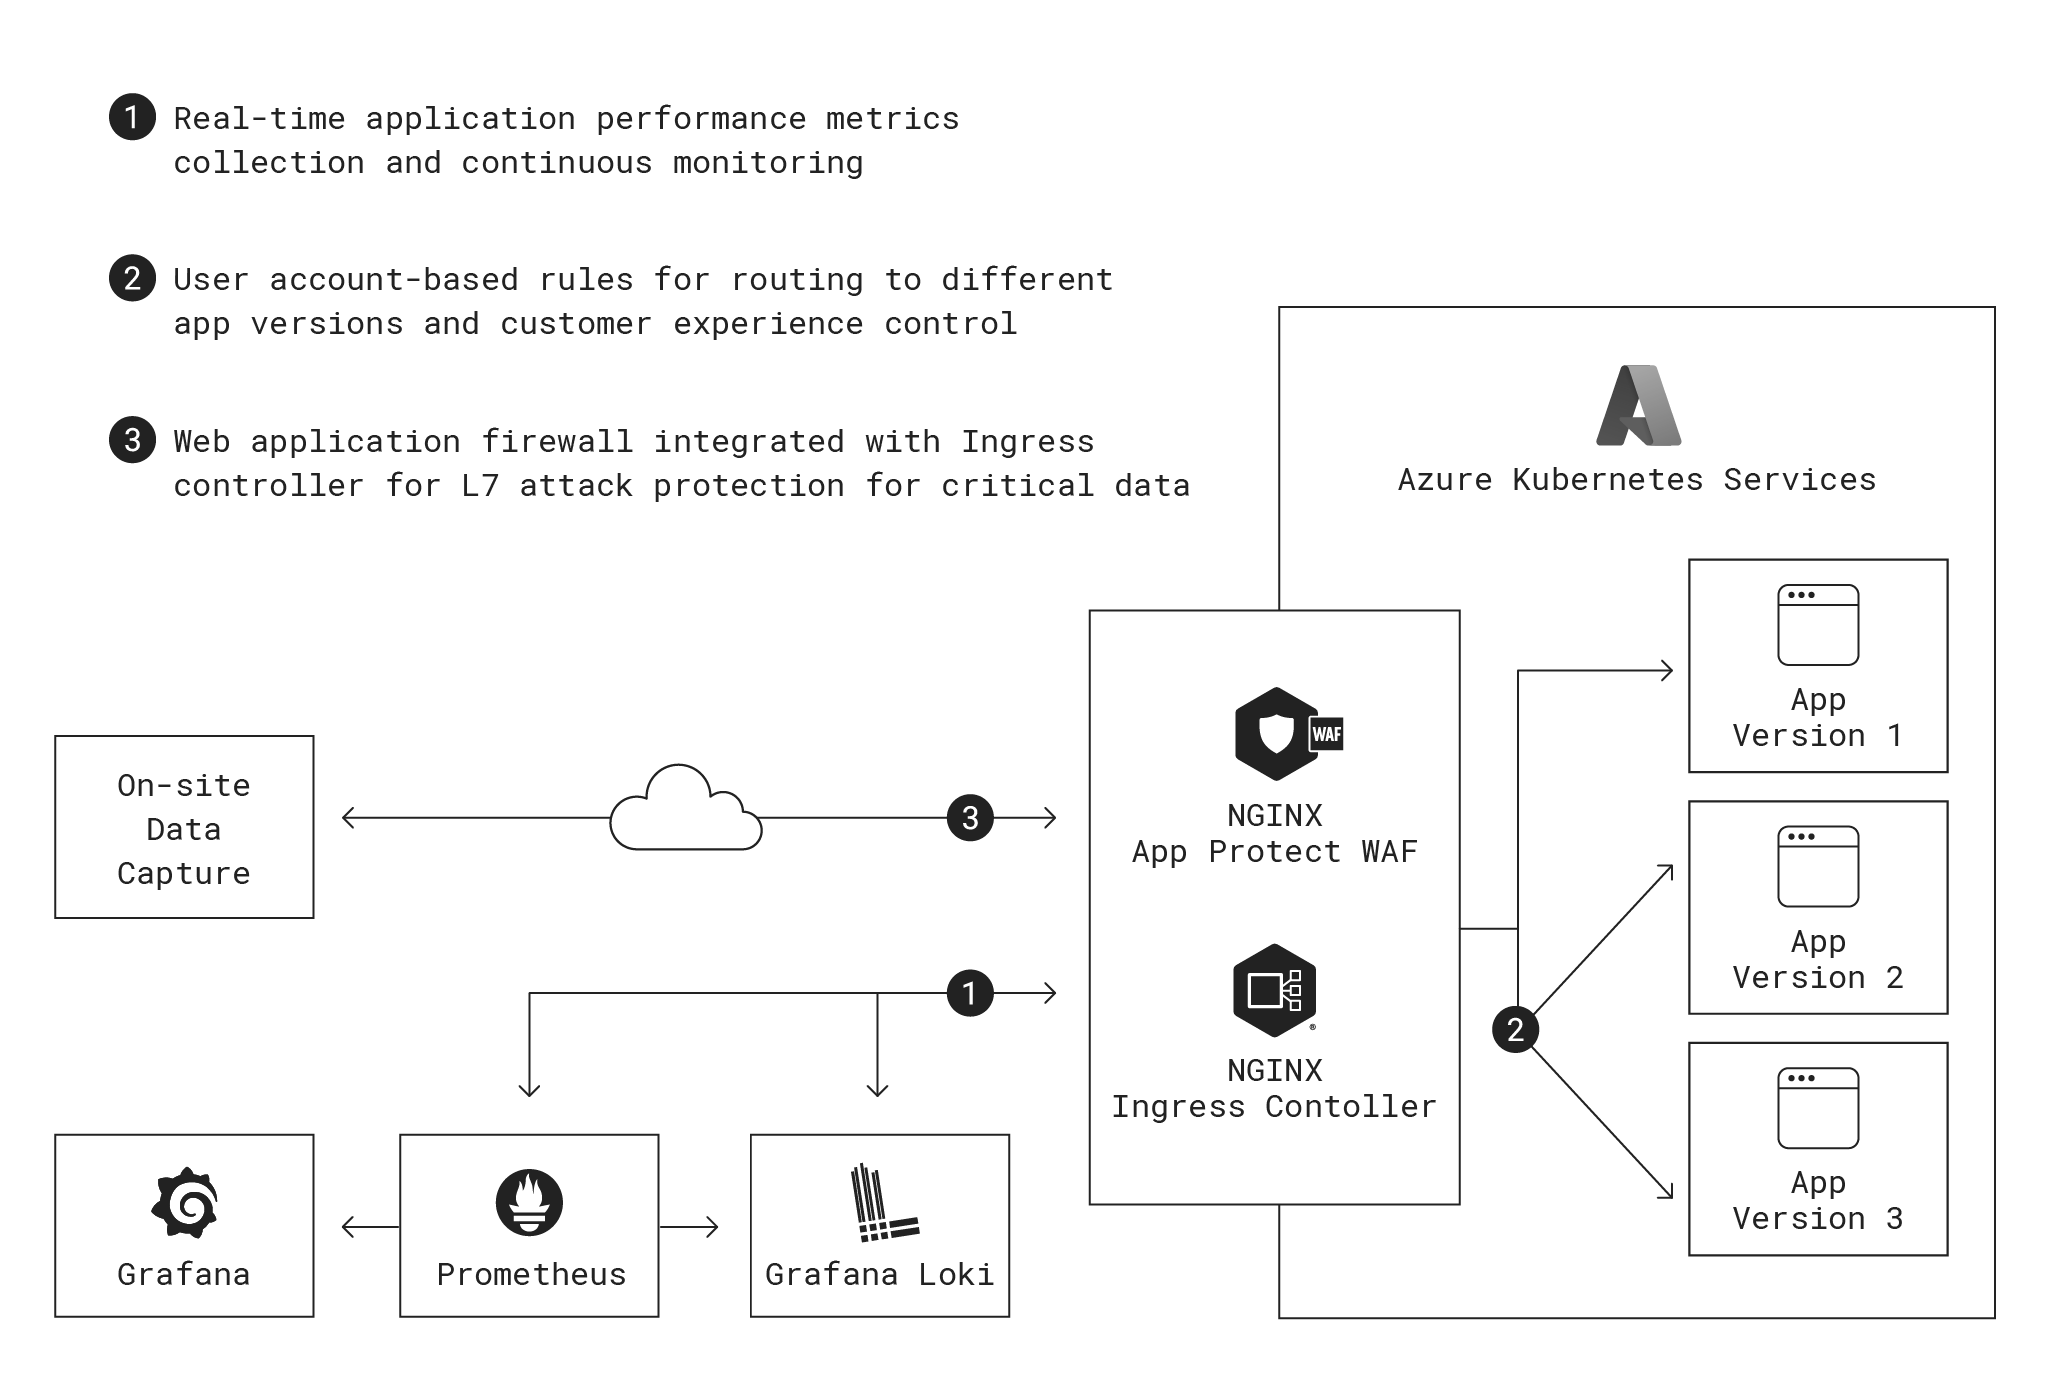
このアーキテクチャにおけるNGINXの位置付けは次のとおりです。
紙ベース運用の問題点
患者の状態やケアに関する情報を定期的に記録することは、医療従事者の重要な業務です。従来は紙に記録していましたが、近年ではノートPCやタブレットも使用されています。しかし、これらの方法には重大な欠点がいくつかあります。
- 医療従事者は1日に数十人の患者に対応することもあるため、ケアを提供しながら詳細な記録を取るのは通常、現実的ではありません。その結果、勤務終了時にまとめて記録することになります。その時点では心身ともに疲れているため、一般的なコメントだけで済ませたくなりがちです。
- 医療従事者は、患者の行動に関する詳細についても記憶に頼らざるを得ません。記録が不正確だと、長期にわたり正確かつ一貫して記録されていれば、より重大な健康上の問題の診断に役立つ可能性のあるパターンを見落とすおそれがあります。
- 紙の記録は、単一の組織内の部門間でさえ簡単には共有できず、ましてや救急救命士、救急外来のスタッフ、保険会社などの外部組織との共有は困難です。ノートPCやタブレットを使用していても、中央のデータストアやクラウドに接続されていなければ、状況はさほど改善しません。
こうした課題に対処するため、同社は、患者情報へのアクセスや、投薬など日常的な処置の記録を簡単に行えるデータ記録システムを構築しました。アクセスしやすく使いやすいため、患者とのやり取りを発生時にリアルタイムで記録できます。
すべてのデータは同社が管理するクラウドシステムに保存されます。また、このアプリは他の電子カルテシステムと連携し、入居者の行動を長期的かつ包括的に把握できるようにします。これにより、介護者はより継続性の高いケアを提供できるほか、安全な履歴記録を作成し、他の医療ソフトウェアシステムと容易に共有できます。
医師やその他の専門家も、患者の受け入れ時や患者に対応する際にこのプラットフォームを利用します。患者の好みや個別のニーズに関する記録は、患者がどの施設に移っても引き継がれます。これらの情報を活用することで、患者が新しい環境でも安心して過ごせるようになり、回復期間などの改善につながります。
企業が患者データを保存しなければならない期間については、厳格な法的要件があります。同社の開発者は、一般的なクラウドアプリケーションよりもはるかに優れた稼働時間SLAを設定し、極めて高い可用性を実現できるようにソフトウェアを構築しました。患者のファイルを読み込めないために救急車を待機させることは許されません。
ガレージからクラウド、そしてKubernetesへの道のり
多くのスタートアップと同様に、同社は当初、共同創業者の自宅に設置したサーバーで最初の概念実証アプリケーションを稼働させ、コストを抑えていました。アイデアに将来性があることが明らかになると、データセンターでハードウェアを管理する代わりに、インフラストラクチャをクラウドへ移行しました。Microsoft製品を中心に利用していたため、Azureを選択しました。当初のアーキテクチャでは、MicrosoftのIIS Webサーバーを実行するマネージドアプリケーションデリバリサービスであるAzure App Service上の従来型仮想マシン(VM)で、アプリケーションを稼働させていました。データの保存と取得には、VM上で稼働するMicrosoft SQL Serverをマネージドアプリケーションとして使用することにしました。
クラウドでの運用を開始して数年が経過すると、同社は急速な成長に伴うスケーリングの課題に直面しました。無制限に拡張できることに加え、VMでは垂直スケーリングに時間とコストがかかるため、水平スケーリングが必要でした。この要件から、コンテナ化とKubernetesが有力な解決策として自然に浮上しました。さらに、同社の開発者は、停止のリスクを抑えながらアプリケーションとインフラストラクチャの更新を頻繁にリリースする必要があり、この点でもコンテナ化が適していました。複数のタイムゾーンで患者の記録が絶えず追加されるため、障害によってお客さまが即座に影響を受けるリスクを伴わずに変更を本番環境へ反映できる、自然なダウンタイムはありません。
同社にとって、まず検討すべき合理的な選択肢は、MicrosoftのマネージドKubernetesサービスであるAzure Kubernetes Services(AKS)でした。チームはKubernetesのベストプラクティスを調査し、AKS上のノードやポッドで稼働するアプリケーションとトラフィックを効果的に管理するには、Kubernetesクラスターの前段でIngressコントローラーを稼働させる必要があると判断しました。
トラフィックルーティングには柔軟性と精度が不可欠
チームはAKSのデフォルトのIngressコントローラーをテストしましたが、そのトラフィックルーティング機能では、必要な方法で顧客にアップデートを提供できないことがわかりました。患者ケアでは、曖昧さや情報の不一致は許されません。たとえば、同じ事象について、あるケアワーカーにはオレンジ色のフラグが表示され、別のケアワーカーには赤色のフラグが表示されるような状況は容認できません。そのため、同じ組織のすべてのユーザーが同じバージョンのアプリを使用する必要があります。これは、アップグレード時の大きな課題となります。顧客を新しいバージョンに移行するのに適したタイミングが自然に生じるわけではないため、サーバーおよびネットワークレベルのルールを使用して、顧客ごとに異なるバージョンのアプリへトラフィックをルーティングする方法が必要でした。
これを実現するため、同社は組織内のすべてのユーザーに同一のバックエンドプラットフォームを提供しており、組織内のインフラストラクチャレイヤーでセグメント化するマルチテナンシーは採用していません。Kubernetesでは、仮想ネットワークルート、ブラウザのCookie、詳細なトラフィックルールを組み合わせてトラフィックを分割できます。しかし、同社の技術チームは、AKSのデフォルトのIngressコントローラーでは、トラフィックを割合に基づいて分割することしかできず、必要とされる顧客組織単位または個々のユーザー単位のルールは適用できないことを確認しました。
基本構成では、NGINX Open SourceベースのNGINX Ingress Controllerにも同じ制約があります。そのため同社は、きめ細かなトラフィック制御をサポートするエンタープライズグレードの製品である、NGINX Plusベースのより高度なNGINX Ingress Controllerへの移行を決定しました。高い柔軟性と制御性を理由に、MicrosoftとKubernetesコミュニティがNGINX Ingress Controllerを推奨していたことも、この選択を後押ししました。この構成は、従来のトラフィック管理ではなく、同社が必要とするPod管理により適しており、Podが適切なゾーンで稼働し、トラフィックが該当するサービスにルーティングされるようにします。トラフィックが内部でルーティングされる場合もありますが、ほとんどのユースケースでは、可観測性を確保するためにNGINX Ingress Controllerを経由して外部へ再度ルーティングされます。
未知の領域:監視、オブザーバビリティ、アプリケーションパフォーマンス
NGINX Ingress Controllerを使用すると、技術チームは開発者とエンドユーザーのエクスペリエンスを完全に制御できます。ユーザーがログインしてセッションを確立すると、すぐに新しいバージョンへルーティングしたり、以前のバージョンへ戻したりできます。組織内のすべてのユーザーに、パッチをほぼ瞬時かつ同時に配信できます。このソフトウェアは、DNSの伝播やクラウドプラットフォーム全体のネットワーク更新に依存しません。
NGINX Ingress Controllerは、詳細かつ継続的な監視という同社の要件にも対応しています。医療分野では、アプリケーションのパフォーマンスが極めて重要です。特に生死に関わる状況では、レイテンシやダウンタイムが適切な臨床ケアの妨げとなる可能性があります。Kubernetesへの移行後、同社が把握していなかったダウンタイムが顧客から報告されるようになりました。同社はほどなくして、問題の原因がサンプリングデータに依存するAzure App Serviceにあることを突き止めました。サンプリングは平均値や大まかな傾向の把握には適していますが、拒否されたリクエストや不足しているリソースなどをまったく捉えられません。また、医療従事者が状況を確認して患者データを記録する際に、通常30分ごとに発生する使用量の急増も把握できません。そのため、同社が把握できていたのは、レイテンシ、エラーの発生源、不正なリクエスト、サービス停止に関する不完全な情報にすぎませんでした。
問題はそれだけではありませんでした。Azure App Serviceで保存データが保持される期間は、デフォルトではわずか1か月で、多くの国の法律で義務付けられている数十年という期間には遠く及びません。長期保存の要件を満たすためにデータストアを拡張するには、法外なコストがかかりました。さらに、AzureソリューションではKubernetesネットワークスタックの内部を可視化できません。NGINX Ingress Controllerは、レイヤー4およびレイヤー7のトラフィックを処理しながら、インフラストラクチャとアプリケーションの両方のパラメーターを監視できます。
パフォーマンスの監視と可観測性の確保に向けて、同社はGrafanaの可視化エンジンおよびダッシュボードに接続したPrometheus時系列データベースを採用しました。PrometheusおよびGrafanaとの統合機能はNGINXのデータプレーンとコントロールプレーンにあらかじめ組み込まれているため、技術チームはわずかな設定変更を行うだけで、すべてのトラフィックをPrometheusおよびGrafanaサーバー経由にできました。また、ログを分析しやすくし、ソフトウェアチームが長期にわたってデータをより適切に管理できるように、情報をGrafana Lokiログデータベースにも転送しました。
この構成は、トラブルシューティングやバグ修正のために、極めて高頻度かつ大量のデータサンプリングが必要となるインシデントにも将来にわたって対応できます。大手クラウド企業の多くが提供するアプリケーション監視システムでは、この種のインシデントへの対応に多額のコストがかかる可能性がありますが、このユースケースにおけるPrometheus、Grafana、Lokiのコストと運用負荷は最小限です。いずれも安定したオープンソース製品であり、通常、初期チューニング後はパッチ適用以外の作業をほとんど必要としません。
方針を貫く:高可用性とセキュリティを重視
同社はこれまで一貫して、極めて機密性の高いデータを保護するためのセキュリティと、高可用性必要なときにいつでもアプリを利用できるようにするための高可用性という2つの領域に注力してきました。Kubernetesへの移行にあたり、両方の機能を強化するため、いくつかの変更を加えました。
最高レベルの可用性を実現するため、技術チームは、単一障害点のない完全な冗長性を備えた、アクティブ/アクティブ、マルチゾーン、マルチリージョンの分散インフラストラクチャ設計を採用しています。2つの異なる地域にKubernetesクラスターを二重に配置し、N+2のアクティブ/アクティブインフラストラクチャを維持しています。各地域では、ソフトウェアを複数のデータセンターにまたがって展開することでダウンタイムのリスクを軽減し、インフラストラクチャのどのレイヤーで障害が発生しても対応できるようにしています。アフィニティルールとアンチアフィニティルールにより、ユーザーとトラフィックを稼働中のPodへ即座に再ルーティングし、サービスの中断を防止できます。
セキュリティ対策として、チームは不正なリクエストや悪意のある攻撃者から保護するために、Webアプリケーションファイアウォール(WAF)を導入しています。OWASP Top 10への対策は、ほとんどのWAFが備える基本的な機能です。アプリの開発にあたり、チームはAzureネイティブのWAFやModSecurityなど、複数のWAFを調査しました。最終的に、インラインWAFと分散型サービス拒否(DDoS)攻撃対策を備えたNGINX App Protectを採用しました。
NGINX App Protectの大きな利点は、NGINX Ingress Controllerと同じ場所に配置できるため、冗長なポイントを1つ排除し、レイテンシーも低減できることです。他のWAFはKubernetes環境の外部に配置する必要があり、レイテンシーとコストの増加につながります。ごくわずかな遅延(たとえば、リクエストごとに1ミリ秒の追加)でも、時間の経過とともに急速に積み重なります。
思わぬ副次効果:開発者のダウンタイムを解消
アプリケーションおよびネットワークインフラストラクチャの大部分をAKSへ移行したことで、同社では開発者体験(DevEx)も大幅に向上しました。現在では、ほぼ常に、お客さまが問題に気付く前に開発者が問題を発見できています。移行後、エラーに関するサポートへの問い合わせ件数は約80%減少しました。
同社のセキュリティチームとアプリケーションパフォーマンスチームは、詳細なGrafanaダッシュボードと統合アラートを利用できるため、複数のシステムを確認したり、異なるプロセスから送られる警告メッセージや電話通知のトリガーを実装したりする必要がなくなりました。開発チームとDevOpsチームは現在、コードやインフラストラクチャの更新を毎日、場合によっては1日に複数回リリースでき、極めてきめ細かなブルーグリーンパターンも使用できます。以前は週に1~2回しか更新をリリースできず、利用が少ない時間帯に合わせる必要があったため、大きな負担となっていました。現在は、準備が整い次第コードをリリースし、アプリケーションの動作を観察することで、開発者がその影響を直接監視できます。
あらゆる面で成果が上がっています。ソフトウェア開発のスピードが向上し、開発者の士気も高まり、より多くの命を救えるようになりました。
著者について
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります