
Dieser Blogbeitrag ist der erste einer Reihe, in der wir verschiedene Aspekte beleuchten, die für die Entwicklung und den Betrieb unseres SaaS-Dienstes erforderlich waren:
- Steuerungsebene für eine verteilte Kubernetes-PaaS
- Globales Service Mesh für verteilte Anwendungen
- Plattformsicherheit für verteilte Infrastruktur, Anwendungen und Daten
- Anwendungs- und Netzwerksicherheit verteilter Cluster
- Observability auf einer global verteilten Plattform
- Betrieb und Site Reliability Engineering (SRE) einer global verteilten Plattform
- Golang-Service-Framework für verteilte Microservices
Wie wir in unserem früheren Blogbeitrag beschrieben haben, entwickeln unsere Kunden komplexe und vielfältige Geschäftslösungen – etwa für intelligente Fertigung, Video-Forensik im Bereich der öffentlichen Sicherheit, algorithmischen Handel und 5G-Telekommunikationsnetze. Daher müssen wir für diese Anwendungen und ihre Endnutzer ein durchgehend verfügbares, vernetztes und zuverlässiges Nutzungserlebnis gewährleisten.
Da diese Anwendungen in mehreren Clustern bei verschiedenen Cloud-Anbietern oder an Edge-Standorten unserer Kunden ausgeführt werden können, musste unser Plattformteam eine verteilte Steuerungsebene und einen PaaS-Dienst entwickeln, um mehrere mandantenfähige Kubernetes-Cluster bereitzustellen, abzusichern und zu betreiben. Diese verteilte Steuerungsebene bietet zahlreiche Vorteile in Bezug auf Betrieb, Skalierung und Leistung, auf die wir in unserer Präsentation (Videolink) eingehen werden – beispielsweise darauf, wie sich Tausende von Edge-K8s-Clustern mit GitOps verwalten lassen. Außerdem werden wir das Thema in den kommenden Wochen in einem separaten Blogbeitrag behandeln.
Kurzfassung (Zusammenfassung)
- Wir konnten auf dem Markt keine benutzerfreundliche Lösung finden, mit der sich mehrere Anwendungscluster, die über verschiedene Cloud-Anbieter, Private Clouds oder mehrere Edge-Standorte verteilt sind, bereitstellen, absichern und betreiben lassen.
- Wir konnten keine robuste Kubernetes-Distribution oder PaaS (z. B. OpenShift, Cloud Foundry usw.) finden, die ein umfassendes Spektrum an Sicherheits- und Betriebsdiensten für verteilte Cluster bereitstellte – beispielsweise PKI-basierte Identitäten, RBAC und Benutzerzugriffsverwaltung, cloudanbieterübergreifende Verwaltung von Geheimnissen und Schlüsseln, ein Multi-Cluster-Service-Mesh, Observability und Audit-Protokolle oder Anwendungs- und Netzwerksicherheit.
- Anthos (Google), Azure Arc (Microsoft) und Rancher sind Verwaltungsplattformen für mehrere Cluster, die verschiedene Dienste bündeln. Unsere Analyse ergab, dass sie unsere Anforderungen an Betrieb, Skalierung, Sicherheit und Mandantenfähigkeit von Anwendungs- und Infrastrukturdiensten über mehrere Cluster hinweg nicht erfüllt hätten.
- Wir mussten eine eigene verteilte Steuerungsebene für unsere verwaltete PaaS entwickeln, die auf Kubernetes aufbaut. Wir begannen mit einer Standardversion von Kubernetes und nahmen anschließend umfangreiche Änderungen vor, um die von unseren DevOps- und SRE-Teams benötigten Plattformdienste bereitzustellen. Darüber hinaus mussten wir eine Steuerungsebene entwickeln, um eine große Anzahl verteilter Cluster zu verwalten und Mandantenfähigkeit über heterogene Infrastrukturen hinweg zu ermöglichen (am Edge, in unserem Netzwerk und bei mehreren Cloud-Anbietern).
Kubernetes für das App-Management: Warum und wie
Wir haben Kubernetes (K8s) als Kern unserer Plattform für die Verwaltung verteilter Anwendungen gewählt, da es umfangreiche Funktionen bietet, ohne dabei übermäßig viele Vorgaben zu machen. So bleiben wir flexibel und können Innovationen in den Bereichen vorantreiben, die unserer Meinung nach für unsere Kunden wichtig sind. Auf dieser Grundlage haben wir mit der Entwicklung unseres Dienstes begonnen. Da K8s immer beliebter wird, ist es zudem einfacher, Entwickler und Betreiber zu finden, die damit vertraut sind.
Allerdings ist die Bereitstellung und Verwaltung einer großen Anzahl produktionsreifer Kubernetes-Cluster in einer hybriden Umgebung (mehrere Clouds, Netzwerk-POPs und Edge-Standorte) nicht ganz einfach, da es für Kubernetes keine sofort einsatzbereiten Lösungen gibt, die Folgendes leisten können:
- Heterogene Infrastrukturressourcen durch automatisierte Clusterbildung, Skalierung und Zero-Touch-Bereitstellung vereinheitlichen; dies war insbesondere am Edge und in unseren Netzwerk-PoPs problematisch
- Eine leistungsstarke und zuverlässige Konnektivität zwischen unterschiedlichen Standorten gewährleisten – insbesondere bei der providerübergreifenden Cloud-Anbindung und bei Verbindungen von Edge-Standorten
- Lösen Sie das Sicherheitsproblem bei Daten während der Übertragung, ruhenden Daten, Geheimnissen, Schlüsseln und im Netzwerk – gestützt auf eine einheitliche PKI-Identität, die über Edge, Netzwerk und Cloud hinweg funktioniert.
- Echte Mandantenfähigkeit – mit Mandantenisolierung und Sicherheitsgarantien – sowie die Möglichkeit, Produktions- und Entwicklungsworkloads für interne Zwecke und Kundenanforderungen auf denselben Clustern auszuführen
- Observability und Betrieb über verteilte Cluster hinweg ermöglichen und dabei zentrale Richtlinien und Zielvorgaben einbinden, ohne eine komplexe Protokoll- und Metrikerfassung aufbauen zu müssen
Nach mehreren Machbarkeitsstudien mit verschiedenen Cloud-Anbietern und Open-Source-Plattformen wie GKE, AKS, EKS und RKE sowie OpenShift und Cloud Foundry stellten wir fest, dass keine davon alle fünf oben genannten Anforderungen erfüllen konnte. Daher beschlossen wir, unsere eigene PaaS aufzubauen. Als Grundlage diente uns ein unverändertes Kubernetes, das wir unter anderem um Funktionen für Identitätsverwaltung, Netzwerke, Sicherheit, Mandantenfähigkeit, Protokollierung und Metriken erweiterten. Obwohl wir Kubernetes zur Erfüllung unserer internen Anforderungen einsetzen, mussten wir einige schwierige Entscheidungen treffen. So stellen wir diese Kubernetes-Cluster unseren internen Benutzern und/oder Kunden nicht direkt zur Ausführung ihrer Workloads zur Verfügung. Mehr dazu später, denn Mandantenfähigkeit war für uns ein zentrales Ziel.
Neben zahlreichen neuen Funktionen, die wir hinzufügen mussten, bestand außerdem die Notwendigkeit, unsere Workloads und Services gemeinsam mit den Workloads unserer Kunden an vielen Standorten am Edge, in unserem Netzwerk sowie in öffentlichen und privaten Clouds auszuführen. Daher mussten wir zusätzliche Funktionen für die Verwaltung mehrerer Cluster in unterschiedlichen Umgebungen entwickeln, die alle über unser globales Netzwerk und unsere verteilten Anwendungs-Gateways miteinander verbunden sind, um Cluster-übergreifend Zero-Trust-Konnektivität auf Anwendungsebene bereitzustellen.
Die Herausforderung: Mandantenfähigkeit und Multi-Cluster-Unterstützung für Kubernetes
Das Erstellen und Betreiben von Anwendungen in einem einzelnen Kubernetes-Cluster ist keine triviale Aufgabe – selbst dann nicht, wenn ein von einem Cloud-Anbieter verwalteter Cluster genutzt wird. Daher versuchen DevOps- und SRE-Teams häufig, ihren Aufwand zu minimieren und sich nicht mit der Komplexität zahlreicher Cluster auseinanderzusetzen. Oft erstellen Teams einen großen Kubernetes-Cluster und führen darin sämtliche Arten von Ressourcen zusammen. Das mag zunächst vorteilhaft erscheinen, da sich so der Betrieb vereinfachen und der Cluster mit maximaler Recheneffizienz und möglichst geringen Kosten betreiben lässt. Aus mehreren Gründen ist dies jedoch nicht die beste Lösung. Erstens unterscheiden sich die Anforderungen von Produktions-Workloads deutlich von denen in Entwicklungs-, Test- und Staging-Umgebungen – instabile Entwicklungs-Workloads können potenziell Probleme für stabilere Produktions-Workloads verursachen.
Neben den Anforderungen unterschiedlicher Workloads sind auch die Einschränkungen von K8s hinsichtlich Sicherheit und Isolation ein weiterer Grund für den Einsatz mehrerer Cluster. Ein typischer Ansatz zur Gewährleistung der Sicherheit und Ressourcenisolation in K8s besteht darin, im Rahmen eines mandantenfähigen Modells für jeden Mandanten einen eigenen Cluster einzurichten. Während dies in der Cloud durchaus machbar sein kann, ist der Betrieb mehrerer Cluster am Edge nicht möglich. Edge-Standorte verfügen nur über begrenzte Rechen- und Speicherressourcen sowie eine eingeschränkte Netzwerkbandbreite, um Protokolle und Metriken für jeden zusätzlichen Cluster an die zentrale Cloud zu senden.
Um das Problem mehrerer Kubernetes-Cluster zu lösen, evaluierten wir Rancher für die zentrale Verwaltung unserer Kubernetes-Cluster (als wir damit begannen, gab es Anthos und Azure Arc noch nicht) sowie KubeFed. Damals standen zwei Ansätze zur Verfügung (und daran hat sich bis heute nichts geändert):
- Die Multi-Cluster-Verwaltung (z. B. mit Rancher) über eine zentrale Konsole hätte es uns ermöglicht, mehrere Cluster an beliebigen Standorten bereitzustellen und Lebenszyklusverwaltungsvorgänge wie Upgrades, Rollbacks usw. durchzuführen. Einige dieser Systeme boten zudem die Möglichkeit, einzelne Cluster mithilfe von Automatisierung zu konfigurieren und Anwendungen darauf bereitzustellen.
- Ein weiterer Ansatz besteht darin, eine Steuerungsebene für einen Kubernetes-Clusterverbund (KubeFed) bereitzustellen, die mehrere physische Cluster wie einen einzigen Cluster erscheinen lässt. Als wir uns damit befassten, stand dieses Projekt noch ganz am Anfang, und selbst heute befindet es sich erst im Alpha-Stadium.
Nach der kürzlichen Ankündigung von GCP Anthos und Azure Arc haben wir unsere ursprüngliche Entscheidung, eine verteilte Steuerungsebene aufzubauen, erneut geprüft. Dabei kamen wir zu dem Schluss, dass selbst diese beiden neuen Angebote zwei entscheidende Probleme verteilter Cluster nicht hätten lösen können. Die beiden zentralen Funktionen, die wir für unsere Plattform benötigten, waren:
- Verwaltung mehrerer Cluster als Flotte, um Vorgänge wie Konfiguration, Bereitstellung, Metrikerfassung usw. über alle Cluster oder eine logische Gruppe von Clustern hinweg ausführen zu können. Dies ist von entscheidender Bedeutung, da wir den Betriebsaufwand für unsere SRE-Teams reduzieren, die Fehlerdiagnose für unsere DevOps-Teams vereinfachen und die Skalierbarkeit unseres Systems verbessern möchten.
- Möglichkeit, einen einzelnen physischen Kubernetes-Cluster für die Mandantenfähigkeit zu unterteilen, ohne dafür physische Cluster bereitstellen zu müssen – dies ist besonders in ressourcenbeschränkten Umgebungen entscheidend, in denen wir nicht allein für die Mandantenfähigkeit neue physische Cluster hinzufügen möchten.
Um diese beiden Probleme zu lösen, mussten wir eine neue Technik entwickeln – eine verteilte Steuerungsebene –, die den betrieblichen Mehraufwand „mehrerer“ Cluster reduziert und in Umgebungen mit begrenzten Ressourcen ein Äquivalent zu „mehreren Clustern“ für die Mandantenfähigkeit bereitstellt.
Verteilte Steuerungsebene: Wie wir Kubernetes mit mehreren Clustern realisiert haben
Unser Plattformteam beschloss, eine verteilte Steuerungsebene für Kubernetes zu entwickeln, die unserem Team Kubernetes-APIs zur Verfügung stellt. Diese APIs stammen jedoch aus „virtuellen“ Clustern, die nur innerhalb unserer Steuerungsebene existieren – ein virtueller K8s-API-Server (vK8s) für einen virtuellen K8s-Cluster (wie in Abbildung 1 dargestellt). Diese Steuerungsebene überträgt die Absicht des Benutzers auf mehrere physische Kubernetes-Cluster, die an unseren Edge-Standorten, unseren Netzwerk-POPs und in öffentlichen Cloud-Umgebungen ausgeführt werden. Auf diese physischen Cluster kann ausschließlich unsere verteilte Steuerungsebene zugreifen, nicht jedoch einzelne Mandanten oder Benutzer.
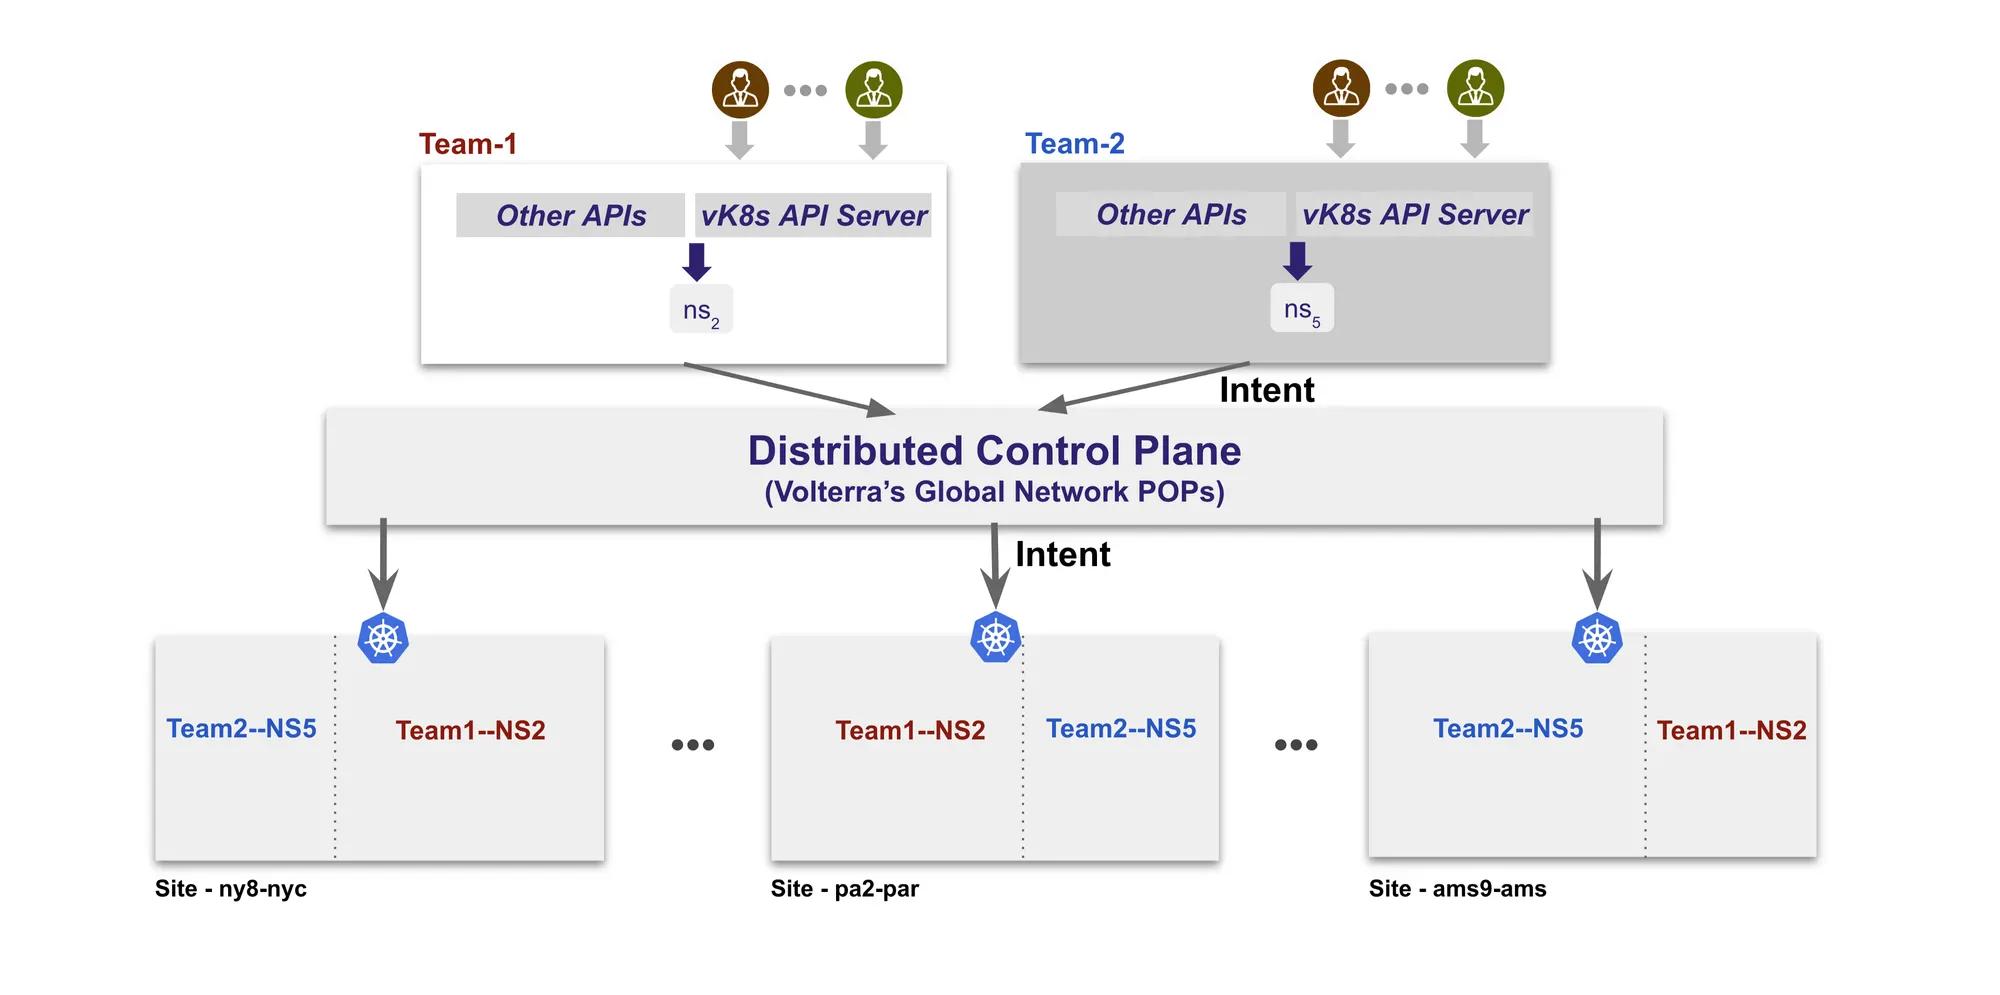
Diese Steuerungsebene stellt jedem Mandanten einen oder mehrere „virtuelle“ Anwendungscluster bereit, in denen er seine Anwendung(en) bereitstellen kann. Je nach Konfiguration repliziert und verwaltet die Steuerungsebene diese über mehrere physische Kubernetes-Cluster hinweg. Neben Konfigurations- und Bereitstellungsvorgängen folgt auch die Überwachung diesem „virtuellen“ Cluster, ohne dass dafür Werkzeuge zum Erfassen und Aufschlüsseln von Daten aus mehreren physischen Clustern entwickelt werden müssen.
Nehmen wir als Beispiel eine UI-Anwendung namens productpage, die der Benutzer verteilt auf drei Standorte ausführen möchte – pa2-par, ny8-nyc und ams9-ams – mit jeweils zwei Replikaten. Wenn der Benutzer ein vK8s-Objekt erstellt und es einem virtuellen Cluster zuordnet, wird sofort ein vK8s-API-Server bereitgestellt, der mit dem standardmäßigen kubectl verwendet werden kann.
Im nächsten Schritt lädt der Benutzer die kubeconfig für diesen virtuellen Cluster herunter und erstellt eine standardmäßige YAML-Datei, um ein K8s-Deployment für productpage zu beschreiben.
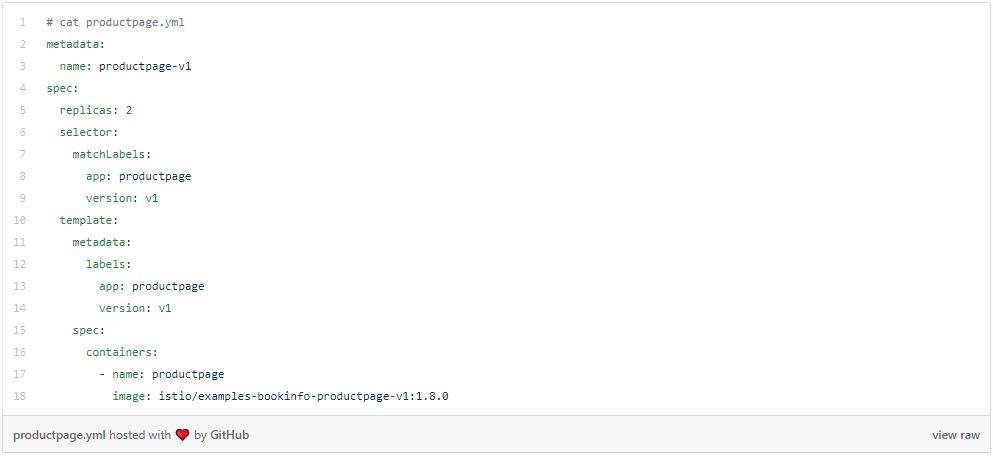
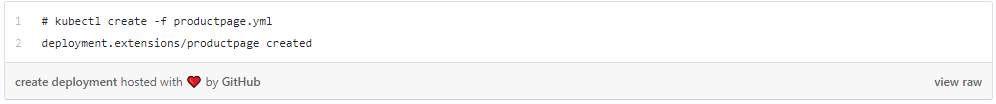
Nach der Erstellung der Bereitstellungsspezifikation kann der Benutzer mit der Erstellung einer Bereitstellung auf diesem virtuellen Cluster fortfahren:
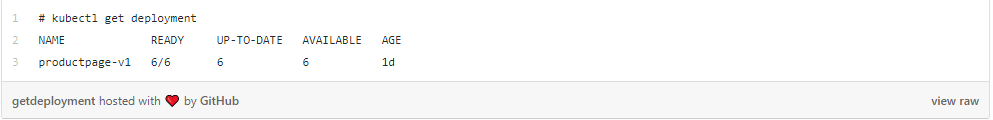
Wenn der Benutzer nun seine Bereitstellung überprüft, sieht er, dass sechs Replikate gestartet wurden, jeweils zwei an jedem Standort (pa2-par, ny8-nyc und ams9-ams).
Die folgende Ausgabe zeigt zwei Pods, die an jedem Standort ausgeführt werden und jeweils einem bestimmten physischen Knoten zugeordnet sind.
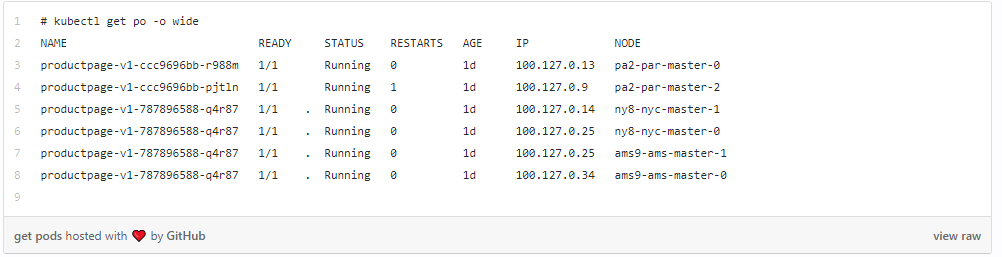
Dieses einfache Beispiel zeigt, wie unkompliziert sich jede beliebige Anwendung innerhalb weniger Minuten über mehrere Cluster hinweg replizieren lässt – ganz ohne Installations- und Verwaltungsaufwand. Neben der Umsetzung der gewünschten Konfiguration bietet die verteilte Steuerungsebene auch Observability für den virtuellen Cluster als Ganzes und nicht nur für einzelne Cluster.
Verteilte Steuerung und zentrale Verwaltung für Mandantenfähigkeit
Wie in Abbildung 2 zu sehen ist, wird unsere zentrale Verwaltungsebene bei zwei Public-Cloud-Anbietern (jeweils in einer Region) betrieben – einmal in AWS und einmal in Azure (zur Redundanz). Diese Verwaltungsebene ermöglicht es unserem SRE-Team, Mandanten mit strikter Mandantentrennung zu erstellen. So kann beispielsweise ein Entwicklungsteam, das an unserem VoltMesh-Service arbeitet, einen Mandanten bilden, während ein Customer-Solutions-Team, das an Proofs of Concept für Kunden arbeitet, einen eigenen Mandanten mit eigenen Benutzern erhalten kann.
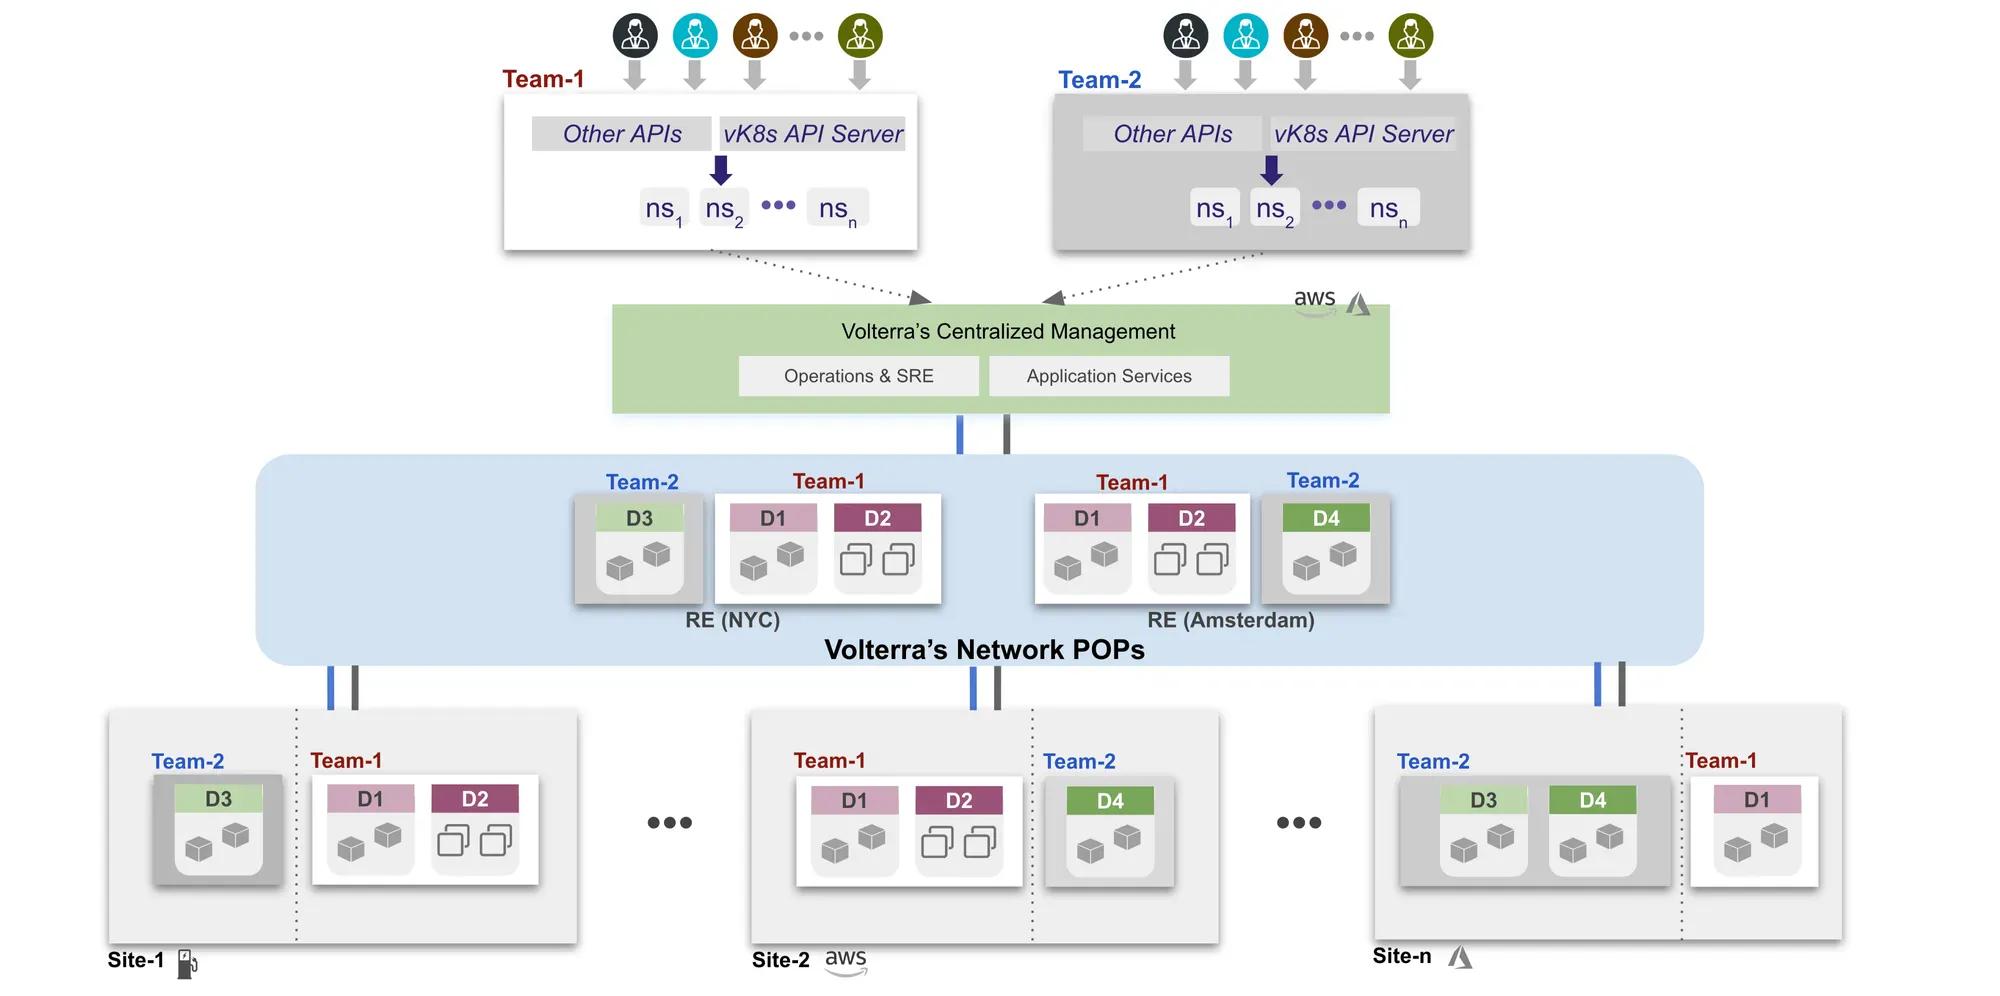
Jeder dieser Mandanten kann mehrere Namespaces erstellen und eine Gruppe von Benutzern zuweisen, die in diesen Namespaces zusammenarbeiten. Bei diesen Namespaces handelt es sich nicht um Kubernetes-Namespaces, sondern um eine Isolationsgrenze innerhalb unserer Plattform mit RBAC-Regeln und IAM-Richtlinien für Benutzer.
Wenn ein Benutzer innerhalb eines Namespace einen Anwendungscluster erstellen möchte, erstellt er ein vK8s-Objekt, das wiederum einen vK8s-API-Server in unserer Managementebene erzeugt. Mithilfe dieses vK8s-Objekts kann der Benutzer Deployments, StatefulSets, PVCs usw. erstellen. Die Steuerungsebene stellt dabei sicher, dass diese Vorgänge je nach den dem vK8s-Objekt zugeordneten Standorten auf einem oder mehreren physischen Clustern ausgeführt werden.
Da jeder Mandant und Benutzer unveränderte Standard-K8s-Operationen verwendet, ist das System mit zahlreichen bei Betreibern beliebten Tools kompatibel, z. B. Spinnaker, Helm, Jenkins usw.
Erzielte Vorteile durch eine verteilte Steuerungsebene
Der große Vorteil einer verteilten Steuerungsebene besteht darin, dass sie den Betriebsaufwand für unsere SRE- und DevOps-Teams erheblich reduziert hat. Sie können nun Vorgänge wie Konfiguration, Bereitstellung, Überwachung und Richtlinienverwaltung in einem virtuellen Cluster durchführen, während die Steuerungsebene diese automatisch auf mehrere physische Cluster abbildet. Neben der Vereinfachung des Betriebs mehrerer Cluster hat die Steuerungsebene auch die Sicherheits- und Isolationsprobleme bei der Mandantenfähigkeit gelöst.
Diese verteilte Steuerungsebene hat auch die Produktivität der Entwickler verbessert, die unserer Plattform neue Funktionen hinzufügen möchten: Sie müssen nicht jedes Mal neue Automatisierungen entwickeln, wenn sie Funktionen hinzufügen, die sich auf die Konfiguration oder den Betrieb mehrerer Cluster auswirken. Sie verwenden das absichtsbasierte Konfigurationsmodell, und die Steuerungsebene weiß, was zu tun ist. Darüber hinaus können sie weiterhin über kubectl mit diesem verteilten Multi-Cluster-Objekt – dem virtuellen Kubernetes – interagieren, anstatt dafür eine weitere CLI verwenden zu müssen.
Nachdem wir dies nun seit mehr als einem Jahr in unseren Entwicklungs-, Test-, Staging- und Produktionsumgebungen betreiben, haben wir festgestellt, dass diese global verteilte Steuerungsebene (die in unseren Netzwerk-POPs ausgeführt wird) auch erhebliche Vorteile hinsichtlich Skalierbarkeit, Leistung und Zuverlässigkeit bietet – etwas, das wir uns in der Anfangszeit noch nicht in vollem Umfang vorgestellt hatten. Auf diese Erkenntnis werden wir in unserem bevorstehenden KubeCon-Vortrag sowie in den kommenden Wochen in einem separaten Blogbeitrag eingehen.
Fortsetzung folgt…
In dieser Blogreihe beleuchten wir verschiedene Aspekte dessen, was nötig war, um unseren global verteilten SaaS-Dienst mit zahlreichen Anwendungsclustern in der Public Cloud, unseren privaten Netzwerk-PoPs und Edge-Standorten aufzubauen und zu betreiben. Als Nächstes folgt Globales Service Mesh für verteilte Anwendungen…
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...