Was passiert mit dem Sicherheitswert Ihres KI-Modells, nachdem Sie es nicht mehr testen?
Die meisten Teams gehen davon aus, dass die Antwort „nichts“ lautet, weil sie vor der Einführung eine Red-Team-Bewertung durchgeführt, ein gutes Ergebnis erzielt und sich dann anderen Aufgaben zugewandt haben. Doch jedes Unternehmen verändert gleichzeitig dieselben drei Faktoren: Geschwindigkeit, Skalierbarkeit und Sicherheit. Sie wollen KI-Funktionen schnell bereitstellen, deren Vertrauenswürdigkeit gewährleisten und beides ohne Kompromisse über eine wachsende Zahl von Modellen, Agenten und Integrationen hinweg erreichen.
In der Praxis geht die starke Fokussierung auf einen dieser Aspekte jedoch fast immer zulasten eines anderen. Ein Team, das ein Modell bereitstellt, das alle paar Wochen aktualisiert wird, kann nicht jedes Mal sechs Wochen für eine manuelle Überprüfung aufwenden. Daher werden die Ergebnisse des Vormonats weiterhin als gültig betrachtet oder ein nicht validiertes Modell bleibt ungeschützt. Red teaming war früher ein Punkt, den man vor der Einführung einfach abhakte. Doch statische Tests zu einem bestimmten Zeitpunkt können mit der rasanten Entwicklung von KI-Bedrohungen inzwischen nicht mehr Schritt halten.
“KI-Red-Teaming ist ein kontinuierlicher Prozess, der mit der Entwicklungsgeschwindigkeit der Systeme Schritt halten muss, die es schützt.”
Generische Einheitstests können mit den Risiken, die sich aus den individuellen Arbeitsabläufen, der Branche und den regulatorischen Rahmenbedingungen eines Unternehmens ergeben, nicht Schritt halten. Genau deshalb benötigen Fachleute Red Teaming, das auf ihre spezifische Umgebung zugeschnitten ist. Einige Kunden haben es bereits direkt in ihre Pipelines und Infrastruktur integriert.
Was CASI- und ARS-Scores tatsächlich messen
Statische Tests können zeigen, dass ein Modell einen Test bestanden hat, aber nicht, wie gut es anhaltenden, ausgefeilten oder sich weiterentwickelnden Angriffen standhält. Deshalb hat F5 Labs zwei objektive Kennzahlen entwickelt: den Comprehensive AI Security Index (CASI) und den Agentic Resistance Score (ARS). Sie bieten Sicherheitsteams eine klare Möglichkeit, Modelle zu bewerten, die Sicherheitslage im Zeitverlauf zu verfolgen und die Führungsebene über Risiken zu informieren. Im Folgenden erfahren Sie, was die beiden Kennzahlen tatsächlich messen.
Umfassender KI-Sicherheitsindex (CASI) – CASI ist eine zusammengesetzte Kennzahl zur Messung der Gesamtsicherheit eines Modells (Methodik hier). Dabei werden unter anderem die Anzahl erfolgreicher Angriffe, die Schwere der möglichen Folgen und der Aufwand berücksichtigt, den ein Angreifer dafür betreiben musste. Je höher der Wert, desto stärker ist die allgemeine Sicherheitslage des Modells.
Agentischer Widerstandswert (ARS) – Der ARS misst, wie gut das gesamte KI-System standhält, wenn ein Team autonomer Angriffsagenten aktiv versucht, es zu kompromittieren, vertrauliche Informationen zu extrahieren, die Systemarchitektur zu kartieren oder das Modell durch Social Engineering zu manipulieren. Ein hoher ARS bedeutet, dass die Schutzmechanismen des Systems auch unter anhaltendem, gezieltem Druck intakt bleiben – und nicht nur bei einem einzelnen Angriffsversuch.
Wie CASI, ARS und F5 AI Red Team in der Praxis eingesetzt werden
Die meisten Sicherheitsteams nutzen bereits herkömmliche Tools wie Static Application Security Testing (SAST), um den Quellcode zu überprüfen, und Dynamic Application Security Testing (DAST), um die laufende Anwendung zu testen. Keines dieser Tools wurde dafür entwickelt, zu prüfen, ob sich das der Anwendung zugrunde liegende KI-Modell täuschen, manipulieren oder schrittweise zermürben lässt.
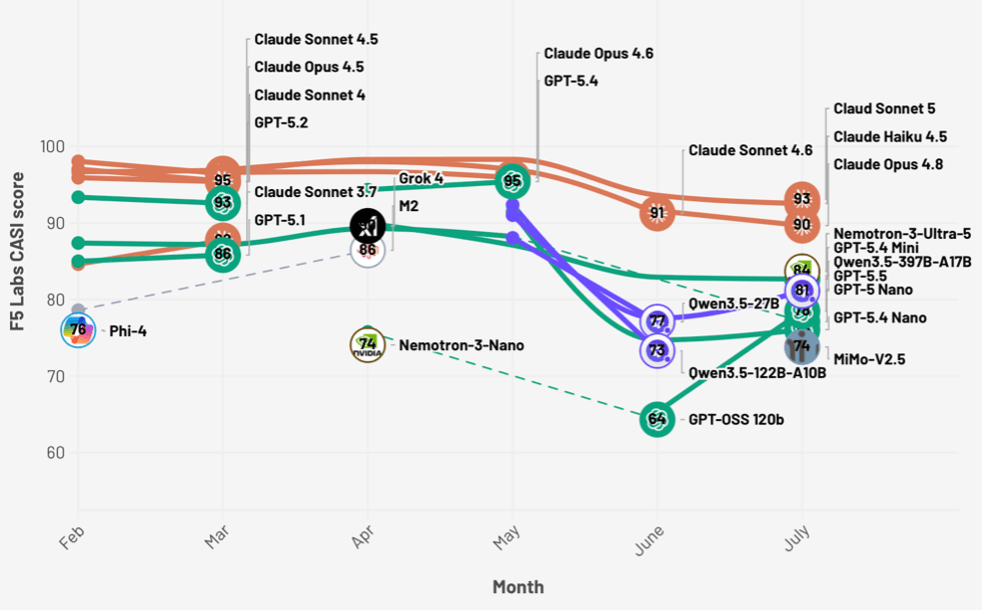
Ein CASI-Score ist zum Zeitpunkt seiner Ermittlung aussagekräftig, doch Modelle und Bedrohungen entwickeln sich ständig weiter. Ein Modell, das in einem Testzyklus einen Wert von etwa 93 erreicht, kann einige Monate später nur noch bei 73 bis 77 liegen. Das entspricht einer Schwankung von 15 bis 20 Punkten – ganz ohne Codeänderung auf Kundenseite, sondern allein deshalb, weil sich das zugrunde liegende Modell verändert hat. Deshalb integrieren einige Kunden von F5 AI Red Team erneute Tests direkt in ihre CI/CD-Release-Pipeline. Sobald eine neue Modellversion oder eine feinabgestimmte Variante veröffentlicht wird oder genügend Zeit vergangen ist, werden die CASI- und ARS-Basiswerte erneut überprüft, anstatt davon auszugehen, dass der Wert aus dem letzten Quartal weiterhin gilt.
Regulierung benutzerdefinierter Intents
Ein standardmäßiger CASI-Durchlauf zeigt, wie gut ein Modell einer umfangreichen Sammlung bekannter Angriffe standhält. Risiken, die mit einer bestimmten neuen Funktion oder rechtlichen Anforderung verbunden sind, werden dabei jedoch nicht automatisch erkannt. So bergen etwa ein Gesundheits-Chatbot, der um eine Symptomprüfung erweitert wird, oder ein Finanzagent, der Überweisungen veranlassen kann, Risiken, nach denen ein allgemeiner Test keinen Anlass hat zu suchen. Für solche Szenarien erstellen Kunden individuell zugeschnittene Angriffsintentionen, die auf eine bestimmte Funktionalität oder regulatorische Anforderung ausgerichtet sind.
Nehmen wir an, ein multinational eingesetztes Vertragsmanagement-Tool muss in einer Region auf die Einhaltung der Vorgaben des EU AI Act und andernorts auf einen völlig anderen Standard für personenbezogene Daten geprüft werden. Mit benutzerdefinierten Intents können Teams gezielt genau die Regel oder Funktion testen, deren Konformität sie nachweisen müssen, anstatt sich auf eine allgemeine Abdeckung zu verlassen.
Aufbau eines internen Kompetenzzentrums für Red Teaming
Einige größere Organisationen (darunter mindestens eine große Anwaltskanzlei) sind noch einen Schritt weiter gegangen und haben ein kleines, spezialisiertes internes Team aufgebaut, dessen einzige Aufgabe darin besteht, KI-Anwendungen für die übrigen Geschäftsbereiche Red-Team-Tests zu unterziehen. Dieses Team kennt sowohl die Bedrohungslandschaft der Organisation als auch deren CASI- und ARS-Ergebnisse und arbeitet bei der Entwicklung neuer KI-Funktionen direkt mit den Produkt- und Schwachstellenmanagementteams zusammen.
Sicherheitsteams teilen die CASI-Ergebnisse mit Anwendungsentwicklern, um eine einfache Botschaft zu vermitteln: Nicht jedes Modell weist dasselbe Sicherheitsniveau auf – wer vom Gegenteil ausgeht, lässt Risiken unbemerkt durchschlüpfen. Dadurch wird eine Wissenslücke zwischen InfoSec- und DevOps-Teams geschlossen, die sich andernfalls möglicherweise überhaupt keine Gedanken über Risiken auf Modellebene machen würden.
Die wichtigste Erkenntnis ist, dass sich die Bedrohungslandschaft schneller verändert, als die meisten Sicherheitsteams manuell Schritt halten können. KI-Red-Teaming ist eine kontinuierliche Praxis, die sich im gleichen Tempo weiterentwickeln muss wie die Systeme, die sie schützt. Dafür muss sie:
- Kontinuierlich erfolgen: Manuelle, mehrwöchige Testphasen können mit der rasanten Weiterentwicklung von Modellen und Agenten nicht Schritt halten.
- Schließen Sie die Lücke zwischen dem Erkennen und dem Beheben eines Risikos: Die Ergebnisse des Red Teamings fließen direkt in die Behebung ein. So wird aus einem statischen Testbericht ein Impulsgeber für schnellere, priorisierte Maßnahmen gegen tatsächliche Risiken.
- Geben Sie Sicherheitsteams die Möglichkeit, ihre Arbeit nachzuweisen: Jede Bewertung liefert einen CASI- und einen ARS-Score. So können Teams ihre Sicherheitslage objektiv und anhand von Benchmarks im Zeitverlauf verfolgen und Risiken gegenüber der Führungsebene klar kommunizieren.
Die Sicherheitslandschaft verändert sich derzeit schneller, als irgendjemand vorhersagen kann. Mit F5 AI Red Team, CASI und ARS können Sicherheitsteams jedoch kontinuierlich von aktuellen Bedrohungsinformationen gestützte Leitplanken etablieren.
Weitere Informationen finden Sie auf den Webseiten F5 AI Red Team und den F5 Labs CASI and ARS Leaderboards.
Über den Autor
Ähnliche Blogbeiträge

Kubernetes-native WAF für das Gateway-Zeitalter: F5 WAF for NGINX lässt sich jetzt in F5 NGINX Gateway Fabric integrieren
F5 erweitert WAFs, um mit F5 NGINX Gateway Fabric und F5 NGINX Ingress Controller einen konsistenten, skalierbaren Schutz über Cluster und Umgebungen hinweg bereitzustellen.

Von Regeln zu Risiken: Die Entwicklung von WAFs und der Aufstieg KI-gestützter Ergebnisse
WAF-Programme geraten oft an einem bekannten Punkt ins Stocken: Der Blockierungsmodus wird verzögert aktiviert, weil die Feinabstimmung aufwendig ist.

Erklärbarkeit: Licht ins Dunkel der KI-Blackbox bringen
Einblicke von James White, CTO bei CalypsoAI: Dank GenAI verstehen wir inzwischen gut, wie Antworten generiert und an uns zurückgegeben werden. Vereinfacht gesagt basiert KI auf einer Transformer-Architektur – sie wählt die beste Vorhersage für das nächste Wort und den nächsten Satz aus und liefert anhand der ihr vorliegenden Informationen die wahrscheinlichste Antwort […]
Die neue KI-Risikolandschaft: unsichtbar, autonom und bereits im Unternehmen
James White, VP Engineering, F5 Zur Jahresmitte 2025 ist es an der Zeit, eine Momentaufnahme der KI-Nutzung in Unternehmen und des aktuellen Stands der KI-Sicherheit zu erstellen. Der Einsatz generativer KI ist in Unternehmen mittlerweile Standard Unternehmen verfügen inzwischen durchweg zumindest über ein grundlegendes Verständnis von generativer KI. Sie wissen, was sie ist und wo sie […]
Die KI-Grenzen sichern: Strategien zur Bekämpfung von Datenexfiltration
Da Unternehmen zunehmend Modelle der generativen KI (GenAI) und große Sprachmodelle (LLMs) in ihre digitalen Systeme integrieren, sind sie mit neuen und erhöhten Risiken konfrontiert. Wenig überraschend stehen dabei Risiken im Zusammenhang mit Datenexfiltration – der unbefugten Übertragung von Daten aus einem Unternehmen an ein externes Ziel – meist ganz oben auf der Prioritätenliste der Sicherheitsteams. Ein Verständnis […]
Everest Group-Bericht: Aktuelle Trends und Zukunftsaussichten bei der Einführung von GenAI in der Industrie
Wir freuen uns, einen wesentlichen Beitrag zu einem wegweisenden neuen Bericht der Everest Group, einem weltweit führenden Forschungsunternehmen, geleistet zu haben. Der Bericht mit dem Titel „Generative AI Adoption – Examining Real-world Use in Horizontal Functions and Future Outlook“ bietet eine eingehende Analyse der Einführung generativer KI (GenAI) in verschiedenen Branchen. Dem Bericht zufolge ist die IT […]