Jeder grundlegende Wandel in der Anwendungsarchitektur zwingt das Netzwerk dazu, sich anzupassen. Das ist keine neue oder gar revolutionäre Idee. Wir haben das schon oft erlebt. Und jedes Mal lief es nach demselben Muster ab: Ein neuer vorherrschender Anwendungstyp entstand, und „das Netzwerk“ passte sich an, um ihn zu unterstützen, weil diese Anwendungen Funktionen erfordern, die der bestehende Stack nicht bieten kann. Genau diesen Druck erleben wir derzeit bei der KI-Inferenz.
Inferenz ist kein Training. Sie ist kein Experimentieren. Sie ist keine Data-Science-Übung. Inferenz ist Laufzeitverhalten im Produktivbetrieb und verhält sich wie eine Anwendungsschicht. Sie hat Nutzer, Datenverkehrsmuster, Latenzanforderungen, Ausfallmodi, Kostenvorgaben und Sicherheitsrisiken. Wer sie wie einen Backend-Dienst oder eine spezialisierte Arbeitslast behandelt, verkennt, was tatsächlich geschieht.
Inferenz ist ein neuer Anwendungstyp.
Unsere jährliche Studie macht diese Realität deutlich. Fast 80 % der Unternehmen betreiben Inferenz selbst. Nur eine kleine Minderheit verlässt sich ausschließlich auf öffentliche KI-Dienste. Die meisten Unternehmen führen Inferenz in ihren eigenen Umgebungen, über mehrere Clouds hinweg und parallel zu herkömmlichen Anwendungen und APIs aus. Schon heute müssen sie sich bei der Inferenz mit Problemen in den Bereichen Routing, Verfügbarkeit, Leistung und Sicherheit auseinandersetzen.
Das ist der entscheidende Punkt. Die Probleme treten während der Inferenz auf – nicht davor, nicht danach und schon gar nicht während des Trainings.
Herkömmliche Bereitstellungstechniken reichen hier nicht aus. Beim Load Balancing wird davon ausgegangen, dass die Backends austauschbar sind. Integritätsprüfungen setzen eine binäre Verfügbarkeit voraus. Die statische Datenverkehrssteuerung geht von einem vorhersehbaren Verhalten aus. Keine dieser Annahmen trifft zu, wenn sich Kosten, Qualität, Latenz und Risiko von Anfragen je nach Prompts, Tokens und Modellverhalten unterscheiden.
Daher, folglich und somit muss sich „das Netzwerk“ erneut verändern.
Der neue Netzwerk-Stack
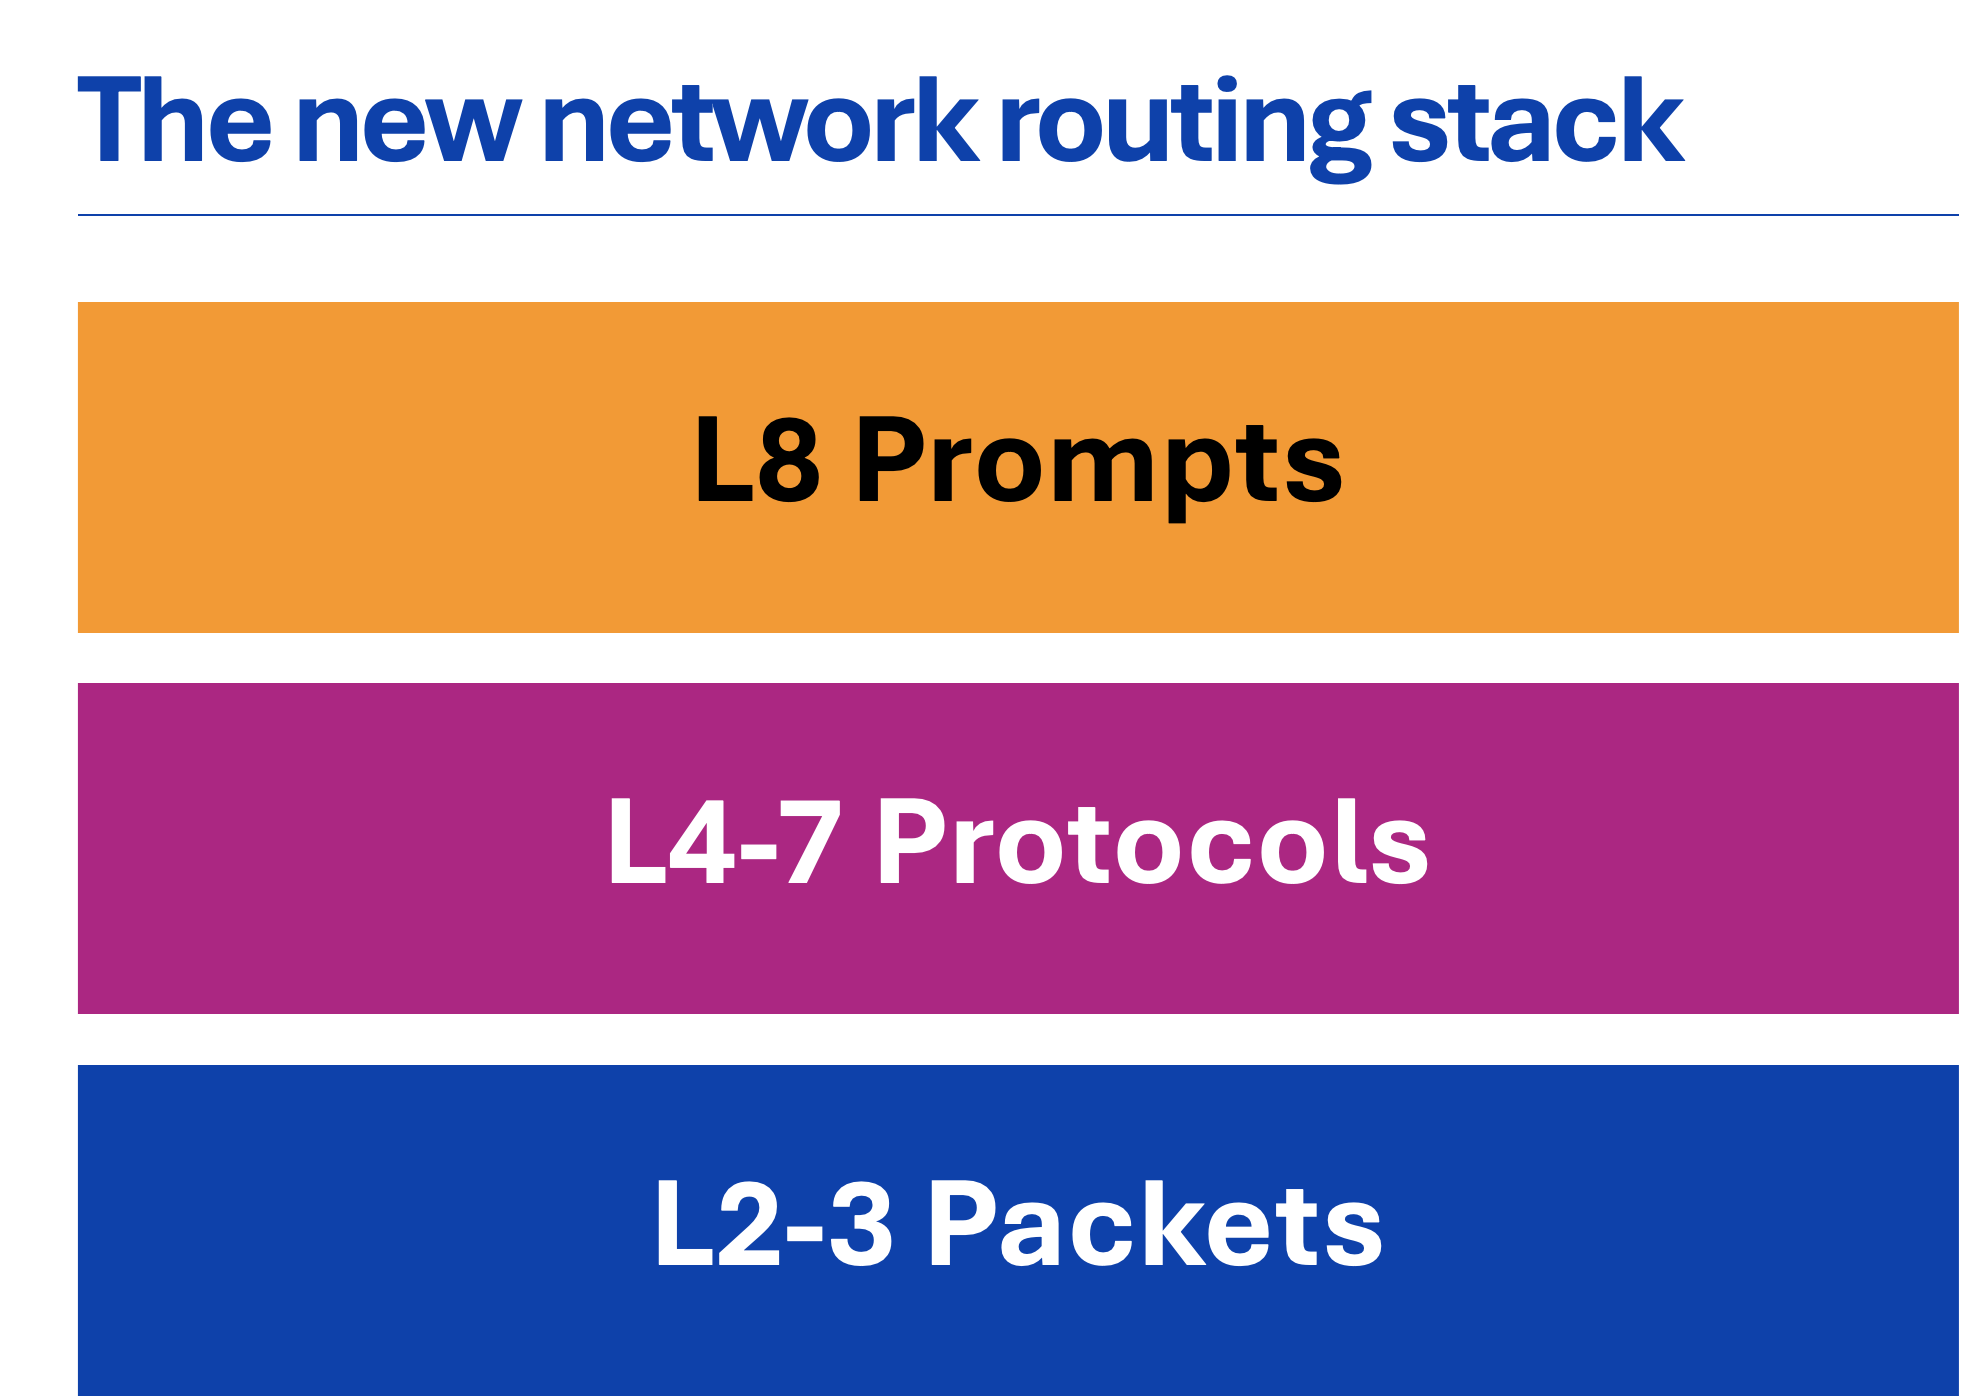
Seit Jahrzehnten wird der Netzwerk-Stack anhand von Paketen und Protokollen beschrieben. Die Schichten 2 und 3 verarbeiteten Pakete. Die Schichten 4 bis 7 waren für Sitzungen, Protokolle und Anwendungen zuständig. Dieses Modell funktionierte, weil Anwendungen ihre Absicht und ihren Zweck über Protokolle zum Ausdruck brachten. Inferenz tut das nicht.
Inferenz drückt Absicht und Zweck durch Prompts aus.
Deshalb erleben wir jetzt die Entstehung einer neuen dominanten Schicht: Layer 8, die Prompt-Schicht.
Moment mal, Lori, denkst du jetzt vielleicht. Wir führen das Routing doch schon lange anhand von Teilen der Nutzdaten durch. Was ist also diesmal so anders?
Danke der Nachfrage!
Der Unterschied ist tatsächlich ziemlich tiefgreifend, insbesondere wenn man bedenkt, dass URIs bei der Inferenz keinen „Funktionen“ zugeordnet werden und dass die Ermittlung dessen, was aufgerufen wird, die Extraktion der Absicht aus dem … Prompt erfordert. Genau deshalb hat sich die nutzdatenbasierte Datenverkehrssteuerung nicht zu einer neuen Schicht entwickelt. Sie hat die Spielregeln nicht grundlegend verändert. Inferenz? Oh, Inferenz verändert nicht nur die Spielregeln, sie schreibt sie regelmäßig neu.
Das Entscheidende ist nun, dass Routing-Entscheidungen auf der „Prompt-Ebene“ nicht mehr ausschließlich auf IP-Adressen, Ports, URIs oder sogar Teilen der Nutzdaten basieren. Sie richten sich danach, wer die Anfrage stellt, was angefragt wird, wie hoch die Kosten sind, wie hoch das Risiko ist und welche Ergebnisqualität erforderlich ist. Zusammen mit der Moderation der Ausgabe und der Token-Kontrolle wurde diese Ebene des Stacks in unserer jüngsten Studie als diejenige identifiziert, auf der Anwendungsbereitstellung und Sicherheit die größte Wirkung entfalten. Nimmt man noch das Modell-Routing hinzu (ebenfalls Layer 8), erkennt bereits die Mehrheit der Unternehmen, wie wichtig diese Ebene für die Absicherung und Skalierung von KI-Inferenz ist.
Prompt-Überprüfung, Token-Kontrolle, Ausgabemoderation und Modell-Routing sind keine optionalen Funktionen. Sie sind Grundvoraussetzungen für den produktiven Inferenzbetrieb.
Keine Sorge: Die darunterliegenden Schichten verschwinden ebenso wenig, wie L2–3 verschwanden, als L4–7 zur obersten Ebene des Stacks wurden. Sie bilden lediglich das Fundament. Paket-Routing bleibt wichtig. Auch die Protokollverarbeitung bleibt wichtig.
Doch eines ist klar: Der Mehrwert liegt jetzt auf Schicht 8.
Die Reaktion auf Inferenz bestätigt den Wandel
Application Delivery Controller entstanden, weil für Pakete konzipierte Netzwerke keine Anwendungen unterstützen konnten. API-Gateways entstanden, weil für Webanwendungen konzipierte Netzwerke keine APIs unterstützen konnten. Nun entsteht Unterstützung für Inferenz, weil für APIs konzipierte Netzwerke keine autonomen, probabilistischen Anwendungen mit variablen Kosten unterstützen können.
Die Reaktion des Marktes bestätigt diesen Wandel. Rund um Modell-Routing, Inferenz-Gateways, Token-Governance und Prompt-Kontrolle entstehen Start-ups. Hyperscaler bauen im Hintergrund intern dieselben Funktionen auf.
Die Reaktion der Unternehmen bestätigt diesen Wandel. Neunzig Prozent der Unternehmen nutzen Inferenzdienste, und 70 % von ihnen verwenden zwei oder mehr verschiedene Inferenzdienste, darunter auch selbst betriebene. Sie setzen Multi-Modell-Strategien um, experimentieren mit agentischer KI und führen KI-gestützte Automatisierung in ihren Betriebsabläufen ein.
Das ist kein Hype. Das ist ein struktureller Wandel.
Inferenz ist nicht einfach nur eine weitere Arbeitslast. Architekturen, die weiterhin auf Paketen und Protokollen basieren, werden zwar funktionsfähig bleiben, aber nicht effizient skalieren. Netzwerk-Stacks, die bei APIs enden, werden Schwierigkeiten haben, autonome Systeme zu steuern.
Inferenz hat den Kontrollpunkt im Stack nach oben verlagert. Der Rest ist unausweichlich.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge
KI-App-Bereitstellung – Top 10: Nicht optimierte Datenverkehrssteuerung
KI stellt herkömmliche Annahmen zur Datenverkehrssteuerung infrage: Backends sind nicht austauschbar, die Kosten variieren und Agenten verzweigen sich unvorhersehbar – daher muss das Routing Modell, GPU-Zustand und Datenlokalität berücksichtigen.
Top 10 der KI-Anwendungsbereitstellung: Fehlende Fehlertoleranz und Ausfallsicherheit
KI macht klassische Resilienzdefizite deutlich kostspieliger: Der Ausfall einer einzelnen GPU oder Abhängigkeit kann sich durch synchrone Inferenzketten fortpflanzen, wodurch sich Latenzen summieren und die Qualität der Ausgaben sinkt.
Die neue Herausforderung der hybriden Multicloud: Betrieb ohne Plattform für Anwendungsbereitstellung und Sicherheit
Unternehmen kehren On-Premises-Umgebungen nicht den Rücken – sie modernisieren sie. Da ihre Portfolios weiterhin gemischt bleiben, müssen Anwendungsbereitstellung und Sicherheit von umgebungsspezifischen Funktionen auf eine einheitliche Plattform umgestellt werden.
Programmierbarkeit ist der einzige Weg, wie Kontrolle im KI-Maßstab bestehen kann
Erfahren Sie, warum die Programmierbarkeit der Daten- und Steuerungsebene entscheidend ist, um KI-gestützte Systeme zu skalieren und abzusichern und in einer sich schnell verändernden Umgebung die Kontrolle in Echtzeit zu gewährleisten.
Die fünf wichtigsten Technologietrends, die Sie 2026 im Blick behalten sollten
Entdecken Sie die wichtigsten Technologietrends des Jahres 2026, in dem Inferenz die KI dominiert – von Kostenstellen und Edge-Bereitstellung bis hin zu Governance, IaaS und Interaktionsschleifen agentischer KI.

Der Einfluss von Inferenz: APIs, DPUs und Kontextchaos
KI-Inferenz verändert die Infrastruktur grundlegend: Sie vervielfacht APIs, belastet Rechenressourcen und erschwert die Kontextverwaltung. Erfahren Sie, warum eine intelligentere Architektur und Laufzeitrichtlinien unverzichtbar sind.