Dieser Blogbeitrag ist der dritte in einer Reihe über die Bereitstellung von Daten für KI.
Generative KI mag auf den ersten Blick mühelos erscheinen. Doch hinter jedem erfolgreichen Modell steht eine Datenpipeline, die so komplex und sensibel ist wie eine industrielle Raffinerie.
Führungskräfte im KI-Bereich weisen immer wieder darauf hin, dass nicht die Modelle das größte Hindernis für die Skalierung von KI darstellen, sondern der Datenfluss, der sie versorgt. McKinsey & Company schätzt, dass die Nachfrage von Unternehmen nach KI-fähiger Dateninfrastruktur jährlich um mehr als 30 % wächst, während der Datenbedarf von Modelltrainingsumgebungen noch schneller zunimmt. Wenn diese Pipelines ins Stocken geraten, bleiben daher selbst die modernsten GPUs ungenutzt.
Eine kurze Analogie hilft, die Herausforderung einzuordnen.
“Stellen Sie sich eine KI-Datenpipeline wie eine moderne Fertigungsstraße vor. Die Rohstoffe (Unternehmensdaten) müssen erfasst, geprüft und ordnungsgemäß bereitgestellt werden, bevor sie in die Fertigung gelangen.”
Anschließend werden sie in einer Reihe präziser Schritte aufbereitet: Sie werden bereinigt, gekennzeichnet, konvertiert und validiert, damit sie strenge Qualitätsstandards erfüllen. Schließlich müssen die fertigen Komponenten effizient und zum richtigen Zeitpunkt an die richtigen Produktionsstationen weitergeleitet werden. Wenn eine Phase uneinheitlich, verzögert oder nicht richtig abgestimmt ist, gerät der gesamte Betrieb ins Stocken – genau wie ein Fließband zum Stillstand kommt, wenn eine einzige Arbeitsstation ausfällt.
So wie Rohstoffe gesammelt, veredelt und zur Produktionsstation transportiert werden müssen, müssen Unternehmensdaten die Phasen der Aufnahme, Transformation und Bereitstellung durchlaufen, bevor sie für das Training bzw. die Feinabstimmung von Modellen oder für die Retrieval-Augmented Generation (RAG) genutzt werden können. Werden die Daten in einer dieser Phasen verunreinigt oder kommt es zu Verzögerungen, wird das gesamte KI-System beeinträchtigt. Dies wirkt sich negativ auf das Unternehmen aus und schmälert den ROI.
Dieser Beitrag untersucht diese drei Phasen und erläutert, wie F5 BIG-IP und S3-kompatibler Objektspeicher die Model-Foundry-Workflows unterstützen, auf die Unternehmen heute angewiesen sind.
Phase 1: Erfassung – Rohmaterial erfassen und konsolidieren
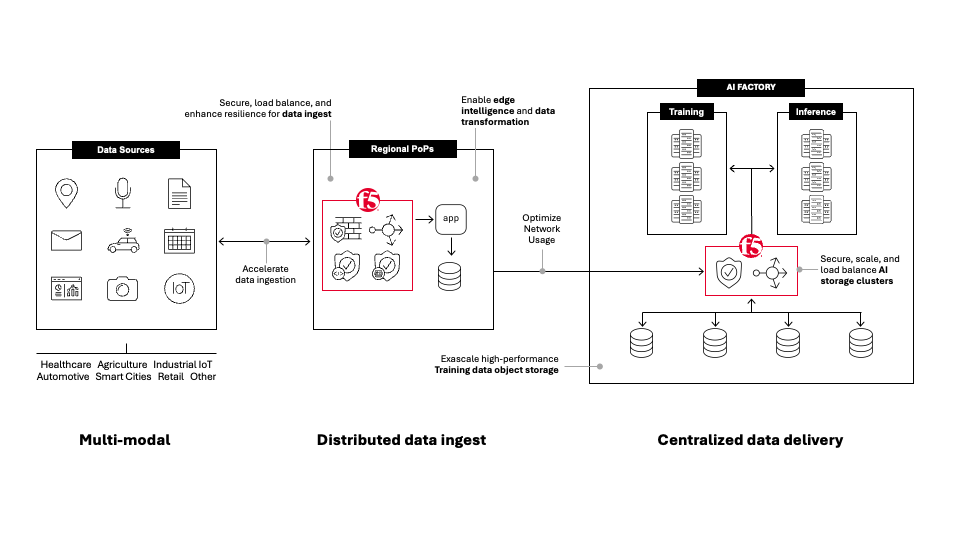
Die Datenaufnahme bezeichnet den Moment, in dem Daten in das KI-Ökosystem gelangen. Unternehmen verfügen nur selten über eine zentrale, verlässliche Datenquelle; ihre „Rohdaten“ sind über Abteilungssysteme, Cloud-Dienste, Objektspeicher, SaaS-Tools, Protokolle, APIs und sogar externe Daten von Drittanbietern verteilt. Ein Großteil davon trifft in unterschiedlichen Formaten, Intervallen und Qualitätsstufen ein.
In dieser Phase müssen die Daten auf ihrem Weg in zentrale oder verteilte Objektspeicher identifiziert, authentifiziert, normalisiert und validiert werden. Metadaten werden hinzugefügt, Schemata zugeordnet und erste Qualitätsprüfungen durchgeführt. Erfolgt die Datenaufnahme nachlässig, überträgt sich diese Nachlässigkeit auf den Rest der Pipeline. Modelldrift – also die Verschlechterung von Modellen im Laufe der Zeit –, Halluzinationen und instabile Trainingsläufe sind häufig auf eine inkonsistente oder unzureichend kontrollierte Datenaufnahme zurückzuführen.
An dieser Stelle wird auch die Anfälligkeit von Verbindungen zu einem echten Problem. In vielen stark verteilten Umgebungen brechen langlebige Verbindungen zu entfernten Systemen unerwartet ab. Ohne geeignete Schutzmaßnahmen bleiben infolge solcher Ausfälle verwaiste Sitzungen in der Objektspeicherumgebung geöffnet, die nach und nach Ressourcen beanspruchen und die Zuverlässigkeit der Umgebung beeinträchtigen.
F5 BIG-IP sorgt hier für Stabilität, indem es diese Verbindungen verwaltet, einen unkontrollierten Ressourcenverbrauch verhindert und sicherstellt, dass Datenübertragungen selbst bei einer schwachen Netzwerkverbindung an der Quelle zuverlässig abgeschlossen werden. Die bewährten Stärken von BIG-IP – integrierte Authentifizierung (einschließlich Token-Validierung, Identitätsintegration und gegenseitiger TLS-Authentifizierung), Datenverkehrsmanagement, API-Schutz und DDoS-Abwehr – schützen zudem die sensiblen Daten, die in die Organisation übertragen werden.
Dank dieser Schutzmechanismen gelangen die Daten zuverlässig zu den S3-kompatiblen Speichersystemen, die die nächste Verarbeitungsstufe versorgen.
Phase 2: Transformation – Aufbereitung von Daten zu modellfertigen Materialien
Wenn die Datenaufnahme das Rohmaterial bereitstellt, ist die Transformation die Raffinerie, die daraus hochwertige, für Modelle aufbereitete Datenbestände erzeugt. Die hier anfallenden Arbeiten sind weitaus aufwendiger, als viele Teams erwarten, und überraschend viele KI-Projekte scheitern in dieser Phase. Modellfabrik-Umgebungen sind auf konsistente, gut verwaltete Daten angewiesen. Sind die Daten verrauscht, inkonsistent, schlecht formatiert oder unzureichend gekennzeichnet, wird das Training instabil und die Modellqualität nimmt ab.
Die Transformation umfasst die Bereinigung, Konvertierung und Aufbereitung von Daten, damit sie für das Modelltraining, die Feinabstimmung oder die abrufgestützte Generierung (Retrieval-Augmented Generation, RAG) verwendet werden können.
Dokumente und PDF-Dateien werden in strukturierten Text oder Vektoreinbettungen umgewandelt. Bilder und Protokolle werden in standardisierte Formate überführt. Fehlende Werte werden korrigiert. Vertrauliche Informationen werden geschwärzt oder verschlüsselt. Die Datenherkunft wird dokumentiert, damit Aufsichtsbehörden nachvollziehen können, wie bestimmte Datenbestände erstellt oder verändert wurden. In RAG-Pipelines erfolgen hier außerdem die Aufteilung in Textabschnitte, die Generierung von Einbettungen und die Aktualisierung von Indizes.
Traditionell fand die Transformation in einer zentralisierten Umgebung statt, doch dieses Muster wandelt sich. Angesichts des explosionsartigen Wachstums der Datenmengen ist es zunehmend sinnvoll, einen Teil der Transformation am Netzwerkrand oder in der Nähe der Datenquellen durchzuführen.
F5 BIG-IP ermöglicht die verteilte Anreicherung und Aufbereitung von Daten mit flexiblen Formfaktoren, die näher an den Ursprungsorten der Daten eingesetzt werden können. In Kombination mit einem flexiblen, S3-kompatiblen Objektspeicher am Edge können Unternehmen Daten filtern und aufbereiten, bevor sie an die zentrale Pipeline zurückgesendet werden. Dies senkt die Kosten für die Datenübertragung und minimiert das Risiko, unnötige oder nicht richtlinienkonforme Inhalte zu übertragen.
Nach Abschluss der Transformation verfügt das Unternehmen über bereinigte, vertrauenswürdige und sichere Datenbestände, die für nachgelagerte Rechensysteme bereitstehen.
Phase 3: Bereitstellung – optimierte Daten zur richtigen Zeit an die richtige Rechenressource übertragen
Bei der Bereitstellung gelangen die aufbereiteten Daten zu den GPU-Clustern, Fine-Tuning-Aufträgen, Vektordatenbanken oder RAG-Pipelines, die auf sie angewiesen sind.
Die Qualität der Bereitstellung macht sich für Nutzer und Betreiber unmittelbar bemerkbar. Treffen die Daten zu langsam ein, werden die GPUs nicht ausreichend ausgelastet. Ist das Routing ineffizient, verbleiben Aufträge länger als erwartet in der Warteschlange. Sind die Zugriffskontrollen unzureichend, können sensible Datensätze offengelegt werden.
Eine gut konzipierte Bereitstellungsphase sorgt dafür, dass Daten schnell und zuverlässig vom Speicher zu den Rechenressourcen übertragen werden. Zugriffspfade mit hohem Durchsatz ermöglichen es verteilten Trainingsaufträgen, parallel aus dem Objektspeicher zu lesen. Intelligentes Caching verbessert die Leistung.
Automatisierte Workflows planen Trainingsläufe, skalieren Ressourcen und leiten Anfragen für die semantische Suche weiter. Monitoring-Tools erfassen Latenz, Durchsatz und Leistungsanomalien.
Sicherheit bleibt hier von entscheidender Bedeutung. Der Zugriff muss am Ort der Nutzung kontrolliert werden, nicht nur bei der Aufnahme der Daten. So wird sichergestellt, dass jeder Datensatz nur den dafür vorgesehenen Modellen, Aufträgen oder Benutzern zur Verfügung steht.
F5 BIG-IP unterstützt dies durch die Durchsetzung von Richtlinien, die Validierung von Tokens und die Überwachung von Anfragemustern. Zudem optimiert es die Verteilung des Datenverkehrs, damit Daten so effizient wie möglich zu den Rechenressourcen fließen.
In Kombination mit skalierbarem, S3-kompatiblem Speicher schaffen diese Funktionen eine Umgebung, in der Trainings- und Feinabstimmungsaufträge kontinuierlich mit Daten versorgt werden. Dadurch werden GPU-Leerlaufzeiten reduziert und eine vorhersehbare Leistung gewährleistet.
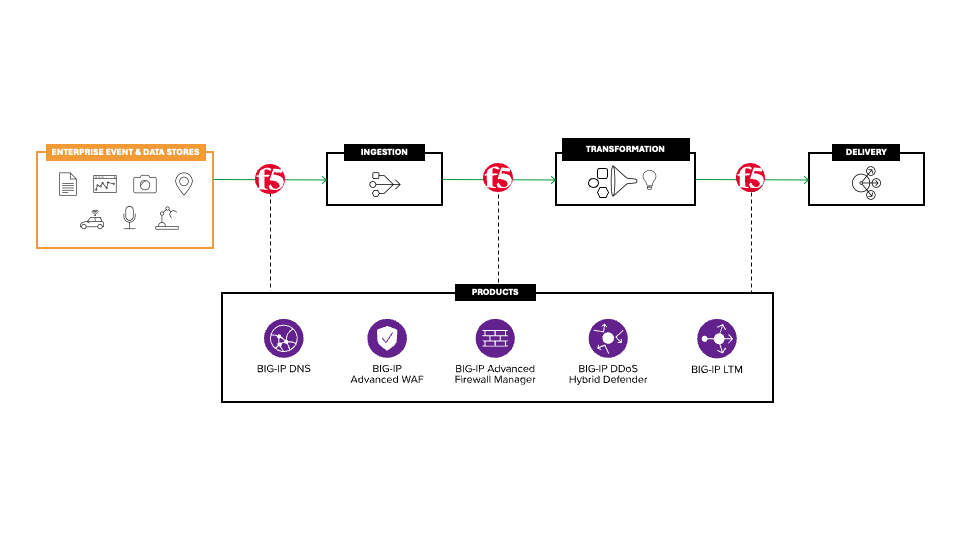
Wie die drei Phasen zusammenspielen
Obwohl Datenaufnahme, Transformation und Bereitstellung eigenständige Prozesse sind, bilden sie einen kontinuierlichen Kreislauf.
Die Datenaufnahme stellt sicher, dass aktuelle, kontrollierte Daten aus dem gesamten Unternehmen in das System gelangen. Durch die Transformation werden diese Daten zu hochwertigen Datenbeständen aufbereitet, die sich für das Training, die RAG-Indexierung oder das Fine-Tuning eignen. Die Bereitstellung überträgt diese Datenbestände schnell und zuverlässig an die richtigen Rechenressourcen.
Schwachstellen in nur einem einzigen Bereich verlangsamen den gesamten Betrieb. Zudem sind Ausfälle in den Pipelines weitverbreitet. Verschiedenen Quellen zufolge scheitern insgesamt mehr als 80 % der KI-Projekte in Unternehmen. Viele dieser Quellen berichten außerdem, dass mindestens 70 % bis 80 % dieser Fehlschläge auf eine mangelhafte oder unzureichende Datenqualität zurückzuführen sind.
Wenn die Pipeline jedoch durchgängig reibungslos funktioniert und dabei durch sichere und ausfallsichere Netzwerkdienste wie BIG-IP sowie skalierbaren S3-kompatiblen Speicher unterstützt wird, können Unternehmen schneller trainieren, das Fine-Tuning zuverlässiger durchführen und Modellfabrik-Umgebungen im industriellen Maßstab betreiben.
F5 stellt KI-Anwendungen überall bereit und schützt sie
Weitere Informationen zu unseren KI-Datenbereitstellungslösungen finden Sie auf unserer Webseite zu KI-Datenbereitstellungs- und Infrastrukturlösungen .
Der KI-Fokus von F5 geht über die Datenbereitstellung hinaus. Erfahren Sie, wie F5 KI-Anwendungen überall schützt und bereitstellt.
Lesen Sie auch die anderen Blogbeiträge aus unserer Reihe zur KI-Datenbereitstellung:
Die KI-Datenpipeline mit F5 und S3-kompatiblem Speicher versorgen
KI optimieren durch die Beseitigung von Engpässen in modernen Workloads
Warum KI-Speicher einen neuen Ansatz für den Lastenausgleich erfordert
Best Practices zur Optimierung von KI-Infrastrukturen im großen Maßstab
KI-Anwendungen in großem Maßstab bereitstellen: Die Rolle von ADCs
Sichern Sie Ihre KI-Datenpipeline, ohne sie auszubremsen
Über die Autoren
Mark Menger ist Solutions Architect bei F5 und auf Technologiepartnerschaften in den Bereichen KI und Sicherheit spezialisiert. Er leitet die Entwicklung der KI-Referenzarchitektur von F5 und treibt damit sichere, skalierbare KI-Lösungen voran. Dank seiner Erfahrung als Global Solutions Architect und Solutions Engineer wirkte Mark an der Secure Cloud Architecture von F5 mit und war an der gemeinsamen Entwicklung der Distributed Four-Tiered Architecture beteiligt. Als Mitautor von „Solving IT Complexity“ verfügt er über umfassende Expertise bei der Bewältigung von IT-Herausforderungen. Zuvor war er als Anwendungsentwickler und Enterprise Architect tätig, wobei sein Schwerpunkt auf modernen Anwendungen, Automatisierung und einer schnelleren Wertschöpfung aus KI-Investitionen lag.
Weitere Blogbeiträge von Mark MengerÄhnliche Blogbeiträge
Vier Gründe, warum Sie den F5 Post-Mythos Security Summit nicht verpassen sollten
Holen Sie sich Expertenrat, um Ihre Apps, APIs und Modelle in der Post-Mythos-Welt zu schützen.

Von einer App zu einer Flotte von KI-Agenten: Ein 90-Tage-Framework für KI-Sicherheit
Vermeiden Sie den kostspieligen Ansatz „Erst bereitstellen, später absichern“ – mit einem umfassenden Framework zum Schutz von KI-Modellen, Anwendungen und autonomen Agenten.

Fünf Stufen antifragiler Cyberresilienz verwandeln Praxis in Ergebnisse
Erfahren Sie, wie fünf Stufen antifragiler Resilienz Störungen in adaptive Verhaltensweisen überführen, die Ausfälle begrenzen und hybride Multicloud-Architekturen stärken.
Warum Ihre KI-Richtlinien, Governance und Leitplanken nicht warten können
KI-Richtlinien und -Governance dürfen nicht länger als reine Formalitäten oder Zukunftsthemen betrachtet werden. Sie müssen durch praktische, durchsetzbare Leitplanken ergänzt werden.

Wenn „privat“ nicht privat ist: Wie ChatGPT-Unterhaltungen öffentlich wurden
KI verändert die Arbeitsabläufe in Unternehmen, doch eine übersehene Einstellung hat bereits Tausende vertraulicher Unterhaltungen öffentlich zugänglich gemacht
KI-Nutzung verstehen: Warum Unternehmen Transparenz brauchen
Anstatt einen zu laxen oder zu strengen Ansatz zu verfolgen, können Unternehmen durch mehr Transparenz bei der KI-Nutzung fundierte und durchsetzbare Entscheidungen treffen.